版本历史
版本 日期 说明 v1.0 2026-05-28 初稿,串联十篇 agentic 推理论文与十篇阅读笔记 v1.1 2026-05-28 增补:正文十处阅读笔记添加内链跳转;新增三张配图(DualPath 架构对比、LayerScale 累积 wall time、Helium 架构) v1.2 2026-05-29 勘误修正:替换错误的 DualPath Fig 1 配图;Helium 架构描述从 “四级” 修正为三段流水线(论文原文解析→优化→执行);HexAGenT 章节修正 SLO 尺度数据和去混淆 workflow-FCFS 与 HexAGenT 完整方案的差异;移除 Helium 段未经验证的 32.9% 缓存命中率数字;清理未引用资产
一次普通的 chat 调用可能 2K token、单轮就结束;一次 Claude Code 任务可能跑 50 次模型调用,每次都背着 30K 以上的固定上下文开销。这个差异不只是”量变”——从 2026 年初开始,整个推理系统社区在一件事情上迅速达成了共识:agentic 负载是一种全新的负载类型,不是”更长的 chat”。
过去评估推理引擎,标准指标是 TTFT(首 token 延迟)、TPOT(per-token 延迟)和吞吐量,负载是 ShareGPT 或 LMSYS-Chat-1M 的聊天对话。这些指标在 agentic 负载下会系统性地误判:它们衡量单次调用的瞬时性能,但 agent 任务持续几十到几百轮,每轮的 prompt 大部分与前一轮重叠,KV cache 的状态积累和失效模式才是真实瓶颈。
从 2026 年 1 月到 5 月,arXiv 上出现了至少十篇直接探讨这个问题的论文,覆盖从负载表征、KV cache 瓶颈诊断、调度优化到工作流级评估的完整链条。本文是一次垂直串联——把十篇论文的核心发现织成一个推理引擎性能评估的框架,每篇背后都有一份独立的深度阅读笔记。(十份阅读笔记对应本文的十篇核心论文,按顺序标注。)
一、Agentic 负载的特征:不是长 prompt,是状态积累
先看两组负载表征工作。
UIUC 联合 Intel 和 Gimlet Labs 对 Gemma 和 Qwen 在五个 agent benchmark 上做了端到端 tracing[1]——最核心的发现是 84.6–99.5% 的输入 token 跨轮可复用,导致 decode 占 LLM 时间的 91.0–98.6%,prefill 仅 1.4–9.0%。
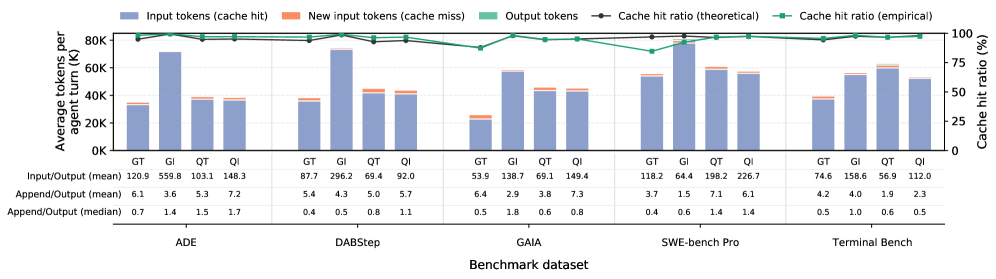 图 1:Agentic 负载的 per-turn context 构成——cached input tokens(绿色)占据绝对主导,newly appended tokens(橙色)仅占 5-15%。(来源:arXiv 2605.26297, Fig 8)
但一旦 cache 被驱逐,每次重新计算全部前缀,成本暴涨。论文还揭示了一个被低估的因素:工具调用失败率会推动正反馈退化——Gemini Instant 在 ADE-Bench 上发了 2,757 次 Edit,失败率 95.4%,每次失败追加一条错误观察,既增加轮次又增长上下文。(详见阅读笔记《Agent 推理不是长上下文推理:cache 红利与驱逐临界点》)
Dalhousie University 的团队补充了能耗维度[2]。四种多请求工作流上对比 vLLM 和 Parrot 后发现:batch size 虽是能耗的最大杠杆,但效果完全取决于负载类型——共享大型 system prompt 的搜索场景获得 2.6 倍 per-token 能耗降低,而链式摘要因为上下文逐段变化,批处理反而恶化能效。跨请求的依赖结构和缓存复用动态,完全改写了单请求 benchmark 中”batch 越大越好”的朴素假设。(详见阅读笔记《同一个 batch size,三种能耗结局——多请求 LLM 工作流性能-能耗首次实测》)
这两篇放在一起指向同一个结论:理解 agentic 负载,不能只看单次请求的 profile,必须看到跨轮 KV cache 的积累和退化。
二、KV Cache 在 Agentic 压力下的三种退化模式
如果 KV cache 是 agentic 推理的命脉,那么它的失效模式就是最需要被 benchmark 捕捉的东西。四篇论文各自命名了一种退化模式。
2.1 middle-phase thrashing
CONCUR[3](NTU + 上海奇绩智峰)识别出一个此前未被描述的现象:agentic 批推理有三阶段——warmup(浅上下文,高前缀共享,~90% cache 命中)→ middle(KV cache 80-100% 饱和但命中率崩溃,占据总执行时间的 >90%,额外重复计算占端到端延迟的 49.1%)→ cooldown。
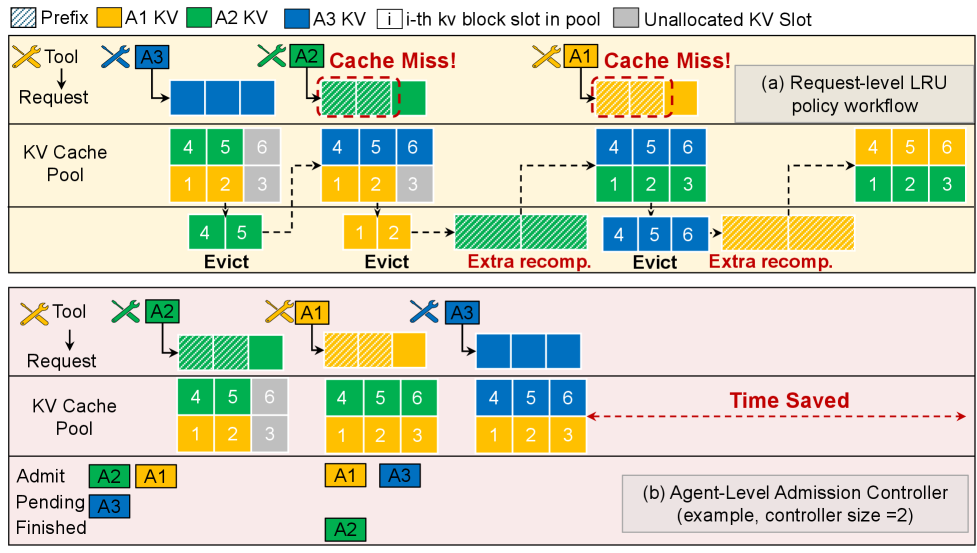
图 2:三 agent 工作流中的 middle-phase thrashing 成因——LRU 驱逐导致暂停中的 agent(A1、A2)丢失 KV cache,恢复时被迫重新 prefill 整个前缀,形成”驱逐→重计算→进一步驱逐”的正反馈螺旋。来源:arXiv 2601.22705, Fig 2。
它将 KV cache 类比为 TCP 中的网络带宽,用 AIMD 拥塞控制动态调节活跃 agent 数量,在 Qwen3-32B 上获得 4.09 倍吞吐提升。最反直觉的发现是:固定并发控制(Request Control)反而比不加控制更慢——问题不在”控制多少”,而在”能否感知 cache 状态反馈”。(详见阅读笔记《CONCUR:KV Cache 的 AIMD 时刻》)
2.2 存储 I/O 瓶颈
DualPath[4](DeepSeek-AI + 北大 + 清华)从 disaggregated 架构角度切入。生产级 agentic RL 训练 trace(平均 157 轮、32.7K 上下文、98.7% KV cache 命中率)显示瓶颈已从计算转移到KV cache 存储 I/O。在 prefill-decode 分离架构下,仅 prefill 引擎从存储加载 KV cache,其存储 NIC 饱和而 decode 侧闲置——这种非对称瓶颈在此前从未被系统分析过。DualPath 利用 decode 侧闲置 NIC + RDMA 在 DeepSeek-V3.2 660B 上获得 1.87 倍吞吐提升,online serving 平均 1.96 倍。(详见阅读笔记《DualPath:当 agent 负载把 PD 分离架构的瓶颈从算力推到存储 I/O》)
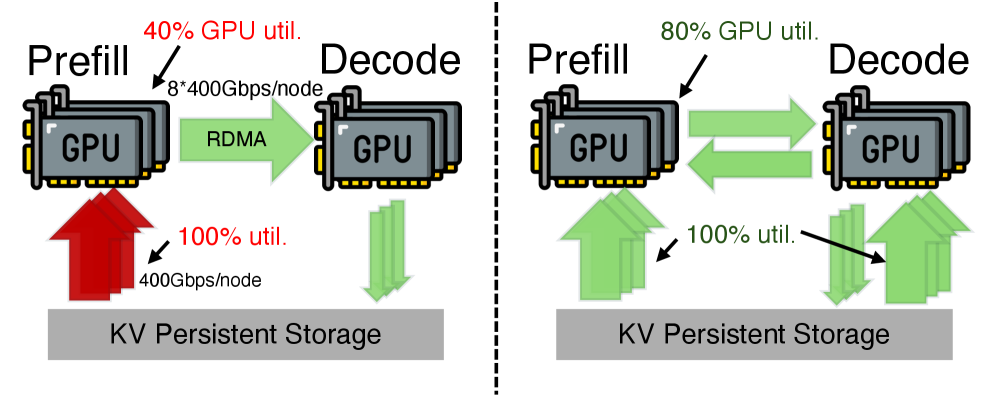
图 3:DualPath 的架构对比——左侧为现有方案(prefill 引擎独自承担 KV cache 加载,存储 NIC 成为瓶颈),右侧为 DualPath(利用 decode 侧闲置 NIC + RDMA 分担加载压力)。来源:arXiv 2602.21548, Fig 1。
2.3 轴感知的 KV 精度分配
TriAxialKV[5](Cambridge + Imperial)观察到 agentic 负载的 context 沿三个轴——时间近度、模态(文本 vs 图像 token)、语义角色(user/tool_call/reasoning/obs 等 7 种)——有不同的 KV 量化敏感度。去掉语义轴,Qwen3-14B 的精度损失是去掉时间轴的 3 倍(-6.22 vs -2.22 分)。按轴分配 INT2/INT4 混合精度后,Qwen3-VL-32B-Thinking + OSWorld 上维持精度同时支持 4.5 倍 KV cache 容量和 30%+ 吞吐提升。(详见阅读笔记《TriAxialKV:为什么 Agent 推理需要多轴 KV Cache 量化》)
2.4 多层内存管理
Predictive Multi-Tier Memory Management[6](独立作者)指出现有系统对 MLA 的支持缺失导致最高 57 倍的 KV cache 内存过度分配。更根本的问题是所有推理引擎都将 KV cache 限制在单层 GPU HBM,Bayesian reuse prediction + 六级存储层次(GPU HBM→CPU DRAM→CXL→NVMe→RDMA→并行 FS)的联合方案将 batch size 从 14 提升到 104(7.4 倍),吞吐 2.86 倍于 vLLM。(详见阅读笔记《预测性多级 KV Cache 管理:57 倍的内存浪费与贝叶斯缓存预测》)
这四篇从并发控制、存储路径、精度分配和内存层次四个角度触碰同一个问题:agentic 负载下 KV cache 的失效模式完全不同于 chat,被动/单层/均匀策略都需要重新设计。对于 benchmark 设计者,含义直接:如果压测 agentic 推理系统时不测量 middle-phase 的缓存命中率退化、存储 NIC 带宽利用率、多层存储的迁移延迟,就测不到真正的瓶颈。
三、调度的重构:从单请求到工作流,从单层到跨层
KV cache 策略变化后,调度也必须跟上。这四篇论文展示了调度粒度的逐级上移。
有状态推理。LayerScale[7] 提出持久 KV cache 跨轮存活 + radix prefix cache 跨 agent 共享,将 per-turn 成本从 O(n_t) 降到 O(Δ_t)。论文的核心数字——在 35 轮 coding 工作流上,median per-turn 延迟 647ms vs vLLM/SGLang 的 2743ms/2732ms(4.2 倍差距)——揭示了一个结构性问题:现有 prefix caching 方案在长时间多轮执行中的 LRU 驱逐压力会系统性地抹除缓存收益。(详见阅读笔记《当 85% 的 prompt 没变,为什么每次 tool call 都要重新跑?》)
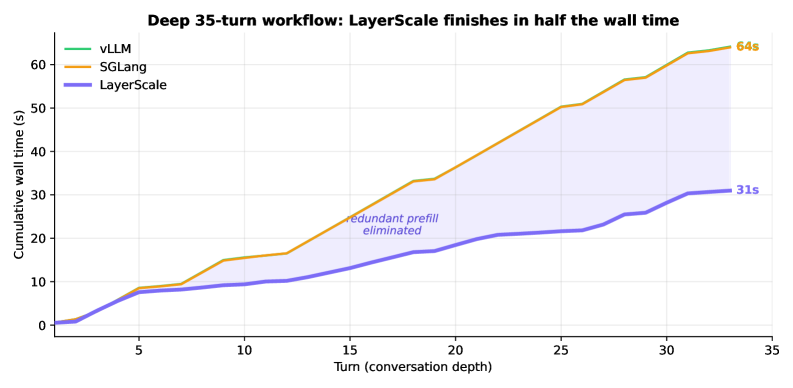
图 4:35 轮 coding 工作流的累积 wall time 曲线——LayerScale 完成全部 35 轮时 vLLM 和 SGLang 才跑到约第 18 轮。差距随轮次增加而扩大,说明缓存驱逐的累积效应。来源:arXiv 2605.26289, Fig 3。
工作流级延迟优化。HexAGenT[8](HKUST 等)的核心主张是:用户感知的是整个工作流而非单次调用的延迟。它将每个工作流建模为在线揭露的 DAG,基于投影风险比例调度各调用——在异构 A100/H100/H200 集群上,Req95 SLO 尺度平均降低 20.1%,Req99 平均降低 33.0%,不同工作流差异巨大。论文最关键的一组对比来自 ShareGPT 负载:per-call FCFS 下 Req95 为 5.85;仅把排序粒度从单调用改成工作流级(workflow-FCFS),Req95 降至 4.50;再加入异构感知的联合 prefill-decode 放置,Req95 进一步降至 2.50。(详见阅读笔记《HexAGenT:当 Agent 把请求从单次调用变成在线 DAG,调度就得重写》)
跨资源协同调度。MARS[9](Duke)看到了 agentic 负载的空间维转变:工具在同一个宿主 CPU 上跑 Docker 沙箱,GPU 推理和 CPU 工具执行的压力相互传导。MARS 的跨资源 AIMD 控制循环 + agent 级优先级调度在 SWE-bench 等 benchmark 上获得高达 5.94 倍的端到端延迟降低。它的 OpenHands 真实部署数据(1.87 倍任务加速)比微基准更有说服力——证明了 GPU-CPU 协同调度的可测量收益不是 benchmark artifact。(详见阅读笔记《推理引擎只管 GPU 是不够的——Agent 把 CPU 工具执行也绑进了延迟关键路径》)
数据系统视角。Helium[10](NUS)从另一个角度切入:将 agentic 工作流建模为 query plan,LLM 调用作为 first-class operator。它的 Templated Radix Tree 仅用 552 KiB 就实现了超越 SGLang RadixCache 14.8 MiB 的共享效果,证明 agentic speculation 放大了缓存复用机会——探索越多,可共享的前缀和中间结果越多。(详见阅读笔记《Helium:把 Agentic 工作流当查询计划来优化》)
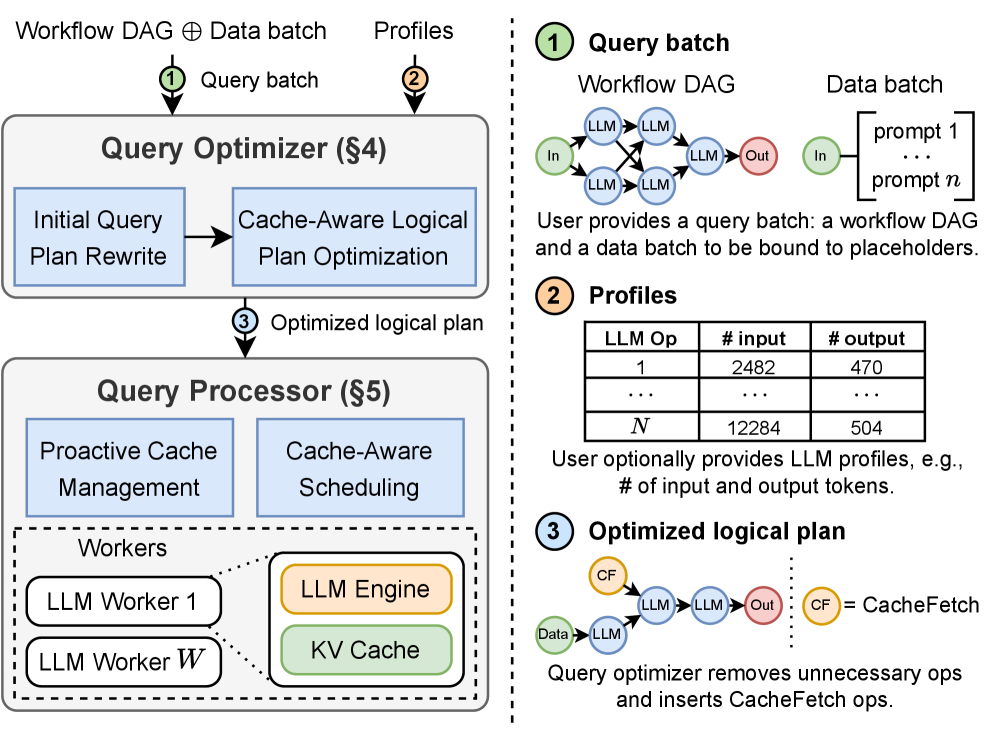
图 5:Helium 的三段流水线——解析构建 DAG、优化器做逻辑计划改写、执行层通过 Templated Radix Tree 与 cache-aware 调度完成声明式执行。这套架构将 LLM 调用视为 first-class operator,复用数据库查询优化的经典思路。来源:arXiv 2603.16104, Fig 3。
这四篇的共同趋势是调度粒度的上移:request → workflow → GPU+CPU coupled → query plan。 对应的 benchmark 评估指标也应上移——加上 workflow SLO attainment rate、工具执行延迟占比、跨调用缓存命中率。
四、结论:Benchmark 需要跟上系统
把这十篇串在一起,三条判断逐渐清晰。
第一,agentic 负载不是”长 chat”。 它是状态积累型负载——多轮、高前缀重叠、decode 主导(前提是 KV cache 不丢失)、工具调用失败驱动正反馈退化。用 ShareGPT 或 LMSYS-Chat-1M 做推理系统压测,看起来会非常不同。
第二,KV cache 的失效模式被严重低估。 Middle-phase thrashing、存储 I/O 不对称、多轴敏感度差异、多层存储利用率——这四个维度在现有 benchmark 中几乎都不被测量。CONCUR 和 DualPath 分别提供了可观测的退化 signal 和架构瓶颈特征,但还没有统一的压测框架。
第三,评估指标需要从单次调用升级到工作流级。 TTFT 和 TPOT 仍有意义,但在 agentic 场景下,工作流端到端延迟、tool call 延迟占比、跨调用 KV cache 复用率、SLO attainment rate 更接近用户体验。HexAGenT 的消融实验最能说明问题:同一个 ShareGPT 负载上,仅把排序粒度从单调用改成工作流级,Req95 就从 5.85 降到 4.50;再加上异构感知的联合放置,进一步降到 2.50——两个改进各自贡献了显著的独立收益。
当前这个方向的 benchmark 生态还处于特征化阶段——大家都在测量和命名问题,还没有收敛到统一的指标和数据。十篇论文在五个月内密集触及同一方向且各用各的负载,这种混乱本身就是一种信号:标准化是下一步,而且从这些工作的差距中,已经可以看清楚标准应该包含什么——三阶段的退火退化曲线、存储 I/O 带宽利用率、跨轴 KV 精度敏感度、workflow SLO attainment rate、以及 GPU-CPU 耦合压力传导。如果这些指标都不能从一个压测工具中拿到,你就还没有在测 agentic 推理。
十篇阅读笔记索引
- Agent 推理不是长上下文推理:cache 红利与驱逐临界点
- 同一个 batch size,三种能耗结局——多请求 LLM 工作流性能-能耗首次实测
- CONCUR:KV Cache 的 AIMD 时刻
- DualPath:当 agent 负载把 PD 分离架构的瓶颈从算力推到存储 I/O
- TriAxialKV:为什么 Agent 推理需要多轴 KV Cache 量化
- 预测性多级 KV Cache 管理:57 倍的内存浪费与贝叶斯缓存预测
- 当 85% 的 prompt 没变,为什么每次 tool call 都要重新跑?
- HexAGenT:当 Agent 把请求从单次调用变成在线 DAG,调度就得重写
- 推理引擎只管 GPU 是不够的——Agent 把 CPU 工具执行也绑进了延迟关键路径
- Helium:把 Agentic 工作流当查询计划来优化
参考资料
[1] Agentic AI Workload Characteristics — UIUC, Gimlet Labs, Intel
[2] Characterizing Performance-Energy Trade-offs of Large Language Models in Multi-Request Workflows — Dalhousie University
[3] CONCUR: High-Throughput Agentic Batch Inference of LLM via Congestion-Based Concurrency Control — NTU, Shanghai Qiji Zhifeng
[4] DualPath: Breaking the Storage Bandwidth Bottleneck in Agentic LLM Inference — DeepSeek-AI, Peking University, Tsinghua University
[5] TriAxialKV: Toward Extreme Low-Precision KV-Cache Quantization for Agentic Inference Tasks — University of Cambridge, Imperial College London
[6] Predictive Multi-Tier Memory Management for KV Cache in Large-Scale GPU Inference — Independent
[7] Stateful Inference for Low-Latency Multi-Agent Tool Calling — LayerScale, Inc.
[8] HexAGenT: Efficient Agentic LLM Serving via Workflow- and Heterogeneity-Aware Scheduling — HKUST, WeBank, Wuhan University, Tsinghua University
[9] MARS: Efficient, Adaptive Co-Scheduling for Heterogeneous Agentic Systems — Duke University
[10] Efficient LLM Serving for Agentic Workflows: A Data Systems Perspective — National University of Singapore
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。