一个 Claude Code 作业 session 可能触发 50 次模型调用,每次调用都带着 30K token 的重叠系统提示。推理服务框架最自然的优化反应是调大 batch size——50 条请求一起送进 GPU,利用率的账怎么算都比逐条处理好看。但这是单请求基准测试训练出来的肌肉记忆,在多请求工作流里,它只在请求间共享前缀时成立,其他情况下可能完全失灵甚至反向恶化。
Dalhousie 大学的研究者在一台 A100 40GB 上用 vLLM 和 Parrot 跑四种多请求工作流,做了第一份面向工作流的性能-能耗系统实测[1]。他们发现同一个 batch size 在 LLM 搜索、链式摘要和多 agent 编程中产生了三种截然不同的能耗曲线:batch size 是能耗最强杠杆,但它的有效性完全由工作流内部的请求依赖结构和前缀缓存复用率决定。
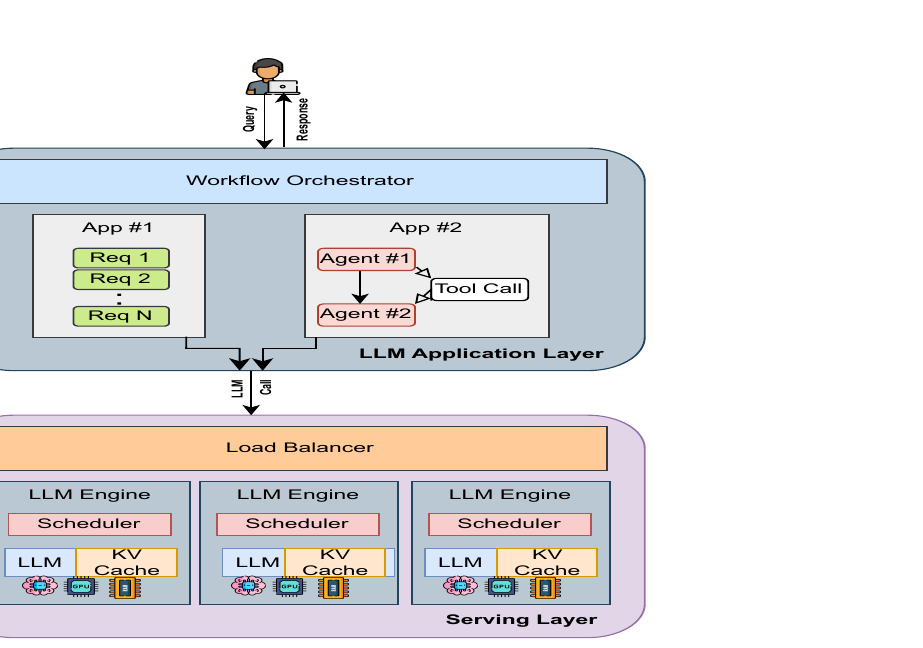
图 1:LLM 推理的三层架构。本文的独特贡献在于联测应用层(多请求工作流的依赖关系)和服务层(vLLM/Parrot 的批处理与调度策略)对能耗的交叉影响。来源:论文 Figure 1。
一、四种工作流,四张依赖图
论文构造了四种多请求工作流,精准覆盖了当前 LLM 应用中最常见的调用模式[1]。
链式文档摘要是最经典的顺序管道:长文档被切分成多个片段,每个片段独立调用一次 LLM 做摘要,上一步的输出可能作为下一步的上下文。整个工作流的端到端延迟等于所有调用的延迟之和——这是一张完全顺序的依赖图,没有任何并行化或前缀共享的空间。
LLM 驱动的搜索代表了交互式 copilot 模式:用户提出一个查询,LLM 可能先对查询做重写,再调用搜索引擎获取结果,然后对结果做摘要和整合。多个用户的多个查询共享同一套系统提示——前缀高度重叠,为批处理提供了天然的优势场景。
多 agent 编程是最复杂的模式:架构 agent 输出设计草案,程序员 agent 按草案写代码,审查 agent 读代码给反馈,修订 agent 根据反馈改代码。调用之间既有数据依赖(下游需要上游的输出),又有部分前缀共享(角色定义、任务描述)。这张依赖图是一个带 branch 和 join 的 DAG,关键路径上的延迟决定整体完成时间,而分支上的请求可能共享部分上下文。
复合工作流则是前三类的混合:一部分请求走顺序管道,一部分请求共享前缀,模拟真实生产环境中异构任务的混杂执行。
四种工作流在请求间依赖强度和前缀共享潜力两个维度上几乎覆盖了整个二维空间。单请求评测会把它们全部打平为同质的独立调用——论文的第一项贡献就是证明这种扁平化假设在能耗维度上不成立。
二、batch size 的三张面孔
论文将 batch size、输入输出长度和 GPU 功耗上限作为三个核心能耗旋钮,在四种工作流上逐一扫参。在所有控制变量中,batch size 对每 token 能耗的波动幅度最大,且效果高度依赖工作流类型[1]。
LLM 搜索场景下,batch size 的收益最直接:当 batch size 从 1 增加到 8 时,每 token 能耗降低了 2.6 倍。这个数字背后的机制很清晰——多个用户的查询共享同一套系统提示,prefill 阶段计算的 KV cache 可以在多个请求间复用。batch 越大,分摊到每个请求的 prefill 计算成本越低。这是单请求基准测试能预测到的理想情况,但它只在共享前缀存在的前提下成立。
链式摘要场景下,batch size 完全失效。摘要工作流中每个请求的输出要等前一个请求完成才能知道——这是硬性的顺序依赖。即使把多个请求塞进同一个 batch,GPU 也只能逐个处理,批处理的并行化优势被依赖关系完全吃掉。论文数据显示增大 batch size 反而增加了每 token 能耗,因为批处理调度本身引入了额外的排队延迟和内存开销,却没有拿到任何并行收益。
多 agent 编程场景的表现最反直觉:非单调。batch size 从 1 增大到 2 时,每 token 能耗反而上升;继续增大到 4 和 8,能耗才逐步回落,但始终没有回到 batch size 1 的水平。论文的解释是:agent 之间存在部分前缀共享(如角色描述和任务定义),但这种共享不是完美的全量匹配。batch size 2 时,两个请求的前缀重叠区域不足以覆盖批处理的调度开销,造成了”最差 sweet spot”;batch size 更大的时候,更密集的请求增加了随机前缀匹配的概率,部分弥补了不完美共享的损失,但始终无法达到搜索场景那种干净的线性收益。
三种模式归结为一个判断:batch size 的真正角色是前缀缓存复用率的放大器——搜索接近 100% 命中率 → 2.6 倍收益;链式摘要接近 0% → 无收益;多 agent 编程处于中间地带 → 非单调波动。论文把前缀缓存称为”隐藏杠杆”,这个命名很精确:batch size 本身不创造节能,它只是把工作流里已有的前缀复用潜力释放出来。
三、两个引擎的两种哲学
论文在链式摘要工作流(四种中最耗能的负载)上对比了 vLLM 0.9.1 和 Parrot 两个推理服务系统[1]。选择这两个系统的用意很明确:vLLM 代表的是引擎层次的吞吐优化路线(PagedAttention + 连续批处理),Parrot 代表的是工作流感知调度路线(Semantic Variable + DAG 级 co-scheduling)。
整体来看,vLLM 比 Parrot 节省约 28% 的总能耗。论文的 GPU 利用率数据解释了差距来源:在 batch size 16 的场景下,vLLM 的 GPU 利用率持续高于 Parrot,尤其是在 decode 阶段——vLLM 的连续批处理能更有效地填充 GPU 计算单元,而 Parrot 的工作流感知调度在等待依赖链上的前序请求完成时,GPU 会出现更多空转。
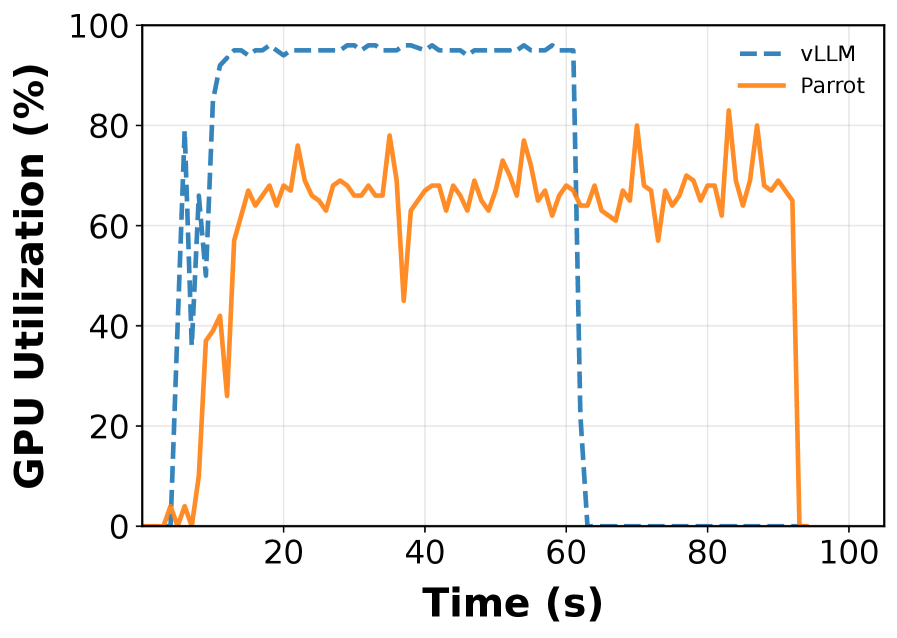
图 2:vLLM 的连续批处理在 decode 阶段维持了更高的 GPU 利用率;Parrot 的 GPU 利用率在工作流依赖等待期间出现明显低谷。来源:论文 Figure 6。
但 Parrot 并非在任何场景下都输:当 GPU 功耗上限被严格限制在 200W 时,Parrot 实现了 21% 的额外能耗节省。论文的推测是 Parrot 的工作流感知调度在严格功耗约束下有更多空间优化 CPU-GPU 活动时序——它知道哪些请求在等待依赖链上的上游完成,可以把这些等待时间段的 GPU 功耗分配给关键路径上的请求。vLLM 没有跨请求的依赖信息,在这个场景下失去了一个可用的优化维度。
两个引擎的比较指向一个更根本的问题:工作流级别的语义暴露到推理系统层的成本是什么。Parrot 的 Semantic Variable 抽象需要应用层显式标注请求间的依赖关系和变量传递——这是一个对上层有侵入性的设计。论文没有深入讨论这个工程权衡,但它暗示了一个选择:要么做侵入性优化(Parrot),拿到工作流级别的最佳调度;要么做无侵入优化(vLLM),用更高的平均 GPU 利用率弥补工作流信息缺失的损失。
四、两个慢速杠杆的边界
除了 batch size,论文还测量了输出 token 长度和 GPU 功耗上限两个控制变量对能耗的影响[1]。结论比 batch size 简洁得多:
输出长度是线性杠杆。每 token 能耗随着输出长度线性增长,单位能耗的下降空间非常有限——因为 decode 阶段的每一轮自回归都是内存带宽受限的,增加输出 token 不会让 GPU 计算单元变得更”忙”。论文把这种做法的代价描述为”proportional scaling with limited efficiency gains”——花多少 token 的电,就会得到多少 token 的产出,没有 batch size 那种批处理摊薄的效应。
GPU 功耗上限是稳但慢的杠杆。论文找到了一个功耗上限的 sweet spot——约 200W(A100 峰值功耗为 300W),在这个点上能耗节省比较明显,同时延迟增加还在可接受范围内。超过这个点往更低方向压,延迟的非单调上升开始出现:论文观察到 DVFS 状态切换的过渡开销在某些功耗区间内会导致延迟的不连续跳变。但整体来说,功耗上限提供的是可预测的、温和的能耗节省,不改变工作流的性能-能耗结构——它更像一个全局的”节能模式开关”,而不是需要针对每种工作流类型做适配的参数。
这个发现的意义在于:如果你运行的混合负载同时包含搜索和链式摘要,降低功耗上限对两种负载的节能效果是接近的(百分比级别),但调整 batch size 对搜索有 2.6 倍改善,对摘要却可能是负面的。优化策略的有效性梯度是:先根据工作流类型决定 batch size 策略,再用功耗上限做全局微调。
五、从 batch size 到依赖感知
这份论文最值得被记住的判断是:单请求基准测试漏掉了多请求工作流中最关键的变量——请求间的依赖关系和前缀复用率[1]。当一个基准测试告诉你”batch size 越大 efficiency 越好”时,这个结论在三种工作流里只对了一种。
站在推理系统设计的角度看,这个结论指向一个结构性问题:当前的推理服务系统在设计 batch 策略时,几乎完全看不到应用层的依赖结构。vLLM 的连续批处理不区分请求之间的因果关系;Parrot 试图弥补这个缺口,但代价是需要应用层提供侵入式的语义标注。在两个选择之间,还存在一个未开垦的地带——推理引擎是否可以通过观测请求间的 token 重叠模式,自动推断前缀共享结构,而无需应用层的显式标注?
论文的实验设置在规模上有限(单卡 A100、Llama-2-7B),但这篇论文的价值不在于性能数字本身,而在于它建立了一个衡量框架。在多请求工作流成为 LLM 应用主流的 2026 年,用一个只适用于独立请求的能耗模型去指导系统设计,误差不是在百分比级别,而是在方向级别——你可能正在用正确的 batch size 优化一个错误的工作流。
参考资料
[1] Characterizing Performance-Energy Trade-offs of Large Language Models in Multi-Request Workflows
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。