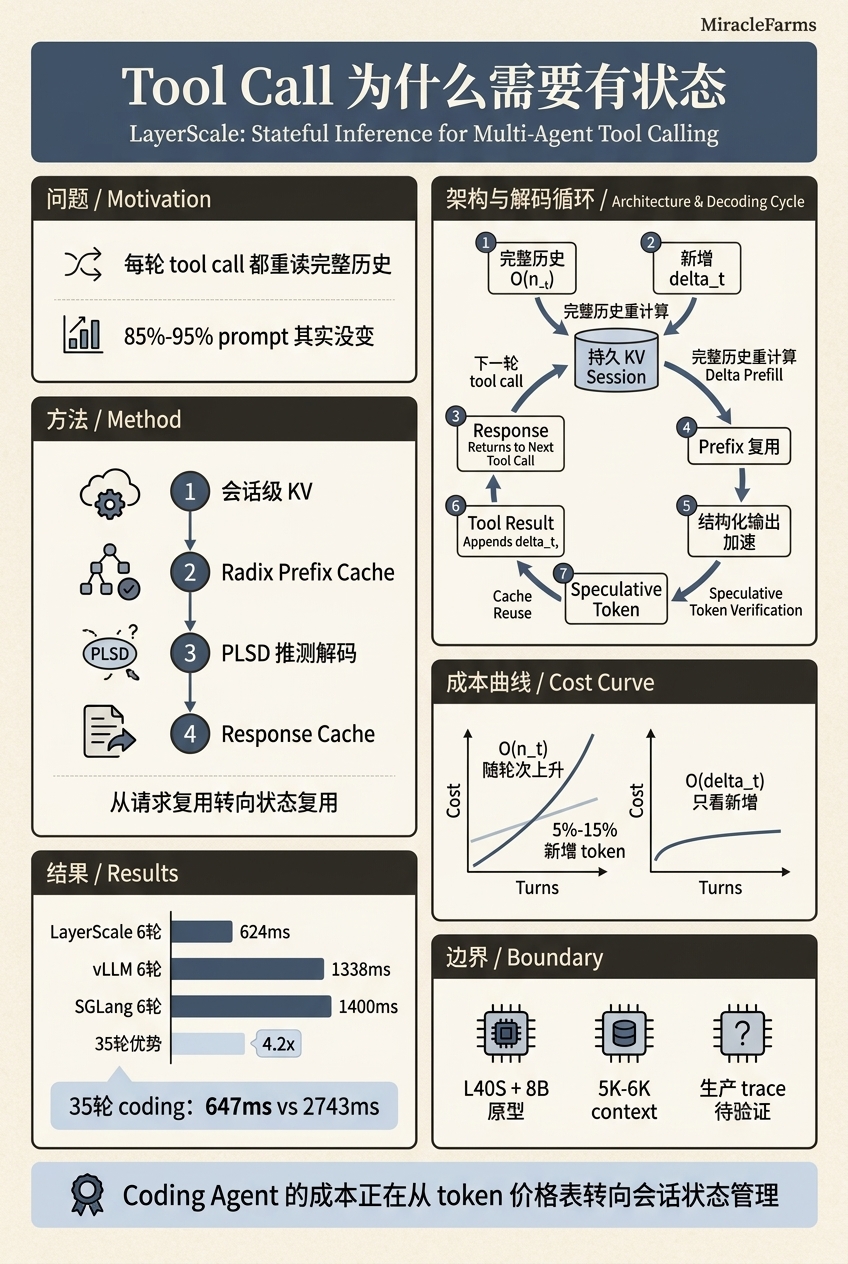
图 0:LayerScale 这篇论文的核心问题是把 tool call 的成本单位从完整历史 O(n_t) 改成新增片段 O(Δ_t)。这张信息图把会话级 KV、Radix Prefix Cache、PLSD 和 Response Cache 放在同一条状态复用链路里。
一次 Claude Code 会话跑完一个 bug fix,可能涉及 35 次模型调用。每次调用前,系统把从会话开始到此刻的完整对话历史重新 prefill 一遍——尽管第 34 轮到第 35 轮之间,prompt 里新增的 token 还不到总量的 15%。这里暴露的是推理引擎对 agentic 负载的根本性误配。
LayerScale 的这篇论文[1]用一句话总结了这个问题:现有推理框架把每个 tool call 当作独立请求,对单次调用做极致优化;agentic 负载的瓶颈落在跨调用的重复计算上。他们给出的答案是”有状态推理”——让 KV cache 跨请求存活,每次只处理新增 token。在 35 轮 coding 任务中,这个改动把端到端墙钟时间从 64 秒砍到 31 秒。
一、O(n_t) 到 O(Δ_t):成本单位换了一条路径
理解这个变化之前,先看当前的工程现实。一个多轮 agent 会话中,每一轮的 prompt P^{(t)} 都是前一轮 prompt 的严格扩展:[P^{(t-1)}; assistant输出; tool结果; 新user消息]。这个单调增长的性质意味着没有 token 会被重写——每一轮只是在末尾追加。
现有推理框架(vLLM、SGLang)的 prefix caching 能利用这种重叠吗?部分能。但它们把每个请求视为独立生命周期的单元:请求到达 → prefill 全部 prompt → decode → 返回。即便 prefix cache 命中了部分 token,系统仍然以”一个完整请求”为单位管理 KV cache 生命周期。请求结束后,该请求的 KV cache 进入 LRU 队列,随时可能被驱逐。
LayerScale 的方案不同:KV cache 不绑定到请求,而是绑定到会话。一个持久 session 承载了多轮对话的全部 KV 状态,每轮只 prefill 本轮新增的 Δ_t 个 token。这不仅是性能优化,更是一种架构选择——把 KV cache 的生命周期从 request-level 提升到 session-level。
per-turn 成本从 T_prefill(n_t) + m·T_decode 变为 T_restore + T_prefill(Δ_t) + ⌈m/(k+1)⌉·T_decode。其中 k 来自 prompt-lookup 推测解码——扫描最近 token buffer 找到最长的后缀锚定 n-gram 匹配,提出 batched speculative draft,在一个 forward pass 中验证多个 token。
对于 tool calling 场景,Δ̄/n̄ 约在 0.05-0.15 之间。这意味着 per-turn prefill 成本降低了一个数量级。
二、九个组件,一个核心假设
LayerScale 将系统拆为九个集成的组件,其中最关键的三个相互支撑:
Radix Prefix Cache。它在 token 序列上做元数据级别名化(metadata-only sequence aliasing),比“匹配前缀就复用”的直觉更进一步。当新请求到达时,调度器会重写新序列的 page table,让它指向已有序列的 KV cell——这个操作的时间复杂度是 O(1),与前缀长度无关。这解决了跨 agent 的缓存共享:当多个 agent(Travel Planner、Code Reviewer、Data Analyst)共享同一个 system prompt 和 tool schema 时,只需一次 prefill。
Prompt-Lookup Speculative Decoding(PLSD)。PLSD 不依赖额外的 draft 模型,而是在当前序列的最近 token buffer 里做匹配——计算开销接近零。论文举例:如果预测到 k=11 个 JSON token,那么生成 m=20 个 token 只需要 2 次 batched decode;常规路径则需要 20 次 sequential decode。在 tool calling 场景中,输出往往是高度结构化的 JSON 或代码片段,这种局部重复性使 PLSD 特别有效。
Response Cache。FNV-1a 哈希 → 确定性的种子 → 完全相同的 prompt 直接返回缓存响应,不经过任何 GPU 计算。这适用于多 agent 场景下的重复子请求——例如 Code Reviewer agent 循环检查同一段代码不同版本时的固定前缀。
这九个组件的共同假设是:agentic 负载的 prompt 可预测性和重复性远高于 chat。如果一个架构正确地管理了会话状态,不再每次从零开始,agentic 服务就会显露出状态管理密集型的特征。
三、35 轮的差异
论文的 benchmark 设计有一个关键细节。测试负载是 3 个并发 agent,每个 5 轮交互,各自携带不同的 tool schema(Travel Planner 有 5 个工具,Code Reviewer 有 5 个,Data Analyst 有 5 个)。每个 agent 有约 200 token 的 system prompt 和 tool 定义。
在 6 轮 novel 工作流中,LayerScale 的 median per-turn 延迟是 624ms,vLLM 是 1338ms(2.1 倍),SGLang 是 1400ms(2.2 倍)。
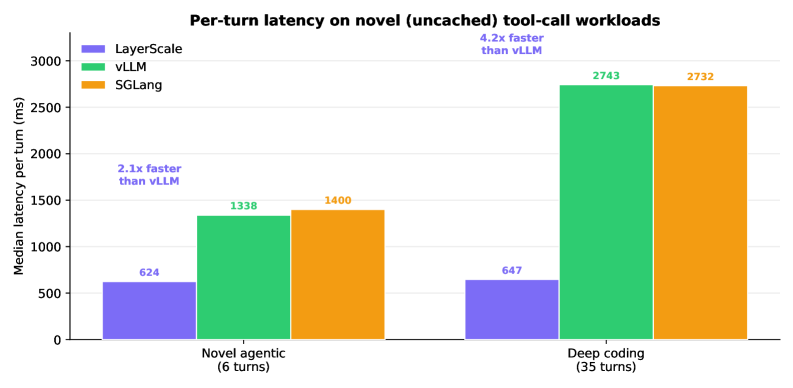 图 1:三种推理引擎在 novel 工作流上的 per-turn 延迟对比。LayerScale 在 6 轮任务上达到 2.1× 优势,该差距随轮数增长而放大。(来源:论文 Figure 1)
但真正的差异在更长的任务中才浮现——35 轮 coding 工作流中,median per-turn 延迟维持在 647ms,而 vLLM 和 SGLang 分别涨到 2743ms 和 2732ms,差距拉开到 4.2 倍。
这个差距来自两个来源。第一,per-turn prefill 成本的差异随 n_t 增长而放大——第 35 轮时,vLLM 需要 prefill 约 35×150=5250 token 的完整历史,LayerScale 只需要 prefill 新增的约 150 token。第二,vLLM/SGLang 的 prefix cache 在长时间执行中会面临驱逐压力——LRU 策略不知道哪些 prefix 在下一次工具调用后还会被用到。
论文专门用 8-way burst 编排(40 个请求跨 5 次迭代)测试了尾延迟:LayerScale 的 p99 tail 比 vLLM/SGLang 低了一个数量级。这暗示在真实的 multi-agent 部署中,bursty 并发模式下的 tail latency 才是用户体验的信噪比——而不仅是 median。
四、这个方向的前置条件
必须实话实说:LayerScale 这篇论文的 benchmark 规模有限。测试环境是一块 L40S(48GB GDDR6),模型是 Llama-3.1-8B-Instruct。35 轮 coding 工作流的总上下文约在 5K-6K token 量级,远小于 SWE-bench Pro 上 80K token 量级的真实场景。
但方向上它是正确的。在更大的上下文和更多轮次上,O(n_t) 和 O(Δ_t) 的差距只会更大,不会收敛。论文还把这项工作定位为对 Anthropic Prompt Caching 的继承和扩展(Anthropic 的方案是二元的——要么命中要么重新计算——没有部分命中,没有跨 agent 共享)。
从推理引擎设计的角度看,这篇论文提出了一个深刻的问题:KV cache 的生命周期应该以什么为单位? 如果答案是”会话”,整个 memory management 栈——从 PagedAttention 的 block table 到 LRU eviction policy——都需要为持久状态做出调整。这比加一个 cache 层要深远得多。
参考资料
[1] Stateful Inference for Low-Latency Multi-Agent Tool Calling — LayerScale, Inc.
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。