PD 分离架构已经是现代 LLM 推理的事实标准——prefill 和 decode 各用各的 GPU,互不干扰。但这套架构的隐含假设是:prefill 侧的瓶颈在算力,不是 I/O。Agent 负载把这个假设打碎了。
当模型在 agent 场景里跑上百轮交互、每轮只追加几百 token 时,KV cache 的加载速度取代 FLOPs 成为吞吐上限。DualPath 是 DeepSeek-AI 联合北大、清华在 2026 年 2 月提交的论文[1],它指出了这个瓶颈并给出了一套可落地的工程解法。这篇论文更值得关注的地方在于:它不是提出了一个新想法,而是指出一个已经被广泛部署的架构在面对新负载时暴露出结构性问题——所有 prefill engine 的存储 NIC 被 KV 加载打满,而 decode engine 那一侧的存储 NIC 在发呆。
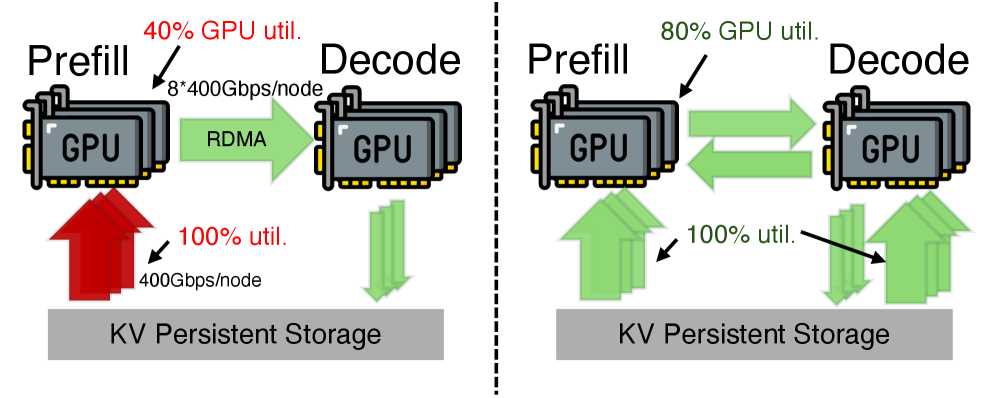
图 1:左侧为现有 PD 分离架构下 KV cache 仅从存储加载到 prefill engine 的瓶颈;右侧为 DualPath 引入双路径后的数据流。来源:论文 Figure 1。
一、Agent 负载为什么把 PD 分离推到了极限
论文用从生产环境采集的 agent trace 回答了这个问题。500 条编码任务的轨迹,平均 157 轮交互,上下文长度均值 32.7K token,但每轮新增的 append 长度只有 429 token。这意味着 KV cache 命中率高达 98.7%——几乎所有历史 token 都已经算过了,需要重新 prefill 的只有新增的那一小段。
这对 PD 分离架构意味着什么?DeepSeek-V3.2 在 append 429 token 的场景下,cache-compute 比率约为 22 GB/PFLOP——每做 1 PFLOP 的计算,就需要从存储读取 22 GB 的 KV cache。在这组数字面前,计算本身已经不是瓶颈了,瓶颈在存储 I/O。论文的 Table 1 进一步显示,对于 KV cache 尺寸更大的模型(如 Qwen2.5-32B 的 FP16 KV),这个比率在 16K–64K 上下文范围内达到 117–267 GB/PFLOP——比 DeepSeek 的 MLA 压缩 KV 高出约一个数量级。
但单一的 cache-compute 比率还不足以解释为什么这是一个系统级问题。论文指出了三个叠加因素:
第一层,硬件演化方向对 agent 负载不利。从 NVIDIA Ampere 到 Blackwell,GPU 算力增长了远超带宽的倍数,I/O-compute 比率下降了 14.4 倍。每 FLOP 能配给的网络带宽越来越低,而 agent 负载恰好需要大量 I/O。
第二层,PD 分离架构中只有 prefill engine 从存储加载 KV cache。所有存储 I/O 压力集中在 prefill 侧的 SNIC,decode 侧的 SNIC 几乎空转。这是一笔被浪费的全局带宽。
第三层,计算网络(compute NIC / CNIC)的聚合带宽远大于存储网络,且集体通信(AllToAll、ReduceScatter 等)以 sub-ms 间歇性爆发——两次通信 burst 之间有大量空闲带宽可以被利用。
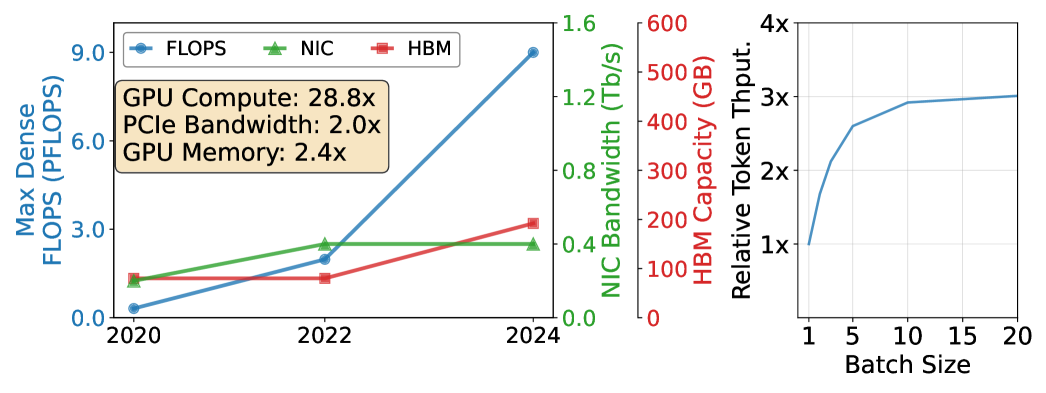
图 2:左为 NVIDIA 各代 GPU 的 I/O-compute 比率变化,从 Ampere 到 Blackwell 下降 14.4×;右为不同 batch size 下 30K 上下文请求的相对吞吐。来源:论文 Figure 3。
二、DualPath 的核心设计:decode 端的存储 NIC 不该闲着
论文的方案简洁得不像一篇系统论文的典型风格:把 KV cache 从 “存储 → prefill engine” 的单一路径,扩展为同时支持 “存储 → decode engine → RDMA → prefill engine” 的双路径。
PE Read Path(传统路径)不变:prefill engine 从分布式存储读取 KV cache 到主机 DRAM,逐层搬运到 GPU HBM 参与 attention 计算。DE Read Path(新增路径):decode engine 从存储读取 KV cache 到自己的 DRAM,再在 prefill 执行期间通过计算网络 RDMA 逐层传递给 prefill engine 的 GPU。
数据流在两种路径之间的选择和融合已经有成熟的先例——PPD 把 append-prefill 调度到 decode 本地[2],LMCache 在 DRAM 和 SSD 之间做分层[3],Mooncake Store 把分布式 DRAM 变成集群级 KV pool[4]。但 DualPath 的不同之处在于:它不是把 KV cache 放在更快的存储层里,而是利用现有的 decode 端带宽资源。不需要新硬件,不需要扩容存储链路,只需要改变数据从哪里进入集群。
论文做了一组 bottleneck-free 分析来确定这种设计在什么 P/D 比例下成立。对于标准的 8 GPU 节点、每节点 1 条 400 Gbps 存储 NIC 的配置,DualPath 在 1/7 ≤ P/D ≤ 7/2 范围内是 bottleneck-free 的——这个区间覆盖了绝大多数生产部署的 P/D 比例,从 prefill-heavy 到 decode-heavy 都在其中。超出这个范围(比如极端的 1P8D)DE CNIC 会成为新瓶颈,这不是论文要回避的边界,而是它明确标记出来的适用条件。
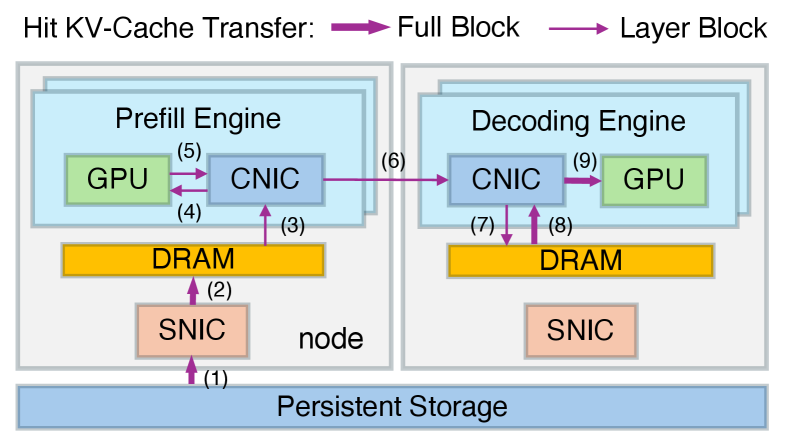
图 3a:PE Read Path — KV cache 从存储直接加载到 prefill engine,再传输到 decode engine 的 buffer。来源:论文 Figure 4(a)。
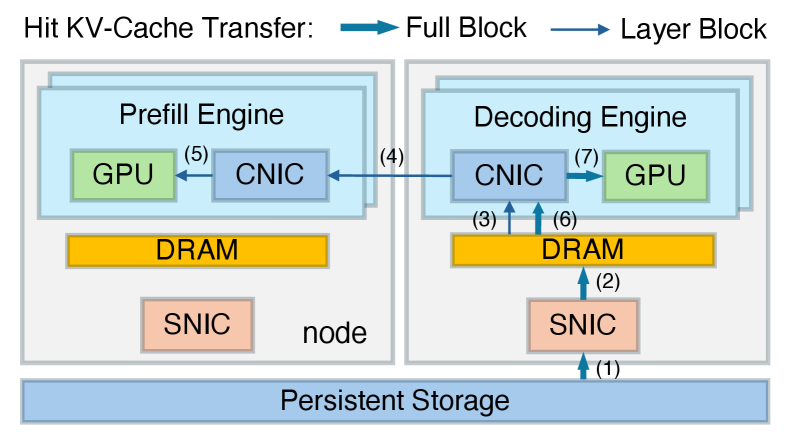
图 3b:DE Read Path — KV cache 先加载到 decode engine DRAM,再通过计算网络 RDMA 传递给 prefill engine。来源:论文 Figure 4(b)。
三、生产中的两道坎:流量隔离与双层调度
光有双路径设计是不够的。引入 DE Read Path 意味着 KV cache 传输流量进入了计算网络——和 AllToAll、AllGather 等延迟敏感的集体通信共享同一条 InfiniBand 链路。论文在这个问题上的处理方式带有明显的生产经验痕迹。
CNIC-Centric Traffic Manager 是论文的流量隔离方案。核心理念:所有进出 GPU 的数据——包括 H2D/D2H 拷贝和 KV 传输——统一走 CNIC 的 GPUDirect RDMA 路径,不直接使用 PCIe 或 GPUDirect Storage 绕过控制点。这样做的代价是数据多绕了一圈(从存储到主机 DRAM,再到 CNIC,再到 GPU HBM),但换来的是可以利用 InfiniBand Virtual Lanes 做 QoS 隔离。论文配置了 99% 高优先级带宽给模型推理通信,1% 低优先级带宽给 KV cache 传输——后者在任何时刻都不能抢前者的链路。
这组参数要成立的前提是:KV 传输量相对于集体通信量足够小,且接受偶尔的饥饿延迟。论文在 2P4D 的实验中验证了这个前提——1% 的低优先级带宽足以让 KV 传输找到间歇性空闲窗口,而 99% 的高优先级足够让集体通信保持不受干扰。
Adaptive Request Scheduler 解决的是双路径带来的调度复杂度。调度器从每台 engine 收集三个信号:seq_e(未完成请求数)、tok_e(未完成 token 总量)、read_q(所在节点的磁盘读取队列长度)。PE 调度按磁盘队列长度把 engine 分成短队列组和长队列组,优先把请求分配给短队列组的 engine 以防止存储 NIC 空转。KV 读取路径的选择简单直接:哪一侧的磁盘读取队列更短,KV cache 就从哪一侧加载。论文承认更优的做法可能是把一个请求的 KV 拆成两部分从两侧同时读取,但当前版本用了更保守的”全量单侧”策略。
四、1.87× 离线、1.96× 在线——这些数字意味着什么
论文的核心评估基于三组模型(DS 660B、DS 27B 缩小版、Qwen2.5-32B)和三组 agent trace(32K/48K/64K 最大上下文)。所有实验跑在 Hopper GPU + InfiniBand + 3FS 分布式存储的集群上。
离线推理(对应 RL rollout 场景):在 DS 660B 上,DualPath 相比 Basic(不加双路径的同一推理框架)吞吐提升最高 1.87 倍。在 2P4D 配置下随着 agent 数量和最大上下文长度增长,收益持续放大——更长上下文意味着每轮需要加载的 KV cache 更多,双路径的优势更明显。Qwen 32B 的趋势类似,只是 1P2D 的绝对带宽池更小。
影响 DualPath 收益幅度的两个关键因素:append 长度和 generation 长度。Append 越短、generation 越短,KV 加载占总延迟的比例越高,DualPath 的收益越大。论文通过缩放 append 长度因子验证了这一点——append 长度乘以 2.0× 后,Basic 性能逐渐接近 DualPath,因为计算压力上升拉平了 I/O 瓶颈的相对比重。
在线服务:DualPath 在 DS 660B 上 average throughput 提升 1.96 倍(最高 2.25 倍),且 TTFT 和 TPOT 的 SLO 未被破坏。TTFT 可以稳定在 4 秒以内,TPOT 不超过 50ms——这说明双路径的 KV 传输延迟没有外溢到用户侧。TPOT 与 Basic 持平进一步验证了 CNIC-centric 流量隔离的有效性:KV 传输确实没有干扰到 decode 阶段的模型推理通信。
大规模延展性:从 2P4D(2K agent,3167s)扩展到 48P96D(48K agent,3201s),完成时间几乎持平——增加 24 倍 agent 数、增加 24 倍硬件,总完成时间仅增加 1%。这不是完美的线性扩展,但在 144 台节点的规模上已经足够说明:DualPath 的双路径设计没有引入随集群规模增长的非线性开销。
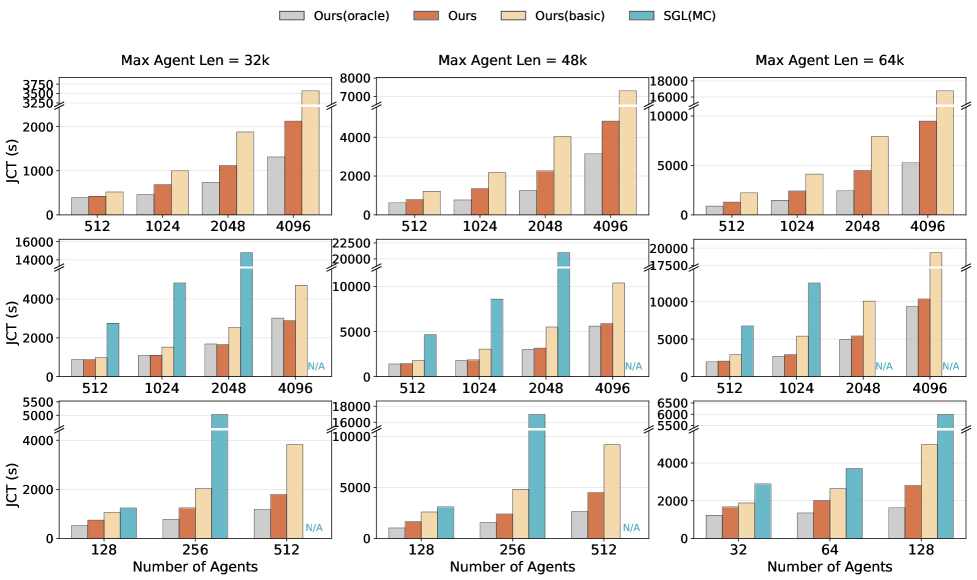
图 4:离线推理 job completion time,三组模型在 varying agent 数量和最大上下文长度下的表现。N/A 表示 SGLang 在该配置下未能完成。来源:论文 Figure 7。
五、这篇论文最值得记住的地方
DualPath 不是一个花哨的系统论文。它的贡献不在于提出一个新的存储层或新的压缩算法,而在于指出并解决了一个被现有架构假设掩盖的瓶颈——PD 分离论文和框架讨论 KV 传输时关心的是 prefill→decode 的 KV 交接延迟,DualPath 关注的是 decode→prefill 方向上的机会。
从工程角度看,这篇论文的三层论证结构值得注意。第一层是现象识别:agent 负载的高 hit rate 把瓶颈从算力推到 I/O。第二层是设计原则:不是加硬件,而是利用闲置带宽——解码端存储 NIC 的带宽、计算网络间歇性空闲的带宽。第三层是可行性验证:QoS 隔离确保 KV 传输不干扰推理通信,双层调度确保两条路径不会互相踩踏。
边界意识也是这篇论文吸引人的地方。Bottleneck-free 分析明确标注了 1/7 ≤ P/D ≤ 7/2 的成立范围;论文承认 DE buffer 通过 H2D 引入了额外 DRAM 压力,建议未来用 GPU Direct RDMA 消除这个代价;在线实验中 DS 27B 的 TPOT 明显高于 Oracle,说明 P-D 传输本身在小模型情况下仍有优化空间——这些都是诚实标记,不是模糊带过。
论文没有回答的一个问题是:当 P/D 比例需要动态调整时(弹性伸缩场景),DualPath 的 bottleneck-free 边界能否随比例变化自动重新配置? 论文的调度器已经能感知磁盘队列和 token 负载,但 bottleneck-free 分析是离线静态推导,没有接入调度器作为在线约束。如果预填充池被剥离了一半节点,剩余的 P/D 比例可能掉出 1/7 的下界——调度器应该做什么?这是留给后续工作的题目。
站在 2026 年 5 月的时间点看:Claude Code 的 context management、Dynamo 的 KVBM 四层存储、LMCache 的分层 KV pool——这些系统都在不同的维度上优化 KV 存储,但 DualPath 是第一个从存储网络带宽的分配不对称角度切入的工作。它的核心洞察——agent 负载下 PD 分离的瓶颈已经不在算力,而在存储 I/O 的全局分配效率——值得被记住。
参考资料
[1] DualPath: Breaking the Storage Bandwidth Bottleneck in Agentic LLM Inference
[2] PPD: Prefill-Push Decoding for Efficient Multi-Turn LLM Serving
[3] LMCache: Lossless Long-Context LLM Inference via Progressive Speculative Caching
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。