一个 SWE-bench 任务跑完之后,你可能以为系统瓶颈在 GPU 推理上。但在这 50 次 LLM 调用之间,agent 在同一个 CPU 上跑了 50 次 bash 命令——git diff、pytest、grep、sed。这些操作的执行时间构成了端到端延迟的不可忽略部分,而现有推理引擎对它们几乎视而不见。
Duke 团队的 MARS[1] 用一句话点出了这个设计的结构性缺陷:agentic 负载在时间维度从单轮推理变成了多轮 LLM-tool loop,在空间维度从 GPU-only 变成了 GPU-CPU 混部。任何只看 GPU 侧的调度器,在 agentic 负载下都会系统性低估资源压力。
一、两个维度的转变
时间维度的转变比较直观。传统 chat 负载:一个请求 → 一次 prefill → 一次 decode → 结束。Agentic 负载:一个会话 → 数十到数百轮 LLM-tool loop,每轮的工具执行时间(bash 命令、文件读写、代码搜索)是 LLM 推理时间的 2-29%。这个比例不高,但它是不可并行化的关键路径——下一轮 LLM 调用必须等待工具结果返回。
空间维度的转变才是 MARS 最独特的观察。在典型的生产部署中,agent 的工具执行不是跑在独立的远程服务上,而是跑在与推理引擎共享同一宿主 CPU 的 Docker 沙箱里。这意味着每轮工具调用都在消耗 CPU cycles,而这些 cycles 本该用于推理引擎的请求调度、KV cache 管理、tokenization 和网络 I/O。
MARS 把这种关系描述为异构资源压力传导。如果 GPU KV cache 因为驱逐了活跃前缀而需要重新 prefill,这个额外计算会延长 LLM 调用时间,推迟工具执行的启动。反过来,如果 CPU 因为工具执行过载而延迟返回结果,LLM 调用后续轮次也会推迟。一个维度的拥塞会放大另一个维度的拥塞——这不是两个独立资源的问题,而是一个耦合系统的问题。
二、三层架构:信息流 → 控制平面 → 调度器
MARS 由三个组件组成,按功能分层:
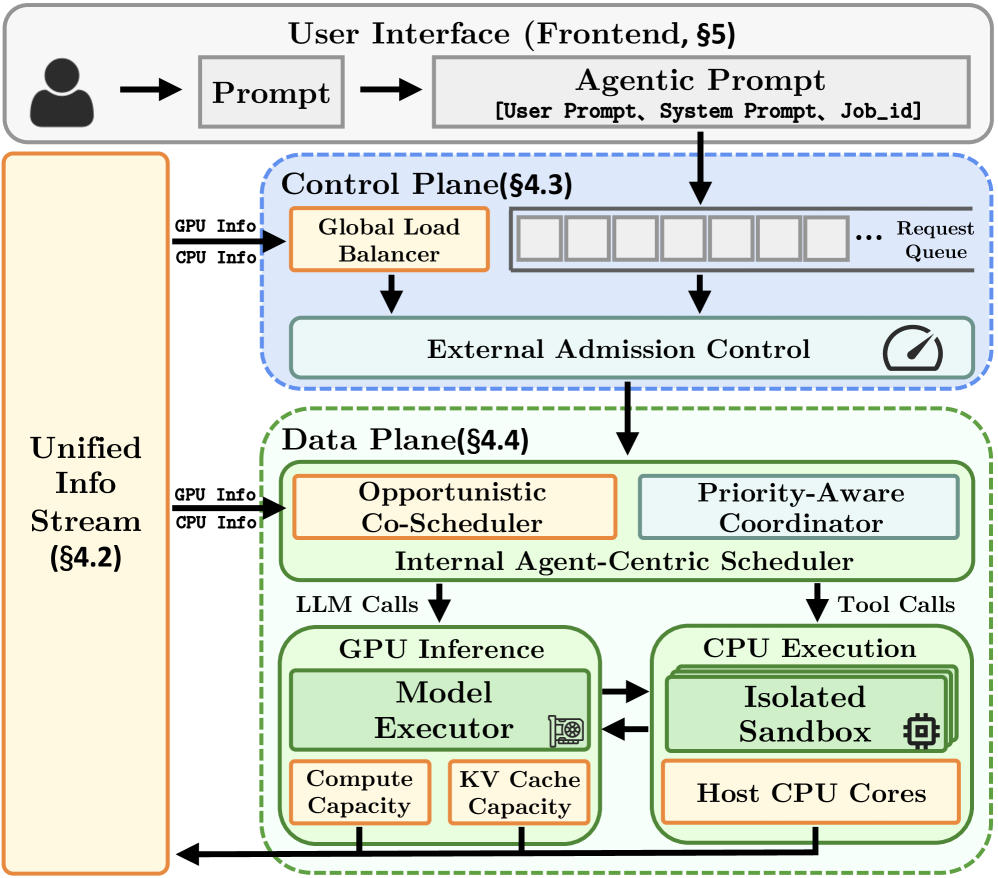 图 1:MARS 三层架构概览——信息流、控制平面、调度器。(来源:论文 Figure 4)
统一信息流(Unified Information Stream)。这是 MARS 的眼睛。它持续采集两组压力信号:GPU 侧——KV cache 使用率、可用 block 数量;CPU 侧——并发工具执行数量、各工具的平均执行时长。这些信号的采集被设计为对 token 处理零干扰——遥测不走推理的关键路径。
外部控制平面(External Control Plane)。这是 MARS 的大脑。它运行一个 AIMD(加性增加/乘性减少)+ 滞后的控制循环,动态调整接纳窗口的宽度。窗口大小决定了当前允许同时运行的会话数。当 GPU 和 CPU 的双侧压力都在安全阈值以下时,窗口缓慢扩大(+1);任一维度过载时,窗口乘性缩减(×0.5)。滞后机制避免了压力信号噪声导致的窗口震荡。
控制平面最关键的决策是接纳与执行解耦。传统的推理引擎在请求到达时立即为其分配资源——如果资源不足就排队或报错。MARS 的接纳只是一个准入许可,实际的 GPU/CPU 资源分配延迟到该会话的下一轮 LLM-tool loop 实际需要执行时。这种解耦让调度器能够在全局范围内看到”接下来即将到来的”压力,而不是”已经到达的”压力。
内部 Agent-Centric 调度器。这是 MARS 的手。它对等待执行的 continuation(agent 的下一次 LLM 调用)按三个因素排序优先级:初始 KV 占用(越低越优先,因为 prefill 更便宜)、累积服务时长(越高越优先,因为已投入的资源更多)、等待时间(越高越优先,防止饿死)。这个排序的目标在关键路径上最小化端到端延迟——优先让已经在跑的工作流尽快跑完,而不是最大化瞬时吞吐量。
KV cache 管理也是这个调度器的一部分。MARS 对每个会话执行一次动态检查:如果重新 prefill 前缀的时间严格超过工具阶段的时长,就保留 KV cache;否则驱逐。这个决策不像现有系统那样是二选一的——它根据工具阶段时长变化而动态调整。在 agent 探索阶段(部分工具失败,大量 read 操作),工具阶段短,驱逐更激进;在 agent 执行阶段(编辑代码、跑测试),工具阶段长,缓存更保守。
论文还提到一个有意思的细节:当 KV cache 碎片化导致无法分配连续 block 时,协同调度器将 prefill chunk 降到单 batch 级别——不报错,只是瞬时降速。这是一种优雅降级——把 transient 碎片化变成暂时的服务质量下降,而不是硬失败。
三、数据说了什么
MARS 在五个 benchmark 上评估:SWE-bench、GitTaskBench、Terminal-Bench、RepoBench、∞Bench。模型用 Qwen3-Coder-30B 和 GPT-OSS-120B。结果中三个数字值得注意。
5.94 倍。H200 + Qwen3-Coder-30B 配置下,MARS 相比最强基线(Continuum-Dy)的端到端延迟降低。
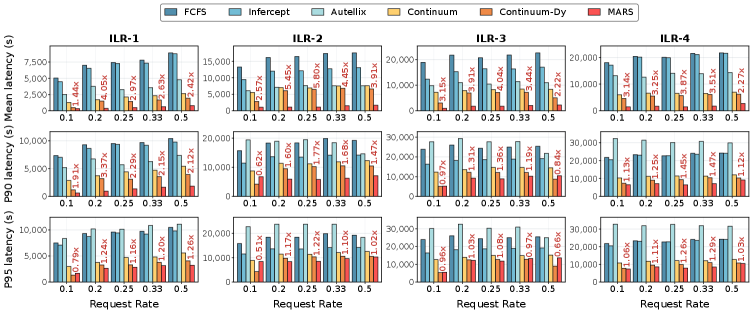 图 2:MARS 与四个基线在四种 ILR 配置下的端到端延迟(mean + P90 + P95)。在长上下文 regime 下优势最大。(来源:arXiv 2604.26963, Fig 7)这个倍数在不同的输入长度 regime(ILR-1 到 ILR-4,从短上下文到超长上下文)之间差异很大——在短上下文下倍数较小(1.44 倍),在长上下文下倍数更大(5.80 倍)。这说明 GPU-CPU 耦合压力随着上下文增长而非线性放大。
2-3 倍。SLO-aware 有效吞吐量。在 ILR-1 regime(短上下文),MARS 的有效吞吐量是最佳基线的 2-3 倍。在 ILR-2 到 ILR-4 下,基线的有效吞吐量趋近于零(因为无法在 SLO 内完成任何任务),而 MARS 维持在了 0.015-0.018 req/s。这不是”更快”,这是”能做”和”不能做”的区别。
1.87 倍。OpenHands 真实部署中的任务完成加速。这不是微基准,而是把 MARS 直接作为 OpenHands coding agent 框架的 serving backend,跑真实任务。这个数字虽然看起来比 5.94 倍小,但它的含义更重——它排除了 benchmark 构造偏差,证明 GPU-CPU 协同调度在真实 agent 系统中确实有可测量的收益。
四、这条线的意义
MARS 不是第一篇讨论 agentic 推理调度的论文,但它是第一篇把 GPU-CPU 耦合作为一等系统设计问题的论文。在 MARS 之前,工具执行时间要么被忽略(假设它远小于推理时间),要么被外推到独立的工具执行服务(不存在资源竞争)。
这种耦合在未来的 agentic 负载中只会更强,不会减弱。当 agent 从”单文件 bug fix”进化到”跨文件重构 + 测试 + 部署”时,工具执行时间占比会上升,CPU 压力会更不均衡。当多 agent 并发运行时,同一个 CPU 上可能同时跑着三个 Docker 沙箱——一个在 debug,两个在跑 test suite。
MARS 的一个限制值得说清楚:它的实验环境将工具执行绑定在相同的宿主 CPU 上,这与很多云部署中推理引擎和工具沙箱物理分离的架构不同。在远程工具执行的场景下,CPU 竞争的模式变化了,但压力传导的基本逻辑不变——只是 CPU 换成了网络延迟。
从评估的角度看,MARS 间接提出了一个更底层的问题:agentic 推理系统的 benchmark 是否需要把工具执行环境也包含进去? 如果答案是肯定的,那么 SWE-bench 或 Terminal-Bench 的挂载方式就需要从”评价 agent 质量”扩展到”评价整个 serving stack 的性能”。
参考资料
[1] MARS: Efficient, Adaptive Co-Scheduling for Heterogeneous Agentic Systems — Duke University
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。