一篇聊 KV cache 量化的文章,最常见的开场是”KV cache 显存占用量太大,所以需要压缩”。这个逻辑对 chat 场景成立——一次调用上下文可能就 2K token,均匀量化到 INT4 或 FP4,精度损失几乎不可感知。但 Agent 场景不是这样。
一次 OSWorld 的 computer-use 任务跑下来,LLaMA-3-70B 的 KV cache 就接近 100K token,FP16 下光是 KV cache 就已经 30 GB。关键是,这 100K token 不是均质的文本——它们来自不同模态(文字 + 截图)、分布在不同时间(从 system prompt 到最近一次 tool 调用)、扮演不同语义角色(指令、推理、工具调用、环境观测)。一旦你开始对这些 token 一视同仁地压缩,那些最脆弱的片段——比如 tool schema 的定义——会最先崩溃,而 chat 场景里根本不会遇到这种问题。
剑桥大学这篇 TriAxialKV[1] 就是冲着这个结构差异来的。它不从”怎么压得更狠”出发,而是先问:在 Agent 的 KV cache 里,哪些 token 扛得住 2-bit 量化、哪些必须保留 4-bit? 答案藏在三个彼此正交的轴上。
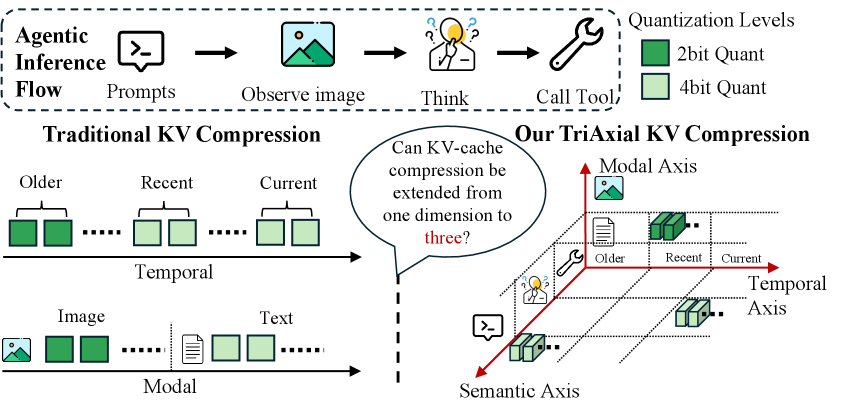
图 1:已有的 KV cache 量化方案多沿单一维度做混合精度分配——PM-KVQ 按时间、VL-Cache 按模态——TriAxialKV 把三个轴同时纳入分配决策。来源:论文 Figure 1。
一、三轴标签:为什么 Agent 的 KV 是结构化的
先想一个 chat 请求的 token 构成:system prompt 一小段,user 一句话,assistant 回一段。文本模态,单轮或两轮,没有 tool call,没有观测结果回灌。对量化器来说,这种 KV cache 内部的差异性不大——做个 per-channel 或 per-token 量化,精度基本够用。
Agent 请求完全不同。一个典型的 OSWorld 轨迹里,请求的 prefill 包含以下片段:system prompt + tool schema 定义、用户指令、模型推理(<think> 标签内的 CoT)、tool call 调用(<tool_call> 内的 JSON)、环境返回的观测结果(包括截图)、delimiter token(聊天模板的结构标记)。每个片段在 attention 计算中的敏感度相差一个数量级以上。
TriAxialKV 用一个三轴标签体系对每个 prefill token 打标:
- 时间轴:
current(当前轮)、turn_m1(上一轮)、turn_m2(上两轮)、older(更早)。attention 随轮次衰减,直觉上较早的轮次可以承受更激进的压缩。 - 模态轴:
text或image。视觉编码器产出的 token 与语言模型 embedding 的统计分布不同——per-channel variance 和稀疏度都有差异,对低比特量化的响应也不同。 - 语义轴:
inst(system prompt + tool schema)、user、assistant、reasoning(CoT 跨度)、tool_call、obs(环境反馈)、delim(结构标记)。这七个角色覆盖了 Agent loop 的完整功能语义。
关键设计决策:这三个轴的标签都可以从聊天模板中解析出来,不需要任何模型推理。 用 tokenizer 的 special token ID——角色标记、消息分隔符、<think> 和 <tool_call> 的结构括号——在一遍扫描中完成全部打标。这比 ThinKV[2] 那种需要内容理解的 thought/non-thought 拆分更轻量,也比 VL-Cache[3] 单纯按模态分类更全面。
二、敏感度标定:为什么用 attention 输出误差而不是 KV 量化误差
有了标签体系,下一个问题是:怎么衡量一个 tag 的 token 被量化到 2-bit 或 4-bit 后的损失?
直觉做法是直接算 KV 值的量化 MSE。但论文指出,KV 量化误差与 attention 输出误差之间不是单调关系——一个 token 的 KV 量化误差可能很小,但如果 softmax 把注意力高度集中在它上面,输出误差会很大;反过来,一个 KV 误差很大的 token 如果几乎不被 attend,对最终输出的影响就微乎其微。加上非线性的 softmax 和 value 加权求和,KV 误差和输出误差之间的关系远比线性复杂。
TriAxialKV 的做法是直接从 attention 输出端测量:在校准集上捕获 KV cache,对每个 tag 的 token 分别量化到 2-bit 和 4-bit,replay attention,记录输出 MSE 相对于 FP16 参考的偏移量。这样得到的是一个 |tag空间| × 2 的敏感度表格——每个 tag 在两个比特宽度下各有一个失真值。
校准分为三步:① 在模型前向过程中注册 hook,捕获每层 QKV 投影的输出;② 对每个活跃 tag 逐 token 量化并重放 attention,记录每层、每请求、每 head 的 MSE;③ 按 head 取 max(保证最敏感的 attention subspace 不会成为瓶颈)、按请求取 mean、按层求和,得到最终的 D_k(b) 值。
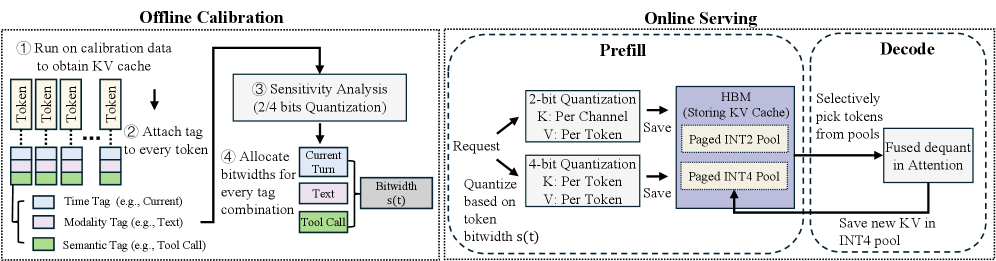
图 2:TriAxialKV 的两阶段系统流程。离线标定阶段按三轴标签测量每个 tag 的 attention 输出失真;在线服务阶段 CPU 打标 → Triton gather-dequant prefill → 融合的 Triton flash-decoding 在线反量化。来源:论文 Figure 2。
三、比特分配:贪心还是枚举
有了敏感度表格,分配问题就简化为:在目标平均比特宽度 B 的约束下,给每个 tag 分配 INT2 或 INT4,使总 MSE 最小。
形式化地:最小化 Σ D_k(b_k),约束 Σ N_k * b_k ≤ B * Σ N_k,b_k ∈ {2, 4}。N_k 是每个 tag 在 KV cache 中的 token 数量。
把 tag k 从 2-bit 升级到 4-bit 的成本是 2 * N_k 额外 bit,收益是 D_k(2) - D_k(4)。定义单位比特收益 ρ_k = (D_k(2) - D_k(4)) / (2 * N_k),按 ρ_k 降序排列,依次给每个 tag 升级直到预算耗尽。
论文的 tag 空间最大 4 × 2 × 7 = 56,去掉实际不会出现的组合(如 image|reasoning),可控在 22 以内。此时穷举 2^22 种配置也可接受;更大空间时用贪心。最终效果是 65–75% 的 token 被路由到 INT2,有效平均 bitwidth 约 2.6–2.7 bit,比 uniform INT4 的 4.0 bit 低了 35% 的存储开销。
四、系统实现与真实收益
TriAxialKV 不是一篇纯算法论文——它实现了一个完整的端到端 serving 系统,基于 SGLang v0.5.10[4] fork。
双精度内存池:INT2 和 INT4 两个 paged memory pool 共享一个虚拟地址空间,按启动时标定出的平均 bitwidth 比例做地址分界。地址低于 offset 的对应 INT2 池,高于 offset 的对应 INT4 池。下游的 attention backend 只需要一次比较就能判定 token 的精度。
融合 decode kernel:decode 阶段用自定义的 Triton flash-decoding kernel,分为 bitwidth-homogeneous 的并行 split——前部处理 INT2 KV,后部处理 INT4。每个 split 在 attention 计算过程中在线 unpack(通过位位移)和 dequantize。新生成的 token 总是写 INT4 池。
实测数据(Qwen3-VL-32B-Thinking + OSWorld):
- KV cache 容量:BF16 基线的 4.5 倍
- 端到端吞吐:B200 上 1.32×,H100 上 1.52×;H100 上增益更大,因为 HBM 带宽更受限,压缩带来的内存节省更能转化成有效 batch size
- 并发请求数:H100 上 3.4×(11.78 vs 3.46),B200 上 4.0×(118.82 vs 29.79)
- 精度:OSWorld 上比 BF16 高 0.6–1.8 个百分点(注意这不是精度损失——混合精度某些情况下甚至略优于 BF16 baseline);BFCL Memory 上在 BF16 的 ±1.1% 以内
对比基线,SGLang FP4 在 BFCL Memory 上表现极其不稳定:Falcon3-10B 上比 BF16 高 4.22 分,Qwen3-14B 上却低了 7.11 分——均匀低比特浮点量化与模型特定的权重和激活分布交互不可预测,这和论文对”均匀策略不适合 agent 负载”的判断一致。
KIVI[5](均匀 2-bit)在 BFCL Memory 上稳定亏损 4–5 分。差距的关键在于 inst 标签——system prompt 和 tool schema 在 KIVI 里被当成普通 token 压到 2-bit,但 BFCL Memory 的评分要求模型精确复现函数签名和参数名,KV 中的微小误差会传播到错误的参数名或类型,直接导致任务失败。 TriAxialKV 把 inst 标签分配到 4-bit,同时把其他低敏感度片段压到 2-bit,在总 bit 预算接近的情况下把关键 token 保护住了。
五、消融实验的教训:语义轴才是主战场
论文的轴消融实验给出了最清晰的信号。在 Qwen3-14B + BFCL Memory 上:
- 去掉语义轴(所有 token 视为同一角色):精度 -6.22 分
- 去掉时间轴(所有 token 视为同一轮):精度 -2.22 分
- 完整三轴:24.22 分
语义轴的损失大约是时间轴的 3 倍。这不是说时间轴不重要,而是说它解决的问题和语义轴有本质差异——时间轴让分配器可以把较早轮次的 token 激进压到 2-bit,因为 attention 集中在当前轮;语义轴则保护了那些绝对不能被压碎的 token 类型(inst、tool_call)。去掉语义轴意味着所有角色共享一个 bitwidth,最脆弱的 inst token 得不到额外的精度——而 inst token 里恰好存着 function signature,错误的参数名 = 错误的工具调用 = 任务失败。
平均 bitwidth sweep 也值得注意。从标定出的 2.7 bit 降到 2.6 再到 2.5,每 0.1 bit 的减少伴随约 5% 的精度损失。这说明 2.7 bit 不是随意选的保守值,而是一个真实存在的 knee point——低于它,即使是混合精度分配也无法补偿敏感 token 的精度赤字。
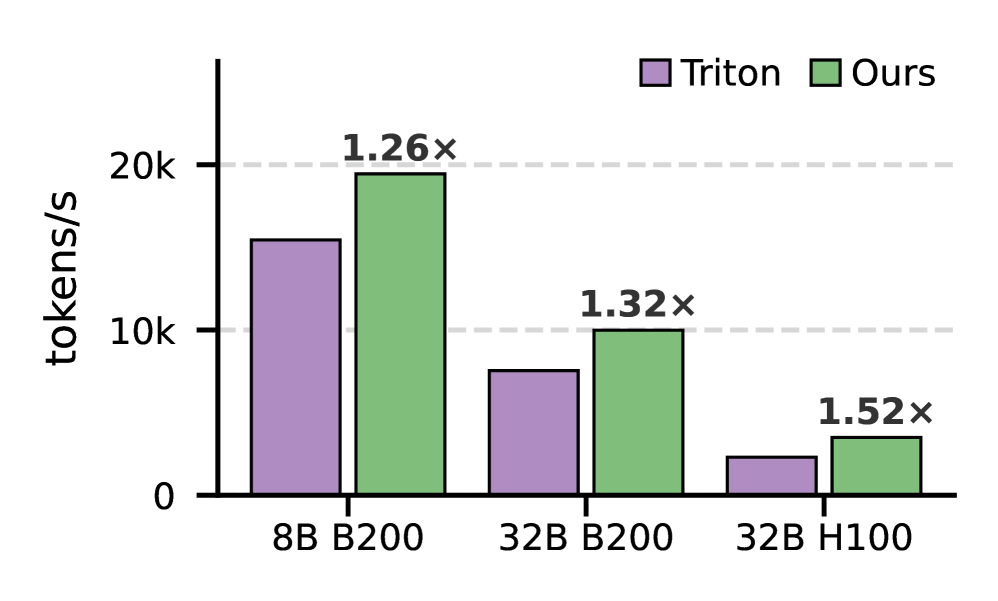
图 3:端到端吞吐量对比。TriAxialKV 在 B200 上达到 1.32×、H100 上达到 1.52× 的 BF16 baseline 吞吐量,H100 上增益更大印证了带宽受限 GPU 上量化收益的放大效应。来源:论文 Figure 5。
六、这篇论文最值得被记住的地方
回到开篇的问题——”哪些 token 扛得住 2-bit”——TriAxialKV 的答案比”哪些扛得住”更进一步:答案是结构化的,和 Agent 的对话模板结构直接对应,不需要模型跑一遍才知道。
这意味着量化策略可以从模型特异性的适配问题,退化为一个已知 tag 空间的组合优化问题。离线标定一次,在线打标和分配几乎没有推理开销——tag 解析在 CPU 上做完,模型还没开始跑就已经知道每个 token 的 bitwidth。
在测评层面,对比 SGLang FP4 的不稳定性,TriAxialKV 的”精度匹配甚至偶尔优于 BF16”说明了一件事:aggressive quantization + structured allocation 可以比保守的 uniform quantization 更安全——因为后者把脆弱的 inst token 和粗糙的 obs token 同等对待,前者则精确地把比特预算集中在真正敏感的位置。
有几个边界需要留意。论文的校准集取 5% 的数据,这意味着对分布外的工作负载——尤其是新类型的 tool schema 或不同的多模态输入比例——分配策略可能需要重新标定。所有实验在单 GPU(H100/B200)上完成,扩展性评估目前缺失。论文实现为 SGLang fork,短期内不会进入任何框架的主流分支。
回到本地知识库的语境[6]:此前关于 KV cache 压缩的讨论多集中在均匀量化的安全性边界(8-bit 是安全的,2-bit 只有 OCTOPUS 能维持可用性)和 NVFP4 等硬件专属方案。TriAxialKV 引入了另一条路线:不做更好的量化算法,而是利用 Agent 负载的结构特征,把有限的比特预算精准分配到最需要它们的地方。
参考资料
[1] TriAxialKV: Toward Extreme Low-Precision KV-Cache Quantization for Agentic Inference Tasks
[2] ThinKV: Dynamic KV Cache Eviction via Token-Level Importance Assessment
[3] VL-Cache: Sparsity and Modality-Aware KV Cache Compression for Vision-Language Model Inference
[4] SGLang: Efficient Execution of Structured Language Model Programs
[5] KIVI: A Tuning-Free Asymmetric 2bit Quantization for KV Cache
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。