一个 agentic 工作流跑起来,在 serving engine 眼里不过是一串独立的 LLM 请求。Map 阶段的 7 个 expert agent 用的是同一段 system prompt,引擎不知道;Debate 的每一轮都在重新 prefill 整个对话历史,引擎也看不见;Parallel 分支里 4 条链重合的三个子查询被各自执行了三遍——引擎仍然毫无察觉。现有推理引擎的优化视野止步于单次调用边界,跨调用的共享结构被完整浪费了。
NUS 发表的 Helium 把这个问题从 MLSys 的语境移植到了数据系统的语境里[1]。核心主张直白:agentic 工作流是一个查询计划,LLM 调用是计划中的算子。一旦接受这个类比,agent 服务就不再是对一串 LLM 请求的被动调度,而变成了编译期可见的 DAG 优化问题——死代码消除、公共子表达式消除、cache 替换、代价感知调度这些数据库领域打磨了几十年的工具,原封不动地拿过来就能用。
一、Agentic 场景的三层冗余
论文把跨调用冗余拆成三个粒度,每一层都对应一类现有系统的盲区。
Intra-operator KV waste 是最直观的一层。在 multi-agent debate 中,每轮辩论都在已有对话历史上追加新内容,但当前引擎无法把前一轮的 KV cache 传递给下一轮——每轮都要从零 prefill 整段对话。论文用一个概念性场景量化了这个浪费:Agent 2 先回答”1 米等于多少英寸”再把 Agent 1 的答案作为 feedback 追加进去评估,两个算子共享完全相同的 system prompt 前半段。最优调度下 ② 产生的 KV cache 可以直接供 ③ 复用;但如果调度器因为依赖关系先执行了 ① 才开始 ②→③,缓存中的共享前缀就可能在 ① 的处理过程中被 LRU 驱逐,③ 不得不重新 prefill。
Inter-operator sharing 比 KV cache 前缀复用更进一步。在 Map-Reduce 模式中,7 个 Map agent 各自拿到不同的输入分片但使用相同的初始化上下文。在传统框架(LangGraph、AgentScope、Spark UDF)里,这段上下文的准备操作被执行了 7 次——编排层看不见”这个操作在所有分支上都相同”这一事实,因为 LLM 在它眼里是不可检查的黑盒。
Inter-workflow sharing 把冗余扩展到跨批次。agentic 批推理反复查询相同的外部源(如每日天气、公司财报),大量确定性操作的输入输出对重复出现。论文用一个 trading workflow 示例来说明:19 个 agent 组成的 88 算子 DAG 中,当多个并行 sub-agent 各自向同一数据源发出相同的检索子查询时,没有任何现有系统能跨工作流复用结果。
这三层冗余的共性在于:它们都不是单次 LLM 调用内部的浪费,而是工作流结构层面的浪费。vLLM 的 prefix cache 可以解决同一引擎上两个连续请求间的 KV 共享,但它看不到 workflow DAG,也就无法在调度时主动构造”两个共享前缀的请求相邻执行”这一条件。这种被动/机会主义的 reuse 策略,在线 serving 场景下是合理的(因为无法预测未来请求),但在 batch agentic 场景下就变成了把已知信息当未知处理。
二、查询计划:从 imperative 到 declarative
Helium 的架构动机一句话就能说清:让系统在运行前看到完整的”查询意图”,而不是在运行中逐一收到指令。 这其实就是在 LLM serving 上复刻了 SQL 优化器的工作模式——你告诉数据库”我要这个结果”,优化器来决定怎么算;而不是你亲自指定每一步走索引还是全表扫描。
Helium 的三段流水线(解析 → 优化 → 执行)几乎照搬了经典数据库架构[1]:
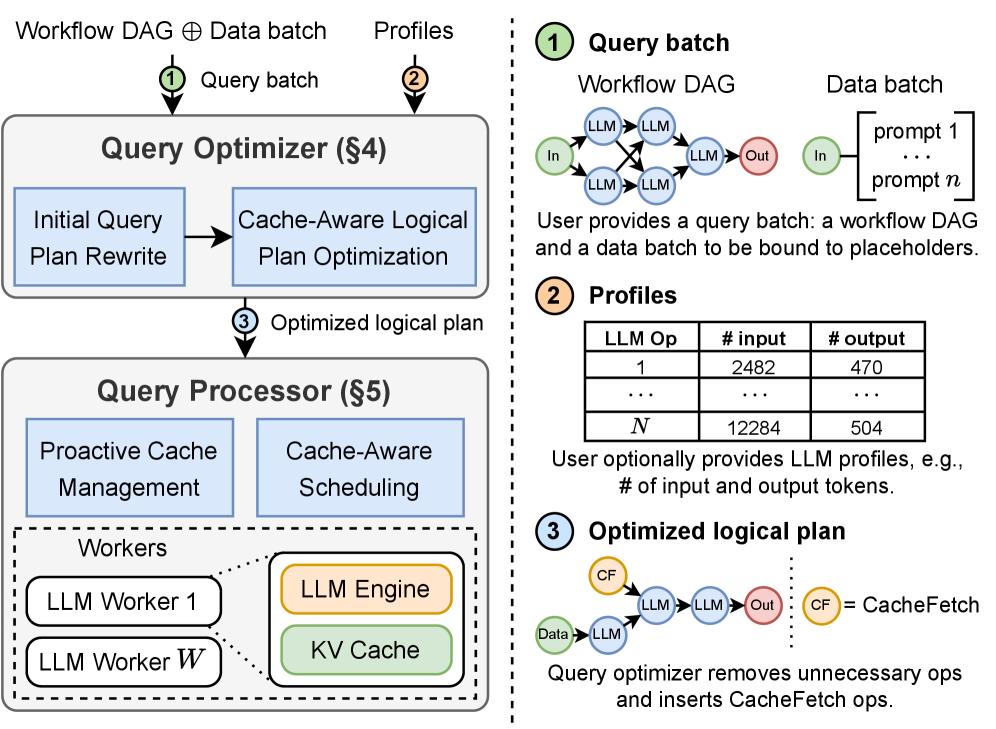 图 1:Helium 系统架构全景——解析、优化、执行三段流水线。(来源:论文 Figure 3)
解析层 使用一个 Python DSL 让用户以延迟求值的方式构建 agentic 工作流。关键设计是 symbolic graph:ops.llm()、ops.fmt() 这些调用并不执行 LLM,而是往 DAG 里加节点和边。compile() 把 placeholder 绑定到具体输入批次,产生的是”这个工作流要做什么”的声明式描述,而不是”现在开始执行”的指令。
优化层 在这个描述上做两件事。第一是结构优化:死代码消除(反向遍历从输出节点追溯有效路径,剪掉未被消费的 speculative 分支)和公共子图消除(哈希匹配拓扑相同的子图,让相同计算只保留一份实例)。第二是 prompt cache 替换:对每个算子用类型签名 + 物化输入哈希去查全局 prompt cache,命中后把 LLM 算子原地替换为 CacheFetch 节点——一个只读指针,指向已缓存的结果。整个优化过程是一次线性图遍历,全是 CPU 上的轻量哈希和节点重写,开销相对于 LLM 推理可以忽略。
执行层 拿到优化后的逻辑计划后,将 prompt 结构编码成 Templated Radix Tree(TRT),再基于 TRT 做 cache-aware 调度。TRT 区别于 SGLang 的 RadixAttention 树的关键在于两点:它同时编码 prompt 的静态前缀结构(哪些 token 是固定的)和算子间的依赖边,使得调度器可以在同一棵树上看到”哪个算子的前缀可以被前一个算子的计算复用”和“谁依赖谁的结果”。调度算法本身是一个 DFS 贪心,基于 critical-path 启发式选择下一个要调度的算子,复杂度只依赖 WORKFLOW 拓扑而非 batch size——这比起在请求级别做调度的方案(复杂度与 batch size 成正比)有明显扩展优势。
三、结果:冗余消除有多值钱
论文在 Qwen3-8B 上对比了 7 个系统,覆盖 5 种基础 agentic 模式和 1 个复合工作流。
五项 microbenchmark 的结果整体一致[1]:
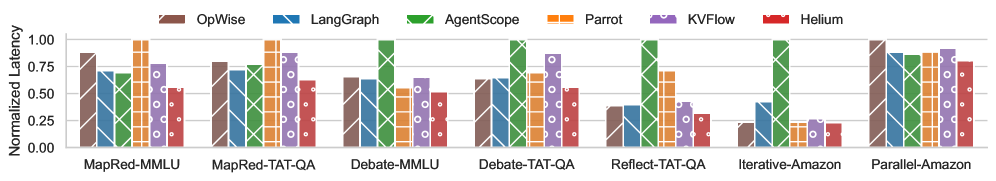 图 2:Helium 与七个基线在五种 agentic 模式上的归一化端到端延迟对比。Helium vs KVFlow 在 TAT-QA 上快 1.56×,vs AgentScope 最快 4.32×。(来源:论文 Figure 5)
Helium vs KVFlow(当前最强的 agent-aware serving 方案)在 TAT-QA 上快 1.56×,vs Parrot 快最多 2.21×,vs AgentScope 快最多 4.32×。OpWise——将工作流按”先执行所有 query 的算子 1,再执行所有 query 的算子 2”这种经典批处理思路调度的基线——也仅达到 Helium 的 80%(TAT-QA Map-Reduce),说明简单地把 agent 工作流套上关系运算的执行模型并不足以捕获 KV cache 和 prompt 间的共享关系。
Trading 工作流(19 agents, 88 LLM 算子)的结果进一步强化了信号:Helium 对比 KVFlow 取得 1.34× 加速,对比 vLLM 的顺序执行加速达到 39.5×[1]。这个倍数提示了一个更深层的事实:在复杂 agent 编排中,vLLM naive sequential 的版本把整个 DAG 的每个叶子都当成独立请求处理,完全没有复用任何 KV 或 prompt 结果——agentic 规模越大,无优化的代价就是所有共享结构被线性放大。
Ablation 实验给出了最值得被记住的数字:plan pruning 贡献 23.35%,cache-aware scheduling 贡献 17.66%,prompt caching 贡献 13.56%,proactive KV caching 贡献 3.55%[1]。前两项——查询改写和调度——合计贡献了超过 40% 的增益。这意味着 Helium 的价值大头不在”把 KV cache 做得更聪明”(那是 vLLM/SGLang 不断在迭代的方向),而在于”在请求还没到达引擎之前就把冗余结构识别并消除掉”。把工作流从 imperative 的请求序列变成 declarative 的查询计划这件事本身,比具体的缓存策略更重要。
TRT 的内存占用也值得留意:在 16 分支配置下 552 KiB,对比 SGLang RadixCache 的 14.8 MiB[1]。这不只是 27 倍的压缩比——它反映的是两种数据结构的根本差异:RadixCache 存储的是实际 KV cache block 的索引,TRT 只存储 prompt token 序列的结构模板。前者在 batch size 增长时持续膨胀,后者的规模只由工作流结构本身决定。
四、这条线的真正含义
把论文放在最近 agentic serving 这条线上,能看到一个更清晰的趋势。
过去半年里,agentic 推理的性能话题持续升温。DualPath 发现生产 agent trace 中 98.7% 的 KV 命中率使得存储 I/O 带宽而非 GPU 算力成为吞吐瓶颈[2]。CONCUR 在 256-agent 批量推理中测出 middle 阶段 49.1% 的端到端延迟来自冗余重计算[3]。NVIDIA Dynamo 用 WORM 模式把 agentic cache read 设计成一等公民,Claude Code 的子 agent 并行场景下聚合命中率达到 97.2%[4]。这些工作从不同方向指向同一个结论:真正决定 agent 成本的不是单次推理延迟,而是”已经算过的东西被反复重算”的比例。
Helium 的独特贡献在于,它把这个趋势推进到了架构层面——不是给现有引擎加 agent-aware 补丁(CONCUR 给 SGLang 加 AIMD 拥塞控制、DualPath 给 disaggregated 集群加双路径 load、Dynamo 给 RadixCache 加 ephemeral TTL),而是直接换掉引擎与编排层之间的接口本身。在 Helium 的架构里,系统与工作流的交互方式是”你给我查询计划,我给你最优执行”,而非”你给我一串 LLM 调用,我尽力优化”。
论文的适用范围也值得说清楚。Helium 的假定是所有 agent 在本地部署、使用同一 base model、不做近似(保证结果语义不变)。这些假定把它的适用场景约束在批处理式的 offline agent 推理——那种同时处理成百上千个相似任务、每个任务跑几十到上百轮 LLM 调用的场景。对于交互式 agent 服务(用户随时发来一个任务、结果必须秒级返回),它的 compilation → optimization → scheduling 链路是否还能保持低 overhead 尚未被验证。
论文也没有讨论 LLM 调用中可能出现的非确定性——temperature > 0 时的采样把 batch 内相同输入算子产生不同输出的情况变成了需要处理的新问题。目前 prompt cache 只覆盖 greedy sampling,这意味着 speculative/exploratory 的分支中的缓存机会在当前的实现中是被放弃的。
Helium 把 agentic 工作流的优化从”如何让单个 LLM 调用更快”拉到了”如何让一批 LLM 调用组成的 DAG 整体最优”。这个视角转换本身可能是这篇论文最值得被记住的地方。当 agent 规模继续增长、多 agent 协作从 demo 变成生产常态,声明式 query plan + 代价感知优化的范式,比任何单个 cache 策略都更能把握住这个趋势的杠杆点。
参考资料
[1] Efficient LLM Serving for Agentic Workflows: A Data Systems Perspective
[2] DualPath: Dual-Path KV Cache Loading for High-Throughput Agentic Inference Serving
[3] CONCUR: Adaptive Concurrency Control for Agentic Batch Inference
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。