一次 Claude Code 任务可能跑 50 次模型调用,每次都背着 30K token 以上的 system prompt 和工具定义——这些重复的 KV cache 本该被缓存,但在今天的生产系统里,它们仍然和一次性推理 token 一样被 LRU 随机淘汰。
这篇论文(arXiv:2604.26968,独立研究者 Sanjeev Rao Ganjihal,正在申请临时专利)的核心价值不在于提出了一个完整可部署的系统,而在于把三个通常被分开讨论的问题——跨架构 KV cache 尺寸计算、多级存储放置、缓存淘汰策略——串成了一条统一的技术路线。论文最值得被记住的两件事:MLA 架构的 KV cache 内存被高估了 57 倍,以及贝叶斯预测可以在不显式编程缓存规则的前提下,把 agentic 工作负载的缓存命中率从 66.5% 拉到 80.5%。
一、57 倍浪费从哪来:MLA 被当作 MHA 来分配
论文列出的第一个问题是跨架构 KV cache 尺寸计算的碎片化。不同 attention 架构的每 token KV 开销差异极大——MHA(2×h×d×p)、GQA(2×h_kv×d×p)、MLA((d_latent + d_rope)×p)——但在通用推理框架里,MLA 不被单独识别。DeepSeek-V3 使用 MLA,每 token 每层只需 1,152 字节,但因为没有 MLA-aware 的尺寸计算,系统按 MHA 去算,得到了 65,536 字节——差了 57 倍。
这个数字不是一个理论极限,它是当前生产集群里的实际浪费。在 80GB H100 + 8 路张量并行的配置下,用 MHA 公式算出的最大 batch size 是 15,用 MLA 公式可以是 104。论文的 ablation 实验显示,去掉架构感知尺寸计算后,MLA 模型的吞吐量损失最严重的一条是 −85.6%。
这其实暴露了一个比“框架没支持 MLA”更根本的问题:异构集群缺乏一个统一的内存预算引擎。今天一个生产集群可能同时跑着 Qwen(GQA)、DeepSeek(MLA)、Llama(GQA)——没有统一的算账方式,GPU 内存要么被低效地过度预留,要么在模型 mix 变化时出现碎片化。这篇论文提出的造型调度方案是:从 config.json 读模型参数,自动分发到 MHA/GQA/MQA/MLA 四套公式,给每种架构算出精确的 B(n)。
对于 GQA 模型,论文的实际贡献不在“框架算不对”——主流框架已经正确使用 KV head count——而在于同一套引擎可以覆盖四种 attention 类型,这对异构集群调度的意义更大。
二、六级存储 + 贝叶斯预测:为什么这不是简单地“多买几层”
论文提出的六级存储层级(T0–T5)看起来很有野心:GPU HBM(40GB)→ CPU DRAM(200GB)→ CXL 3.0(712GB)→ NVMe+GDS(4.7TB)→ RDMA Pool(38TB+)→ Parallel FS(冷存储)。但这个方案最值得深入看的部分在于架构:每层之间的晋升/降级决策由同一个贝叶斯预测器统一驱动,各层之间不再各自维护一套启发式规则。
贝叶斯预测器的核心设计并不复杂:
- 定义两种分类变量:block type(4 类:system_prompt / tool_context / user_context / intermediate_reasoning)和 transition type(4 类:same_tool_repeat / tool_switch / reasoning_step / agent_handoff)。
- 对 4×4=16 种组合,各自维护一个 Beta 分布
Beta(α, β)。 - 命中一次 α+=1,未命中一次 β+=1,后验均值
α/(α+β)即为该组合的重用概率。 - 每次更新 O(1),不需要离线的批量重训练。
当 P_reuse(b, t) 超过层级阈值时,对应的 block 被异步提升到更快的存储层;低于阈值时降级到更便宜的层级。这个机制把传统的被动淘汰(满了才删)变成了预测驱动的主动摆放。
但这个设计在生产里成立的前提条件,正是论文最薄弱的环节。Beta 分布的参数没有展示收敛速度的数据(论文说 (system_prompt, same_tool_repeat) 在 500 次观测内 α/(α+β)>0.97,但这是在 trace replay 上测的,不是实时 serving 环境)。而且 16 对参数的初始化被承认影响很小(“所有先验在 100 次观测内收敛,变化 <2%”),这意味着短期冷启动时预测准确率会显著低于稳态——而这恰恰是新模型或新工具刚上线时最需要准确预测的时刻。
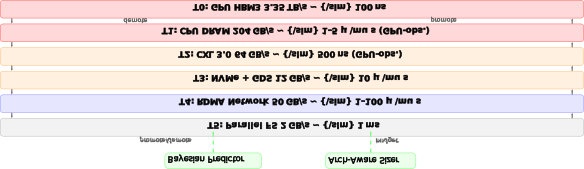
图 1:六级存储层级与贝叶斯预测器的关系——预测器根据 block type × transition type 的后验概率驱动跨层迁移,架构感知尺寸引擎为每类 attention 架构计算精确的内存预算。来源:论文 Figure 1。
三、Agent 场景里的结构:LRU 错过了什么
论文在三个 workload 上做了 trace replay:ShareGPT(通用对话)、LMSYS-Chat-1M(高系统提示复用)和 synthetic agentic(工具调用序列,5–15 轮)。贝叶斯预测器相对于 LRU 的缓存命中率提升分别是 10.3pp(59.5%→69.8%)、6.4pp(77.8%→84.2%)、14.0pp(66.5%→80.5%)。
最有意思的是 agentic workload 上的 14 个百分点的差距。LRU 在工具调用序列面前基本是盲的——它不知道 tool_switch 发生后哪些 block 大概率会被重用。而贝叶斯预测器能捕捉到:system_prompt 块在 any 过渡类型下都是高重用概率(这是直觉能猜到的),tool_context 块在 same_tool_repeat 过渡下是高重用、在 agent_handoff 过渡下是低重用(这需要系统自己去学)。
论文额外引入了一个一阶 Markov chain 来做 agentic 任务转换预测:追踪 P(tool_j | tool_i) 的转移概率,结合每工具的历史 KV cache 大小统计(均值、方差、峰值),在工具切换发生时预分配容量、调整 attention head 的重要性乘数、并发起低层级的 block prefetch。三个动作串在一起形成了一个闭环:预测下一次工具调用 → 提前准备好内存和缓存 → 切换发生时 block 已经在它在的层级。
从工程逻辑上看,这个设计比 FlexGen 的被动卸载[1]和 Mooncake 的被动放置[2]都更进一步——它把 cache placement 从请求后的被动操作变成了请求前的主动动作。但目前这只是逻辑架构,没有在真实生产集群上与 Mooncake 做过对比实验。
四、结论
这篇论文真正成立的判断有三个梯度。
第一层(确信):跨架构 KV cache 统一尺寸计算是一个真实需求。MLA 被当成 MHA 计算导致 57× 内存浪费,这个数字是直接从模型 config 和公式(3)算出来的,不依赖任何投影或估计。只要你的集群跑 MLA 模型,这个浪费就在那里,不管你用不用这篇论文的方案。
第二层(有把握但待验证):贝叶斯重用预测在 agentic workload 上的 14pp 命中率提升方向是对的。agentic 交互的结构性比通用对话强,这正是贝叶斯更新擅长的场景。但 16 对参数的冷启动问题——新工具/新场景刚上线时 α=1、β=1 意味着重用概率估计是 50% 的随机猜测——论文没有给出足够数据来量化这个阶段的负面影响。
第三层(需要保留判断):六级存储层级的全系统性能数字全部是分析性投影,没有一个数字是在真实 CXL 3.0 + NDR InfiniBand + GDS 集群上跑出来的。单卡工作站验证了贝叶斯预测器和去重算法,但没有验证跨层数据搬运的延迟叠加效应、CXL 地址映射的碎片化问题,或者 RDMA 池在大规模并发下的竞争行为。论文自己也在结论里写了——“planned as future work”。
这恰恰是这篇论文最诚实的地方:它把每个数字的计算方法都写清楚了(投影方法在 §V-B 有完整的公式推导),让读者可以自己判断什么数字是硬结论、什么数字是方向性判断。在 KV cache 管理从单机 block pool 向集群级数据面演进的过程中,这种把 sizing、placement、eviction 统一建模的思路,比任何单个数字都更值得被记住。
参考资料
[1] FlexGen: High-Throughput Generative Inference of Large Language Models with a Single GPU
[2] Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving
[3] Predictive Multi-Tier Memory Management for KV Cache in Large-Scale GPU Inference
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。