Gemma Instant 变成一个做 AE 数据分析的 Claude Code agent 时,跑了 786 个 turn 才停下来。它在这段路上调用了 2,757 次 Edit 工具,其中 95.4% 都以失败告终——每一轮失败都会往上下文里塞一段错误日志,下一轮模型又得读一遍这些垃圾,然后再试、再失败、再追加更多上下文。
这个极端案例来自 UIUC / Intel / Gimlet Labs 联合发表在 arXiv 上的论文”Agentic AI Workload Characteristics”[1]。作者搭建了一套端到端 tracing 设施,在 2× H100 NVL 上用 vLLM v0.20.0 跑了四个模型配置(Qwen3.6-27B / Gemma4-31B,各开 reasoning 和 instant 两档)在五个 agent benchmark(ADE-Bench、DABstep、GAIA、SWE-bench Pro、Terminal-Bench 2.0)上的全量 trace,把 agent 执行轨迹和 LLM serving trace 做了逐请求关联。
786 轮只是长尾的极端值。但论文真正的贡献,是把 agent 推理的那组默认假设全部拆开,用数据回答一个推理基础设施团队迟早要面对的问题:agent 工作负载到底长什么样,以及这组特征对 serving 系统的设计意味着什么。
一、两条正交的长尾:轮次不在同一根轴上
先看作业规模。论文的 Figure 3 展示了各 benchmark 的 turn 分布:大多数配置的均值在 12 到 62 轮之间,落在一个直觉范围里。尾巴却长得完全不同——Gemma Instant 在 ADE 上中位数 28 轮、最大值 786 轮,在 DABstep 上 640 轮,GAIA 上 617 轮,Terminal-Bench 上 470 轮。同一个模型去掉 reasoning 能力后,作业时长暴涨了数倍。
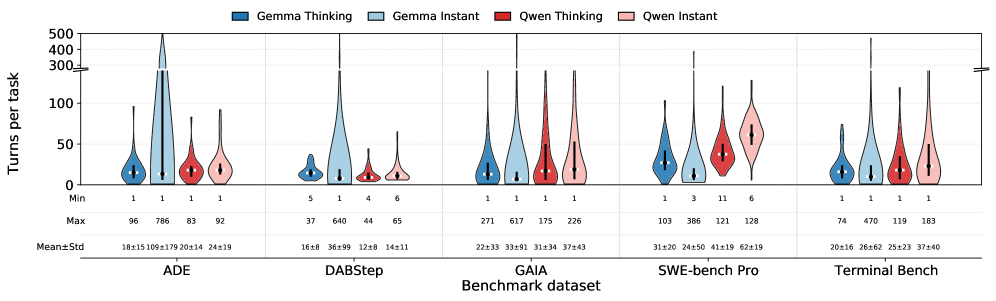 图 1:论文 Figure 3。Reasoning 变体(Gemma Thinking、Qwen Thinking)普遍比 instant 变体收敛得更快,但这是 workload-dependent 的——对 Qwen、SWE-bench Pro 上 instant 和 thinking 几乎同量级。
奇怪的是,reasoning 在这里扮演的角色和直觉完全相反。直觉上是”模型想得更多 = token 更多 = 更贵”,但论文的数据指着相反的方向:ADB 上 Gemma Thinking 均值 18.0±15.3 轮,Gemma Instant 均值 108.8±178.7 轮。推理能力没有增加成本,反而通过压缩探索次数显著降低了成本。 这是因为 instant 模型在复杂任务里进入了一个”试错-失败-重试”的正反馈循环,而不在思考模式下,它缺乏跳出这个循环的元认知。
但轮次长尾只是故事的一半。上下文的长尾是一根不同的轴。
SWE-bench Pro 是上下文最重的 benchmark,均值 68.7K 到 80.1K token,最大达到 166K token——但它的轮次分布只在 Qwen Instant 上才极度膨胀(均值 62.4 轮),其他配置的轮次并不极端。Terminal-Bench 和 GAIA 在 Qwen 上也制造了 52.5K 到 65.1K token 的平均上下文,尽管轮次中位数远比 ADE 的极端 case 温和。这意味着存在两类完全不同的 serving 压力:一类是高频模型重入(许多轮短上下文),另一类是低频率重上下文(每轮都拖着巨大的 KV cache 足迹)。 两种场景对调度器、内存管理和缓存策略的要求完全不同——前者考验的是请求调度的频率和上下文切换开销,后者考验的是 KV cache 的容量和保留策略。
论文还做了一个非常实用的切分:比较成功和失败运行的上下文长度。GAIA 上,失败运行的 mean context 比成功运行高出 15-40%(例如 Qwen Thinking 从 45.6K 跳到 64.7K)。Terminal-Bench 上差距更大,Qwen Thinking 的失败运行均值 79.2K,成功运行的均值只有 44.4K。失败并不是只消耗了更多 token——失败把错误信息、栈跟踪、失败的 patch 全部塞进了 KV cache,而这些垃圾在下一次模型调用时都会被完整重读。 系统为此付出的代价是双重的:更多的调用次数 + 每次调用更大的 KV 缓存压力。
二、从 raw input-to-output 到 effective ratio 的折叠
有了这些数字后,直觉会把人带到一个方向:agent 每轮都拖着一个 50K-80K token 的上下文做 prefill,这成本得有多高?
论文用 Figure 8 和 Figure 9 彻底推翻了这条路。
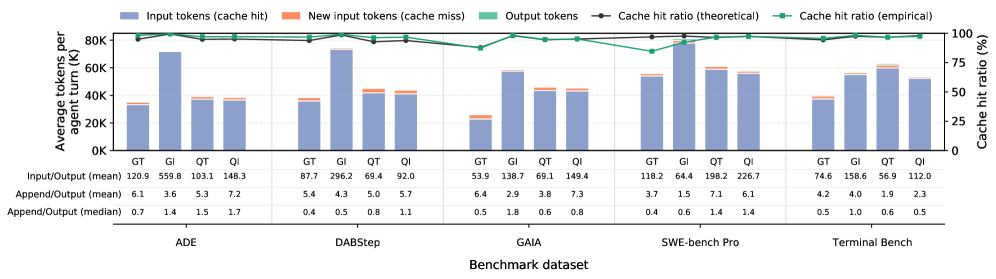 图 2:论文 Figure 8。尽管 agent 上下文不断膨胀,每轮真正需要新 prefill 的只是增量部分(appended tokens),绝大部分历史 token 由 KV cache 直接复用。
实测 cache 命中率为 84.6-99.5%。每轮大部分输入 token 是前缀命中,真正需要作为”冷 miss”来 prefill 的部分只占很小的增量。论文算了一组关键的比值:raw input-to-output ratio 的最低值是 53.9×,最高到 559.8×——如果只看原始输入体量,agent 工作负载确实像 prefill 灾难。但 append-to-output ratio 的均值只有 1.5× 到 7.3×,中位数常常低于 1.5×。换句话说,真正的 prefill 压力比你用总上下文长度估算的结果小了 30 到 80 倍。
这正是论文的核心转向:agent 推理不应该被建模为一序列独立长 prompt 请求,而应该被建模为在一段持续增长的缓存上下文上反复 decode 重入。这组结论在 Figure 9 中得到了直接验证。
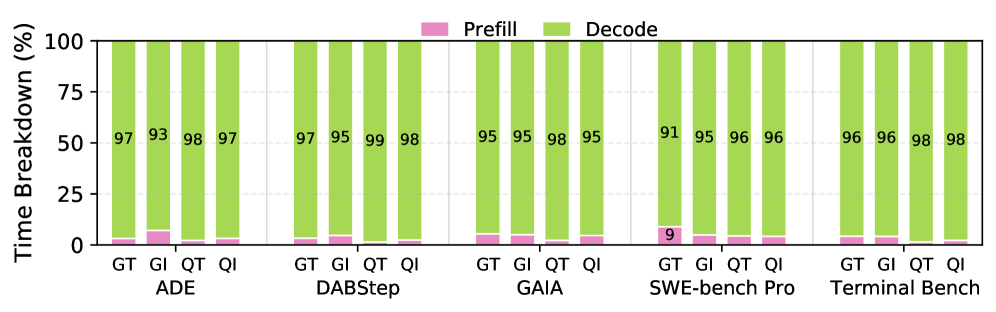 图 3:论文 Figure 9。Prefill 最高只占 LLM 时间的 9.0%(Gemma Thinking 在 SWE-bench Pro),其余全部是 decode。
decode 占据了 LLM 执行时间的 91.0-98.6%,prefill 仅占 1.4-9.0%。 如果把 agent 推送进生产环境,问题的陈述方式需要出现根本转向:核心从”长上下文推理如何优化 prefill”切换到”持续的 decode 如何在 KV cache 保活的约束下稳定吞吐”——前提是你有足够的 GPU 内存来保留正在运行的 agent 的全部 KV cache 状态。这就是论文埋下的最大隐含条件。
三、decode 霸权的裂痕:cache 驱逐会把 agent 打回 prefill 地狱
论文坦白地标注了 Figures 8 和 9 的前提条件:实测中每个 agent 的聚合上下文都保持在 GPU 内存中,不发生驱逐、不经历 offload,是一组理想缓存 regime 下的行为数据。
一但引入并发 agent——比如同时有几十个 agent 在跑,各自积累 50K+ token 的上下文——GPU 内存就会溢出。此时 LRU 或其他淘汰策略会驱逐一些 agent 的 KV cache,下一次该 agent 再调模型时,整个前缀需要重新 prefill。一张 50K token 上下文的 prefill 单靠增量是 1.5-7.3× output 的轻量操作,失去 cache 后就变成了 53.9-559.8× 的完整 prefill——中间差了超过 100 倍。 这就是论文真正想提醒的事情:agentic serving 的核心瓶颈在保证 KV cache 不被驱逐的延续性——prefill 的绝对成本并不高,但一旦 cache 被打破,decode-dominated 的工作负载会瞬间退化回 prefill-heavy 的重计算。
这个退化行为在更近的文献中已经被定量捕获。CONCUR 论文[2] 对 ReAct agent 批推理做了阶段分析,发现在 batch=256 的 SGLang baseline 下,KV cache 命中率会从 warmup 阶段的 ~90% 跌到 middle 阶段的 <40%——因为 tool 等待期间的空闲 agent 的活跃前缀会被新 agent 的上下文挤掉。这 40% 的命中率崩坏直接转化为额外 prefill 开销,占据了端到端延迟的 49.1%。
回到这篇论文的数据,一个间接证据是:文章测出的 decode 占比(91-98.6%)是一个相当厚实的数字。这意味着只要发生 cache thrashing,agent 服务系统的性能会以 10 倍以上的量级坍塌——从一种负载特征翻转到另一种负载特征,中间存在一个质变的临界点。对推理基础设施团队来说,agent 服务系统的 SLO 设定不应该围绕延迟或吞吐量,而应该围绕 KV cache 命中率的可观测指标。 如果缓存命中率从 90% 跌到 60%,系统已经从 decode 主导模式退化到了 prefill 主导模式——这个变化比 30% 的命中率数字本身所暗示的严重得多。
四、工具失败:负载的隐形放大器
论文的工具调用特征同样值得认真对待。最难对付的不是慢工——Agent 委托子任务可能跑 300-900 秒(GAIA 上 Qwen Thinking 均值 916 秒)——而是高频失败的操作。
Gemma Instant 在 ADE 上的 95.4% Edit 失败率是一个教科书级别的失败-重试正反馈回路:每次 Edit 失败写入错误信息→下一轮模型读了更多上下文→下个 Edit 继续失败→继续写入。 这个回路解释了整个 786-turn 长尾——它不是一次成功的长时间作业,而是一个困在重试循环里不断消耗资源的死进程。
Bash 的失败率在 SWE-bench Pro 上也普遍高达 30-40%(Gemma Thinking 30.7%,Gemma Instant 39.8%),而 Edit 在 Gemma Instant 上达到 77.8%。这些失败都做了一件事:往 agent 上下文里追加了一条错误观察。这组数据意味着,agent 系统中的”失败负载”不是一个例外情况——它就是正常负载的一部分,且完全不可预测。 一个 SWE-bench Pro 任务可能 10 轮就干净地完成,也可能因为环境依赖错误在第 7 轮触发连锁失败,之后 60 轮全在试错和重试——即便最终失败,它对系统施加的压力也远大于一个干净完成的任务。
这是一个对容量规划的严肃提醒。如果你用”成功任务均值”来估算 agent 服务系统的容量需求,你会低估实际负载 1.5 到 2 倍——因为失败运行比成功运行消耗了更多的平均上下文和更多的轮次。
Agent 的作业剖面在时间维度上也有结构。论文将工具调用按意图分为”探索/读取”(Read、Glob、Grep、WebFetch、WebSearch)和”执行/写入”(Bash、Edit、Write、TodoWrite),按 task 进度的四分位数做了分段分析。
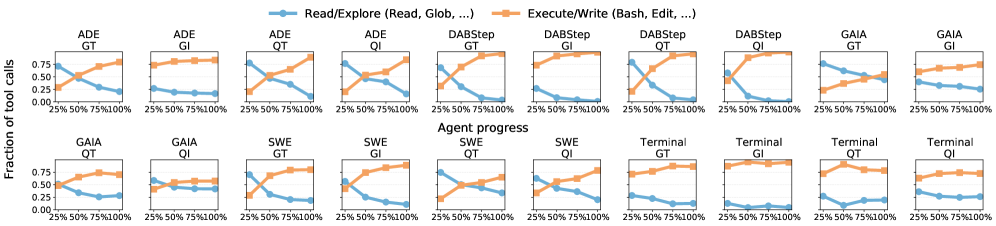 图 4:论文 Figure 12。GAIA 是例外——在整个任务过程中,读取和执行的占比相对均衡,不出现明显的后期执行集中期。
DABStep 和 SWE-bench Pro 的探索比例从第一四分位的 60-80% 跌到最后一四分位接近零,执行比例反向爬升到 80-100%。ADB 和 Terminal-Bench 也有类似的趋势,但 GAIA 完全不同——读取和执行占比几乎全程平衡,最终仍然接近 40-60 的分割。这个”意图迁移模式”是一个对调度器有价值的信息:如果能把 agent 的任务进度与 KV cache 管理做联动调度,早期阶段(探索为主)的上下文多为文件读取结果和 grep 文本输出,对 cache 保活的价值随任务进展快速衰减;后期阶段(执行为主)的上下文才是 patch、test result、build log 等对复盘有价值的信号。
五、结论
这篇论文提供了 agentic 推理领域目前最接近公开可用 trace 的系统性特征数据——它有局限(单节点、两个 27-31B 等级的小模型、没有长时间运行的并发 agent 场景),但它最值得被记住的是三个判断。
第一个判断:agentic serving ≠ long-prompt serving。 把 agent 推理当作长 prompt 推理来优化,等于在错误的维度上烧工程资源。真正有效的提升在 KV cache retention、context scheduling 和驱逐策略,而不是 prefill 效率。
第二个判断:decode 主导是一个有条件的、脆弱的状态。 只要并发 agent 的总上下文超过 GPU 内存,decode-dominated 负载会跳变回 prefill-heavy。这个跳变不是量变,是质变——cache 命中率每降 1%,prefill 负担会增加超过 10%。这意味着 agent 服务系统的观测体系里,KV cache 命中率应该是一个比延迟和吞吐量更前置的告警指标。如果命中率从 85% 剧降到 60%,系统已经不在同一个性能模式里运行了。
第三个判断:失败运行不是系统边缘 case,而是负载曲线的核心组成。 不能把失败 agent 的上下文视为”浪费”而从容量模型中剔除——恰恰是这些运行制造了最长的轮次和最重的上下文压力。
论文说的这些判断,最终落到一句工程前提上:当前所有的推理系统——vLLM、SGLang、TRT-LLM——都不是为 agent 的负载特征设计的。它们的调度器不认识 agent 的”身份”——不知道请求 A 和请求 B 属于同一个 agent 会话、不知道这个 agent 已经失败了多少次、也不知道它的上下文哪部分是探索阶段的文本噪声、哪部分是执行阶段的代码 patch。在这个 gap 被填上之前,agent 推理服务的基石——成本预测、容量规划、SLO 设计——都建立在用 chat 负载特征外推的沙子上。
参考资料
[1] Agentic AI Workload Characteristics
[2] CONCUR: Agent-Level Admission Control for Multi-Turn Agentic Serving
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。