一次 chat 调用和一次 Agent 调用的区别在哪里?大多数人的第一反应是 Agent 会调用更多轮 LLM——ReAct loop、tool call、refinement、branching。但这个回答漏掉了一个更根本的变化:用户体验的不是某一次调用的延迟,而是整个工作流从发起到完成的时间。 这个变化把调度的基本单元从”单个请求”掰成了”一个还在持续展开的有向图”。
HKUST 团队这篇 HexAGenT[1] 就是从这个掰弯了的视角出发,重新设计了一套面向 Agent 工作流的推理调度器。论文的核心主张只有一句话:当优化目标是端到端工作流 SLO 而不是单次调用延迟时,按请求粒度做的所有调度优化都不再是对的函数——甚至可能是错的。
不止是主张,论文用一个逐渐加码的消融实验把这句话砸实了。在 A100/H100/H200 混合集群上,Qwen-Mixed 工作流的 Req99 SLO 缩放因子从 per-call FCFS 的 15.84 一路降到 HexAGenT 的 3.94——56% 的尾延迟改善来自把调度目标从 call 切换到 workflow 再加一层异构感知。在 ShareGPT 上更直白:per-call FCFS 需要把 SLO 放宽松到 5.85 倍才覆盖 95% 流,HexAGenT 只需要 2.50 倍。
一、问题三明治:在线、异构、耦合
HexAGenT 面对的问题比大多数调度论文多一层。它不是在一个已知 workload 上做离线最优分配,也不是在一个同构集群上做请求级排队。它要同时处理三层约束。
第一层:DAG 是在线揭示的。 工作流到达时,调度器只知道这个工作流的第一批 LLM 调用(source node)。只有当前一个调用完成、或 tool call 返回结果后,下一批调用的节点才会从暗处浮上来。这意味着调度器永远在信息残缺的状态下做决策——你不知道这个工作流接下来会不会分叉成三路并行、不知道后面来的调用是 2K 的短 prompt 还是 100K 的长上下文重灌。
第二层:异构的不仅是 GPU,还有工作负载内部的多样性。 P/D 分离后的集群里,prefill 实例和 decode 实例可能跑在不同型号的 GPU 上。同一工作流内的不同调用,prompt 长度、output 长度、KV cache 压力都可能差一个数量级——有的调用是轻量 tool call,有的是一次把整个代码库灌进 context 的 prefill 重操作。调度器不仅要决定”哪个调用更急”,还要决定”这个调用放在哪个 prefill/decode 对上最划算”。
第三层:跨阶段耦合。 P/D 分离后,一个调用的执行路径不再是单体的:prefill → KV transfer → decode。KV transfer 的延迟取决于 KV 大小和跨 GPU 型号的带宽。在异构集群里,A100 prefiller 算出来的 KV 送到 H200 decoder 可能比送到本型号 decoder 更慢——但如果 H200 decoder 计算快得多,这个 tradeoff 就变得需要精算。
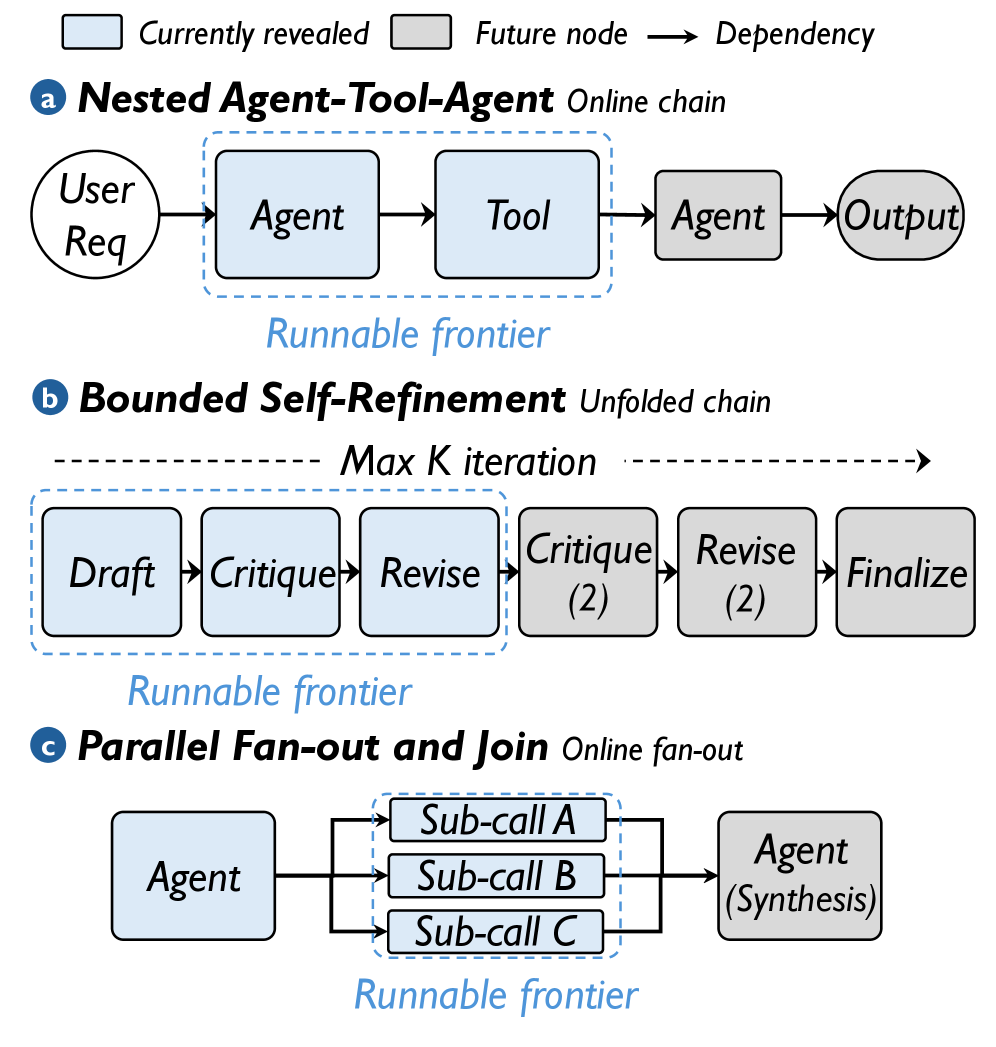
图 1:Agent 工作流以在线 DAG 的方式逐步浮现。工作流到达时只有源节点可见;随着父调用完成或 tool 返回,下游调用才被揭示。调度器始终在部分信息下做决策。来源:论文 Figure 1。
二、最便宜的改善:只把 FCFS 改成 Workflow 级别的
在讲 HexAGenT 的完整设计之前,论文在 §3 放了一个很关键的消融实验——不需要任何复杂的异构感知,只做一步最简单的改动,就能拿到巨大的收益。
这个改动是:把 per-call FCFS 改成 workflow-level FCFS。前者把所有调用按 reveal 时间排成一队,来自不同工作流的调用混在一起。后者保持每个工作流内部的执行连续性——工作流 A 的所有就绪调用不会因为工作流 B 的调用先 reveal 就被插到后面。
效果:Qwen + BFCL-v3 上,Req95 从 21.11 降到 9.64(下降 54%),Req99 从 26.89 降到 11.67(下降 57%)。这个改进不需要任何异构感知、不需要任何延迟估计、不需要任何额外的系统开销——它只是把排队的粒度从单个调用换成了工作流。
反过来说,这也意味着原来的做法有多差。per-call FCFS 在 agent 场景下犯的错不是”不够优”,而是”系统性做错了”——它把一个工作流的调用打散到不同工作流的调用之间,等于在主动制造 head-of-line blocking。当工作流 A 的 tool call 要等 B 的整个 reasoning chain 执行完才能动时,A 的端到端时间被拖累的不是单次排队延迟,而是整个 downstream DAG 的级联延迟。
接下来论文再加一层:加入了异构感知——调度器在选择 prefill/decode 对时使用了 roofline 估计的 per-instance 服务延迟。这一层再加进去,Qwen-Mixed 的 Req99 从 15.01(workflow-FCFS)降到 3.94——workflow 视角拿到了大盘面,异构感知把残存的浪费也挤掉了。
三件事的消融关系很清晰:workflow-level ordering 是必要但不充分的条件;加上异构 placement 才能逼近上限;per-call FCFS 是大前提错了,不是实现细节不够好。
三、怎么把”离 SLO 还有多远”变成一个可排序的数
HexAGenT 的调度算法可以用一个公式概括,但公式背后是一个工程直觉:不要优化延迟的绝对值——优化延迟相对于工作流当前可承受上限的比例。
具体做法:
① 每个工作流维护一个”独立完成地平线” H_w(t)。 这个值是”如果已经揭示的这部分工作流子图独占了整个集群,它需要多长时间跑完”——一个随着工作流节点逐步揭示而逐步更新的估计值。它回答的问题是:这个工作流现在看起来有多重?如果后面揭示的节点让子图变长了,H_w(t) 就会上调。
② 对每个就绪的调用 c,在候选的 prefill/decode 对上估算一个”完成投射” Δ_s(c,t)。 这个投射包括:等待时间 + prefill 执行时间 + KV transfer 时间 + decode 等待与执行时间。同一个调用放在不同的 prefill/decode 对上,Δ 会不一样——因为不同 GPU 型号的服务速率不同,跨型号的 KV transfer 带宽也不同。
③ 计算风险比率 R_s(c,t) = ((t - a_w) + Δ_s(c,t)) / H_w(t)。 分子是”如果现在把这个调用放到这个 pair 上,它结束的时刻离工作流到达已经过了多久”;分母是工作流当前看起来需要的总时间。R > 1 意味着调度已经让这个工作流落后于它的独立执行时间表了。R 越大的调用越应该被优先调度。
这个比值比直观的”剩余 Slack”指标更自然,因为 H_w(t) 会随着工作流的在线揭示而动态调整——一个刚开始看起来不紧急的工作流,可能因为中途揭示了一个重 prefill 调用,H_w 突然拉高,R 随之下降,优先级重新洗牌。而传统的 Slack 或 Deadline 策略做不到这种动态调整,因为它们预设了工作流的全部信息。
调度循环本身是贪心的——每轮选出 R 最大的调用,匹配到最佳 prefill/decode pair,更新模拟的资源状态,重新计算剩余调用的 R 值,然后继续。队列大时退化为单轮排序以控制开销。
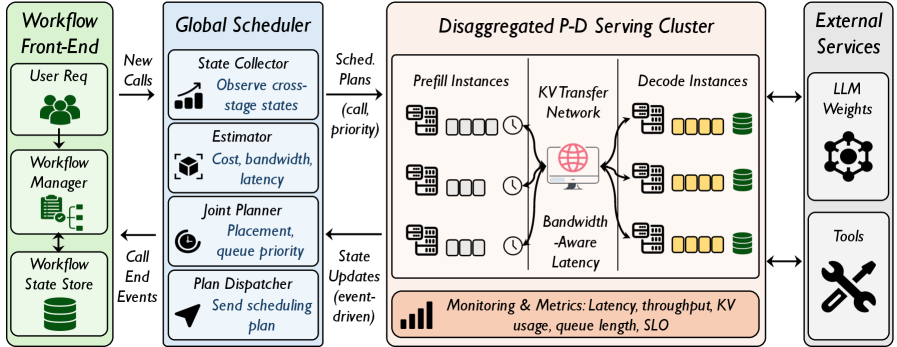
图 2:HexAGenT 的系统架构。全局调度器收集跨阶段快照,为每个就绪调用评估 prefill 时间、KV transfer 延迟和 decode 时间,联合决定实例放置和队列优先级。调度是异步的,不阻塞正在服务的调用。来源:论文 Figure 2。
四、数据里的四个信号
论文的实验部分值得被记住的,不只是 headline number,而是几个散布在各处的信号——每一个都独立地说了点什么。
信号一:Homogeneous 也能吃。 在纯 H200 集群上(没有异构 placement 选择),HexAGenT 仍然比 workflow-level FCFS 把 Req95 降低了 24.8%、Req99 降低了 36.8%。这说明异构 placement 是增益放大器,但不是 HexAGenT 生效的前提——workflow-level 的风险排序本身就比 FCFS 好一个量级。
信号二:Sequential 工作流获益最大。 四类 workload 里,ShareGPT(串行对话链)和 Mixed 的改善最明显——Qwen ShareGPT 的 Req99 从 5.45 降到 3.50(36%),Mixed 从 8.96 降到 3.94(56%)。这两个工作流的共同特征是串行依赖链条长——一个调用被卡住等于整个工作流被卡住,workflow-level 排序的价值在串行负载上被放大到最大。BFCL-v3(很多短 function call)的 Req95 改善较小(5.7%),因为 urgency-based 基线本身在短任务上就接近最优。
信号三:异构环境下跨 GPU 型号的 KV transfer 代价真实存在。 HexAGenT 的联合 prefill-decode planning 会主动避免高带宽代价的跨型号 placement。Qwen 在异构环境下的改善比 Llama 更大(Req99 33.1% vs 18.2%),因为 Qwen-235B 的 KV size 大得多,跨型号 transfer penalty 也更重——一个错误 placement 的代价足以在尾延迟上留下可见的疤痕。
信号四:调度开销可控。 HexAGenT 的调度开销平均 7.1–14.7ms per invocation,最差 23.7ms。考虑到一个工作流端到端执行时间通常在数秒到数十秒的量级,这个开销相当于千分之一到百分之一的量级——用几个毫秒的 CPU 计划换来了尾延迟上几十个百分点的改善,这个性价比没什么可争辩的。
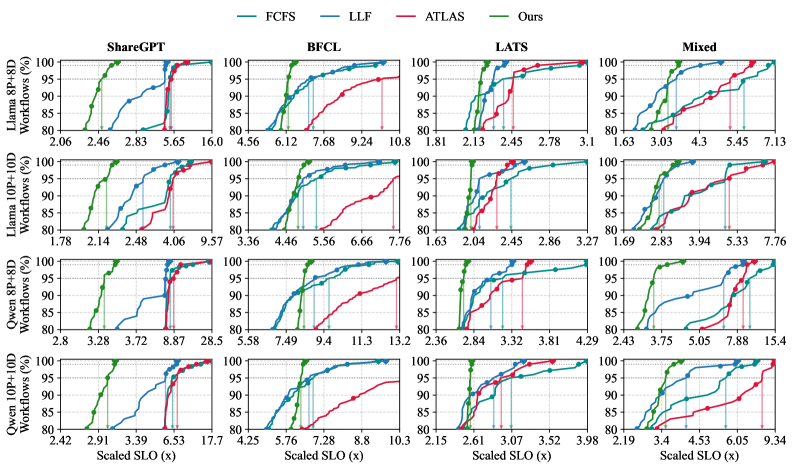
图 3:异构 A100/H100/H200 集群上的 SLO 达成率曲线。HexAGenT(蓝线)在所有 α 尺度上都在更左侧,意味着它以更紧的 SLO 约束达到了更高的工作流完成率。在 Qwen 和 Mixed/LATS 工作流上优势最明显。来源:论文 Figure 3。
五、这篇论文的局限性——以及它暗示什么
HexAGenT 的实验局限在它自己的实验环境中:4.6K 行 Python 模拟器 + SGLang v0.5.9 的 PD 分离实现。论文没有在生产规模的集群上做验证,没有在真实流量(而不是 trace replay)下运行,也没有把调度器集成到一个已经上线的 SaaS 推理平台里。这些限制都合理——学术论文很少能在生产环境里跑实验——但它们意味着 HexAGenT 的结论需要在更多样的 GPU 拓扑和真实流量模式下被复现。
更重要的问题是:HexAGenT 依赖两个估计——per-instance 的 roofline 服务延迟模型,以及 proxy model 的输出长度预测。这两个估计的质量直接影响调度决策的质量。论文的 robustness 实验(§7.6)表明即使给延迟估计注入 30% 乘性误差,Req99 退化不到 2%(Llama)到 10%(Qwen),但这仍然是在”误差均匀分布”的假设下做的——在真实生产环境中,估计误差可能高度偏斜,且与 GPU 型号、batch size、workload mix 存在非线性耦合。
但这些局限并不能削弱论文的核心主张。真正值得被记住的,不是 HexAGenT 的具体实现细节,而是它改变了问题本身。大多数推理系统研究的前提是”每个请求独立”,HexAGenT 把前提换成了”请求形成在线 DAG”——这个前提一变,所有以请求粒度为单位的优化都变成了一个错误的问题上的正确答案。 在 Agent 工作流已经进入生产的 2026 年,把调度目标从 call 升级到 workflow 不是锦上添花的细粒度优化——它是跟不跟进这个时代的分水岭。
参考资料
[1] HexAGenT: Efficient Agentic LLM Serving via Workflow- and Heterogeneity-Aware Scheduling
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。