把 256 个 agent 同时丢给推理引擎,会发生什么?直觉上的回答是吞吐量会上升——batch size 越大,GPU 利用率越高。但 CONCUR 论文[1]给出了一个反直觉的答案:吞吐量可能不升反降,而且降的原因不是计算瓶颈,是 KV cache 命中率的系统性崩溃。在 Qwen3-32B 上,SGLang baseline 完成 256 个 ReAct agent 需要 1480 秒;CONCUR 用同一批硬件只需 362 秒——4.09 倍加速,没有改模型,没有改 kernel,只改了一样东西:控制同时进入推理引擎的 agent 数量。
这篇论文命名了一种新的 KV cache 退化模式:“middle-phase thrashing”(中间阶段颠簸)。它不是出现在推理的某个请求内部,而是出现在一个 agentic batch 的中段——当所有 agent 都在做不同的事情、KV cache 池被碎片化的异步调用填满时,LRU 驱逐逻辑会自发地踢掉之后仍然需要的关键前缀。
一、三阶段退化:warmup → 颠簸 → cooldown
CONCUR 对 agentic 批推理的 KV cache 行为做了一个很细致的切片。一个 batch 的执行过程可以明确分成三个阶段。
Warmup 阶段:agent 刚刚启动,大部分请求都在复用相同的 system prompt 和工具定义,KV cache 命中率接近 90%。此时 cache 容量充足,LRU 驱逐几乎没有发生。
Middle 阶段:这是论文的核心发现。agent 开始产生生成内容——有的 agent 在生成思考链,有的在等待工具返回,有的正在从工具调用恢复。KV cache 池开始积累大量不同 agent 的中间状态。关键的时刻发生了:一个 agent 因为等待工具调用而暂时空闲,其前缀被 LRU 踢出,当工具返回该 agent 需要恢复时,整个前缀必须重新 prefill。这触发了一个连锁反应——额外 prefill 消耗了本已紧张的 KV cache 容量,进一步驱逐其他 agent 的等待前缀,又引发更多 agent 恢复时的重计算。论文测出 middle 阶段占据了超过 90% 的总执行时间,其中 49.1% 是额外重计算。”Thrashing”这个词用得精准:系统不是在服务 agent,而是在为被自己驱逐的东西反复买单。
Cooldown 阶段:agent 陆续完成任务退出,cache 压力消退,命中率自行恢复。
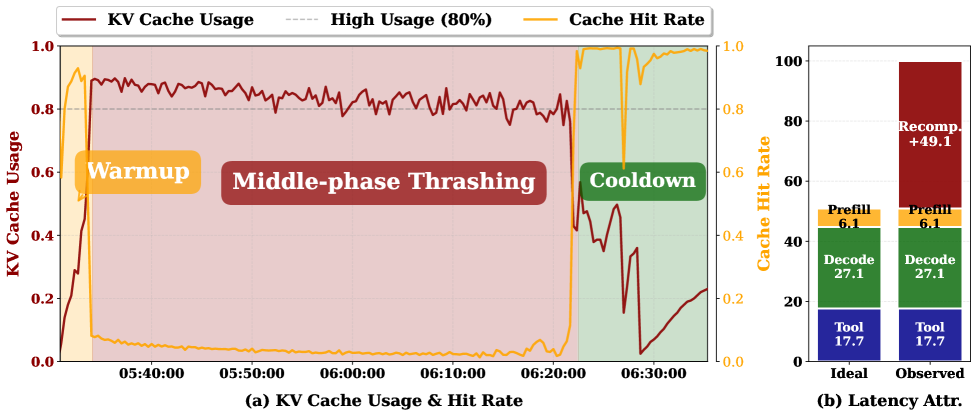
图 1:DeepSeek-V3 上 agentic 批推理的 KV cache 三阶段退化——Warmup(cache 使用量上升、命中率接近 90%)、Middle(cache 接近饱和但命中率崩盘,占据 >90% 总执行时间)、Cooldown(agent 陆续完成、压力消退)。来源:CONCUR 论文 Figure 3。
这三个阶段的分布有一个重要的工程含义:middle-phase thrashing 的严重程度由 batch 中的 agent 数量决定。batch 越大,cache 池被占满的速度越快,颠簸开始得越早、持续得越久。这意味着”加更多 agent”不是减轻而是加剧问题——这是一个正反馈驱动的退化模式。
二、根因:异步 agent 对 LRU 意味着什么
传统推理场景下,LRU(或基于 tree 的 prefix matching)工作得很好——请求大多是”一发入魂”的 chat completion,请求到达后一路完成,中间不会暂停。KV cache 块要么正在被活跃请求使用(保留),要么请求已结束(可以安全淘汰)。
Agent 场景打破了这两个假设。Agents 的天然特征是异步的:一个 agent 发出工具调用后,它的 KV cache 处于”暂时闲置”状态——请求没有结束,也没有在生成。从 LRU 角度看,这些块就是最理想的驱逐目标:最近最不活跃。问题在于,工具调用一结束,agent 就会恢复生成,此时它需要的是被 LRU 刚踢出、且包含了”我调用这个工具之前说了什么”的前缀。
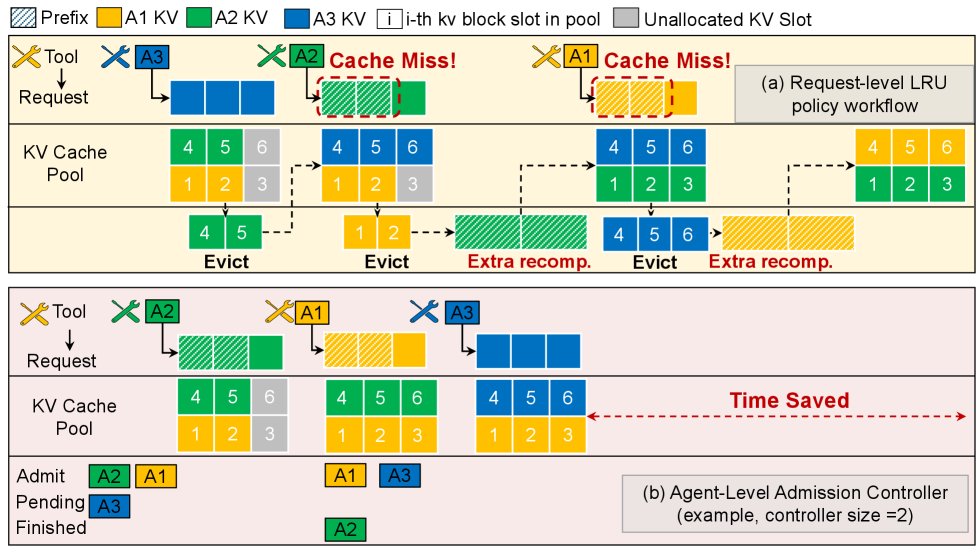
图 2:三 agent 工作流示意中间阶段颠簸的成因。 (a) LRU 驱逐导致暂停中的 agent(A1、A2)丢失 KV cache 条目,恢复时被迫重新 prefill,形成”驱逐→重计算→进一步驱逐”的正反馈螺旋。 (b) Agent 级准入控制限制并发,避免 cache 过度占用。来源:CONCUR 论文 Figure 2。
这是一个 cache 管理中最经典的问题——某些”冷”块不是真的冷,它们只是在等待。但 LRU 没有等待语义,它只有访问频率语义。CONCUR 的贡献不在于增加一种新的 prefix matching 算法,而在于识别出问题的维度不在 cache 算法本身,而在调度层——LRU 只是一个放大器,真正的信号应该在 agent 进入引擎之前就被拦截。
SGLang 的 RadixTree 和 vLLM 的 prefix caching 在这个问题上提供不了帮助。它们的 shared prefix 设计针对的是多个请求共享同一个前缀(如 system prompt)的场景——在同一个 batch 的 agent 之间,system prompt 和工具定义确实可以高效复用。但每个 agent 在 middle 阶段积累的会话特定前缀是独一无二的——没有其他 agent 可以共享”agent A 在第三轮对工具 X 的调用结果”。这是 LRU 级别的竞争,不是 prefix tree 级别的复用。
三、为什么固定并发控制反而更差
如果问题是 agent 太多导致 cache 争抢,直觉方案是限制同时活跃的 agent 数量。论文测试了这个方案——SGLang + Request Control(固定 cap 并发数)——结果是 2049 秒,比 SGLang 不加控制的 1480 秒还慢了 38%。这个结果比 middle-phase thrashing 本身更值得停下来想一想。
固定 cap 的问题出在两个层面。第一,它不知道 agent 是在”真干活”还是在”等工具”——如果一个 agent 在等一个慢工具返回,它占着一个 slot 却不产生计算,真正可以推进的 agent 被挡在外面。第二,固定 cap 无法感知 KV cache 的即时状态——即使 cache 命中率已经开始崩塌,cap 仍然允许新 agent 进入,因为”slot 没满”。
这引出了 CONCUR 的一个根基性洞察:agentic batch inference 的并发控制不是一个”控制多少 agent 同时跑”的问题,而是一个”在 KV cache 拥塞时减速、在缓存空闲时加速”的问题。它需要的不是一个固定的门,而是一个能感知缓存状态的反馈环路。
四、AIMD 拥塞控制:一个被精确搬运的网络隐喻
CONCUR 的作者做了一个非常漂亮的跨域类比:把 agent 视为 TCP flow,把 KV cache 视为网络带宽,把 cache 争抢视为网络拥塞——然后用经典的 AIMD(Additive Increase / Multiplicative Decrease)拥塞控制算法来管理 agent 并发窗口。
具体算法:维护一个全局 agent 准入窗口 W。当 KV cache 利用率 U < 20% 时,说明 cache 很空,W 按加法增加(W += 2),略微多放一些 agent 进来;当利用率 U > 50% 且命中率 H < 20% 时,说明 cache 不仅紧张、而且命中率已经崩了,W 按乘法削减(W *= 0.5),激进地减少并发 agent 数量,让已进入的 agent 先稳定完成一段、释放 cache 空间。
这两个条件的组合决定了这个算法对 middle-phase thrashing 的精准打击点。U 和 H 同时高(cache 满但命中很正常)不触发削减——这在 warmup 阶段是正常现象。U 和 H 同时低也不触发——这意味着 agent 本来就不多、cache 用得也少。只有当 cache 满了、而命中率也崩了时——也就是 middle-phase thrashing 的精准定义——窗口才会被乘法缩减。这恰好是 TCP 在检测到丢包时的”乘法降速”逻辑。区别在于 TCP 检测的是 packet loss,CONCUR 检测的是 cache hit loss。
这个类比的精确性还体现在”加法增加”的设计上。TCP 在无拥塞时缓慢扩大发送窗口(每 RTT +1 MSS),CONCUR 在 cache 宽松时缓慢增加 agent 并发量——两者都遵循”别用试探掩盖你真正不知道的事”的保守增长原则。网络领域几十年验证过的控制论直觉,被直接平移到了一个意外的领域。
五、Agent 级准入控制:调度粒度的质变
CONCUR 的架构实现本身并不重。它是一个在 agent 框架和推理引擎之间的轻量准入控制器,向外暴露三个原语:Admit、Pause、Resume。关键的工程决策是操作粒度——在 agent 级别,而不是 request 级别。
这意味着当窗口缩减时,CONCUR 不是拒绝某个孤立请求(那会丢弃一个 agent 的上下文),而是暂停选定 agent 的后续所有生成步骤,但不丢弃其已积累的 KV cache。暂停期间,agent 的 KV cache 仍然被保留(不需要等恢复时重新 prefill),只是没有新的请求被发送到推理引擎。当窗口重新扩大时,agent 被恢复,直接从自己的 KV cache 的断点继续。
这和前面讨论的”固定 cap + LRU 踢出”形成了三重对比:固定 cap 不知道暂停和只拒绝一个请求的区别、不知道 cache 即时状态、也不保留被暂停 agent 的 KV cache——被 LRU 踢出后的恢复是重新 prefill 全部历史。
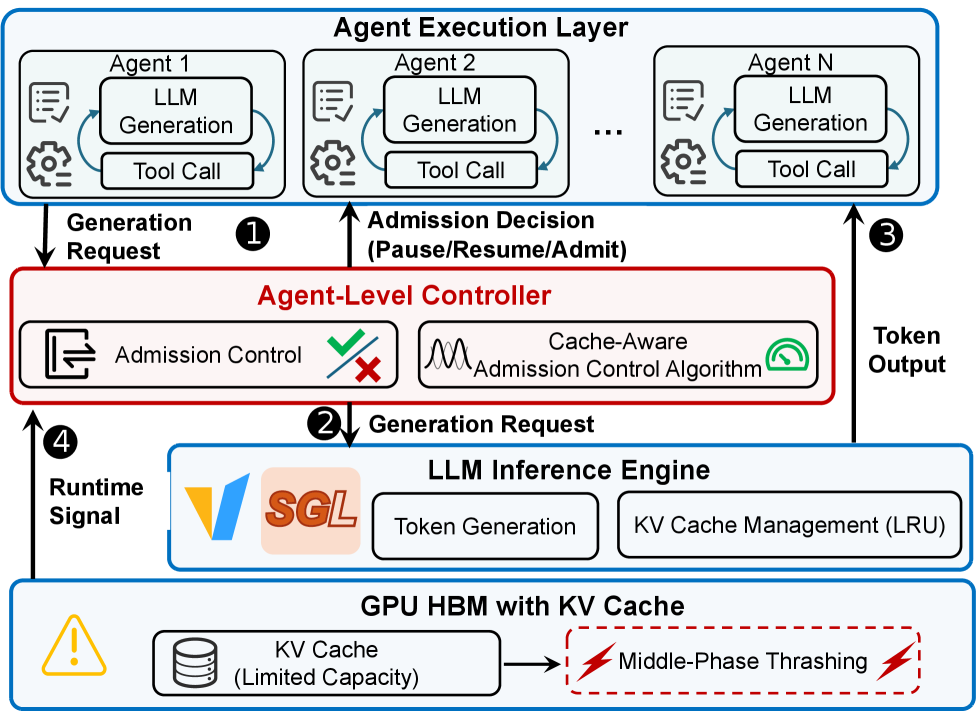
图 3:CONCUR 系统架构——在 Agent Execution Layer 与 LLM Serving Engine 之间插入轻量级 Agent-Level Controller,通过 Admit / Pause / Resume 三个原语在 agent 粒度调控准入。来源:CONCUR 论文 Figure 4。
在 Qwen3-32B(TP=8, 8 GPUs, batch 256)上的完整对比:
| 方案 | 总时间 | 缓存命中率 |
|---|---|---|
| SGLang baseline | 1480s | ~35% |
| SGLang + Request Control | 2049s | 更差 |
| SGLang + HiCache | 976s | 改进 |
| CONCUR | 362s | ~73% |
在 DeepSeek-V3 上,CONCUR 将命中率从 35.41% 提升到 73.36%,端到端时间从 3877s 降到 2043s(1.90 倍加速)。固定并发最佳延迟为 1231ms,CONCUR 自适应窗口降至 846ms。
这些数字背后有一个更深的工程判断:agentic 推理的性能瓶颈正在从”模型跑得不够快”转移到”模型在做太多不该做的工作”。CONCUR 解决了后者——它不加速任何一个单独的生成步骤,它减少的是”把已经算过的东西再算一遍”的步骤。在 middle-phase thrashing 最严重的 256-agent batch 里,4.09 倍的加速几乎全部来自减少重计算。
六、结论:评测 agentic serving 需要新指标
CONCUR 这篇论文最值得被记住的,不只是 AIMD 类比或 4.09 倍的加速——而是它揭示了一个事实:当前的推理系统评测框架(TTFT、TPOT、吞吐量)不足以捕捉 agentic batch 推理的真实性能瓶颈。
如果只报告单请求的 latency 和 batch 的总吞吐量,middle-phase thrashing 不会被单独识别——它被平均到了漫长的总执行时间里,和正常的计算开销混在一起。它的影响只有在同时观察 KV cache 命中率的时间序列时才会浮出水面。而当前的 agent 评测[2]报告的是成功率和步数,KV cache benchmark 报告的是压缩率和命中率——两者之间没有一个指标专门衡量”一个 batch 中有多少延迟来自缓存颠簸而非原生计算”。
在固定并发控制比不加控制更慢这个结论里,还可以看到另一个重要的评测缺口:batch size 本身不是一个可以固定下来的配置参数,它在 agentic 场景下是一个需要动态调整的运行时变量。不同 agent 在不同阶段的 KV cache 占用差异极大——一个正在跑长推理链的 agent 和一个在等工具返回的 agent,对 cache 池的压力完全不同。固定 batch size 把所有 agent 的 cache 需求均匀化了,这正是 middle-phase thrashing 的正反馈起点。
CONCUR 给出的方向是明确的:agentic serving 的性能优化应该在 agent 框架和推理引擎之间插入一个能感知 cache 状态的自适应控制层。这个控制层不需要理解 agent 的具体逻辑——它只需要知道 KV cache 的空余量、命中率,和当前有多少 agent 在”真干活”、多少在”等工具”。基于这几个信号做 AIMD,就是一个极其简单但极其有效的方案。
评测体系的演进也应该朝这个方向走:与其继续用固定的 batch size 压测推理引擎,不如用带有异步暂停/恢复语义的 agentic trace 来测——然后报告的不只是吞吐量,还有”有效吞吐量”(扣除重计算后的净增量)和”cache thrashing 占比”。后者才是 agentic 推理真正关心的指标。
参考资料
[1] CONCUR: High-Throughput Agentic Batch Inference via Congestion-Based Concurrency Control
[2] SCBench: A KV Cache-Centric Analysis of Long-Context Methods
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。