版本声明:TRT-LLM 分析基于 commit
0119a237(2026-05-12);vLLM 分析基于 releasev0.8.5;SGLang 分析基于 2026-05-13 时的 main 分支;除非特别说明,以下描述均基于这些版本。
一次带有 2048-token system prompt 的对话,加上前缀复用之后 TTFT 可以从 450ms 降到 95ms——4.7 倍的提速[1]。但这个数字有一个隐藏的前提:前缀恰好对齐了物理 block 的边界。如果实际前缀是 2049 个 token,而 block size 是 128,最后那个残缺 block(仅 1 个 token)是否也参与复用,取决于用的是哪个推理框架——以及背后算法对”命中”这件事的定义有多严格。
前缀匹配算法是 KV Cache 复用率的天花板。SGLang 选择了压缩 Radix Tree 加节点分裂,能在任意 token 边界命中;vLLM 选择了链式哈希加二分搜索,匹配粒度被锁在固定 block 边界;TRT-LLM 在 C++ 批调度器里用 per-block Trie 加多维 BlockKey,在 Python v2 调度器里用 SHA-256 链式哈希加受限部分匹配。三条路各有自己的工程假设,每一条都能在自己设定的场景里自圆其说。
这篇文章从源代码层面剖析这三套实现,目标不是选出”最好”的算法,而是还原每个设计决策背后的约束和取舍。
一、数据结构是设计假设的直接表达
三框架的算法选择集中在三种数据结构上,先把它们的根本区别讲清楚,后面的分析才不会混成一团。
标准 Trie 的节点粒度是单个 token——对于 LLM 推理来说几乎没有实用价值。一个 32K token 的序列会产生 32K 个节点,路径上大量的单子节点链只是在浪费内存,并把每次查找变成连续指针追踪的 cache miss 压力。
压缩 Radix Tree(Patricia Tree)的核心操作是把不分叉的单子节点路径折叠成一个节点,每个节点存储的是一段 token 序列而非单个 token。折叠带来两个后果:节点数量 ≤ 叶节点数,内存大幅降低;插入时可能需要节点分裂,当新序列只与现有节点部分重合时,把重合前缀拆分成独立节点。这个”分裂”操作是支持任意前缀精度的代价。
Hash Map 最直接:对每个完整 block 的内容计算哈希,以哈希值为 key 查找对应的物理 block。单次查找 O(1),但它只认完整 block——不满一个 block 的残缺前缀没有对应的哈希,自然也就没有命中。
| 框架 | 数据结构 | 节点粒度 | 支持部分 block 命中 |
|---|---|---|---|
| SGLang | 压缩 Radix Tree | 可变(按 page 对齐) | ✅ 任意 token 边界 |
| vLLM | 链式哈希 + 平坦 Hash Map | 固定 block(16 tokens) | ❌ |
| TRT-LLM C++ | Per-block Trie | 固定(128 tokens) | ✅(最后一个 block) |
| TRT-LLM Python v2 | 链式哈希 + 树形结构 | 固定 + 受限部分 | ✅(≤32 子节点时) |
选型背后是三个不同的系统假设:精度损失是否会直接转化为复用率损失;工程简洁性和极限精度哪个更重要;生产环境有没有 Python 框架天然解决不了的并发问题。
二、SGLang:以 child_key 换精确度
SGLang 的实现在 python/sglang/srt/mem_cache/radix_cache.py,核心类是 RadixCache。树的每个节点 key 是 RadixCacheKeyData 对象(内部是 token id 数组),value 是对应的 GPU 显存 page 索引。
压缩 Radix Tree 的查找有一个经典问题:节点 key 是可变长的 token 序列,如果用完整序列做字典 key,每次比较的代价是 O(key 长度)。节点越多,查找越慢。SGLang 的解法是 child_key 路由——子节点字典以 key 的第一个 page 的哈希值为索引,而不是完整 key:
def _match_prefix_helper(self, node, key):
    child_key = key.child_key(self.page_size)  # 只对第一个 page 计算 hash → O(1)
    while len(key) > 0 and child_key in node.children:
        child = node.children[child_key]
        prefix_len = child.key.match(key, page_size=self.page_size)  # token 级精确比较
        if prefix_len < len(child.key):
            new_node = self._split_node(child.key, child, prefix_len)
            value.append(new_node.value)
            break
        else:
            value.append(child.value)
            node = child
            key = key[prefix_len:]
            child_key = key.child_key(self.page_size)
当 child_key 把查找导向某个子节点后,child.key.match(key) 做 token 级精确比较,确认实际匹配了多少个 token。如果匹配长度小于子节点 key 的完整长度,说明只有部分前缀重合,触发节点分裂:把现有节点的前 split_len 个 token 提取为新的中间节点,原节点变成中间节点的子节点,只保留后缀部分。
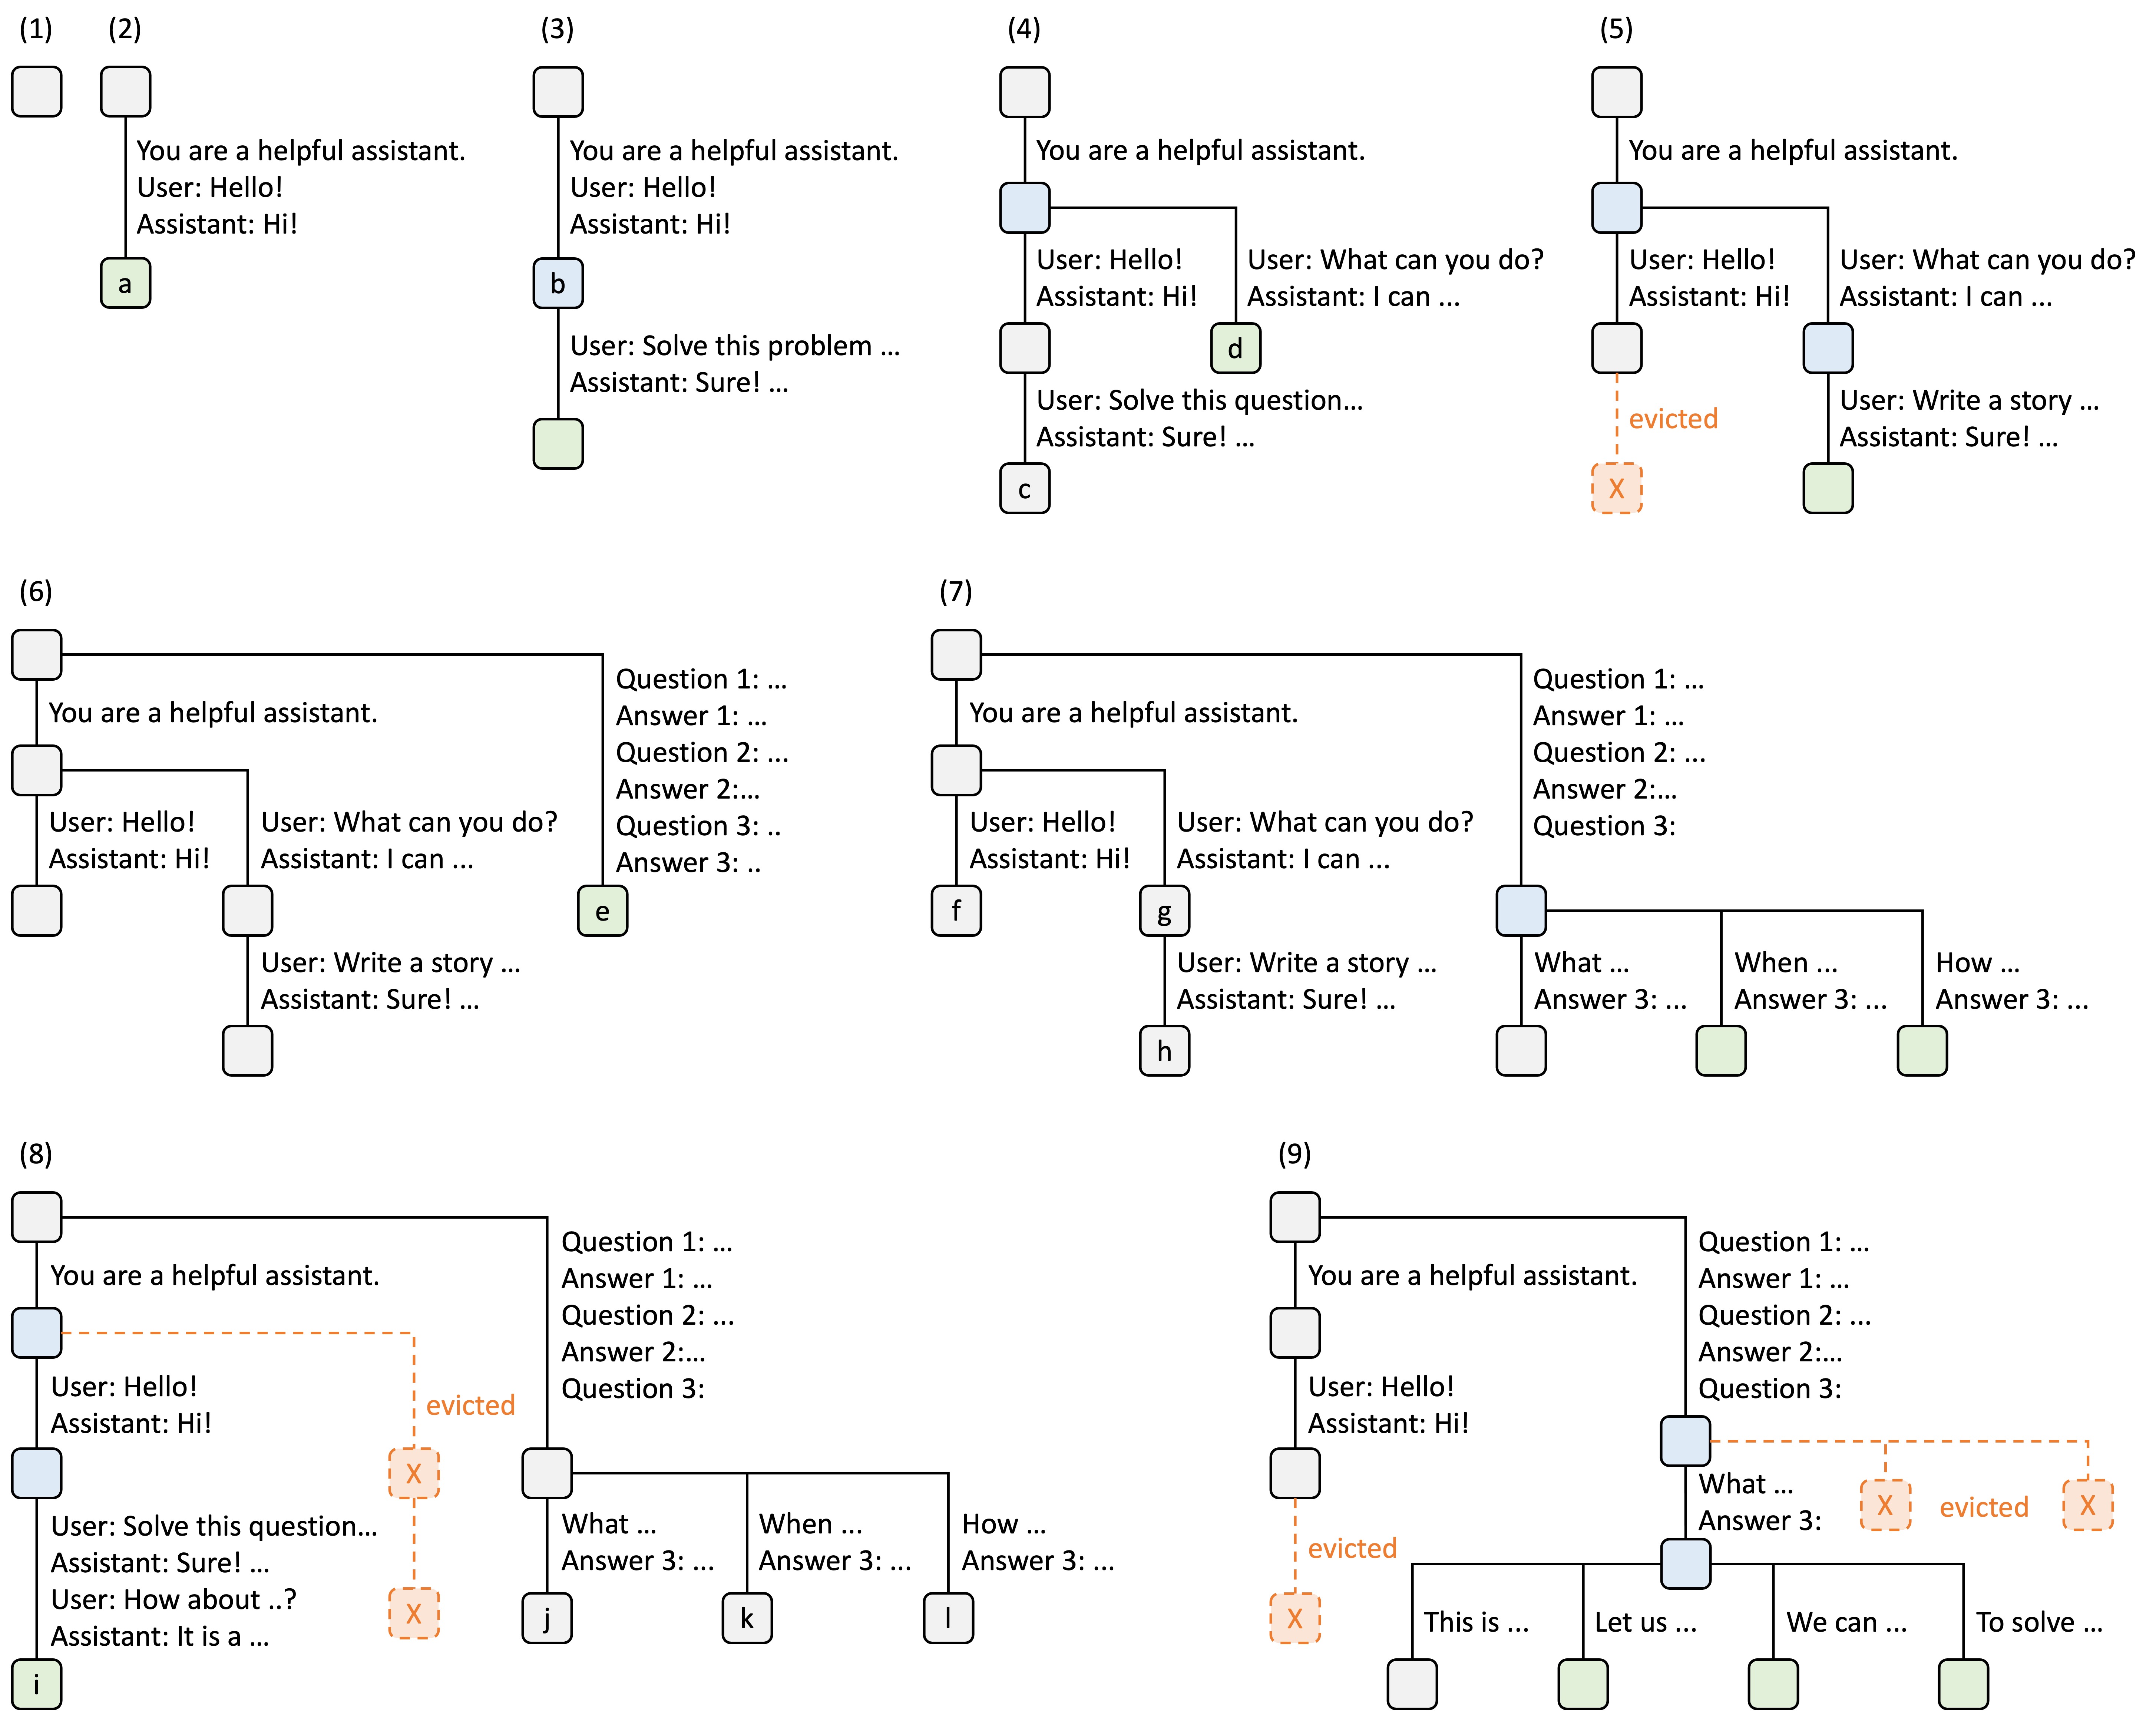
图 1:SGLang RadixAttention 九步操作演示,涵盖插入、匹配、分裂与 LRU 淘汰。步骤四出现的节点分裂是支持任意前缀精度的关键机制——两个只在末尾不同的请求可以共享前缀部分的 KV block。来源:LMSYS Blog[3]。
child_key 碰撞怎么处理?即使两个不同子节点的第一个 page 哈希恰好相同,后续的 match() 调用也会通过 token 级比较正确过滤误匹配——正确性不受碰撞影响,只是多了一次无效比较。碰撞本身在哈希空间足够大的情况下极为罕见,实际系统中不构成问题。
前缀查找的整体复杂度是 O(P) 次 O(1) 哈希表查找(P 是序列中的 page 数),外加 O(k) 的 token 级比较(k 是被命中节点的 key 长度)。任意 page 边界都能命中——只要场景对精度敏感,SGLang 的算法不会在 block 粒度上留下复用损失。
三、vLLM:单调性让二分搜索成立
vLLM v0.8.5 的实现在 vllm/core/block/prefix_caching_block.py,核心数据结构是一个平坦哈希表[2]:
self._cached_blocks: Dict[PrefixHash, BlockId] = {}
key 是 block 内容的链式哈希值(Python int),value 是物理 block ID。链式哈希是整套设计的基础——每个 block 的哈希不只包含本 block 的 token,还依赖前一个 block 的哈希:
def hash_block_tokens(
    is_first_block, prev_block_hash, cur_block_token_ids, extra_hash=None
) -> PrefixHash:
    return hash((is_first_block, prev_block_hash, *cur_block_token_ids, extra_hash))
链式哈希创造了一个单调性性质:对于序列 T[0:N],若第 i 个 block 的哈希在缓存中命中,则前 i 个 block 的哈希也必然命中——因为每个 block 的哈希值依赖其所有前驱的哈希。命中序列的形态必然是 [True, True, True, False, False, ...],这让二分搜索直接成立:
def find_cached_blocks_prefix(self, block_hashes):
    def _block_is_cached(idx):
        return block_hashes[idx] in self._cached_blocks

    return bisect_left(range(len(block_hashes)), False,
                       key=lambda x: not _block_is_cached(x))
bisect_left 找到第一个 False 的位置,O(log N) 次哈希表查找得出最长命中前缀的长度。
vLLM 使用 Python 内置的 hash(),64 位,非加密哈希。对于 n = 10⁶ 个 block,碰撞概率约 5.4 × 10⁻⁸——实用中可接受,但非零。碰撞发生时,错误的 block 内容会被复用,输出不正确。TRT-LLM Python v2 换用 SHA-256(256 bit),把碰撞概率降到 ≈ 4.3 × 10⁻⁶³,工程上可视为零,代价是更高的哈希计算成本。
vLLM 还有一个防竞争机制:mark_blocks_as_computed 的延迟标记。同一调度步内生成的 block 不会立即写入 _cached_blocks,本轮调度完成后才注册。这防止了同一 batch 内两个请求竞相复用彼此刚生成的 block,在不引入显式锁的前提下维持了正确性——Python GIL 保证调度函数本身串行,延迟标记只需要处理 batch 内的时序问题。
vLLM 匹配精度的上限是固定 block 粒度(默认 16 tokens)。序列末尾不满一个 block 的残缺前缀永远不参与复用。对于 system prompt 长度恰好不对齐 block 边界的场景,每次请求都会丢掉最后几个 token 的缓存收益。
四、TRT-LLM C++:多维键与两阶段并发
TRT-LLM 的 C++ 批调度器需要解决 Python 框架不需要面对的问题:多线程并发调度。这个约束从根本上改变了算法的设计。
4.1 BlockKey:多维隔离的基石
C++ 实现的前缀匹配核心在 blockKey.h,BlockKey 结构体编码了远超”token 序列”的多维信息:
struct BlockKey {
    std::optional<LoraTaskIdType> loraTaskId;    // LoRA 适配器 ID
    VecUniqueTokens uniqueTokens;                // token 序列(含唯一 ID)
    std::vector<MmKey> extraKeys;                // 多模态内容哈希(图片/视频)
    std::optional<CacheSaltIDType> cacheSaltID;  // 租户隔离盐值

    int numMatchingTokens(BlockKey const& other) const noexcept {
        if (loraTaskId == other.loraTaskId
            && extraKeys == other.extraKeys
            && cacheSaltID == other.cacheSaltID) {
            auto [matchEnd, _] = std::mismatch(
                uniqueTokens.begin(), uniqueTokens.end(),
                other.uniqueTokens.begin(), other.uniqueTokens.end());
            return std::distance(uniqueTokens.begin(), matchEnd);
        }
        return 0;  // 任一维度不匹配 → 直接返回 0
    }
};
LoRA 隔离是这个设计的典型受益场景:不同 LoRA 适配器产生的 KV Cache 不可共享,两个请求的 loraTaskId 一旦不同,numMatchingTokens 直接返回 0,无需额外的隔离逻辑层。多模态请求同理——extraKeys 里的图片哈希不匹配,block 自然不会被跨请求复用。
UnifiedBlockTree 用一棵树服务所有注意力窗口类型(Full Attention、Sliding Window Attention、Mamba/SSM),通过 WindowSize 作为 value 的 channel 键区分。Mamba/SSM 使用哨兵值 kRecurrentStates = -1,与 Attention 的 window size 语义明确隔离,避免了为不同模型类型维护多棵树的管理开销。
4.2 精确匹配与部分匹配的二分法
Trie 节点支持两条查找路径。精确匹配走哈希表,O(1);部分匹配要线性扫描所有子节点,O(C)(C 为子节点数):
// 精确匹配
Node* findMatchingNode(BlockKey const& key) {
    auto it = mNextNodes.find(key);
    return it != mNextNodes.end() ? it->second.get() : nullptr;
}

// 部分匹配:扫描所有子节点,按匹配长度降序排序
std::vector<PartialMatch> findPartiallyMatchingNodes(BlockKey const& key) {
    std::vector<PartialMatch> results;
    for (auto const& [nodeKey, node] : mNextNodes) {
        int matchLen = key.numMatchingTokens(nodeKey);
        if (matchLen > 0) results.push_back({node.get(), matchLen});
    }
    std::sort(results.begin(), results.end(),
              [](auto const& a, auto const& b) { return a.matchLen > b.matchLen; });
    return results;
}
正常前缀匹配走精确路径,每个 block 对应一次 O(1) 哈希查找。只有序列最后一个 block 才可能走部分匹配——因为最后一个 block 可能尚未填满,不存在完整的精确 key。生产场景中 C 通常很小(热门前缀下的分支数有限),O(C) 的实际代价可控。
findReusableBlockMatches 还做了 SWA(Sliding Window Attention)安全检查。SWA 下,只有窗口内的 KV Cache 才能被复用;若 anchor block(窗口边界的锚块)缺失,继续向前读取的 cached block 可能超出有效窗口,产生错误的注意力计算。latestMissingAnchorEndToken 记录最后一个缺失 anchor 的位置,在这里截断匹配结果——SWA 场景下缓存安全性的硬保障。
4.3 两阶段 Claim:解决 TOCTOU
Python 框架(SGLang、vLLM、TRT-LLM Python v2)依赖 CPython GIL 保证调度函数串行执行,查找和分配之间不存在时序竞争(TOCTOU,Time of Check to Time of Use)。C++ 批调度器是多线程的,如果 Phase 1(查找到可复用 block)和 Phase 2(实际分配内存)之间有线程切换,同一 block 可能被两个请求同时”认为”可用,导致 double claim 或内存损坏。
TRT-LLM 的解法是两阶段 Claim。Phase 1 在 mLookupTree 的 recursive_mutex 锁保护下执行:找到所有可复用 block,立即对它们 ref+1,防止被 evict;对 partial block,通过 PartialClaimTracker 协调竞争——只有最后到达的请求成为”复用者”(reuser),可以继续向该 block 写入新 token,其余竞争者成为”复制者”(copier)。这一阶段只做簿记操作,不涉及 GPU 内存搬运,持锁时间在微秒量级。
Phase 2 释放锁后执行:复制者申请新的空闲 block,通过 TransferManager::onboard 把 cached block 内容拷贝过来;复用者摘除 partial leaf block,将其转为自己的专属 block。耗时的内存操作在锁外并行执行。
PartialClaimTracker 的”最后竞争者获胜”策略最大化了 block 利用率:reuser 不需要额外申请内存,直接在原 block 上扩展,只有竞争失败的请求才需要支付内存拷贝的代价。
五、TRT-LLM Python v2:哈希安全性与软限制
TRT-LLM Python v2 调度器(tensorrt_llm/runtime/kv_cache_manager_v2/)融合了 vLLM 的链式哈希思想和树形结构,最显著的差异是哈希函数:
BlockKey = bytes  # SHA-256 digest,32 字节

def sequence_to_blockchain_keys(tokens_per_block, lora_task_id, tokens):
    digest = Hasher(lora_task_id).digest      # 根哈希,加入 LoRA task ID
    yield [], digest
    for token_block in chunked(tokens, tokens_per_block):
        digest = Hasher(digest).update(token_block).digest  # H[i] = SHA256(H[i-1] || tokens[i])
        yield token_block, digest
代码注释明确标注 Hasher 是 perf-critical,通过 type() 精确判断(而非 isinstance())区分 int 和 bytes 的快路径,把 SHA-256 的计算代价压到最低。
部分匹配有一个明确的软限制:
def find_best_partial_match_in_next_nodes(block, tokens):
    if len(block.next) >= 32:
        # TODO: build a database to accelerate partial matching. (TRTLLM-7784)
        return None, 0  # 子节点太多时放弃部分匹配
    ...
当一个节点有 32 个或更多子节点时,直接放弃部分匹配,返回无命中。这是主动用命中率换延迟稳定性——O(32) 的线性扫描代价可控,但某个热门前缀下的分支数若持续增长,不加限制的线性扫描会造成 TTFT 尖峰。TRTLLM-7784 跟踪了用加速索引替代线性扫描的优化计划,32 是当前务实的临时边界。
与 C++ 版本不同,Python v2 不需要两阶段 Claim——GIL 保证调度函数串行,查找和分配之间没有线程竞争。
六、并发:GIL 是隐藏的架构假设
Python 框架把并发安全这件事静默地外包给了 CPython——因为 GIL 的存在,Python 解释器内同一时刻只有一个线程在执行字节码,调度函数不需要担心”查找”和”分配”两步之间会被打断。这让 SGLang 和 vLLM 的代码保持了极高的简洁性,但也把系统架构绑定在了 CPython 单进程模型上。
TRT-LLM C++ 的 BatchManager 打破了这个假设。UnifiedBlockTree 用 std::recursive_mutex 显式保护树的读写,Phase 1 在持锁状态下完成所有 block 的 claim,Phase 2 释放锁后再做内存操作。recursive_mutex(可重入互斥锁)的选型允许同一线程在已持锁时重入获取同一把锁,避免了某些递归调度路径下的死锁风险。
持锁时间短是关键。Phase 1 里的所有操作(ref+1、PartialClaimTracker 协调)都是轻量的簿记,不涉及任何 GPU 内存搬运;耗时的 onboard(block 内容拷贝)放在 Phase 2,锁已释放。这个分离把持锁窗口压到微秒量级,避免了锁竞争成为调度吞吐量的瓶颈。
从这个角度看,C++ 版本的复杂性不是过度设计,而是在移除 GIL 这个隐式假设之后,必须把 Python 框架”免费获得”的线程安全显式地写出来的工程代价。
七、适用边界与选择逻辑
三套算法在命中精度、并发模型、功能边界上各有侧重,选型逻辑相对清晰。
超长 system prompt 场景,追求最高复用率,SGLang 的 Radix Tree 在任意 token 边界上都能命中。场景越是 prompt-heavy(同一 system prompt 服务大量用户请求),child_key 路由的精度优势就越明显。RAG 多轮对话(3072 token 前缀)场景下,理论上可以把 TTFT 从 620ms 压到 70ms 附近,比对齐优化不到的 vLLM 实现多捞回几十个 token 的缓存。
大规模部署,工程稳定性优先,vLLM 的平坦 Hash Map 实现简单,调试容易,Python GIL 保证线程安全,没有节点分裂的维护代价。block 粒度命中对绝大多数生产场景够用,O(log N) 的二分搜索在 block 数量较大时理论上优于 O(N) 线性遍历——虽然在 N 较小(典型序列下 N ≈ 512)的场景里,哈希表 LLC miss 的实际代价会让渐进分析意义有限。
企业多租户、多 LoRA 适配器,或混合模型(Mamba + Attention),TRT-LLM C++ 的 BlockKey 原生支持 LoRA 隔离、多模态隔离和租户隔离,UnifiedBlockTree 统一管理所有注意力窗口类型,功能边界在三套实现里最宽。两阶段 Claim 的并发设计让它能在 C++ 多线程批调度器中稳定运行。
八、结论
三种算法都正确,但它们回答的是不同的问题。
SGLang 问的是:如果每一个 token 都可能有人在等它,有没有办法让前缀复用精确到 token 粒度?Radix Tree 加节点分裂给出了理论上优雅的答案,代价是树的动态维护开销。vLLM 问的是:在不引入复杂数据结构的前提下,能实现多少前缀复用?链式哈希加二分搜索在 block 粒度上给出了够用的答案,代价是放弃残缺 block 的命中机会。TRT-LLM 问的是:如果系统里有 LoRA 切换、多模态请求、租户隔离、SWA,还需要同时管理 Mamba 的 recurrent state,单一 token 序列还够不够用作 cache key?BlockKey 的多维编码和两阶段 Claim 给出了答案,代价是显著的实现复杂度。
选框架时,算法选型背后的系统假设比算法本身更值得关注。vLLM 和 SGLang 的 Python GIL 依赖意味着两者的调度模型绑定在 CPython 单进程上;TRT-LLM C++ 的两阶段 Claim 意味着它在显式处理一个 Python 框架从未面对的问题。部署场景足够复杂时,这些假设的差异最终会浮到水面上来。
参考资料
[1] SGLang: Efficient Execution of Structured Language Model Programs
[2] Efficient Memory Management for Large Language Model Serving with PagedAttention
[3] SGLang RadixAttention Blog Post (LMSYS, Jan 2024)
[4] vLLM Automatic Prefix Caching Documentation
[5] TRT-LLM KV Cache Runtime Architecture 深度解析
[6] TensorRT-LLM GitHub Repository
版本对齐信息
| 材料 | 版本 / 标识 | 查询日期 |
|---|---|---|
| TRT-LLM 源码 | commit 0119a237 |
2026-05-13 |
| vLLM 源码 | release tag v0.8.5 |
2026-05-13 |
| SGLang 源码 | main branch | 2026-05-13 |
| SGLang 论文 | arXiv 2312.07104 | 2026-05-13 |
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。