版本声明:本文分析基于 TensorRT-LLM 主分支 commit
f8d7ecb169a1(2026-05-09);分离式 Serving 与 Dynamo 部分参考 tech_blog5 和当前官方文档,不绑定单一 commit。
一次生产推理请求的生命周期里,TensorRT-LLM 的 Attention kernel 期望 KV cache 以特定张量格式出现。这个格式在引擎编译时就已固化:每个 block 对应各层各头 [2, num_kv_heads, tokens_per_block, head_dim] 大小的一块显存切片,多层共用同一个 block 的物理位置。TensorRT 内核的地址访问是编译进去的,运行时无法重新调整布局。
这个约束定义了 TRT-LLM KVCache 管理的起点:block 本身是一个固定接口,而不是可以在运行时随意重组的软件抽象。哪些 block 需要复用、哪些可以降级到 host memory、哪些可以卸载到 NVMe、哪些应该被淘汰——这些问题都在 block 的粒度上组织,前缀共享是后来叠加在 block 层之上的索引能力。
本文要分析的,正是 TRT-LLM 如何在这个约束下,把 block 的生命周期组织成能横跨 GPU/Host/NVMe 三层存储的缓存系统,如何把这套系统的实时状态通过事件 API 暴露给外部路由层,以及如何在 prefill-decode 解耦的分离式 Serving 场景里,借助 NIXL 把 block 的所有权在实例间传递。
一、Block 与 Pool:分页存储的基本结构
TRT-LLM 的 KVCache 在源码里以 KVCacheBlockPool 和 KVCacheBlock 两个层次来组织[1]。
KVCacheBlockPool 是实际存储 KV 数据的容器,包含两个指针:primaryPtr(GPU 显存)和 secondaryPtr(Host 内存)。两者共享同一套 block 编号体系——当一个 block 从 GPU 降级到 host,它在物理上换了内存区域,但在整个 block 管理层里的逻辑 ID 保持不变。这是后续三层卸载能在 block 粒度统一处理的前提。
Pool 的粒度是按注意力窗口大小 × KV head 数量划分的。GQA 和滑动窗口注意力(SWA)场景里,不同 layer 可能有不同的 head 数或 window size;TRT-LLM 为每种组合单独创建一个 pool,由 WindowBlockManager 分别管理[1]。MLA(Multi-head Latent Attention)等压缩 attention 变体也遵循同样的 pool 隔离逻辑,只是 head 维度的定义不同。
KVCacheBlock 只保存元数据,没有实际的数据指针。它携带的是:线性 block ID、在 memory pool 里的物理偏移(mMemoryPoolBlockIndex)、引用计数(mRefCount 和调度阶段用的 mSchedulingRefCount)、优先级(mPriority)、过期时间(mExpirationTime)、用于事件 API 的哈希(mHash),以及挂载在前缀树上的节点指针(mLookupNode)[1]。block 是否在 GPU 上,由 isPrimary() 方法判断——它检查的是 mMemoryPoolBlockIndex 的类型位,而不是指针本身。
默认 block 大小是 128 tokens,可通过 --tokens_per_block 配置(必须是 2 的幂次)。这个粒度的选择是 I/O 效率和匹配细度之间的权衡:128 tokens 的 block 在大部分场景下足够填满、适合 prefetch;但对于只共享了几个 token 的场景,会有内部碎片浪费。
源码里还有一个细节值得注意:kPrimaryLevel = 0,kSecondaryLevel = 1 是写死的常量[1]。整个 block 的”在哪一层”判断依赖这两个常量,不是动态配置的。这意味着两层(GPU + Host)是设计上的硬边界,第三层 NVMe 通过 KvCacheTransferMode 的枚举值引入,绕过了这个两层框架,以一种”转移模式”而非”存储层”的方式接入。
二、WindowBlockManager:Block 生命周期的中央调度
WindowBlockManager 是 TRT-LLM block 生命周期管理的核心[1]。它维护当前 window size 下的所有 block 元数据,包括:空闲块队列(FreeBlocksQueue)、按请求分组的已分配块映射,以及用于调度的”虚拟可用块数”(mSchedulingNumFreeBlocks)。
调度阶段和实际分配阶段对 free block 的计数是分开的:schedulingHasFreeBlocks() 检查的是 mSchedulingNumFreeBlocks,用于 batch scheduler 在提交任何实际分配前预判请求能否被接纳;hasFreeBlocks() 检查的是实际空闲数,用于正式分配。这个双计数设计允许 scheduler 在”脑补”一轮批次调度时,不影响真正的 block 状态。
addSequenceBatch() 是这套设计里最重要的方法,它处理批量请求的 block 分配,分成两个阶段执行[1]:
Phase 1(Claim):在统一的前缀树锁下,遍历 radix tree,为批次里每个请求找到可复用的前缀 block,并将它们”认领”(ClaimResult)。认领的含义是提前持有引用,防止这些 block 在后续步骤里被淘汰。Phase 1 还会处理跨请求的 partial match 竞争:如果两个请求都想复用同一个 block 的部分内容,第一个请求 in-place 复用,后续请求触发 copy。
Phase 2(Onboard + Allocate):锁仍然持有。把 Phase 1 认领到的 host 端 block 搬回 GPU(onboard),并为前缀之外的新 block 从空闲队列分配。Phase 2 结束后才释放树锁。
这个两阶段设计的意义是避免了以下竞态:如果 Phase 1 匹配到一个 block 后立即释放树锁,另一个并发请求可能在 Phase 2 开始前把这个 block 淘汰掉,使 Phase 1 的搜索结果失效。
三、RadixBlockTree:叠加在 Block 上的前缀索引
TRT-LLM 的前缀复用机制通过一棵 radix_block_tree::UnifiedBlockTree 实现[1]。它是一棵所有 window size 共用的查找树,每个节点(LookupNode)可以挂载多个 block,分别对应不同的 window size。KVCacheBlock 通过 attachToLookupNode() 和 detachFromLookupNode() 挂载和卸载。
一个关键的设计决定是:前缀树索引的是 block,而 block 本身的物理内存由 pool 管理。这和 SGLang 的设计顺序相反——在 SGLang 里,radix tree 节点本身就承担了 KV 生命周期的角色,节点的 lock_ref、host_value、priority 等字段直接记录了 KV 的当前状态[2];在 TRT-LLM 里,树节点是一个纯查找索引,block 的状态(在不在 GPU、被谁引用、优先级多少)记录在 KVCacheBlock 对象里,树只是告诉你”这个 token 序列曾经被算过,对应的 block 在哪”。
匹配时,analyzePrefixReuse() 做一次完整的树 walk,返回一个 PrefixReuseSummary,包含:已分配的可复用块数(用于 block 预算计算)、全量可复用块数(用于 token 预算计算),以及第一个在树里找不到的 block key(用于 scheduler 判断是否跳过这个请求)[1]。单次 walk 合并了原先需要多次调用的信息,减少了树遍历开销。
enable_partial_reuse 允许匹配一个 block 里的部分 token。当源 block 还有其他引用(isShared()),partial match 会触发 copy:把源 block 复制一份,新请求用那份复制体,原 block 继续被其他请求持有。copy_on_partial_reuse 参数控制这个 copy 行为是否在 partial match 时总是触发,还是只在有引用冲突时触发。
cache_salt 是命名空间隔离的机制:不同 salt 值的请求之间不共享 block,用于租户隔离或安全场景(防止缓存侧信道)[3]。
四、优先级淘汰:KvCacheRetentionConfig 的生产语义
生产推理场景里,一条请求的不同 token 范围有截然不同的”留存价值”。系统提示(system prompt)在所有请求里都出现,复用价值极高;解码阶段生成的 token 通常只对当前请求有用,复用价值低;用户历史对话介于两者之间。TRT-LLM 把这个差异显式地暴露给应用层,通过 KvCacheRetentionConfig 控制[4]。
TokenRangeRetentionConfig 允许为特定 token 范围指定优先级(0-100)和持续时间(duration_ms)。例如:系统提示的 token 0-512 赋予优先级 100,持续时间不限;用户输入的 token 512-2048 赋予优先级 50,持续 30 秒;decode 生成的 token 赋予优先级 20,持续 10 秒。时间窗口过期后,优先级自动重置为默认值,block 重新进入普通竞争。
淘汰策略的核心规则是优先级分段的 LRU:同等优先级的 block 按 LRU 顺序淘汰;只有当某个优先级的所有 block 都被淘汰干净后,才会开始淘汰下一个优先级段的 block[3]。这意味着高优先级 block(比如系统提示对应的 block)实际上享有类似”保留席位”的待遇。
secondary_offload_min_priority(默认 35)是另一个重要参数:优先级低于 35 的 block 在被淘汰时,直接从 GPU 丢弃,不进入 host memory[3]。这个设计说明 host memory 并不是无差别的”回收站”,而是一个有入门资格的二级缓存:只有”值得保留”的 block 才被卸载到 host,避免 GPU→Host 的传输带宽被低价值 block 消耗。
根据 NVIDIA 技术博客,优先级淘汰可以让缓存命中率提升约 20%[4]。这个数字依赖工作负载特征,但它说明了一个直觉:在多租户或长 session 场景里,纯 LRU 的缺陷是”无差别对待所有 block”,而引入优先级后,系统能把有限的缓存空间优先留给高复用率的内容。
五、三层存储:GPU → Host → NVMe
在源码层面,TRT-LLM 把 KVCache 存储分成两层(primary GPU 和 secondary host),第三层通过 KvCacheTransferMode 枚举的三个值接入[5]:
DRAM:标准的 GPU↔Host 内存传输,通过cudaMemcpyAsync实现GDS(GPUDirect Storage):绕过 CPU DRAM,GPU 直接读写 NVMe 存储(需要 cuFile 库)POSIX_DEBUG_FALLBACK:GDS 不可用时的文件系统回退,用于调试和兼容环境
offload() 把 GPU block 写入 host 或 NVMe;onboard() 把 host 或 NVMe 的内容加载回 GPU[5]。两者的 mode 参数决定实际走哪条路径,directory 参数指定 GDS/POSIX 的文件路径。KvCacheRetentionConfig 里的 transfer_mode 和 directory 字段允许请求在自己的生命周期里指定首选卸载路径——这意味着不同请求的 KV 可以卸载到不同的存储目标,例如把高价值 block 卸载到 host DRAM,把低价值 block 卸载到 NVMe。
GPUDirect Storage 的设计动机很清楚:KV block 从 GPU 到 NVMe 的路径上,如果经过 CPU DRAM,就要做两次内存拷贝(GPU→CPU,CPU→NVMe)。GDS 让 GPU 通过 DMA 直接与存储交互,在 NVMe 带宽足够的情况下,延迟和带宽都有明显收益[6]。PR #3209 为 TRT-LLM 引入了 KvCacheTransferManager 里 cuFile 的集成,使 GDS 路径可以用于 KV block 的卸载与读回。
Grace-Hopper 架构(GH200)提供了一条不同的扩展路径:900 GB/s 的 NVLink-C2C 连接让 GPU 和 CPU LPDDR5 之间的带宽达到 PCIe Gen5 的 7 倍,480 GB CPU 内存和 96 GB GPU 内存共享统一地址空间[7]。在 GH200 上,host offloading 的延迟大幅低于 PCIe 系统,原本因为传输代价过高而不划算的卸载策略,在这个架构上变得合理。这也解释了为什么 v1.1 的 release notes 专门提到了 MLA + host offloading 的示例[8]——MLA 的 KV 体积更小,Grace-Hopper 的高带宽使得频繁 offload/onboard 在延迟上可接受。
六、KVCacheTransferManager:用两个流换 overlap
卸载和加载 KV block 如果和前向计算共用一个 CUDA stream,会形成串行瓶颈。KVCacheTransferManager 用三个独立的 BufferManager(mBufferManager、mOnboardManager、mOffloadManager)来拆开这个瓶颈[5]:
mBufferManager:和 prefill/decode kernel 共用的主 streammOnboardManager:专用于 host→GPU 的搬运 streammOffloadManager:专用于 GPU→host 的搬运 stream
同步的时机是精确的:syncWithBufferManager() 在每 step 的第一次 addSequenceBatch() 调用之前执行,确保搬运流等待 kernel 流——上一 step 的 kernel 结果必须先写完,才能开始被搬运;syncTransfers() 在最后一次 addSequenceBatch() 调用之后执行,确保 kernel 流等待搬运流——下一 step 的 kernel 需要的 block 必须已经 onboard 完成才能使用[5]。
这两个同步点之间的窗口里,onboard 和 offload 操作可以和当前 step 的 kernel 计算并行执行。mPendingReads 和 mPendingWrites 用 CUDA event 追踪每个 block 的搬运状态,防止同一 block 同时被读写的竞态。
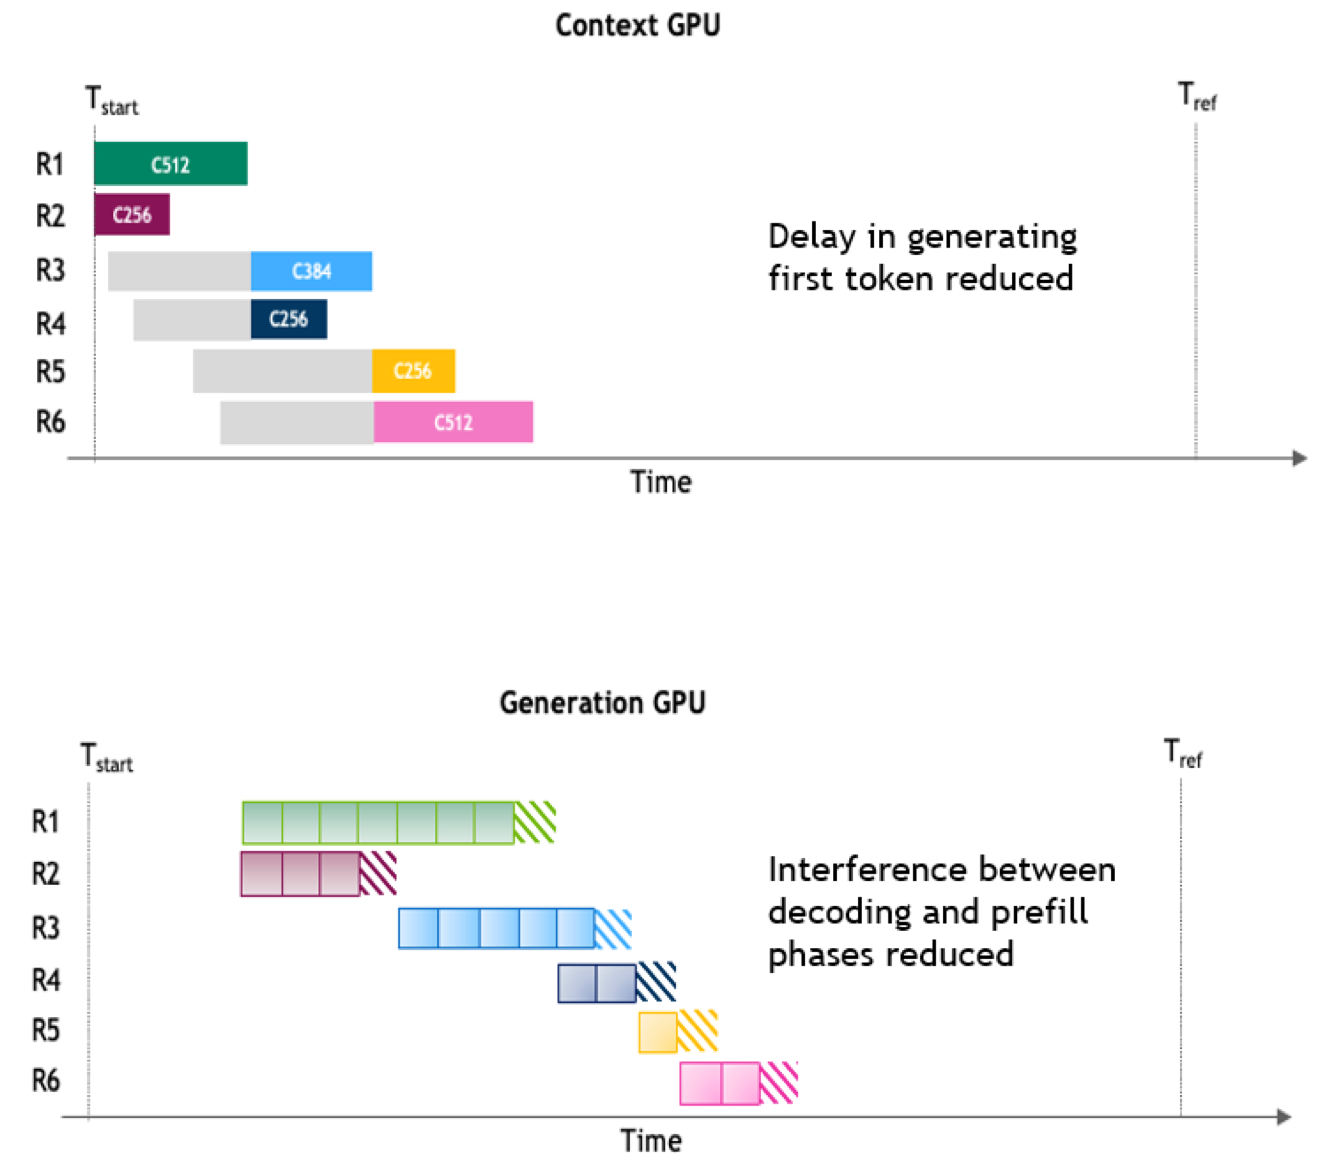
图 1:聚合 serving 里,prefill 和 decode 在同一进程里交替执行,长 prefill 阻塞 decode,短 decode 浪费 prefill 的算力。分离式 Serving 把两个阶段放到不同 GPU 池,KV cache 在 prefill 完成后通过网络传输给 decode worker。来源:TRT-LLM tech_blog5。
KvCacheIterationStats 提供每次迭代的传输统计,包括 primary/secondary pool 的实时块数、本轮 onboard/offload 的块数和字节数,以及 GPU 内 block copy(partial reuse copy)的统计[1]。这组统计在生产运维里很实用:iterOnboardBlocks 和 iterOffloadBlocks 的比例如果长期失衡,说明 host cache 的利用率不理想,可能需要调整 secondary_offload_min_priority 或增大 host_cache_size。
七、KVCacheEventManager:把本地缓存状态暴露给集群路由
单机 KVCache 的信息如果只留在进程内部,集群层面的路由器就无法感知哪台 worker 持有哪些 prefix block,只能做无差别的负载均衡。KVCacheEventManager 通过事件流把 block 状态实时暴露给外部[9]。
事件分四种类型,对应 block 状态机的四个关键节点:
CreatedData:KVCache 初始化时发出,告知外部每层缓存的初始 block 总数StoredData:block 被填满并入树时发出,包含parentHash(前驱 block 的哈希)和每个 block 的 tokens、LoRA ID、缓存层级、优先级;外部路由器据此建立前缀-worker 的映射表RemovedData:block 被淘汰时发出,包含 blockHash 列表;路由器据此更新映射表UpdatedData:block 优先级或状态变化时发出
外部服务通过 getEvents(timeout) 拉取事件队列,返回的是”最终一致”的视图,而非精确快照[4]。这个设计选择有工程逻辑:路由决策不需要精确到毫秒,稍有滞后的缓存状态对命中率的影响极小;但如果设计成强一致,事件发布和 block 操作就必须同步,会在关键路径上引入锁竞争。
Attention Data Parallelism 场景里,多个 DP rank 各自维护一部分缓存。KVCacheEventManager 会在 rank 0 上启动一个独立线程(exchangeAttentionDpThread),通过 MPI communicator 周期性地把各 rank 的事件汇聚到 rank 0,再由外部订阅者统一消费[9]。
TRT-LLM v0.20.0 在此基础上加入了 KV cache-aware router[8],后续版本里这个能力被 Dynamo 的 smart router 进一步完善。通过订阅 KVCacheEventManager 的事件流,路由器能把新请求优先发送给已经持有匹配前缀 block 的 worker,把前缀复用从单机本地优化提升到集群维度。
八、分离式 Serving:KvCacheConnector 与 NIXL 的联动
KVCache 在 worker 内部的生命周期管理和 worker 之间的 KV 传输,在 TRT-LLM 里是两套不同的抽象。内部管理由 KVCacheManager 负责;跨 worker 的传输由 KvCacheConnectorManager 负责[10]。
KvCacheConnectorManager 是一个虚拟接口类,只暴露一个关键方法:getNumNewMatchedTokens(request, numComputedTokens)[10]。这个方法在 decode worker 的 KVCacheManager::addSequence 调用路径里被触发:decode worker 接到一个来自 prefill worker 的请求时,先查询 connector 有多少 token 的 KV 可以从远端加载,再决定实际需要 prefill 的 token 范围。如果 decode worker 本地已经持有该请求的部分前缀(比如这个请求的 prefix 在上一轮已经被 prefill 过),就可以减少或完全跳过 prefill 传输。
传输后端当前支持三种:MPI、UCX 和 NIXL。NIXL(NVIDIA Inference Xfer Library)是推荐默认值,通过 TRTLLM_NIXL_KVCACHE_BACKEND 环境变量进一步指定底层协议——默认是 UCX(走 InfiniBand/NVLink),v0.16.0 后支持 LIBFABRIC 插件[11]。
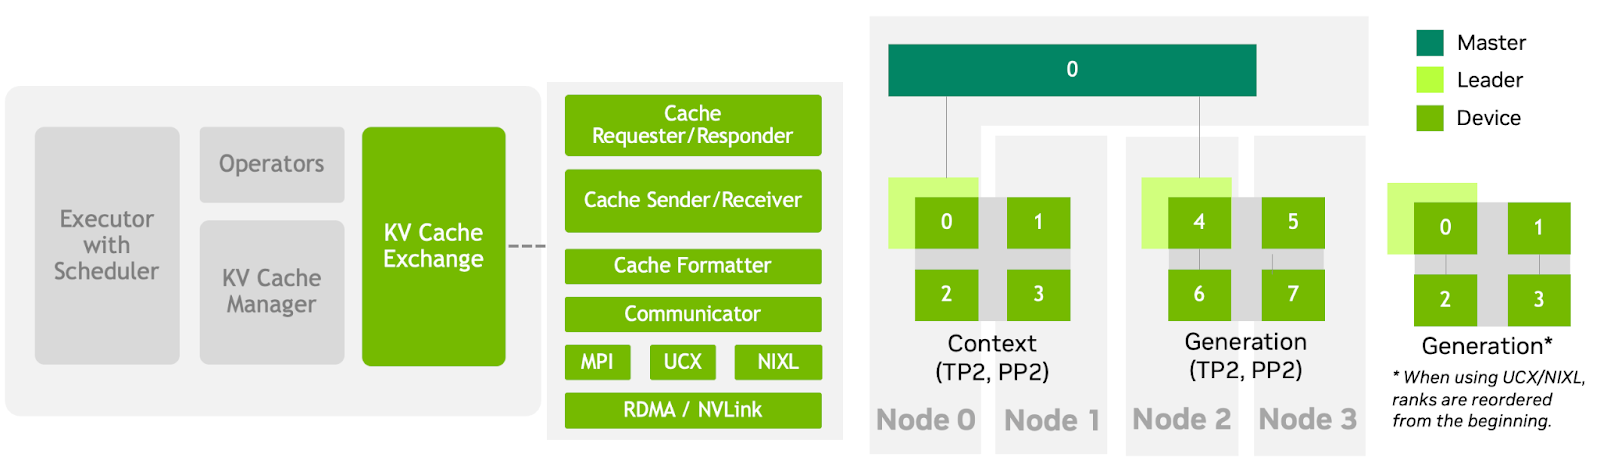
图 2:TRT-LLM 分离式 Serving 的 KV cache 传输后端架构。NIXL 把底层协议选择下放给环境变量,使同一套代码能适配不同的网络拓扑。来源:TRT-LLM tech_blog5。
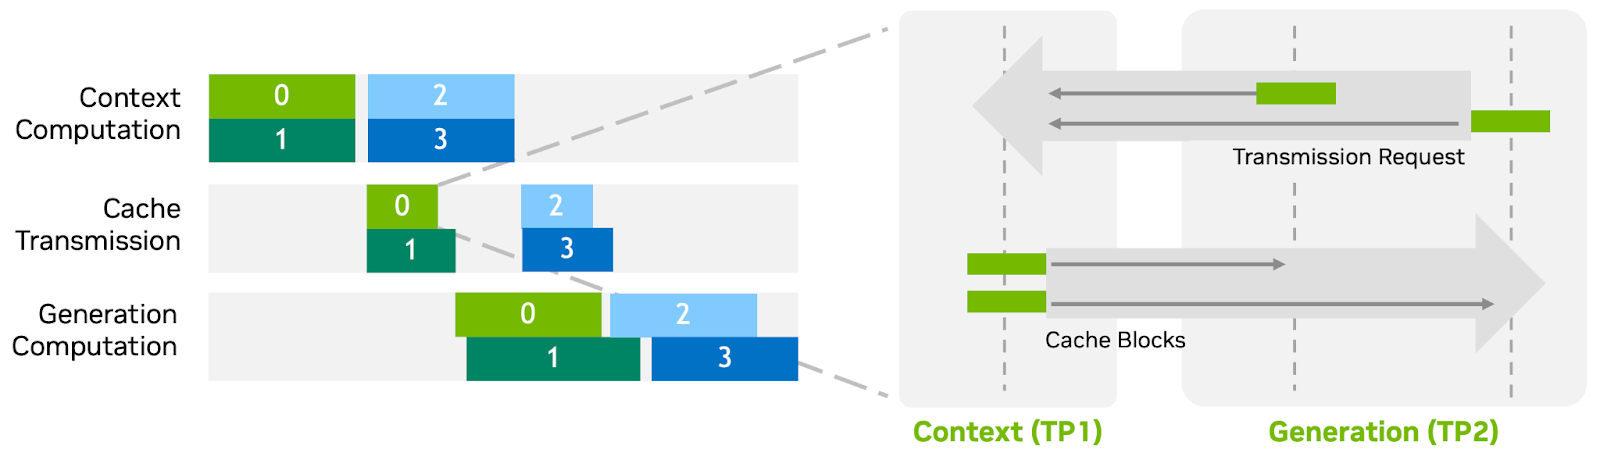
图 3:TRT-LLM 在分离式 Serving 里叠加 KV 传输与计算的时序。prefill 完成后,KV 传输和其他请求的 decode 计算在时间轴上重叠,降低了传输对整体吞吐的影响。来源:TRT-LLM tech_blog5。
其中有几个工程细节值得单独说:
零拷贝路径(TRTLLM_TRY_ZCOPY_FOR_KVCACHE_TRANSFER=1)启用后,prefill worker 可以直接把 block 地址暴露给 decode worker,跳过中间缓冲区[11]。代价是要求两侧的 memory 通过 RDMA 可见,配置复杂度更高,通常只在确定基础设施支持的环境里启用。
Layout 转换是另一个隐性成本:当 prefill 和 decode 使用不同的并行策略(比如 prefill 用 TP2,decode 用 PP2),KV block 的 tensor 布局需要做转换——不同切分策略下,每个 rank 持有的 KV 子集不同[11]。这个转换在传输层自动处理,是 NIXL 后端需要支持的原语之一,也是选择 prefill 和 decode 并行策略时必须一并考虑的约束。
性能数据:在 GB200 GPU 上用 DeepSeek R1 测试,ISL 4400/OSL 1200 的场景下分离式 Serving 带来 1.4-1.8x 吞吐提升(叠加 Multi-Token Prediction 时达到 1.6-2.5x);ISL 8192/OSL 256 的短生成场景下提升达到 2x[12]。Qwen 3 的场景下提升范围更大:1.7x-6.11x,高端数字来自 prefill 瓶颈更严重、KV 传输相对开销更小的配置。
这组数字背后的原因是固定的:聚合 serving 里,长 prefill 会阻塞 decode,使 decode GPU 空转;短 decode 又会让 prefill GPU 等待。分离后,两种请求的 GPU 算力可以独立调配,消除了这种交叉浪费。KV 传输的开销是代价,收益是阶段独立带来的吞吐。
九、Dynamo 在这套架构里扮演的角色
Dynamo 是 NVIDIA 针对数据中心规模的推理编排层,在 TRT-LLM 的 KVCache 架构里接入了三个点[13]:
智能路由:Dynamo 的 smart router 订阅多个 TRT-LLM 实例的 KVCacheEventManager 事件流,维护一张”哪个 worker 持有哪些 block”的全局表,把新请求路由到命中概率最高的实例。这是 KV Event API 的主要生产消费方。
Prefill bypass:decode worker 接到路由过来的请求后,先查本地缓存;如果命中足够多的前缀,直接 bypass prefill,进入 decode 阶段。Dynamo 的请求路由和 TRT-LLM 的 KvCacheConnectorManager::getNumNewMatchedTokens() 在这里形成一个闭环:路由器尽量把请求发到已有缓存的 worker,connector 再确认实际可以省略多少 prefill 计算。
Kubernetes 支持:Dynamo 提供 K8s operator,可以按负载动态扩缩 prefill 和 decode 的 GPU 池,两者独立伸缩。KV 传输的 NIXL 后端在这个场景里提供网络隔离和协议适配能力,支持跨节点的 InfiniBand 和 NVLink 传输路径。
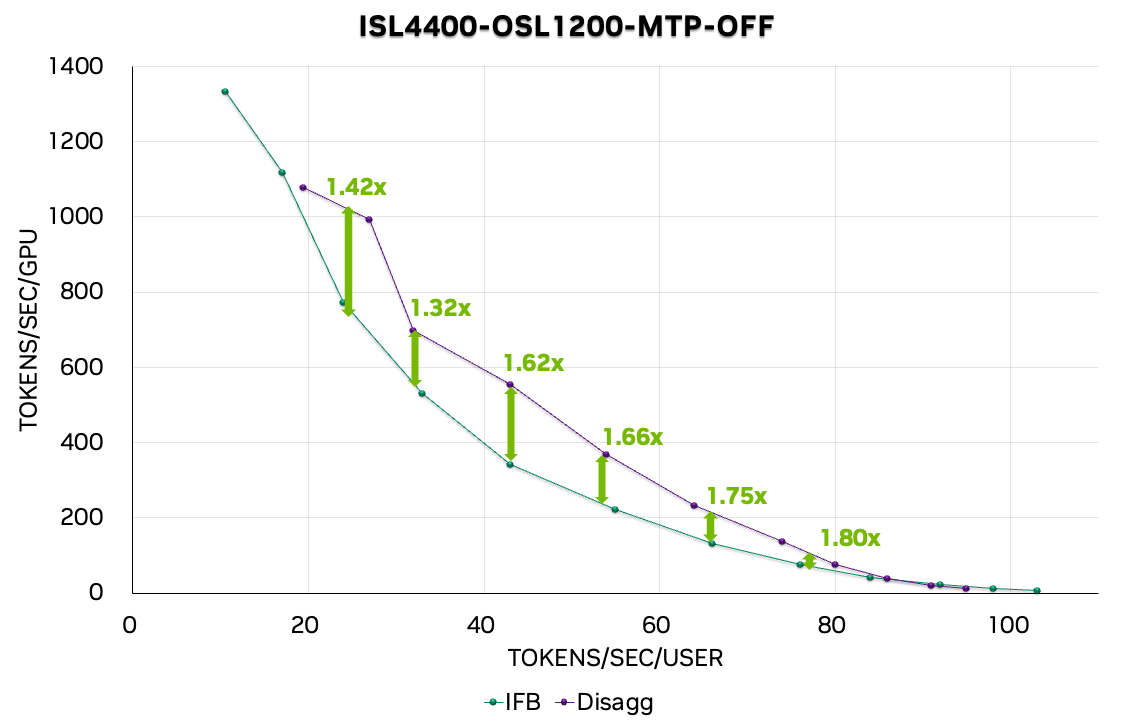
图 4:分离式 Serving 在 DeepSeek R1(ISL 4400/OSL 1200)上的性能数据,横轴为吞吐量(tokens/s),纵轴为 TTFT(ms)。分离式配置的 Pareto 前沿明显优于聚合 serving,在同等延迟约束下吞吐提升约 1.4-1.8x。来源:TRT-LLM tech_blog5。
结语:TRT-LLM 的 KVCache 是一个资源调度问题
从 v0.12 的 LoRA/P-Tuning 前缀复用,到 v0.20 的 KV-aware router,再到 v1.1 的 KvCacheConnectorManager 和 salting——TRT-LLM KVCache 的演进路径说明的是同一件事:这套系统在乎的是把缓存作为有限、异构、跨层的资源来管理,而不只是”如何共享前缀”。
block pool、优先级淘汰、三层存储、异步传输 overlap、事件驱动路由、分离式 Serving 的 KV 传输——这六个模块各自独立、接口清晰,但都服务于同一个目标:让有限的 GPU 显存、host DRAM 和 NVMe 空间都被用在最有业务价值的地方。KvCacheRetentionConfig 把这个”价值判断”直接暴露给应用层,而不是藏在推理引擎内部;KVCacheEventManager 把”当前谁持有什么”实时告知上游路由;NIXL 确保跨实例的 KV 传输不成为瓶颈。
目前仍有一些开放边界:MLA + 分离式 Serving 的完整组合在 v1.1 才开始启用,长上下文场景下的行为还在社区验证中;GDS 路径对 NVMe 硬件和驱动版本的依赖较强,在异构集群里需要额外的配置管理;KVCacheConnectorManager 目前只暴露了 getNumNewMatchedTokens 这一个接口,对于更复杂的 prefill 结果校验或 KV 所有权转让语义,还没有形成完整的 API 规范。
参考资料
[1] kvCacheManager.h — TensorRT-LLM 源码
[2] Fast and Expressive LLM Inference with RadixAttention and SGLang
[3] KV Cache System — TensorRT-LLM 官方文档
[4] Introducing New KV Cache Reuse Optimizations in NVIDIA TensorRT-LLM
[5] kvCacheTransferManager.h — TensorRT-LLM 源码
[6] feature: KV Cache GPUDirect Storage — Pull Request #3209
[7] Accelerate Large-Scale LLM Inference and KV Cache Offload with CPU-GPU Memory Sharing
[8] Release Notes — TensorRT-LLM
[9] kvCacheEventManager.cpp — TensorRT-LLM 源码
[10] kvCacheConnector.h — TensorRT-LLM 源码
[11] Disaggregated Serving — TensorRT-LLM 官方文档
[12] Disaggregated Serving in TensorRT-LLM
[13] KV Cache Transfer in Disaggregated Serving — NVIDIA Dynamo Documentation
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。