版本历史
版本 日期 说明 v1.0 2026-06-24 初稿,基于 UB-Mesh、CloudMatrix384、UnifiedBus 2.0 规范和 HC2025 keynote,澄清协议/拓扑混淆 v1.1 2026-06-24 修订更新:移动到 Essay 板块,补充 MWC 2026 Atlas 950 信息,修正 CloudMatrix-Infer 性能数字边界,加入信息图题图 v1.2 2026-06-24 新增第六节:拆解 UB 的设备池化真实进度(CPU/内存/存储/DPU 已落地、PCIe 定位、NVLink C2C 同款的 fabric 级与封装级之分) v1.3 2026-06-24 事实核查修订:收敛 TaiShan/Atlas 公开产品描述,弱化 SSD/DPU 接入路径、PCIe 替代和 NVLink-C2C 类比的推断语气 v1.4 2026-06-26 事实核查修订:修正 6912 光模块归属(UB scale-up 5,376 + RDMA scale-out 1,536);补充 NPU→L1 板内铜互连、L1 输出侧光口说明;删除论文原文中未能核实的 5655 prefill 数字,6688 为论文报告主指标 v1.5 2026-06-27 事实核查修订:按 UnifiedBus 基础规范和 SuperPoD 白皮书重写同步/异步内存语义延迟口径,避免把编程模型差异误写成单纯快慢对比
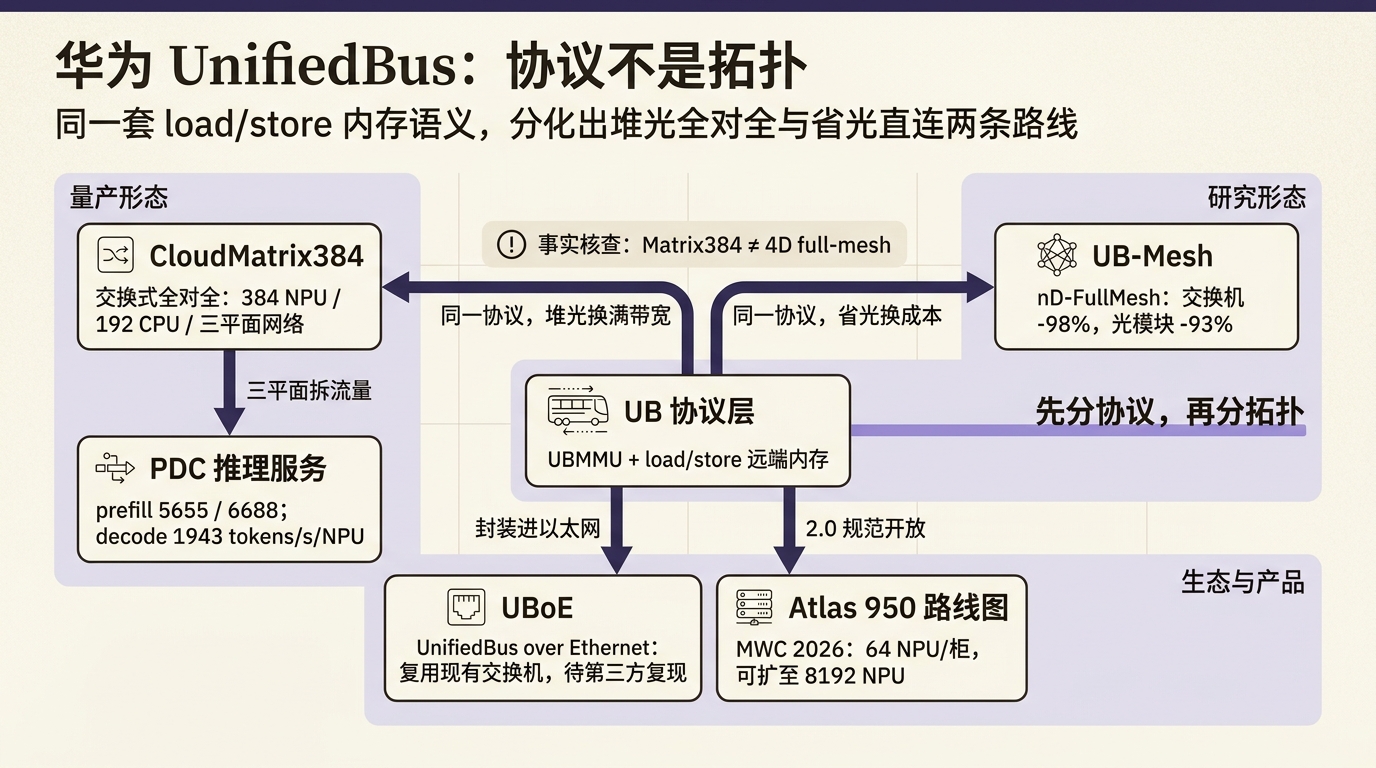
题图:UnifiedBus 的核心混淆在协议层和拓扑层之间。CloudMatrix384 与 UB-Mesh 共享 UB 内存语义,但一个用交换式全对全堆光换带宽,一个用 nD-FullMesh 省光换成本。
“UB-Mesh 和现在量产的 Matrix384 是一套方案吗?”——这是读华为 UnifiedBus(灵衢,简称 UB)材料时最容易踩的一个坑。把这两个名字当成同一件事,整篇综述的主轴就会写歪。
两者分属相反的拓扑路线:量产的 CloudMatrix384 靠 UB 交换机做全对全互联,单个超节点塞进 6912 个光模块[9];UB-Mesh 走 nD-FullMesh 直连,目标是把交换机用量砍掉 98%、光模块砍掉 93%[1]。一个堆光换满带宽,一个省光换成本。两者共享的底座,是那层叫”灵衢”的内存语义总线协议。读懂 UB 的前提,是先把 UnifiedBus 当协议层看,再把 CloudMatrix384 和 UB-Mesh 当两种拓扑实现看。 这篇综述按协议层、拓扑层、开放与路线图三层来拆,顺序不能乱。
一、灵衢首先是一套内存语义总线协议
本节论点:灵衢的核心落在 load/store 内存语义外扩:把单机内部总线语义推到超节点尺度。 本节核心参考:
(v1.1 更新) 灵衢的研究从 2019 年开始,基于 1.0 版本的 Atlas 900 A3 超节点自 2025 年 3 月开始交付,到华为全联接大会 2025(9 月)已商用部署 300 多套;2.0 在 1.0 基础上扩功能、提规模,并把技术规范开放出来[4]。华为给灵衢超节点总结了六个特征:总线级互联、协议归一、平等协同、全量池化、大规模组网、高可用[4]。前三个词定义协议语义,后三个词描述系统效果。
“总线级互联”和”平等协同”翻译成工程语言,就是把内存总线的 load/store 语义从单机内部捅到了机柜乃至跨机柜尺度。传统 PCIe / RDMA 系统也能做远端读写和 DMA,但应用通常面对的是显式提交、排队和完成通知的 I/O 或通信模型;UB 基础规范把功能层直接拆成两类编程模型:Load/Store 同步访问和 URMA(Unified Remote Memory Access)异步访问[3]。前者由处理器指令经片上总线进入 UB Controller,再转换成 read、write、atomic 等 UB 事务;后者通过 Jetty、SQ、CQ 等队列机制提交事务并异步等待完成[3]。ServeTheHome 对 Hot Chips 资料的转述进一步把这层机制落到 UBMMU:远端内存可映射进本地地址空间,处理器对远端地址发起 load/store 后,由 UB 侧完成地址转换、权限校验和事务传输[5]。
(v1.5 更新) 这套语义的差异不能只读成”同步更快、异步更慢”。SuperPoD 白皮书给出的原始口径是:总线级互联提供百 ns 级同步内存语义访问时延、2~5 us 异步内存语义访问时延,并支持组件间 TB/s 级带宽[3];同一份白皮书在机制章节里进一步说明,UB 支持计算单元直接发起同步和异步访存指令,减少控制命令交互,并把内存语义单事务覆盖到 64B 至 4KB 以及变长操作[3]。这里的百 ns 和 2~5 us 对应两种编程模型和完成语义:Load/Store 是指令级同步访存路径,URMA 是队列化提交、完成通知和可 overlap 的异步路径。这组数字应解读为 UB 同时提供细粒度按需访存路径和队列化异步搬移路径,两者服务的流量形态不同,不能被当成同一应用调用模式下的苹果对苹果 benchmark。 徐直军 keynote 给的跨机柜 NPU 间通信时延是 2.1 微秒,Ascend 950 系列单卡 UB 带宽 2 TB/s、Ascend 970 到 4 TB/s[4]。平等协同和全量池化成立的前提,正是软件能把远端资源纳入统一地址、权限和事务语义,而不是每次都把远端访问退化成一轮显式通信协议。
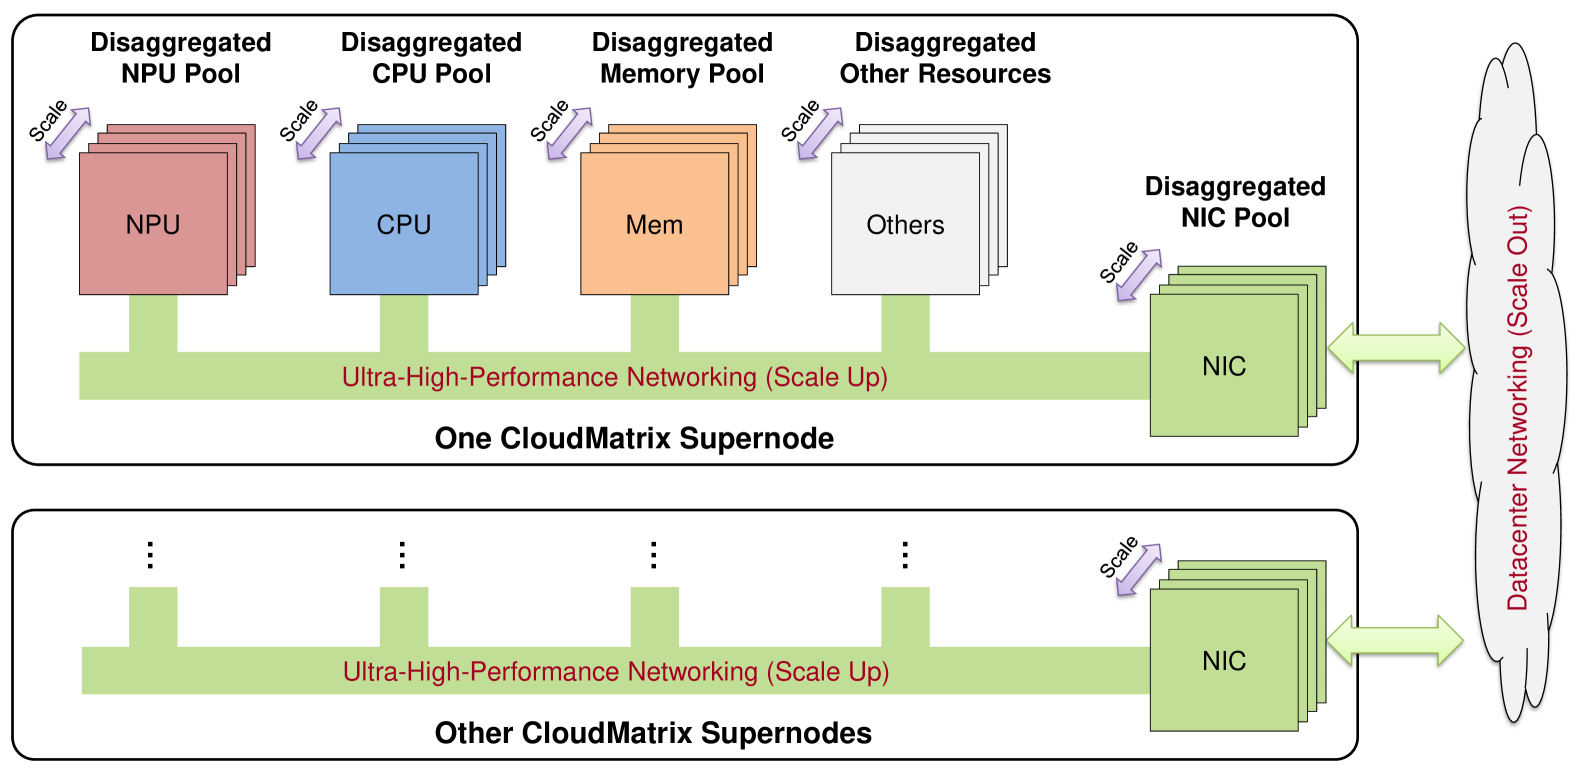
图 1:灵衢的”全量池化”在架构上长这样——NPU、CPU、内存、NIC 各自成池,靠 Scale-Up 网络做对等互联,摆脱单台服务器里的固定绑定。能这么拆的前提,是 UB 提供了跨设备的 load/store 内存语义。来源:CloudMatrix384 serving 论文[2]。
二、量产形态:CloudMatrix384 用”堆光”换满带宽
本节论点:CloudMatrix384 是目前最清楚的量产判例,它的重点是交换式全对全和三平面拆流量,和 UB-Mesh 的省光直连路线分属两种取舍。 本节核心参考:
把协议层放一边,看实际落地的超节点,CloudMatrix384(对应 Atlas 900 A3)是目前唯一公开的规模化生产判例。它由 48 台服务器组成,集成 384 颗 Ascend 910C NPU 和 192 颗鲲鹏 CPU,全部经 UB 网络互联,做直接的全对全通信和资源动态池化[2]。
它的拓扑是交换式全对全:板载 L1 层每节点 7 颗 UB 交换芯片(对应 7 个子平面,每颗服务节点内全部 8 颗 NPU),机架级 L2 层每子平面 16 颗交换芯片,7 层子平面各自构成独立 full-mesh,保证任意两个 NPU 之间零争用、非阻塞。(v1.4 修订) 连接路径分两段:NPU 与同板 L1 交换芯片之间是板内铜互连,每颗 NPU 有 7 个 UB 端口分别接入 7 颗 L1 芯片,单方向 28 GB/s,单卡 UB 总带宽 196 GB/s;L1 芯片输出侧通过光链路跨机架连接 L2 交换机,这是 6912 个光模块的主体分布位置。6912 并非 UB 平面专属:精确拆分为 UB scale-up 平面 5,376 个(计算服务器侧 2,688 + UB 交换机侧 2,688)和 RDMA scale-out 平面 1,536 个,合计 6,912[9]。这套堆料堆出来的结果是 300 PFLOPS BF16 稠密算力,接近 GB200 NVL72 的两倍,总显存容量约 3.6 倍、总内存带宽约 2.1 倍[9]。它用光模块和交换芯片的绝对数量,换来了不依赖最先进制程也能堆出的系统级带宽——这是先进工艺受限背景下的一种工程解法。
CloudMatrix384 怎么用这张网,更能解释 UB 的工程位置。它没把所有流量塞进一条通道,而是按语义拆成三个物理平面:UB 平面承载内存语义的 P2P 池化访问,跨节点延迟增加小于 1 微秒、带宽衰减小于 3%;RDMA 平面(RoCE,400 Gbps/NPU)专门走 prefill→decode 的同步 KV 大块交接;VPC 平面隔离控制流[2]。
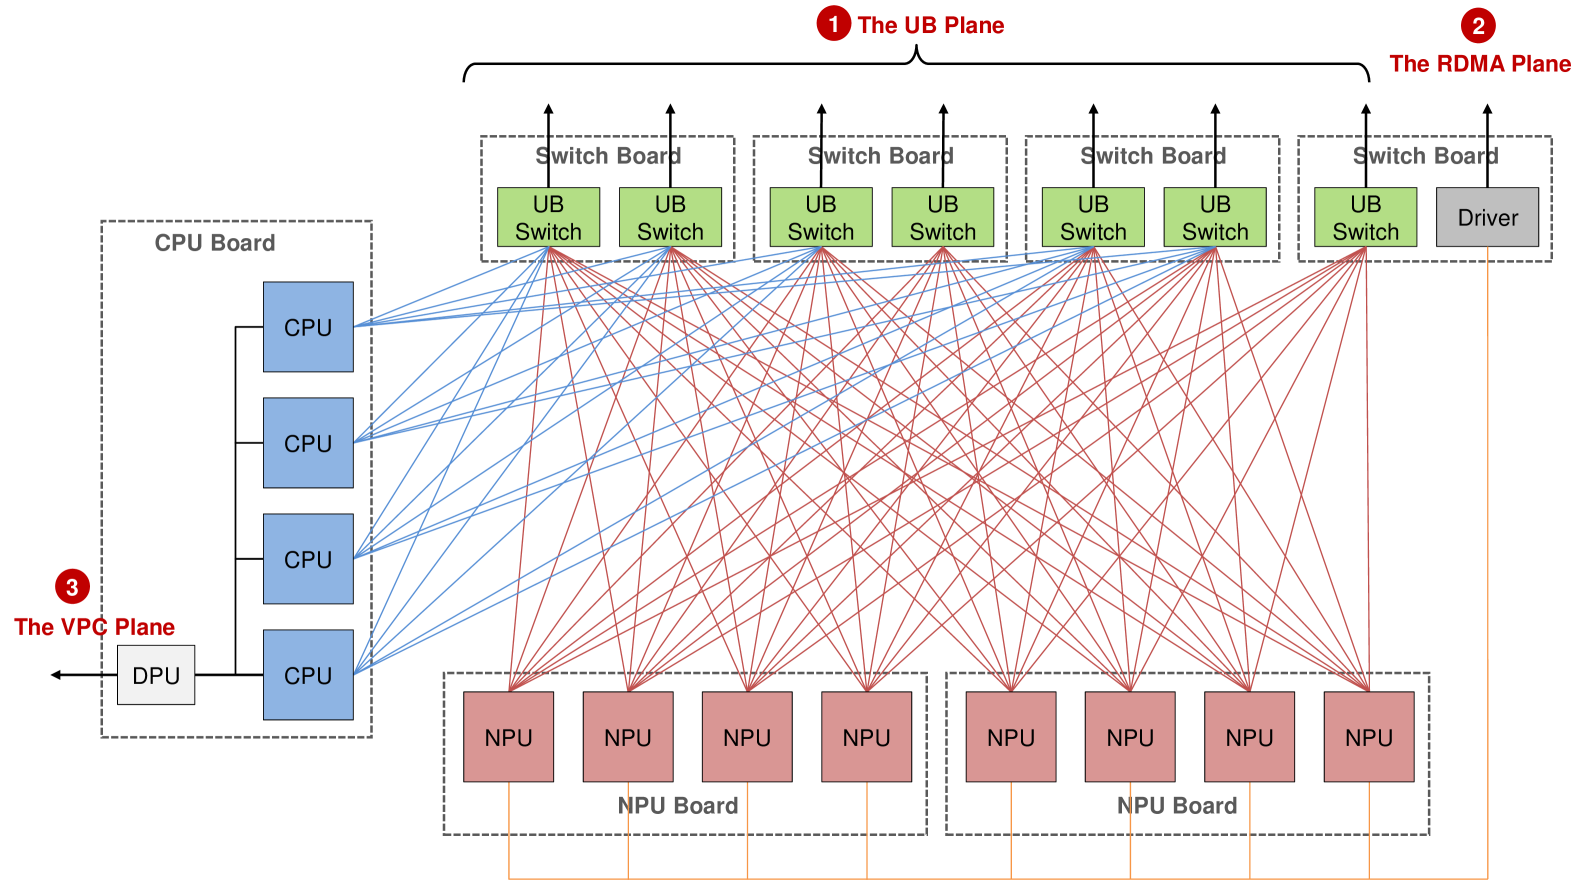
图 2:注意图上那一片密密麻麻的连线——CPU 板、NPU 板全部汇聚到 UB Switch 板,这是典型的交换式全对全,靠交换机做满二分带宽。这正是 CloudMatrix384 和下一节 UB-Mesh 的根本分歧所在。来源:CloudMatrix384 serving 论文[2]。
(v1.5 更新) 这套三平面设计的工程含义是”按流量语义拆平面”,避免把南向和北向写成二选一。decode 步内细粒度、按需、难预知的内存池访问交给 UB 平面,大块、可调度、可被后台线程发起并 overlap 的 prefill→decode KV 交接交给 RDMA 平面;这里的”后台异步”是服务调度层的 overlap 方式,不等同于上一节 UB 规范里的 URMA 异步访问延迟指标。两类流量混用同一条 RDMA 通道会让控制面开销在细粒度场景下急剧放大。落到推理指标上,CloudMatrix-Infer prefill 吞吐为 6688 tokens/s/NPU(4K prompt,EP32 配置);decode 侧 1943 tokens/s/NPU(49.4ms TPOT),收紧到 15ms TPOT 约束时降到 538 tokens/s/NPU[2]。(v1.4 修正) v1.1 将 5655 标为”默认配置”、将 6688 标为 Perfect EPLB 条件——核查论文 HTML 原文后,论文报告的 prefill 主指标为 6688,未见 5655 这一数字,已删除该区分;6688 直接作为论文给出的 prefill 主指标。UB 的内存语义已进入 prefill/decode/caching 服务架构设计,超出了单纯规格表延迟讨论,这一判断不受影响。
三、研究形态:UB-Mesh 用 nD-FullMesh”砍光”换成本
本节论点:UB-Mesh 是把训练流量局部性写进拓扑的研究路线,和 CloudMatrix384 的交换式全对全构成一组成本/带宽对照实验。 本节核心参考:
UB-Mesh 走的是相反方向。这篇论文(arXiv:2503.20377,Heng Liao 等 33 人,2025 年 3 月)的标题就点了题——”a Hierarchically Localized nD-FullMesh Datacenter Network Architecture”[1]。它的出发点是 LLM 训练的流量有强局部性,没必要给所有节点对都铺满对称带宽,于是用一种递归的 nD 全连接拓扑:板级 1D 全连接、机架内 2D、跨机架 3D 及以上,尽量用便宜的电缆做短程直连,只在必要的高维度才上交换机和光模块。
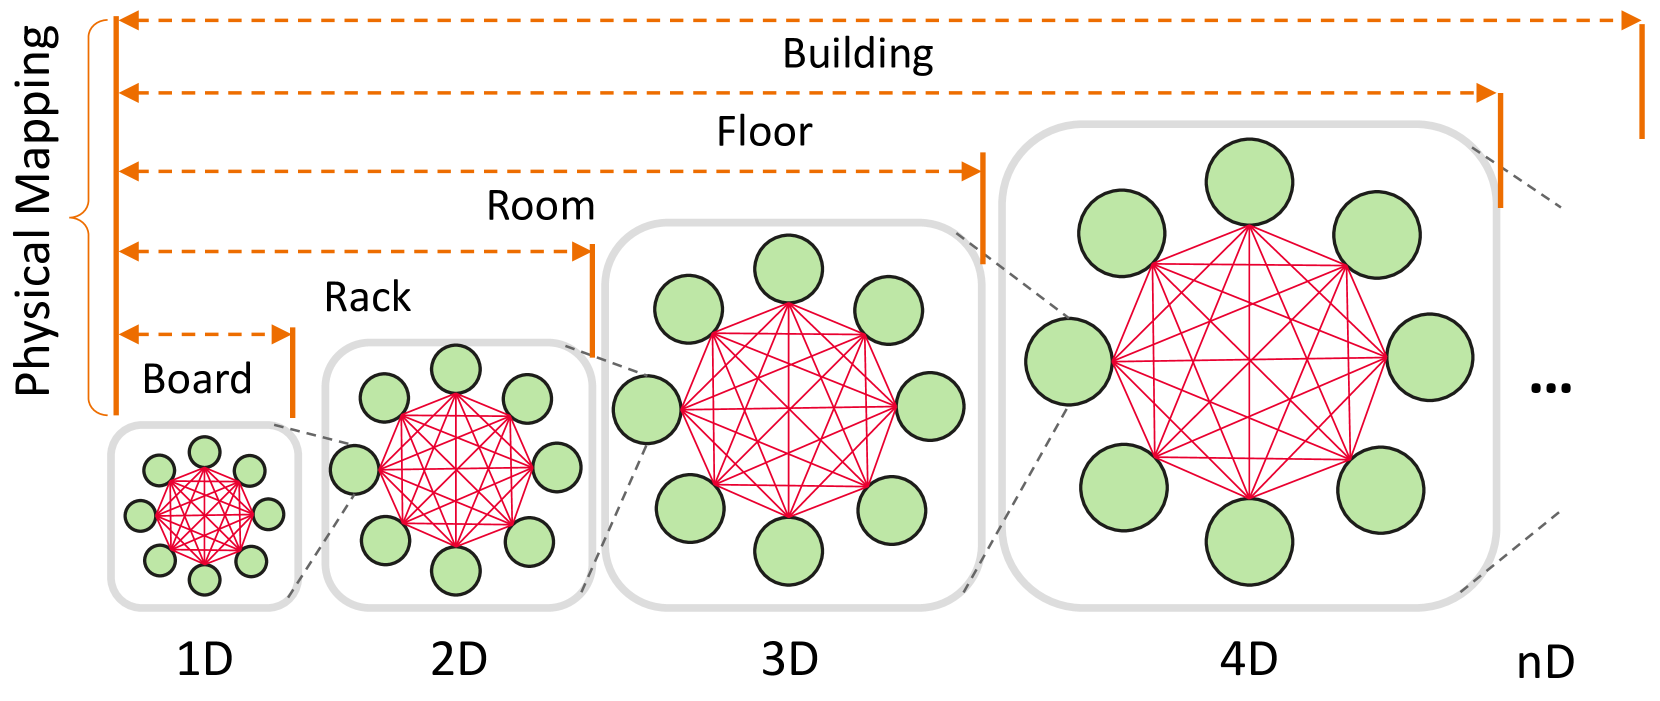
图 3:和图 2 的”全部汇聚到交换机”对照着看——UB-Mesh 在每个维度内部做全连接直连,只把跨维度流量交给交换层,交换机和光模块因此被大幅省掉。同样跑 UB 协议,拓扑哲学完全相反。来源:UB-Mesh 论文[1]。
具体实现 UB-Mesh-Pod 是 4D-FullMesh,可无缝扩到 8192 张 NPU 组成一个高带宽域,配合 All-Path-Routing 做流量管理,并用 64+1 的备份设计扛故障[1]。论文给的对比数字很硬:相比 Clos 架构,交换机用量降 98%、光模块降 93%,整体成本效率提升 2.04 倍、可用性高 7.2%,而在各类 LLM 训练任务上保持 95% 以上的线性度[1]。省掉这些光模块和交换机没有牺牲性能,背后赌的是 LLM 训练流量的局部性——一旦工作负载的通信模式偏离这个假设,nD-FullMesh 的省钱逻辑就要重新算账。 这是读这篇论文时该替生产环境追问的边界。
这里要点破一个连知识库自己都混过的坑。另一篇超节点论文 HyperParallel(arXiv:2603.03731)在描述硬件时,把”Matrix384”直接写成了 4D full-mesh 拓扑、200ns 单跳、下一代扩到 8192 卡[10]——这套描述更接近 UB-Mesh 的特征,却被安到了量产 CloudMatrix384 的名下。但 CloudMatrix-Infer 论文白纸黑字写的是交换式全对全、三平面、6912 光模块[2]。同样叫”384”,一个是已量产的交换式堆光形态,一个是省光的研究拓扑,把后者的拓扑特征贴到前者身上,是这批材料里最高频的事实错误。 综述要做的是把这层混淆讲清楚,不能反过来被它带跑。
四、UBoE:把总线语义塞进以太网
本节论点:UBoE 是 UB 从专用超节点走向既有以太网基础设施的折中路线,但性能优势仍主要来自厂商口径。 本节核心参考:
协议和拓扑之外,UB 还有一条向现网妥协的路径:UBoE(UnifiedBus over Ethernet)。它让灵衢协议跑在以太网之上,这样客户能继续用已有的以太网交换机,不必为超节点单独换一套专网。Atlas 950 SuperCluster 同时支持 UBoE 和 RoCE 两种协议;按华为的口径,UBoE 集群相比 RoCE 静态时延更低、可靠性更高,且需要更少的交换机和光模块[6]。
这条路径把”灵衢是否只能配华为专有交换硬件”这个生态门槛降下来。把内存语义事务封装进以太网帧,是开放 Scale-Up 阵营的共同动作——OCP 的 SUE 和 UALink 也在做类似的事,区别在各自从物理层、链路层还是事务层切入。UBoE 的存在说明华为没想让灵衢只活在自家专网里,但”复用现有以太网交换机”和”百纳秒同步内存语义”之间存在张力,UBoE 实测能逼近多少专网性能,目前只有厂商自己的对比口径,缺第三方复现。 这是该标”待验证”的地方。
五、开放与路线图:从 1.0 到 2.0 的生态意图
本节论点:UB 的开放意图已经落到规范仓库和 Atlas 950 产品路线,但开放规范能否变成开放生态,还要看华为之外的部件和系统供应商是否跟进。 本节核心参考:
灵衢 2.0 最实在的动作是开放技术规范。华为在全联接大会 2025 上由徐直军宣布开放灵衢 2.0 规范,包括《灵衢基础规范 2.0》《灵衢固件规范 2.0》《灵衢使能操作系统参考设计 2.0》等[4]。这套规范以 BSD-2-Clause 开源在 GitHub 上,涵盖基础规范、固件规范、OS 软件参考设计、管理运维软件架构、SuperPoD 架构白皮书,以及内存池化、设备虚拟化、超节点可靠性、编程编译等关键技术子文档[3];软件栈的高阶服务参考设计另有 openEuler 社区发布的白皮书承接[7]。
往前看,华为给的路线图把规模拉得很满:Atlas 950 SuperPoD 8192 卡、8 EFLOPS(FP8),Atlas 960 SuperPoD 15488 卡、30 EFLOPS(FP8);集群侧 Atlas 950 SuperCluster 超 52 万卡、524 EFLOPS(FP8),Atlas 960 SuperCluster 破百万卡、2 ZFLOPS(FP8),分别排到 2026 和 2027 的 Q4[4]。(v1.1 新增) 到 2026 年 3 月 MWC Barcelona,Atlas 950 SuperPoD 已进入全球发布口径:单柜集成 64 个 NPU,可扩展到 8192 个 NPU,并继续以 UnifiedBus 作为互连底座[8]。这条新信息没有改变文章主判断,只是把 Atlas 950 从 HC2025 的路线图推进到 2026 年的产品发布阶段。
把 UB 放回 Scale-Up 的全局坐标系,它和 NVLink、UALink 构成三种姿态。NVLink 以专有协议加配套交换芯片为基础,工程成熟度最高,但只半开放接入;UALink 走开放的以太网衍生路线、定义了 memory-semantic 事务和 1024 加速器 pod,但仍处在规范推进和生态构建阶段,尚未出现量产级的数十到数百卡超节点;UB 从 2.0 起转向开放标准,把总线语义扩展到机柜乃至多机柜尺度、强调 CPU 与加速器对等互联和资源池化[4]。在”开放阵营里谁先拿出量产超节点”这个问题上,UB 手里握着已交付 300 多套的 Atlas 900 A3,这是 UALink 目前还给不出的筹码。 但开放规范和开放生态是两回事——规范挂上 GitHub 只是第一步,有没有华为之外的厂商真正基于灵衢做出部件和系统,才是这条路线能否成立的检验。
六、全量池化到底池化了什么:公开产品能确认到哪一层
本节论点:CPU/NPU 同挂 UB、内存池化和 Atlas 350 四卡池化已经有公开产品或论文支撑;SSD/DPU pooling 已进入 TaiShan 950 官方规格,但公开资料没有说明它们是否以 UB 原生端口接入;NVLink-C2C 只能作为封装级相干互连参照,不能和 UB fabric 级内存语义直接等同。 本节核心参考:
- ★★★ CloudMatrix384 论文[2] — CPU 与 NPU 同挂 UB、CPU DRAM 以 EMS 内存池被全体 NPU 访问
- ★★★ 徐直军 HC2025 keynote[4] — TaiShan 950 的 16 节点/32 处理器/48 TB、memory/SSD/DPU pooling、GaussDB 2.9 倍和 Q1 2026 可用时间表
- ★★★ Huawei SuperPoD innovation 公告[6] — Atlas 350 cache-line 级访问、四卡 compute/memory pooling;TaiShan 950 内存池化
- ★★ Huawei MWC 2026 发布稿[8] — TaiShan 950 全球发布口径、memory semantics load/store 表述
- ★ NVIDIA NVLink-C2C[11] — 封装级 die-to-die 相干互连的参照系
(v1.3 更新) “全量池化”是 keynote 里最容易被当口号略过的词,但它恰恰是事实核查时最需要拆开的地方。公开材料能确认三层信息:CloudMatrix384 论文已经给出 CPU、NPU、内存池在 UB 上协同的量产判例;华为新闻稿把 TaiShan 950 写进通用计算 SuperPoD 产品组合,并明确提到 memory/SSD/DPU pooling;但 SSD、DPU 到底是 UB 原生端口、桥接设备,还是由系统软件统一调度的资源池,公开稿没有展开。把这三层写成一句”所有设备都已经进 UB”,会误导读者。
先说 CPU。CloudMatrix384 论文写得最清楚:这个 supernode 集成 384 颗 Ascend 910 NPU、192 颗鲲鹏 CPU 和其他硬件组件,经 UB 网络互联,支持直接 all-to-all 通信和资源动态池化[2]。论文里的分布式内存池(EMS)把 CPU DRAM 作为缓存池提供给 prefill/decode 侧 NPU 访问,强调的是统一带宽、统一延迟和 P2P 访问语义[2]。因此可以稳妥地说:在 CloudMatrix384 这个公开量产判例里,CPU/NPU/内存池已经被放进同一个 UB supernode 语义里;但不必进一步推断每一种板级链路都已经完全脱离 PCIe。
内存池化也不只停在 AI 线。徐直军 keynote 介绍 TaiShan 950 SuperPoD 时给出的口径是:基于 Kunpeng 950,最多 16 个节点、32 颗处理器、48 TB 内存,并具备 memory、SSD、DPU pooling;配合 GaussDB 多写架构时,不改应用可带来 2.9 倍性能提升[4]。MWC 2026 发布稿进一步把 TaiShan 950 放进全球发布的产品组合,强调 memory semantics communication 通过 load/store 操作做跨节点数据传输[8]。这能支持的结论是:通用计算线已经公开承诺把内存池化做成产品能力,且它和 UB 的 load/store 语义绑定;还不能支持的结论是:所有存储和 DPU 设备都已经以同一种 UB 原生链路形态接入。
存储和 DPU 是最容易写过头的一块。官方 keynote 确实把 SSD pooling 和 DPU pooling 列进 TaiShan 950 SuperPoD 参数[4],这说明华为希望把通用计算里的存储和数据处理资源也纳入 SuperPoD 资源池。但公开页面没有给出 SSD/DPU 的端口形态、协议栈分层、缓存一致性范围或是否经桥接接入。所以更稳妥的写法是:SSD/DPU pooling 已进入 TaiShan 950 的公开产品规格,但其底层接入方式仍待官方白皮书或第三方拆解确认;不要把它直接等同于”SSD 和 DPU 都已经像 NPU/CPU 一样原生挂在 UB 上”。
那 PCIe 退场了吗?公开资料不支持这么写。UB 2.0 规范开放和新闻稿里的”协议归一”可以说明华为想把不同计算、内存和 I/O 资源放进统一 SuperPoD 语义,但产品形态会长期和 PCIe、以太网、RoCE 等既有通道并存。把 UB 写成”马上替代 PCIe”风险很高;更准确的判断是:UB 在超节点内部承担新增的内存语义 scale-up 通道,PCIe 仍可能作为板内、存量设备或管理路径存在。
最后回到 NVLink-C2C 这个参照。NVIDIA 对 NVLink-C2C 的定义是处理器与加速器之间的高带宽相干数据传输,并支持 atomics;当前公开页还强调它依赖先进封装,能效和面积效率对比对象是 PCIe Gen 6 PHY[11]。Grace Hopper / Grace CPU Superchip 的 900 GB/s 数字可以作为既有产品带宽参照,但它对应的是封装/模块内 C2C 链路,不是机柜级 fabric。因此这里不能写”UB 已经是 C2C 的功能等价物”。更准确的说法是:UB 和 NVLink-C2C 都在追求内存语义访问,但 UB 公开材料落在 supernode/fabric 尺度,NVLink-C2C 落在封装级相干尺度,二者解决的是相邻但不同层级的问题。 Atlas 350 的公开稿提到更细粒度的 cache-line memory access,以及最多四卡通过 UnifiedBus 端口池化 compute 和 memory 资源[6],这可以看作华为在更小粒度资源池化上的产品信号;但华为目前没有公开一个对标 Grace Hopper/NVLink-C2C 的封装级 CPU-NPU 相干产品。这个空白要标”待验证”,不能用 fabric 级 UB 量产来替代回答。
七、结论:读懂 UB,先分三层
本节论点:UB 的可信部分是协议层和 CloudMatrix384 量产形态;省光拓扑、UBoE 优势和开放生态仍需要第三方复现与供应商跟进。 本节核心参考:
回到开头那个问题。UB-Mesh 和量产的 CloudMatrix384 分属两条方案线,但这个答案本身不是重点,重点是它暴露的阅读方法:华为 UnifiedBus 要分三层读——协议层(load/store 内存语义、UBMMU、全量池化)是不变的”灵衢”内核;拓扑层是 CM384 全对全堆光和 UB-Mesh 省光直连两种相反的成本/带宽取舍;开放与产品层是 1.0 到 2.0 的演进和生态意图。把协议当拓扑、把研究拓扑当量产形态,是这批材料里最容易犯的两个错。
这套判断成立有它的边界。CloudMatrix384 的三平面延迟带宽数据、UB-Mesh 的成本效率数字、UBoE 对 RoCE 的优势,目前主要来自华为自己的论文和 keynote,第三方独立复现还很少;灵衢 2.0 规范虽已开源,但生态侧能不能长出华为之外的部件供应商,要再观察至少一到两个产品周期。换句话说,UB 的协议层和量产形态已经有扎实的一手材料支撑,而它的开放生态和省光路线,还停留在”厂商宣称、待外部验证”的阶段。读这批材料时,这两类信息要分开记。
参考资料
[1] UB-Mesh: a Hierarchically Localized nD-FullMesh Datacenter Network Architecture
[2] Serving Large Language Models on Huawei CloudMatrix384
[3] UnifiedBus 灵衢 2.0 技术规范(GitHub,BSD-2-Clause)
[5] Huawei Presents UB-Mesh Interconnect for Large AI SuperNodes at Hot Chips 2025
[6] Huawei Launches Open-Access SuperPoD Architecture for All-Scenario Computing
[7] 灵衢系统高阶服务软件架构参考设计 2.0(openEuler 白皮书)
[8] Huawei Unveiled the Latest SuperPoD, Making an AI Infrastructure New Option to the World(MWC 2026)
[9] Huawei AI CloudMatrix 384 – China’s Answer to Nvidia GB200 NVL72(SemiAnalysis)
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。