传统 KV cache 有一个隐含前提:每个 token 对应唯一一组 KV 向量。把 RadixTree 里的前缀节点与 KV buffer 对应起来,是 SGLang RadixAttention 以及几乎所有 prefix caching 方案的共同起点。DeepSeek V4 打破了这个前提。
V4 的每一层注意力都是混合架构:SWA(滑动窗口全精度)+ C4(4:1 top-k 稀疏压缩)或 C128(128:1 全量密集压缩),外加 indexer 和 compress state pool,同一个 token 在不同注意力路径下会对应五种完全不同的物理 KV 形态。传统 RadixTree 只能用一个指针索引一种 KV,遇到 V4 的多态结构立即失效——不是性能下降,而是根本没有寻址能力。
阿里云 Tair KVCache 团队与 SGLang 社区合作,从 2026 年 4 月 DeepSeek V4 发布起即联合设计了三层应答:Shadow Radix 解决寻址问题,HiCache 解决 Prefill 容量问题,HiSparse 解决 Decode 显存问题[1]。这篇文章拆解这三层设计,以及它们背后的工程判断。
一、为什么 V4 会让传统 KV cache 失效
理解 Shadow Radix 的必要性,首先要理解 V4 结构为什么如此”麻烦”。
每层注意力被分解成两条并行路径。第一条是 SWA,始终激活,保留最近 128 个 token 的全精度原始 KV,用来捕捉局部上下文。第二条根据层类型选择 C4 或 C128 之一:C4 以 4:1 top-k 稀疏压缩保留”最重要的”压缩 KV 单元;C128 则以 128:1 全量密集压缩维持一个极度压缩但覆盖完整历史的表示。两条路径共用同一批 token,但产生的物理数据格式、大小、访问模式完全不同。
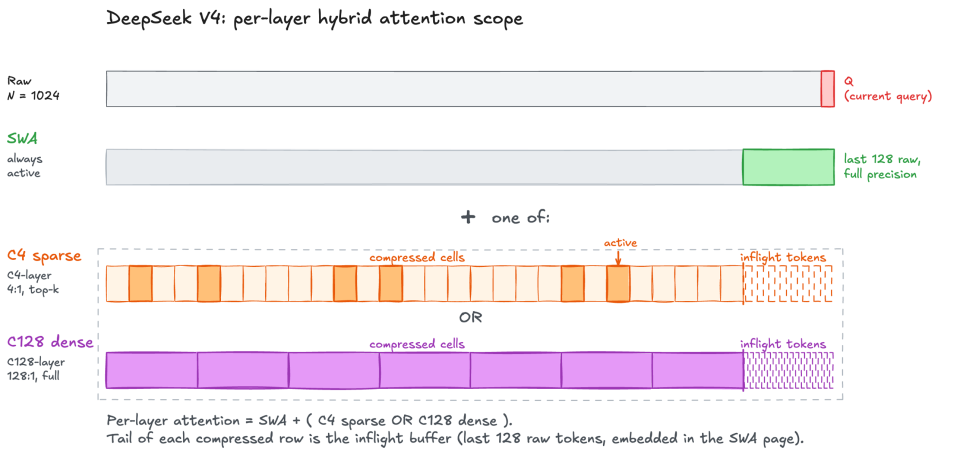
图 1:V4 每层 attention = SWA + (C4 sparse 或 C128 dense);SWA 保留最近 128 token 全精度,C4 稀疏压缩率 4:1,C128 密集压缩率 128:1。每条压缩行的尾部是 inflight buffer(嵌入 SWA 页)。来源:Tair 技术博客。
除了这三类 KV,还有 indexer(top-k 选择矩阵,控制 C4 访问哪些压缩位置)和 compress state pool(记录压缩状态的辅助数据)。五种物理形态,全部绑定在同一批 token 上。
在 V3/DSA 架构下,SGLang 的 memory_pool.py 维护了单一 DSA 类型的 KV 池(约 42KB/token,比 LLaMA MHA 的 512KB 小得多),RadixTree 的每个前缀节点可以直接对应这个池里的一段连续 buffer。V4 要求同一个节点同时持有 SWA 池、C4 池、C128 池和 indexer 的物理引用,RadixTree 的一对一索引模型完全失效。
这是一个寻址问题,而不只是容量问题。 解决寻址,才能谈容量。
二、Shadow Radix:一棵树,多套物理映射
Shadow Radix 的设计思路是分离逻辑坐标与物理存储。
树里维护的是”虚拟全 token 槽位”——每个节点按 token 序列排布,记录的是逻辑位置,本身不持有任何 KV 数据。调度器对这棵逻辑树做前缀匹配,得到的结果是一个逻辑坐标范围。真正的物理 KV 数据通过”shadows”——每个物理池独立维护的索引映射——投影到各自的池。
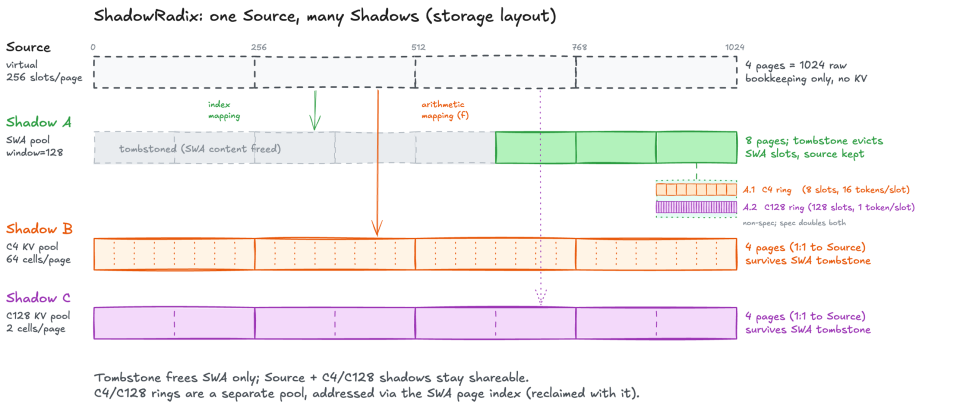
图 2:Source(虚拟坐标层)bookkeeping only,不存 KV;Shadow A 为 SWA 池,窗口外部分被 tombstone 释放但 Source 保留;Shadow B(C4)和 Shadow C(C128)以 1:1 比例跟随 Source,在 SWA tombstone 后继续存活。来源:Tair 技术博客。
这张图揭示了一个关键的不对称性。SWA 窗口是滑动的:当新 token 不断进入,超出 128 token 窗口的旧 SWA 数据会被 tombstone 释放。但 Source(逻辑节点)不会因此消失,C4 和 C128 的 shadows 也继续存活——它们的生命周期和 SWA 无关,只受全局 LRU 驱逐控制。这样,即便历史 SWA 数据已经被清除,前缀 cache 依然可以通过 C4/C128 shadows 为后续请求提供压缩前缀的命中,逻辑树保持完整性。
引用计数的设计也是专门为此而来:每个节点维护两个计数——full_lock_ref 覆盖所有 shadows(SWA + C4 + C128),swa_lock_ref 单独追踪 SWA 是否在当前滑动窗口内。只有 swa_lock_ref 归零时才释放 SWA 数据,Source 和压缩 shadows 的生命周期完全独立。
投机解码的兼容性也在这里解决:将 C4 的 ring buffer 大小从 8 翻倍到 16、C128 的从 128 翻倍到 256,就足以让投机解码的草稿 token 槽位不影响正式 KV 的管理。实测在 4K 到 900K token 的上下文范围内,Decode 吞吐量下降幅度在两块 GPU 上均低于 10%(B200:199→180 tok/s,H200:266→240 tok/s)[2],吞吐曲线基本平坦。
三、HiCache:把前缀 cache 从 GPU 推进到三层存储
寻址问题解决后,容量问题就可以按传统思路扩展了。但 V4 的五套物理形态意味着单请求的 KV 占用远高于 V3,GPU HBM 的前缀 cache 容量压力更大。
HiCache 基于 UnifiedRadixTree 架构,把前缀 KV 的存储从 GPU HBM(L1)扩展至 Host CPU 内存(L2)和分布式存储(L3)。整个框架的调度器统一面向 BasePrefixCache API——它不需要知道某段前缀 KV 在哪一层存着,只需发出 match_prefix / cache_finished_req / evict / init_load_back 四类指令,由 UnifiedRadixTree core 负责协调各层的 load-back 和 backup。
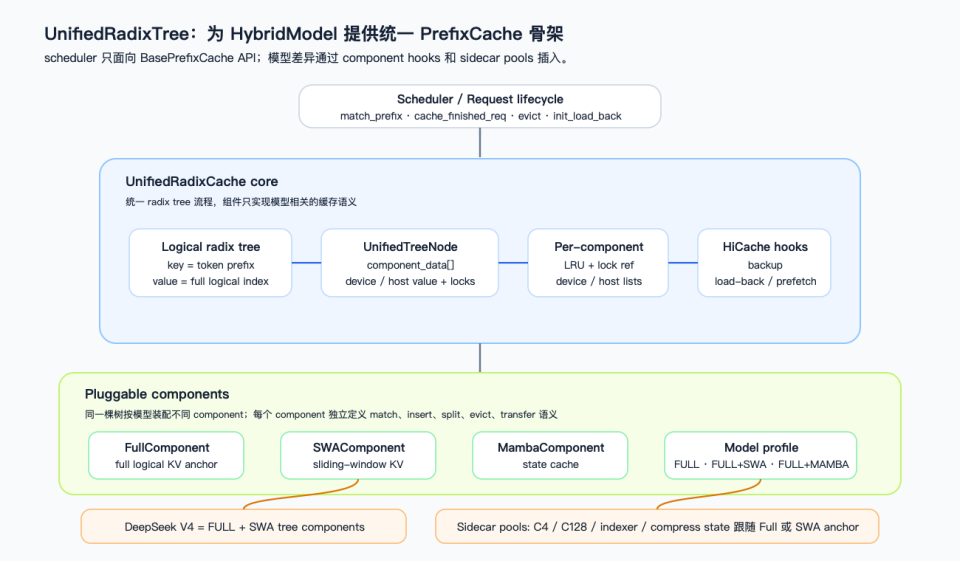
图 3:调度器只面向 BasePrefixCache API;UnifiedRadixTree core 维护逻辑树、节点数据和 HiCache hooks;Pluggable components 层处理模型差异(FullComponent/SWAComponent/MambaComponent),DeepSeek V4 = FULL + SWA;C4/C128/indexer 作为 sidecar pools 附着于 Full 或 SWA anchor。来源:Tair 技术博客。
图中值得注意的是 “Pluggable components” 层的设计。V4 在这里被建模为 FULL + SWA 两个 tree components,而 C4/C128/indexer 则作为 “sidecar pools” 附着在 Full 或 SWA 的 anchor 上。这意味着未来接入新的混合注意力架构(比如 Mamba 变体的 state cache),可以通过实现新 component 插入,而不需要改动调度器和 core 树逻辑。
在多轮对话场景下,HiCache 使 Input Throughput 提升接近 3 倍[2]。多轮对话里每轮都要带入完整历史上下文,而这部分前缀通常是高度可复用的。当历史 KV 从 GPU HBM 溢出到 Host 内存,HiCache 的 init_load_back 机制会在需要时异步预取,掩盖 Host→GPU 的搬运延迟。
四、HiSparse:Decode 阶段的稀疏冷热分离
HiCache 解决了 Prefill 阶段的前缀容量问题,但 Decode 有另一个瓶颈:C4 压缩 KV 的 GPU 显存占用。
C4 的 indexer(top-k 选择矩阵)在每个 decode step 只触及全部压缩位置的一小部分——典型情况下,相邻 decode step 的 top-k 选择集合重叠 80%–90%,每步实际需要新加载的 KV 不到总量的 20%。换言之,大多数 C4 KV 在任意时刻都是”冷的”,把它们常驻在 GPU HBM 上是浪费。
HiSparse 的方案是:GPU 只保留 C4 KV 的热 buffer(active working set),完整历史镜像存在 CPU pinned memory 中。LRU 协调器按页管理冷热交换:热 buffer 维持最近高频访问的 top-k 集合,miss 时从 CPU 异步加载,同时把新生成 token 的 KV 异步备份到 CPU 镜像。LRU buffer 大小通常设为 top-k 的 2–4 倍(约 4K–8K token),就足以维持 80%+ 的 GPU 命中率。
这套机制有效的前提是稀疏性强且相邻步骤选择集合稳定,这恰好符合长上下文场景的规律:Coding agent、长文档推理、多轮工具调用都表现出高度的 top-k 时序连续性。在 2×B200、200K 输入/20K 输出的测试配置下,HiSparse 将 Decode BatchSize 提升 5~10 倍[1],根本机制是把大量 C4 KV 从 GPU HBM 转移到 CPU,释放出的显存直接转化为可并发的请求槽位。
需要注意的边界:Host-GPU 数据搬运是这套方案的核心临界路径,PCIe 带宽和 CPU NUMA 拓扑对实际性能影响显著。短 prompt、低复用、batch 小的服务不一定能摊平 indexer 和传输开销——HiSparse 的 5-10 倍收益是长上下文重负载下的数字,不是通用加速比,这一边界条件值得关注。
五、结论
从 DeepSeek V3 到 V4,KV cache 管理的难度有一次质变:不是量的增加(更大、更多),而是结构的分叉(同一 token,多种物理形态)。Shadow Radix 应对这次质变的方式,是把”寻址”从”存储”里分离出来——先建一层纯逻辑的坐标系,再让各个物理池独立投影。这个分离带来了两个连锁收益:历史前缀 cache 可以在 SWA 窗口滑走后继续依赖 C4/C128 shadows 存活,HiCache 和 HiSparse 的三层扩展也因此有了统一的逻辑锚点。
这套架构最值得借鉴的地方不是它针对 V4 调了多少参数,而是它把”模型结构的物理差异”通过 Pluggable components 插入点从 cache 逻辑里抽离了出来。 UnifiedRadixTree 的 Mamba component 钩子已经在设计图里——Mamba 的 state cache 和 Transformer 的 KV cache 可以共存在同一棵逻辑树上,只是两种不同的 sidecar pool。
开放的问题是 Host-GPU 带宽约束。阿里云博客没有在网络 KV(L3 distributed storage)层给出 latency breakdown,HiCache 在 L3 触发 load-back 的实际耗时对不同硬件拓扑的影响仍不清晰。另一个待回答的问题是:HiSparse 的 LRU 策略在 top-k 选择集合快速漂移的场景(例如 reasoning 型推理的注意力模式剧烈变化)下命中率会退化到什么程度。这两个边界,值得有后续实测数据填进来。
参考资料
[1] Tair 联手 SGLang 共建 DeepSeek V4 分层缓存架构(阿里技术,2026-05-29)
[3] DeepSeek V4 Roadmap(SGLang GitHub Issue #23602)
[4] UnifiedTree: Support HiCache For DeepSeek V4(SGLang GitHub Issue #23639)
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。