版本声明:本文分析基于 ai-dynamo/dynamo commit
4a7f64f2(2026-06-02);除非特别说明,以下描述均基于此版本。
KVBM 最容易被低估的地方,是名字里还带着 Block Manager。如果只按 vLLM 或 TRT-LLM 里的传统 block manager 去理解它,很容易把它看成一个更大的 KV offload 插件。源码给出的信号更明确:Dynamo 已经把 KV cache 的逻辑身份、物理布局、跨层传输、跨实例发现和框架连接器拆成独立子系统。KV cache 在这里不再只是 attention kernel 的输入张量,而是一个可以被注册、查询、迁移、持有和订阅的存储对象。
这个判断和此前 Dynamo 1.0 的架构判断对得上:Dynamo 把推理系统拆成 KVBM、NIXL、Grove 等层次,试图把调度、内存、传输和 Kubernetes 扩展都纳入推理集群本体。KVBM 是其中最靠近模型执行的一层。它关心的是同一段 prefix 对应的 block 如何在 GPU、CPU、NVMe、对象存储和远端 worker 之间保持可发现、可复用、可回收。
一、KVBM 的三层结构:runtime 接口、逻辑生命周期、物理数据面
Dynamo 文档把 KVBM 描述成 vLLM、TensorRT-LLM 等框架之上的统一内存层和 write-through cache[1]。这句话在文档里很短,落到源码里意味着三件事:上层 connector 把 vLLM/TRT-LLM 的调度事件翻译成 block 操作,中层逻辑 manager 维护 block 生命周期和 hash registry,底层 physical/engine 层负责真正的数据搬运和分布式协调。
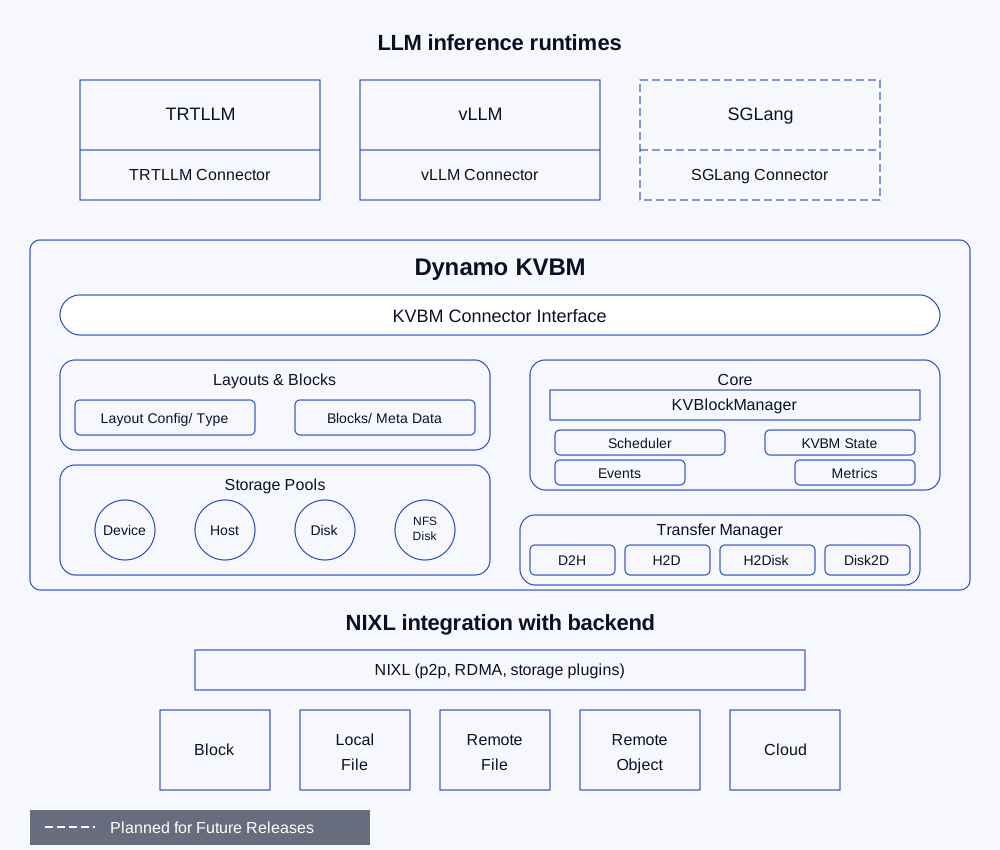
图 1:KVBM 的官方组件图把 LLM runtime、KVBM logic 和 NIXL layer 分开。这个分层说明 KVBM 的目标是让 vLLM/TRT-LLM 继续执行模型,同时把 KV cache 管理从框架内部抽出来。来源:NVIDIA Dynamo KVBM design。
这个拆法和 vLLM 的 PagedAttention 有明显继承关系。PagedAttention 的核心贡献,是把 KV cache 分成固定大小 block,用 block table 解决连续显存分配和碎片问题[14]。KVBM 沿着这条路往前走了一步:block 不只映射到 GPU HBM,还要跨 G1/G2/G3/G4 四层移动。官方 design doc 直接把 device pool、host pool、disk pool、remote storage 分成 G1 到 G4:GPU HBM、CPU pinned memory、local NVMe、remote/object storage[2]。
这里发生变化的是管理对象。 在 vLLM 里,scheduler 问 KVCacheManager 还能不能给请求分配 slots;在 KVBM 里,leader 可以先按 sequence hash 查 G2,再查 G3,必要时启动远端 onboarding session。前者回答“本 worker 还能不能跑这个请求”,后者回答“这个 prefix 是否已经在某个层级、某个实例上存在,以及把它拉回来值不值”。
二、逻辑层的关键是强弱引用边界
kvbm-logical 的 README 把 block 生命周期写成 MutableBlock<T> → CompleteBlock<T> → ImmutableBlock<T> ⇄ WeakBlock<T>[4]。这看起来像 Rust 类型系统细节,实际是在定义 KV cache 的所有权边界。
MutableBlock 是刚从 reset pool 拿出来、还可写的 slot;CompleteBlock 已经带上 SequenceHash,但还没有进 registry;ImmutableBlock 已注册,可被共享,强引用会阻止驱逐;WeakBlock 是不阻止驱逐的引用,只有 block 还活着时才能升级回来。blocks/mod.rs 里的注释直接把这些状态作为 RAII guard 描述,每次状态转移消耗一个 guard 产生下一个 guard[5]。
这个设计解决的是一个部署里的具体问题:offload 或 onboard 会跨越排队、等待 forward pass 完成、batch 传输、写入 G2/G3 等多个阶段。这个过程中,请求可能结束,transfer 可能取消,cache 可能被驱逐。强引用和弱引用把“正在被使用”和“只是一个候选缓存”分开,避免 transfer pipeline 为了追求复用而把所有 block 都 pin 死。
BlockManager::match_blocks() 也体现了这个取舍。它按 SequenceHash 做线性 prefix match,遇到第一个 miss 就停,且一次 store lock 完成 active+inactive prefix 的解析;scan_matches() 则是 scatter-gather,不要求连续命中[6]。这两个接口服务不同场景:prefix cache 需要连续命中,迁移或后台 offload 更需要“有哪些 block 可用”的全集扫描。
另一个细节是 registry 用 PositionalRadixTree 管 sequence hash,frequency tracker 用 TinyLFU 记录访问频次。这里的 hash 是 positional lineage hash;同一段 token 出现在不同位置,语义上可能不该复用同一个 block。KVBM 的 dedup 边界是“位置化的序列身份”。 对 agent 长会话、工具调用和多轮摘要这类负载,这个边界决定了 cache hit 的安全性。
三、物理层回答的是“同一个 block 怎么换格式搬运”
逻辑层知道 block 是谁,物理层才知道 block 在内存里长什么样。kvbm-physical 的 README 把它的职责拆成 layout、manager、transfer 三块:layout 负责 block 到 memory region 的映射,manager 负责注册 layout 和导出 RDMA metadata,transfer 负责选择 CUDA、NIXL、memcpy 或两跳 bounce buffer 路径[7]。
这里最有工程味的新增抽象是 KvBlockLayout。旧的 block manager 只要知道“这是第几个 block、在哪个 tensor 里”;KVBM 需要知道它在不同框架和不同存储层里的维度顺序。kvbm-physical 给了 UniversalTP、UniversalPP、OperationalHND、OperationalNHD、Custom、Unknown 等格式,并提供 requires_transform() 判断是否需要重排[8]。
PD 分离、不同 TP 配置、MLA replicated data、vLLM 和 TRT-LLM 的 KV tensor layout 都会让“同一段 KV”在物理上呈现不同切片。没有格式感知,跨 worker 拉 block 就有数据错位风险;有了格式感知,transfer executor 可以在 Operational 和 Universal 格式之间选择 transform kernel。
迁移文档也说明了这次重写的意图:kvbm-physical 从旧的 dynamo-llm::block_manager physical transfer layer 迁移出来,增加 LogicalLayoutDescriptor、KvBlockLayout、KvBlocks、caller-provided CUDA stream,以及基于 kvbm-kernels 的直接 FFI[9]。这次迁移的主线是把“按物理 handle 搬数据”升级为“按逻辑层级搬 KV block,并在必要时处理布局转换”。
transfer/strategy.rs 里的策略选择也很实际:host 到 disk 走 NIXL write,disk 到 host 走 NIXL read flipped;device 到 disk 如果 GDS 不可用就走 Device → Pinned → Disk 两跳;device 到 remote 如果 GPU RDMA 不允许,也先落到 pinned host memory[10]。这说明 KVBM 没有假设所有集群都有理想直连路径,保守默认是 pinned DRAM staging。
四、engine 层把 G1-G4 变成一次可取消的流水线
kvbm-engine 是 KVBM 从“本地 cache manager”变成“分布式存储系统”的地方。README 把存储层级写得很直白:G1 是 GPU HBM,G2 是 pinned DRAM,G3 是 NVMe/SSD,G4 是 S3/MinIO 这样的对象存储[11]。leader 负责匹配和放置决策,worker 负责通过 RDMA、NVMe 或对象存储 API 执行搬运。
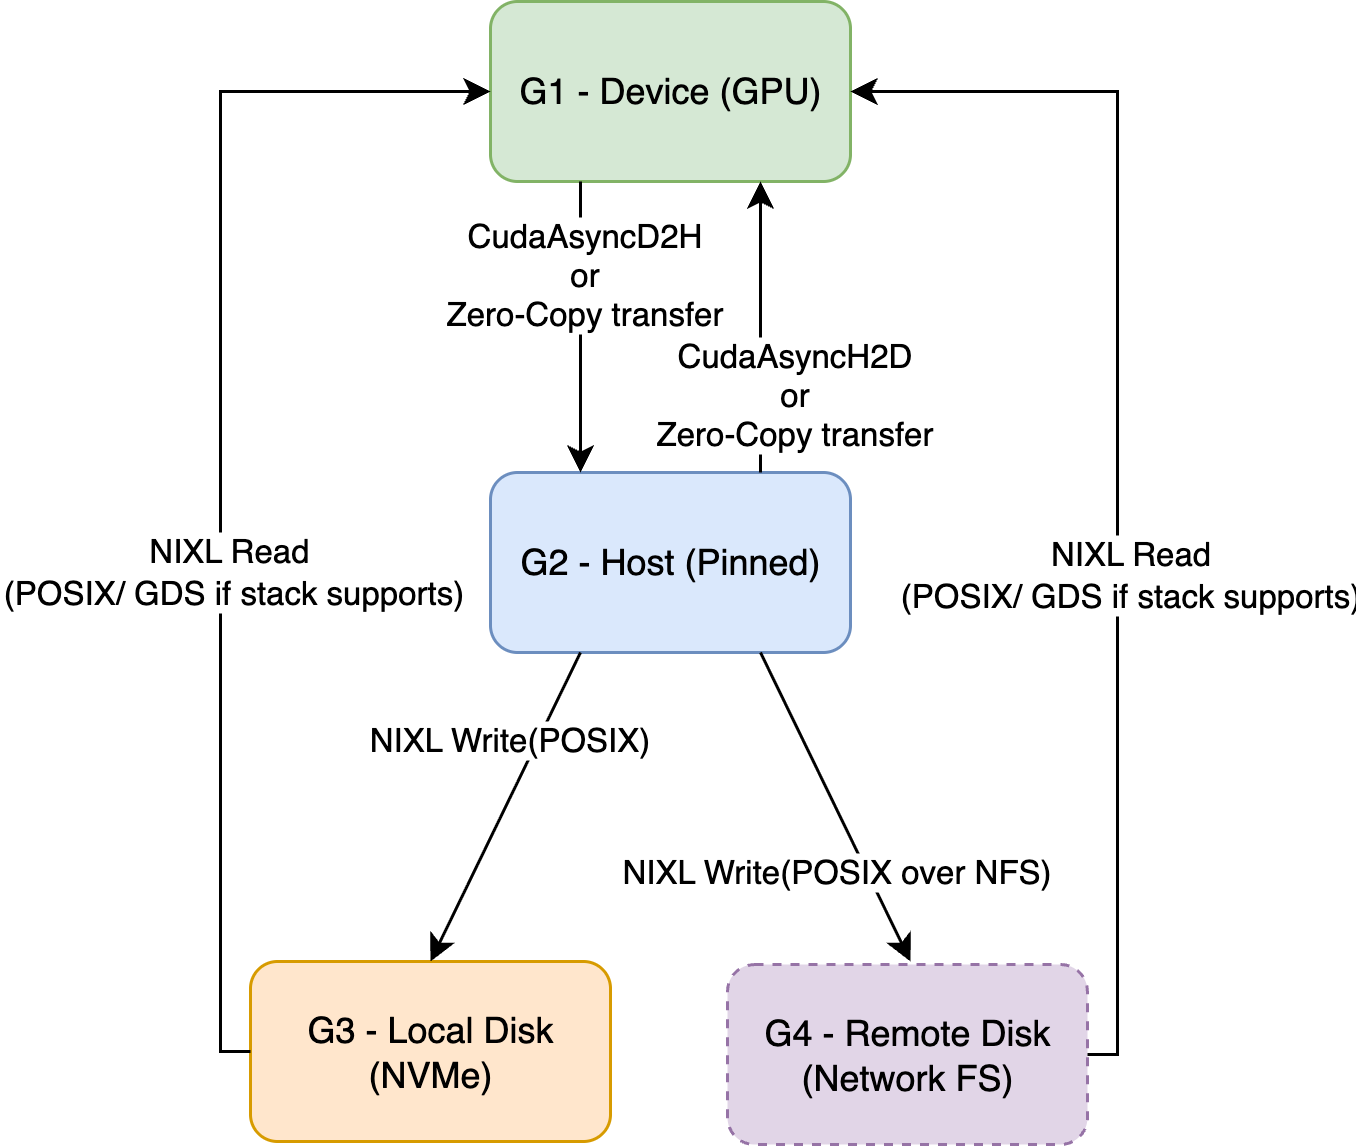
图 2:KVBM 的 data flow 把 offload 和 onboard 分成 Device→Host、Host→Disk、Host→Device、Disk→Device 等路径。真正困难的地方在于这些路径要和 forward pass、eviction、取消请求同时发生。来源:NVIDIA Dynamo KVBM design。
offload pipeline 的注释比架构图更能说明工程压力。一次 transfer 会经过 policy evaluation、batch collector、precondition awaiter、block upgrade 和 transfer executor;取消检查贯穿多个阶段,dedicated sweeper 会主动从 CancellableQueue 里移除已取消 transfer 的 block[12]。
这个设计的关键边界是 upgrade。WeakBlock 升级为 ImmutableBlock 之前,transfer 可以取消,block 可以被释放;升级之后,pipeline 持有强引用,传输进入承诺阶段。KVBM 把“可以放弃的候选 offload”和“已经承诺执行的数据搬运”切开,避免后台缓存动作反过来绑死前台请求生命周期。
engine 层还要处理并行策略差异。kvbm-config 里 ParallelismMode 有两个模式:TensorParallel 下每个 worker 持有自己的 KV shard,G1/G2/G3 操作 SPMD 执行;ReplicatedData 面向 MLA 场景,只有 rank 0 有 G2/G3,加载到 G1 后通过 NCCL broadcast 给其他 rank[13]。这和最近一批 MLA/DSA 模型的 KV 形态变化直接相关:KV cache 不再总是“每张卡一份 shard”,KVBM 必须把并行策略纳入内存层设计。
五、connector 的角色是让 runtime 放弃一部分 KV 管理所有权
KVBM 最后落到 vLLM 和 TensorRT-LLM connector。bindings/kvbm README 给了两个最小入口:vLLM 通过 --kv-transfer-config 指向 kvbm.vllm_integration.connector,TensorRT-LLM 通过 kv_connector_config 配置 DynamoKVBMConnectorLeader 和 DynamoKVBMConnectorWorker[3]。
vLLM connector 源码里,scheduler 侧实现 get_num_new_matched_tokens()、update_state_after_alloc()、build_connector_meta()、request_finished();worker 侧实现 register_kv_caches()、start_load_kv()、save_kv_layer()、get_finished()[15]。这组接口正好跨过 scheduler、allocation、forward pass 和 request finalization 四个位置。
connector 的职责明显超过“传输插件”。它要在 scheduler 判断一个请求能复用多少外部 token,要在分配之后更新状态,要把 metadata 传给 worker,还要在 forward pass 中加载和保存 KV layer。接入 KVBM 后,runtime 仍然执行模型,但 KV cache 的一部分生命周期决策已经交给外部内存层。
部署文档给出了几个需要小心的边界。KVBM 当前在 feature matrix 里对 vLLM 和 TensorRT-LLM 是支持状态,对 SGLang 仍标为实验/进行中[16]。KVBM guide 还提示 TensorRT-LLM 需要 PyTorch backend,并建议关闭 partial reuse 来提高 offloading cache hits;CPU cache 如果小于 device cache,KVBM 可能频繁在 forward pass 后把 block 从 GPU 搬到 CPU,带来性能下降[17]。
这些配置反映 KVBM 的收益前提:offload 层必须有足够容量承接 GPU working set,cache hit 的复用收益要超过跨层搬运成本,connector 要能把 runtime 的生命周期事件准确传出来。少了任意一项,KVBM 就会从“省掉 recompute”变成“制造额外搬运”。
六、写这篇笔记时我会怎么使用 KVBM 材料
如果后续要把 KVBM 写成更完整的工程文章,我会按三条线组织,避免按模块目录逐个介绍。
第一条线是 block 身份线:SequenceHash、BlockRegistry、Mutable/Complete/Immutable/WeakBlock、prefix match 和 scan match。它回答的是同一段 KV 如何被识别、去重、持有和释放。
第二条线是 数据搬运线:PhysicalLayout、KvBlockLayout、LogicalLayoutDescriptor、TransferStrategy、NIXL/GDS/CUDA/bounce buffer。它回答的是同一段 KV 如何在不同格式、不同层级、不同 worker 之间安全移动。
第三条线是 部署控制线:leader/worker、offload pipeline、onboarding session、vLLM/TRT-LLM connector、G2/G3/G4 容量配置、TensorParallel/ReplicatedData 模式。它回答的是一次请求进来后,系统什么时候查缓存、什么时候迁移、什么时候放弃、什么时候把控制权还给 serving engine。
这三条线合在一起,才是 KVBM 和传统 block manager 的差别。传统 block manager 的主战场在单引擎内存分配;KVBM 的主战场在分布式 KV 生命周期。它最像一个专门为推理写的 KV memory subsystem:engine 管计算,KVBM 管 block 的长期身份和跨层移动,NIXL 管底层可达性。
七、结论
KVBM 当前最值得追的是它暴露出的系统分层变化。KV cache 已经从“模型执行时顺手生成的中间状态”变成推理集群的共享数据资产。这个资产需要自己的身份系统、生命周期系统、传输系统和 observability 事件流。Dynamo 把这些放进 KVBM,说明 NVIDIA 对推理系统的判断已经从单机 engine 优化走向集群级内存操作系统。
边界也很清楚。公开材料还没有给出 KVBM 在大规模生产负载下的独立 benchmark;许多数字仍来自 Dynamo 1.0 总览、agentic inference 和 NIXL 场景,KVBM 自身的 ablation 还不充分。对于真实部署,最先要验证的是 G2/G3 容量、命中率、传输路径和 workload 复用模式是否足以覆盖 KVBM 的额外复杂度。SGLang 在 KVBM feature matrix 中仍未达到 vLLM/TRT-LLM 的支持水平,这也限制了跨框架统一内存层的现实边界。
真正的开放问题在 connector 边界。vLLM、TRT-LLM、SGLang、Mooncake、LMCache 都在把 KV cache 拉出单 worker,但它们对 block 身份、prefix 命中、layout 格式和 lifecycle event 的定义并不完全相同。KVBM 能否成为统一内存层,取决于这些定义能不能收敛到稳定接口。源码已经给了一个方向:先把逻辑身份和物理传输拆开,再让不同 runtime 通过 connector 接入。
参考资料
[2] KVBM Design
[3] Dynamo KVBM bindings README
[5] kvbm-logical blocks module
[6] kvbm-logical BlockManager implementation
[8] kvbm-physical KvBlockLayout
[9] kvbm-physical v1 migration guide
[10] kvbm-physical transfer strategy
[11] kvbm-engine README
[12] kvbm-engine offload pipeline
[13] kvbm-config cache configuration
[14] Efficient Memory Management for Large Language Model Serving with PagedAttention
[15] Dynamo vLLM KVBM connector
[17] KVBM Guide
版本对齐信息
| 材料 | 版本 |
|---|---|
| ai-dynamo/dynamo 源码 | commit 4a7f64f2(2026-06-02),branch main |
| Dynamo release artifacts | 当前稳定版 v1.1.1,kvbm==1.1.1 wheel,vLLM runtime v0.19.0,TRT-LLM runtime v1.3.0rc11 |
| KVBM feature matrix | Dynamo docs 标注 vLLM / TensorRT-LLM 支持 KVBM,SGLang 为实验/进行中状态 |
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。