版本历史
版本 日期 说明 v1.0 2026-06-02 初稿,基于 Mooncake 截至 2026-06-02 的公开材料,组件状态参照 v0.3.11 release 与 GitHub roadmap issue #1058 / #1883 v1.1 2026-06-02 修订更新:基于 Mooncake commit 94b9a6bc与最新 Conductor 设计文档,澄清 Conductor 当前仍是 KV indexer / router 辅助层,不是已开源的全局调度接管层
2026 年 2 月 12 日 Mooncake 正式加入 PyTorch 生态[1]。这件事容易被读成一次普通的项目收编,但它真正确认的是一个判断:KV cache 的传输和存储,已经从各家推理引擎内部的实现细节,沉淀成一层可以被多个框架共享的基础设施。 今天 vLLM、SGLang、TensorRT-LLM、LMCache、NIXL 都把 Mooncake 接进了自己的数据路径——它不再是某一个引擎的附属模块,而是这些引擎脚下的同一块地。
这就带来一个对工程选型很实际的问题:当一个 KV cache 项目同时被五六个上层框架依赖,它到底覆盖了哪些能力?这些能力在 SGLang / vLLM / TRT-LLM 里各自落地到什么程度?它和同样在做 KV cache 的 LMCache、HiCache 是竞争还是分工?这篇文章想把 Mooncake 当前的架构版图、生态落地状态和演进路线一次说清楚,并给出一个可操作的选型判断。
一、Mooncake 是什么:五个组件,一条主线
Mooncake 起家于 Moonshot AI 为 Kimi 做的推理平台,2024 年 7 月的架构论文以”KVCache-centric disaggregated architecture”拿下 FAST 2025 最佳论文[2]。论文给出的那张总览图,直到今天仍然是理解整个项目的最好入口。
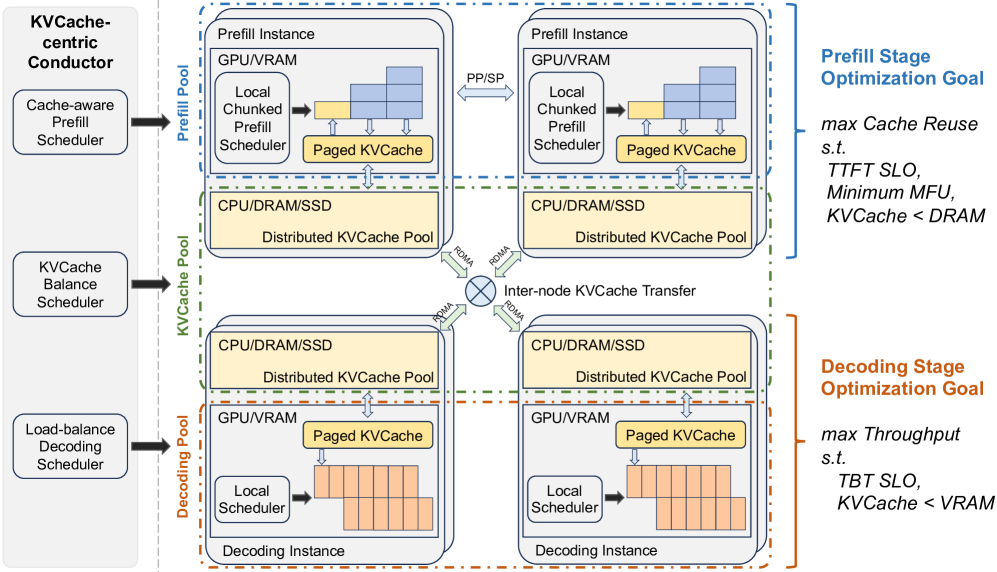
图 1:Mooncake 的核心是把 KV cache 提升为系统一级资源。左侧 KVCache-centric Conductor 用三个调度器(Cache-aware Prefill / KVCache Balance / Load-balance Decoding)统一编排,中间是把 CPU/DRAM/SSD 聚成的分布式 KVCache Pool,节点之间通过 Transfer Engine 搬运 KV。来源:Mooncake 论文 Figure 1。
把这张图拆开,就是 Mooncake 当前对外暴露的五个组件,它们解决的是推理系统里五个原本各自为政的问题:
Transfer Engine(传输引擎) 是最底层、也是最先开源(2024-11-28)的部分。它把 TCP、RDMA、CXL/shared-memory、NVMe-of 这些异构传输抽象成一套统一的批量数据搬运接口,对上层只暴露”把这块内存从 A 搬到 B”的语义,底层自动选 NIC、做 zero-copy。2025 年 10 月的 TransferEngine 论文报告,它在 ConnectX-7 和 AWS EFA 两类硬件上都能打到 400Gbps 级峰值带宽[3]。
Mooncake Store(分布式 KV 存储) 建在 Transfer Engine 之上,把集群里各节点贡献的 DRAM 聚成一个分布式 KV pool,支持多副本、条带化和并行 I/O,服务于 XpYd(X 个 prefill、Y 个 decode)的分离式部署。它要解决的是单实例 HBM 装不下、且 KV cache 无法跨实例复用的问题。
Mooncake EP(弹性专家并行) 把容错语义带进了 MoE 的 expert parallel 通信。它在 DeepEP 兼容的 dispatch/combine API 上显式加了 active_ranks 和 timeout_us 两个参数,让”某些 rank 已经失活”从通信层内部吞掉的异常,变成 EP 原语可见、可处理的输入。LMSYS 在 32 GPU、ep_size=32 的 DeepSeek V3.2 部署上验证:配置 256 个冗余专家后,最多容忍 16 个 rank 故障,服务中断仍在 10 秒内,相比传统全量重启的 2–3 分钟下降约 90%[3]。
Mooncake Backend(弹性分布式计算后端) 是对 PyTorch NCCL/Gloo 的替代,提供在 rank 失效时仍能继续工作的容错 collectives,并把失败信息向上汇报给应用层做 graceful 处理。
P2P Store 则面向去中心化的 checkpoint 分发和权重共享,是 RL 场景里权重更新路径的底座。
五个组件落在一条主线上:Mooncake 把推理系统里所有”数据要从一个地方移动到另一个地方”的需求——KV cache 搬运、跨实例复用、EP dispatch/combine、RL 权重更新——收敛到同一套底层传输和故障感知能力上。 这正是它能被五六个框架同时依赖的原因:它做的是一层所有引擎都绕不开的数据移动——这层一旦被抽出来独立,就不再归属于任何单个引擎。
二、PyTorch 博客点出的五种能力,对应五个生产痛点
PyTorch 那篇博客没有按组件、而是按能力来介绍 Mooncake,列了五项[1]。换个角度看,这五项恰好是大规模推理部署里五个最硬的成本痛点:
Prefill-Decode 分离——把算力密集的 prefill 和延迟敏感的 decode 拆到不同集群,各自按自己的 SLO 优化。Kimi K2 在 128 张 H200 上的部署是最完整的生产样本:4 节点做 prefill、12 节点做 decode,prefill 吞吐 224k tokens/sec,decode 吞吐 288k tokens/sec,短上下文场景下成本压到约 0.21 美元/百万输出 token[4]。
全局 KVCache 复用——把 KV block 当成跨请求、跨实例共享的分布式内存,命中就不用重算 prefill。这是 Mooncake Store 的核心价值,原始论文在真实 trace 上报告有效请求容量提升 59%~498%[2]。
弹性专家并行——前面提到的 Mooncake EP,让 wide EP 的 MoE 部署第一次具备局部故障后退化运行的能力。
PyTorch 分布式后端——Mooncake Backend 提供的容错 collectives。
权重更新——为 RL 和 checkpoint 场景提供 tensor-native、zero-copy 的快速权重更新。SGLang 基于 Mooncake TransferEngine 做的 RDMA P2P 权重传输,把 1T 参数 Kimi-K2 的权重更新从 NCCL broadcast 的 53.3 秒压到 7.2 秒,约 7.37 倍[3]。
把这五项摆在一起,能看出 Mooncake 的野心边界已经远远超出”KV cache 存储”。它在沿着推理系统的数据流,一段一段地把原本散落在各个框架里的传输与容错逻辑接管过来:请求进来要复用 KV、prefill 完要把 KV 传给 decode、MoE 要做 expert 通信、RL 训练完要灌权重——每一段都是数据移动,每一段 Mooncake 都想提供同一套底层能力。 这条扩张路线的工程含义是,上层框架可以逐步把这些重活外包出去,自己专注在调度和算子上。
三、五种能力在 vLLM / SGLang / TRT-LLM 落地到什么程度
能力清单很漂亮,但工程选型要看的是落地状态——哪些已经是稳定的官方支持,哪些还在分支里跑。Mooncake 在主流框架里的集成版图大致如下:
| 框架 | 集成角色 | 状态 |
|---|---|---|
| vLLM | PD 分离的 KV Connector;Mooncake Store 做跨实例 KV 复用 | 官方支持(v1+,2025-12 起) |
| SGLang | HiCache 的 L3 分布式存储后端;Elastic EP;RDMA P2P 权重 | HiCache 官方支持(2025-09),P2P 仍在 miles 分支 |
| TensorRT-LLM | PD 分离推理中的 KVCache 传输 | 已集成(2025-12-19) |
| LMCache | remote connector,做分布式 KV 管理后端 | 官方支持(2025-04) |
| NIXL | 作为 backend plugin | 支持(2025-05-09) |
| LMDeploy / vLLM-Ascend / vLLM-Omni / xLLM / FlexKV | PD 分离 / KV 传输 / 混合 offload | 各自集成中 |
具体到三大主流引擎,落地深度其实差别很大。
vLLM 走得最完整。 2025 年 12 月 Mooncake Transfer Engine 作为 KV Connector 进入 vLLM v1,承担 PD 分离场景下的跨节点 KV 传输;2026 年 5 月 vLLM 官方博客进一步把 Mooncake Store 集成讲透——MooncakeStoreConnector 在 scheduler 侧查询命中 token 数、worker 侧用 RDMA/GPUDirect 做 SM-free 的 zero-copy 搬运,把本地 block runtime 延伸成集群级 KV pool[5]。在 vLLM 上,Mooncake 的 PD 传输和全局复用两项能力都已经是可以直接用的官方路径。
SGLang 的落地最深、但也最分层。 HiCache 从 2025 年 9 月起就把 Mooncake Store 作为 L3 后端正式支持(详见第四节);Elastic EP 通过 Mooncake EP 落地;但 RDMA P2P 权重传输目前仍合在 sglang-miles 分支,尚未进入 SGLang main 的稳定 release API[3]。也就是说,SGLang 上 KV 复用和 EP 容错已稳定,权重更新还是一条正在工程化的 production path。
TRT-LLM 的集成相对窄。 2025 年 12 月 Mooncake Transfer Engine 进入 TRT-LLM,主要承担 PD 分离推理的 KVCache 传输。但 TRT-LLM 在传输层同时支持 UCX、NIXL 等多种后端,NVIDIA 自家的 Dynamo 又默认走 UCX、实验性支持 NIXL——所以在 NVIDIA 体系里,Mooncake 是 KV 传输的可选后端之一,而不是唯一通路。
so what:如果你的技术栈是 vLLM 或 SGLang,Mooncake 的 KV 复用和 PD 传输能力已经是生产可用的成熟路径;但 EP 容错和 RL 权重更新这两项更新的能力,落地程度高度依赖你用哪个引擎、跟哪条分支——尤其权重更新,目前还不能假设它是稳定 API。能力清单的”已支持”和你的部署能不能直接打开,中间还隔着一个分支状态的问题。
四、Mooncake 与 LMCache、HiCache 到底是什么关系
这是选型时最容易混淆的地方:LMCache 在做 KV cache,HiCache 在做 KV cache,Mooncake 也在做 KV cache,它们是三个互相竞争的方案吗?
答案是否定的——它们处在不同的层。Mooncake 是底层的传输 + 存储 substrate,LMCache 和 HiCache 是它上面的缓存管理策略层。 三者是分层互补关系,落地时往往是叠在一起用的。
先看 LMCache。它定位是 KV cache 的管理层,负责持久化、压缩、lookup 这些更上层的逻辑,本身可以对接多种存储后端。当你想让 vLLM 把 KV offload 到分布式内存时,LMCache 通过 remote_url 参数指定后端,格式是 mooncakestore://host:port/[6]——也就是说,Mooncake 是 LMCache 的一个 remote backend,LMCache 管”缓存策略”,Mooncake 管”数据落在哪、怎么搬”。 两者构成上下游,一个管策略,一个管落盘,谁也替代不了谁。
再看 HiCache,关系更典型。HiCache 是 SGLang 把 RadixAttention 扩展出来的分层缓存系统,借鉴 CPU cache 的设计,把 GPU 显存作为 L1、host 内存作为 L2、分布式存储作为 L3[7]。
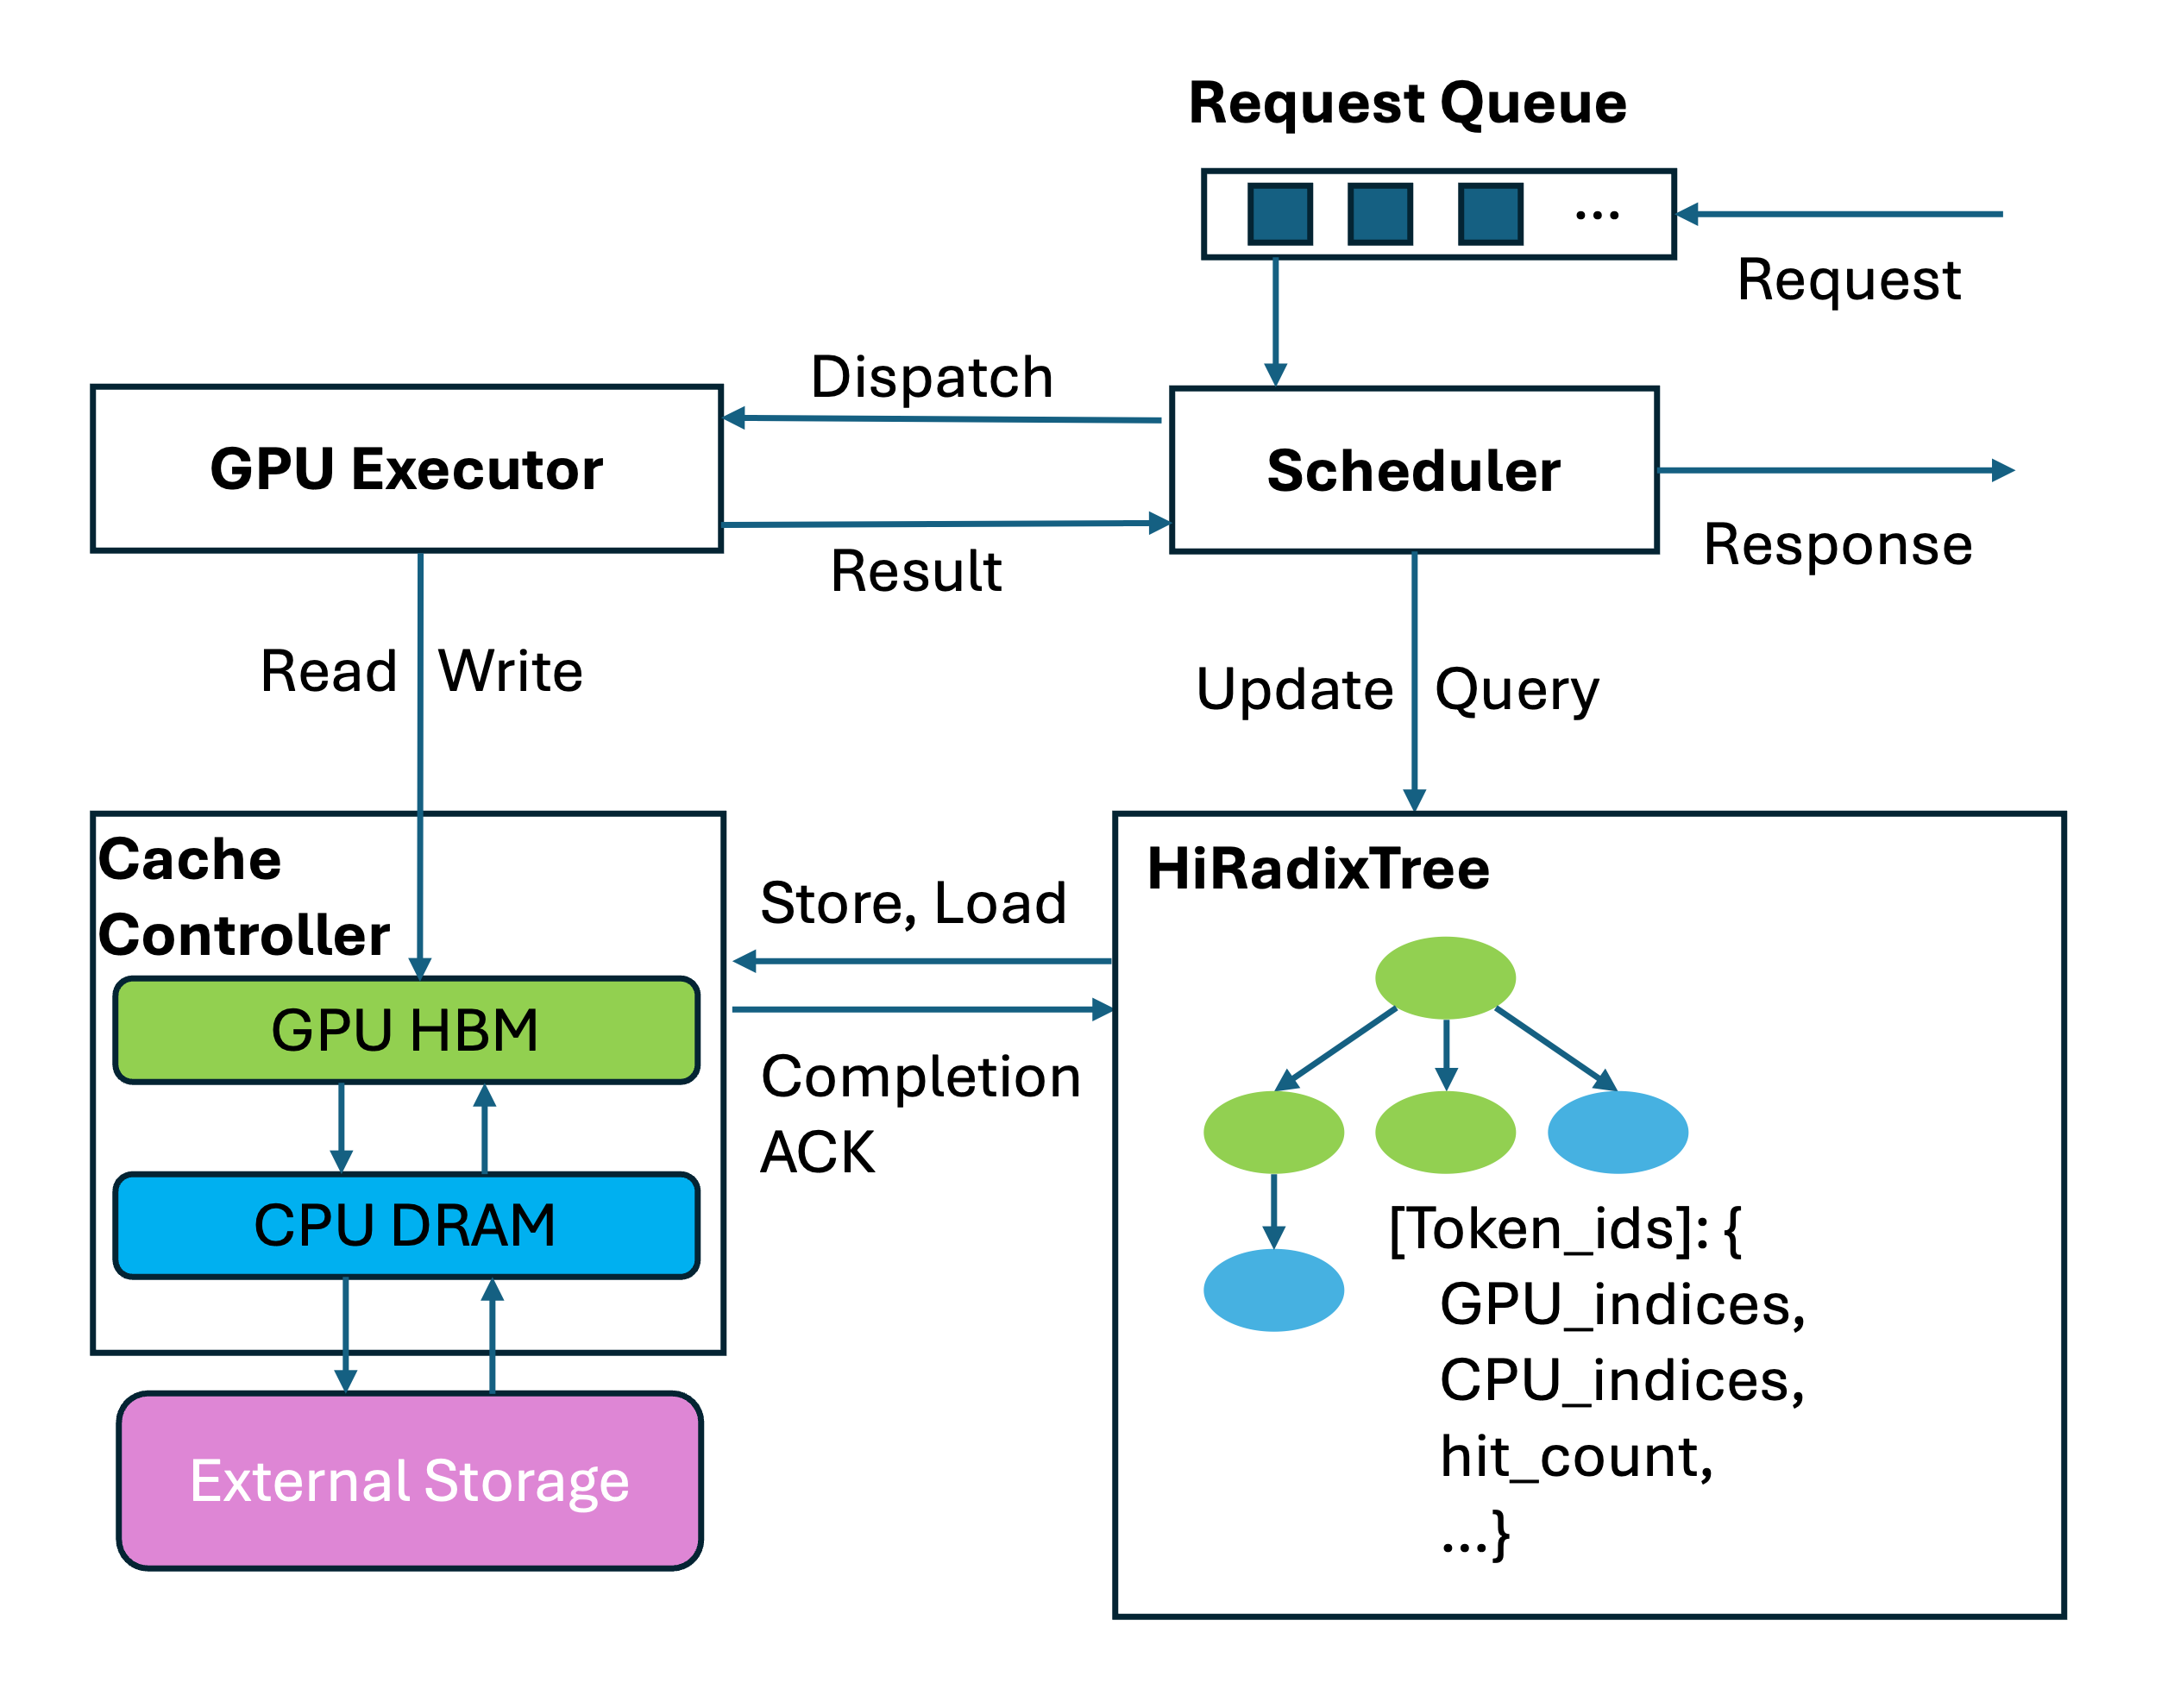
图 2:HiCache 用 HiRadixTree 精确记录每个 token 块在 GPU/CPU/外部存储的位置。最底层的 External Storage 就是 Mooncake 插入的 L3 位置——HiCache 管分层调度,Mooncake 管 L3 的分布式存储与跨实例共享。来源:SGLang HiCache 博客。
在这套三层结构里,Mooncake 就是那个 L3。 HiCache 负责 L1/L2/L3 之间的 prefetch、write-back 调度——本地匹配后再实时查询 Mooncake 拿 L3 的元数据,命中长度超过阈值(默认 256 token)就异步触发预取,用 RDMA 并行读、按页批量传(最多 128 页)[8]。Mooncake 负责把 L3 做成跨实例共享的分布式池子,数据一旦落到 L3,集群里所有实例都能复用,避免重复计算。
这套分层的价值,一张多轮对话的 benchmark 说得最清楚:
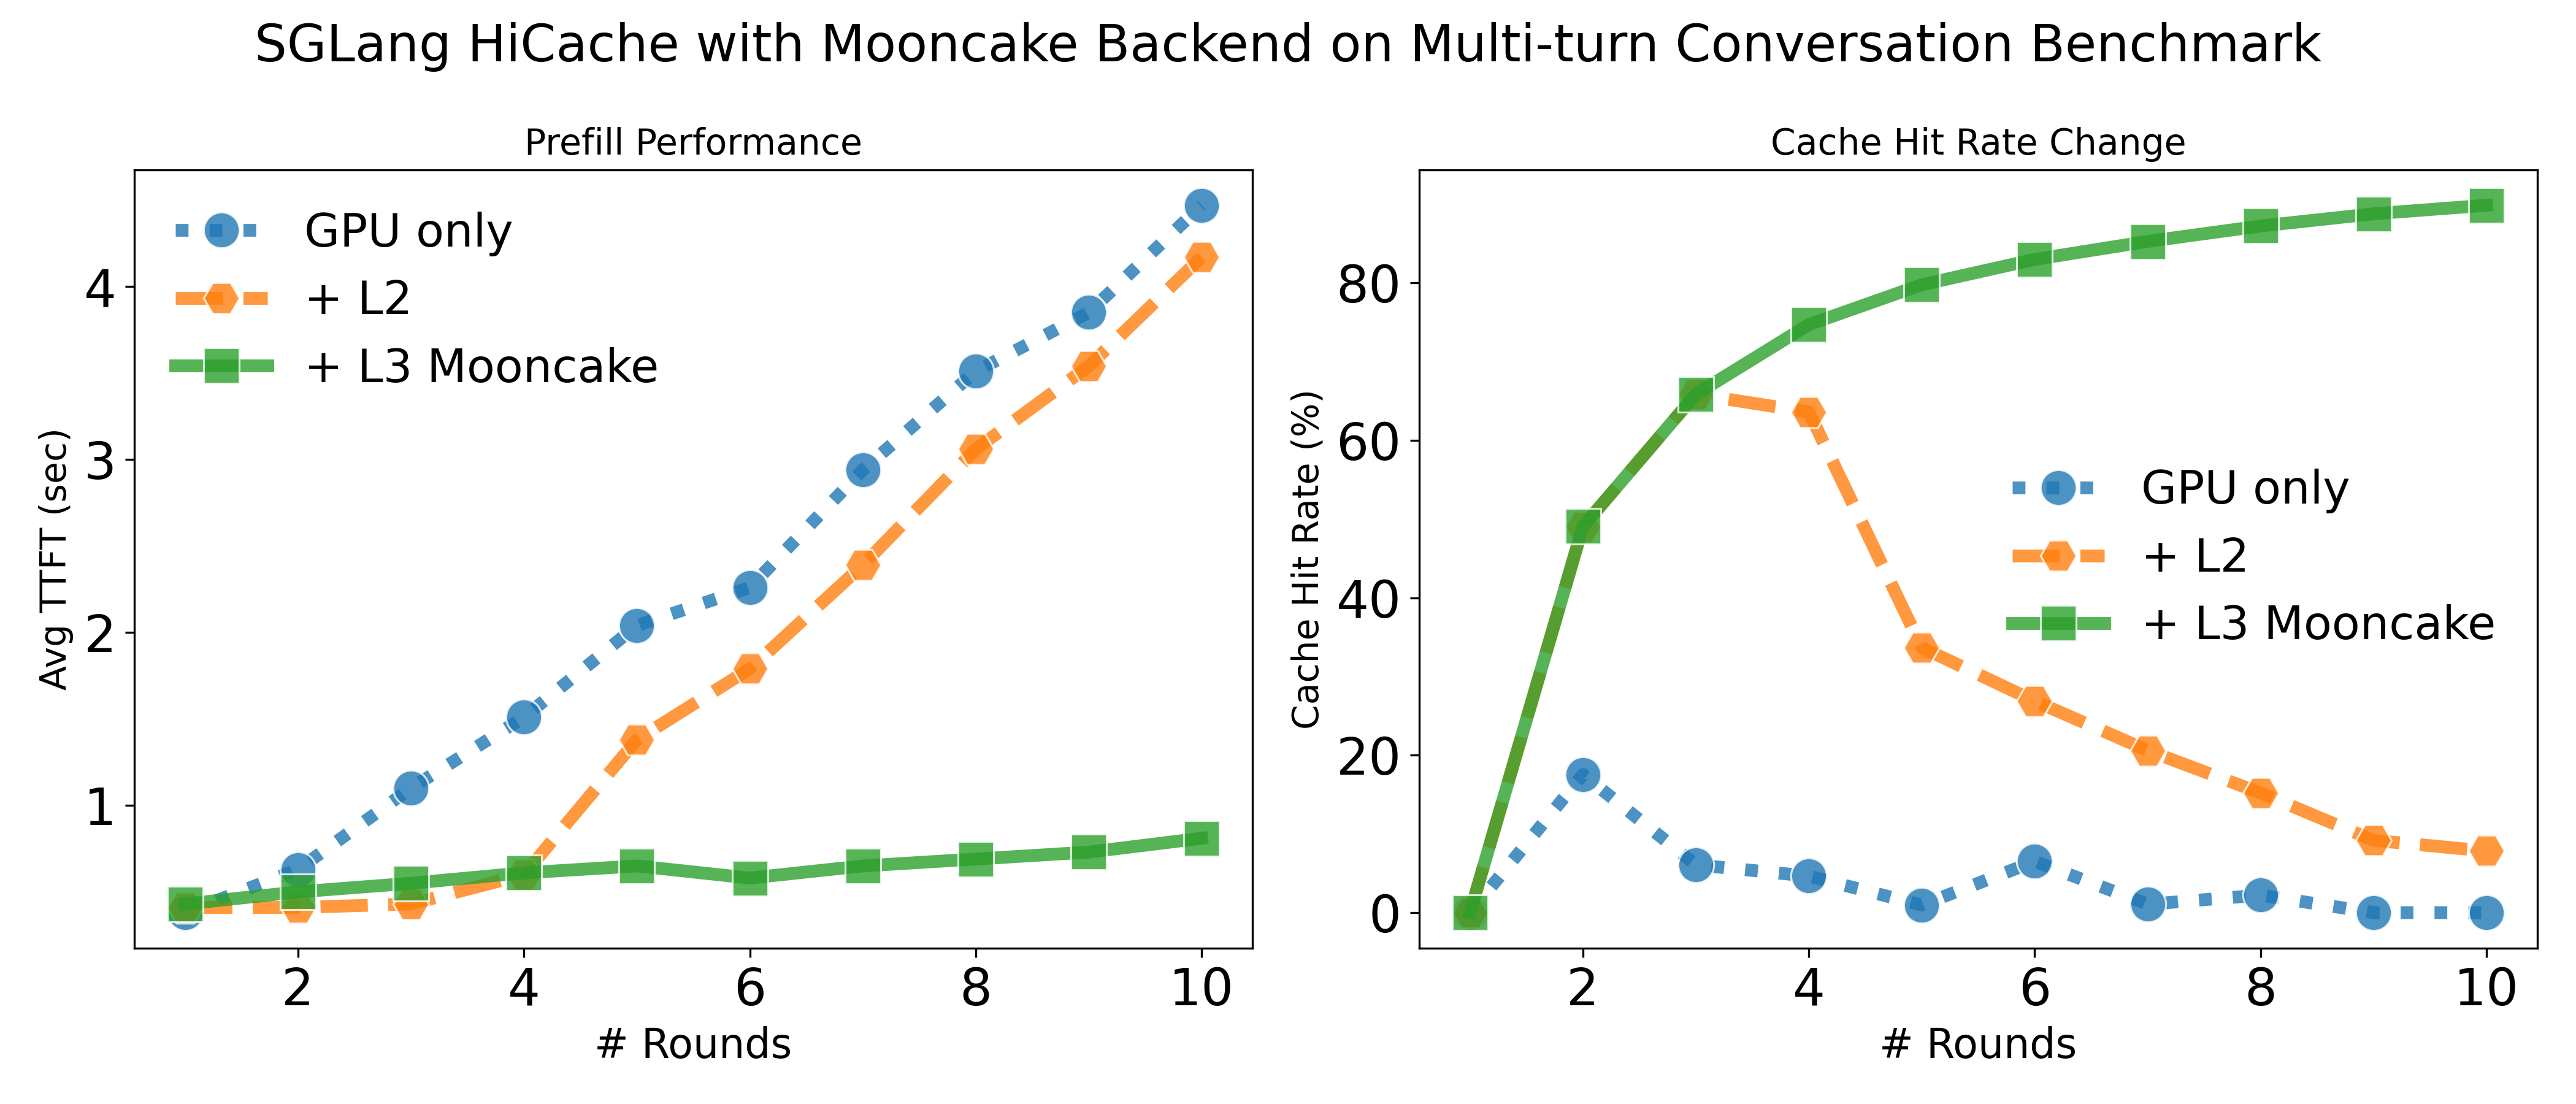
图 3:随对话轮数增加,纯 GPU 缓存(蓝)的命中率很快掉到接近 0,+L2 host 内存(橙)在第 4 轮见顶约 63% 后因容量耗尽持续下滑,而 +L3 Mooncake(绿)命中率爬升到约 90% 并稳住,TTFT 在第 10 轮仍维持在 0.8 秒内,纯 GPU 方案已涨到 4.5 秒。来源:SGLang HiCache 博客。
这张图点出了 Mooncake 作为 L3 的不可替代性:本地 L2 host 内存有容量上限,多轮场景下 working set 一旦超过它,命中率就会塌掉;而分布式 L3 池子的容量是集群级的,它把命中率从”几轮之后归零”变成”稳定在 90%”。 LMSYS 内部测得 HiCache 带来最高 6 倍吞吐提升、最高 80% TTFT 下降,蚂蚁集团报告 cache 命中相比全量重算 TTFT 降 84%,Novita AI 报告平均 TTFT 降 56%、吞吐翻倍、命中率从 40% 升到 80%[7]。这些数字的前提,都是有一个够大的 L3 把缓存接住。
理清这层关系,选型逻辑就清楚了:你几乎不会在”用 Mooncake 还是用 LMCache/HiCache”之间做选择,因为它们不在一个层上。真正的问题是,你的缓存管理策略层(LMCache 或 HiCache)下面,要不要挂一个分布式的 Mooncake 做 L3/remote backend。
五、落地的时候应该怎么选
把前面的关系收敛成一个可操作的决策框架,可以沿三个问题往下走。
第一个问题:你在哪个引擎上? 这决定了你接 Mooncake 的入口。vLLM 上,原生的 MooncakeStoreConnector 和经由 LMCache 的 mooncakestore:// 后端是两条都成熟的路;SGLang 上,标准入口是开启 HiCache 并把 L3 指向 Mooncake;TRT-LLM 上,Mooncake 是 PD 分离 KV 传输的可选后端,但要和 NIXL/UCX 一起权衡,尤其当你已经在用 Dynamo 时。
第二个问题:你要解决的是传输、复用,还是容错? 这决定了你需要 Mooncake 的哪几个组件。只做 PD 分离的 KV 搬运,用 Transfer Engine(或经 NIXL 间接用)就够;要跨实例复用 KV、扛多轮和长上下文,才需要 Mooncake Store 做分布式池子;要给 wide EP 的 MoE 加容错,才需要 Mooncake EP;要压 RL rollout 的权重更新停机窗口,才需要 P2P/Backend 那条线。不要因为 Mooncake 功能多就全量接入——大多数部署只需要其中一两个组件。
第三个问题:你的 working set 有多大? 这决定了分布式 L3 值不值得引入。从图 3 能反推出一条边界:如果你的负载是单轮、短上下文、KV 复用率低,本地 L1/L2 缓存可能已经够用,引入分布式 L3 的网络开销反而不划算;只有当多轮、长上下文、跨实例共享让 working set 持续超过单机 host 内存时,Mooncake 这层 L3 的命中率优势才会压过它的传输成本。分布式 KV pool 不是免费午餐,它的收益曲线在 working set 越过本地容量之后才陡峭起来。
三个问题答完,选型基本就定了:引擎决定入口,需求决定组件,working set 决定要不要上分布式层。
六、Conductor 当前进展:从全局调度 RFC 收缩为 KV indexer
(v1.1 新增) 这里需要把”论文里的 Conductor”、”RFC #977 里的 Conductor”和”当前本地源码里的 Conductor”拆开看。论文图 1 左侧的 Conductor 是 KVCache-centric scheduler:它知道 prefill / decode pool、KV cache pool 和 SLO,负责把请求路由到最合适的实例。RFC #977 继续沿着这个方向,把 Conductor 写成三层三明治结构:上层全局调度,中层 vLLM / SGLang 执行,底层 Mooncake Store 存储,并规划了 cache-aware prefill、load-balance decoding、KVCache balance 三类调度器[10]。
但以本地 Mooncake commit 94b9a6bc(2026-06-02)为准,开源树里并没有 mooncake-conductor/ 运行时代码,git ls-files 只包含两份 Conductor 设计文档和一张架构图。最新文档对 Conductor 的定义也已经明显收窄:它是 cache-aware router 使用的 KV cache indexer,负责订阅推理引擎或存储后端发出的 KV cache event,维护全局 prefix cache table,并通过 HTTP API 给 router / gateway 返回”这个请求 prefix 在哪些实例、哪些介质、哪些 DP rank 上命中”的查询结果[12]。
这意味着 Conductor 的公开进展不是”已经接管上层调度”,而是先补齐全局可见性。它的架构由 EventManager、ZMQClient、KVEventHandler、PrefixCacheTable 组成:ZMQ 客户端消费 KV event,handler 把引擎事件归一化,prefix table 维护模型、tenant、LoRA、block size、salt、实例和 DP rank 维度下的 prefix 命中状态;router 查询时传入 token IDs 或 rolling sequence hashes,Conductor 返回每个实例的 longest_matched 以及 GPU / CPU / DISK 分层命中 token 数[13]。
更重要的是,文档里的兼容性说明非常具体也非常克制:当前实现消费的是 vLLM ZMQ msgpack batches,并把 BlockStored 和 BlockRemoved 归一化进内部 prefix index;标准化方向参考的是 KV-Store Indexer API 和 KV Events API 两个 RFC[14][15]。SGLang、Mooncake storage daemon 可以作为 publisher 类型出现在 API 设计里,但从本地源码可见的已实现边界看,最明确的是 vLLM 事件接入,SGLang 仍更接近目标适配对象,而不是已经在开源树里跑通的同等级实现。
七、Conductor 与 vLLM / SGLang 调度是什么关系
(v1.1 新增) 结论先说清楚:当前 Conductor 不是 vLLM / SGLang scheduler 的替代品,也不是上游完全接管层;它更像 scheduler 外侧的 cache-aware routing / indexing control plane。 它回答”哪台实例更值得路由过去”,不回答 vLLM / SGLang 内部下一步 batch 怎么组、block 怎么分、prefetch 等多久、decode iteration 怎么推进。
vLLM 的 Mooncake 代码能很好地说明这条边界。MooncakeConnector 作为 vLLM 的 KVConnector 插进 scheduler hook:get_num_new_matched_tokens() 告诉 vLLM 有多少 token 可以从外部 KV 拉取,update_state_after_alloc() 在 vLLM 分配本地 block 后记录远端拉取任务,worker 侧再用 Mooncake Transfer Engine 注册 KV tensor、通过 ZMQ side channel 交换远端地址、调用 batch_transfer_sync_write() 搬 KV。这里 vLLM scheduler 仍然存在,PagedAttention / KVCacheManager / BlockPool 仍然是执行主链路;Mooncake connector 只是把”外部 KV 可用”这件事变成 vLLM scheduler 能理解的 external tokens 和 worker transfer metadata。
MooncakeStoreConnector 的关系也类似。它让多个 vLLM 实例通过 Mooncake Distributed Store 共享 block-hash 去重后的 KV pool,可以单节点 kv_both,也可以在 XpYd P/D 分离里和 MooncakeConnector 通过 MultiConnector 并排使用[16]。这再次说明它是插件化数据面:vLLM 仍做本地 block 管理和 request scheduling,Mooncake 提供远端 store、远端 transfer 和跨实例可见性。
SGLang 侧更不能说被 Conductor 接管。HiCache 的调度逻辑在 SGLang 内部:先查本地 HiRadixTree 的 L1/L2,再实时查询 L3 后端,命中超过阈值才触发 prefetch;等待策略由 best_effort、wait_complete、timeout 决定;多 rank 还要用 all_reduce(min) 对 L3 hit 长度达成一致[8]。Mooncake 在这里是 L3 backend 和 RDMA 数据面,Conductor 即便未来接入,也更可能给 router 提供跨实例 prefix locality,而不会替代 HiCache 的 L1/L2/L3 prefetch、write-back 和 GPU/CPU 搬运策略。
所以它们不是简单的上下游,也不是完全接管。更准确的层次是:router / gateway 在最外侧,用 Conductor 的 index 做跨实例路由;vLLM / SGLang 在中间,继续做 engine 内部调度;Mooncake Store / Transfer Engine 在底层,负责分布式 KV 存储和数据搬运。 Conductor 与框架 scheduler 的接口正在变清楚,但清楚的是”事件与查询接口”,不是”把 scheduler 迁移到 Mooncake”的接口。
八、Conductor 对 KV cache 分层调度为什么重要
(v1.1 新增) 如果它暂时不接管 scheduler,那 Conductor 还重要吗?重要,而且重要性恰好在分层调度的边界处。单机 engine 内部能看到本地 GPU / CPU cache;Mooncake Store 能看到自己服务过的 store-side hit 和 object count;但请求级、token 级、跨实例、跨介质的命中率,需要一个能同时观察完整请求路径和多层 cache 位置的控制面。Mooncake Store 部署文档已经明确说,Store 侧指标不是最终 request-level / token-level hit ratio,端到端命中率应由 Conductor 或 inference engine 计算;源码注释也把 segment 容量/用量查询标成 Conductor 可用于调度新请求的信息。
这就是 Conductor 对分层调度的核心价值:它把 “KV 在哪一层” 从局部事实变成路由输入。Indexer API 把存储介质抽象成 G1 device pool、G2 host pool、G3 disk pool,并在查询结果里返回 GPU / CPU / DISK 的连续 prefix 命中长度[13]。一个 router 看到 A 实例 GPU 命中 128 token、CPU 命中 512 token,B 实例 GPU 命中 0、CPU 命中 2048 token,才可能把”命中更多”、”命中更快”、”排队更短”三件事放进同一个选择函数。没有这层 index,分层 cache 只能在各 engine 内部局部优化,跨实例只能退回 round-robin 或粗粒度负载均衡。
这也解释了为什么 Kimi 内部很可能做过更深的系统改造,但开源接口还没有把那套调度完整交出来。原始论文里的 Conductor 能做 early rejection、prefill/decode pool balance、KV cache balance,这需要它同时掌握请求长度预测、TBT SLO、实例队列、KV 位置、cache 迁移成本和 store 容量。当前开源 Conductor 文档只定义到 event ingestion、prefix indexing、query response;它没有公开一个可以驱动 vLLM/SGLang 内部 batch scheduler 的完整状态机。因此合理推断是:Kimi 生产系统里的 Conductor 更像一套深度集成的内部 serving control plane,而开源 Mooncake 目前先释放了更容易标准化、也更容易让多框架共同接入的 KV event + indexer 子集。
这条路线是务实的。要让 vLLM 和 SGLang 都接受一个外部调度大脑,代价会非常高:它们的 batch construction、KV block allocator、prefix tree、prefetch deadline、DP/TP rank 协同都不一样。相比之下,让它们先发布 KV events、让 Conductor 统一计算 prefix locality,再由 router 做实例选择,是对现有框架侵入最小、也最可能变成跨框架标准的路径。Conductor 对 KV cache 分层调度的重要性,不在于今天已经接管了一切,而在于它把未来接管或协同调度所需的全局状态面先铺了出来。
九、社区演进路线:存储底座先生产化,调度大脑再标准化
Mooncake 目前的公开 roadmap(issue #1883)列了 16 个里程碑,但结合本地源码看,演进节奏比”马上变成全局调度平台”更保守[9]。
第一条线是 Store / Transfer Engine 的生产化。 Transfer Engine NEXT(TENT,issue #1058)提出一个”声明式切片喷射引擎”的概念[11]:调用方只声明”传什么、从哪到哪、QoS 是什么”,TENT 自动在 RDMA/NVLink/TCP/EFA 之间选路、调度优先级、处理链路故障。Phase 2 还规划了拓扑感知路由(跨 NUMA/PCIe/RDMA/NVLink)和 Kubernetes 弹性编排。把命令式的”你来搬这块内存”升级成声明式的”我要这个传输目标,你看着办”,本质是在给异构硬件和复杂传输场景做一层抽象隔离。
第二条线才是 Conductor 的标准化。 早期 RFC #977 讲的是全局调度大脑;最新文档落在 indexer API 和 KV Events API 上。这不是退步,而是把调度问题拆成两步:先让所有 engine / store 以同一种事件语义报告 KV block 生命周期,再让 router 基于统一 index 做 cache-aware routing。只有这层事实表稳定,后续才有可能谈更激进的 KVCache Balance Scheduler、热 block 迁移和 SLO-aware early rejection。
除这两条主线外,roadmap 还覆盖 Store V3 的模块化重构、SSD offload、动态 KVCache 迁移、agent 状态管理、多模态支持,以及对 Ascend NPU、摩尔线程、鲲鹏、AMD ROCm 等异构硬件的适配。v0.3 系列的近期 release 已经在逐条兑现:v0.3.10 加入 AWS EFA transport、CXL 存储和 io_uring 优化;v0.3.11 引入 Store HA 后端抽象(支持 Redis 领导选举做元数据高可用)和原生 Rust bindings[9]。从这些 release 的密度能看出,Mooncake 正在从”能跑的开源项目”往”敢上生产的基础设施”过渡——HA、异构硬件、可观测性这些不性感但生产必需的能力,是这个阶段的重心。
十、竞品版图与未来场景
Mooncake 所在的这层——推理系统的 KV 传输与存储 substrate——并不是无人区。它的竞品版图有点特殊,因为很多”竞品”同时也是它的集成方。
最直接的对照是 NVIDIA NIXL(Inference Xfer Library)。NIXL 是 NVIDIA 为 Dynamo 体系做的高性能传输层,同样面向分离式推理的 KV 搬运。微妙之处在于,NIXL 把 Mooncake Transfer Engine 收作了一个 backend plugin(2025-05-09)——所以在 NVIDIA 体系里,你可以用 NIXL 接 Mooncake,也可以用 NIXL 接 UCX。这是典型的”标准层之争”:NIXL 想成为 NVIDIA 生态的统一传输接口,Mooncake 想成为跨厂商、跨硬件的统一数据面,两者在抽象层级上重叠,但 Mooncake 的卖点是异构(不绑 NVIDIA),NIXL 的卖点是和 CUDA/Dynamo 栈的深度整合。
往上一层,NVIDIA Dynamo 的 KVBM(KV Block Manager)是更完整的 KV 管理方案,通过 NIXL 对接 CPU/SSD/文件系统/云存储等多种后端,这和 Mooncake Store + Conductor 的组合形成正面对照。再加上 Tencent 与 NVIDIA 合作的 FlexKV(2026-01 起也支持用 Mooncake Transfer Engine 做 KV 复用)、DeepSeek 开源的 3FS(在 HiCache benchmark 里和 Mooncake 并列作为 L3 后端选项),这层的玩家正在快速变多。
竞争格局背后,是几个 Mooncake 未来最可能发力的场景:
Agent 与长上下文的 KV 状态管理。 多轮对话、工具调用历史、共享前缀把 KV 生命周期从单请求推到会话级,working set 持续膨胀——这正是分布式 L3 命中率优势最明显的场景(图 3)。roadmap 里的 agent 状态管理和 agentic-aware caching 就是冲这个去的。
RL 训练与推理的解耦。 P2P 权重更新已经把 1T 模型的更新窗口压到秒级,这条线会随着 RL infra 的普及持续重要——rollout 和 update 之间的权重同步,本质就是 Mooncake 擅长的大规模数据移动。
跨数据中心与异构硬件部署。 TENT 的拓扑感知路由、对 Ascend/ROCm 的适配,瞄准的是 NVIDIA 生态之外的部署——在出口管制和多元算力的背景下,”不绑单一厂商”这件事本身就是 Mooncake 相对 NIXL 的差异化价值。
so what:Mooncake 的竞争优势不在单点性能,而在覆盖面和中立性。当一个项目同时是 vLLM、SGLang、TRT-LLM、LMCache、NIXL 的依赖,它的护城河就不再是某个 benchmark 数字,而是”换掉它要动整个数据路径”的迁移成本。 这也是它能从 KV cache 底座一路扩张到统一数据面的底层逻辑。
十一、结论
回到开篇的判断:Mooncake 加入 PyTorch 生态,标志的是 KV cache 的传输与存储正式成为一层可被多框架共享的基础设施。梳理完它的五大组件、各框架落地状态和与 LMCache/HiCache 的分层关系,这个判断可以收得更紧——Mooncake 已经从”为 KV cache 服务的远端存储”,演化成推理系统的统一数据面:KV 复用、PD 传输、EP 容错、权重更新、cache-aware routing,正在收敛到同一套底层能力上。
但这个判断有明确的边界。一是落地状态参差:KV 复用和 PD 传输在 vLLM/SGLang 上已成熟,EP 容错和 RL 权重更新则高度依赖引擎和分支,权重更新目前还不是稳定 API。二是”大脑”尚未以完整形态开源:让 Mooncake 真正成为调度中枢的 Conductor,在公开代码里当前仍停在 indexer / router 辅助层;它能提供跨实例、跨介质的 KV locality 事实表,但还没有公开接管 vLLM/SGLang 内部 scheduler 的接口。三是竞争未定型:NIXL、KVBM、FlexKV、3FS 都在抢这层 substrate,Mooncake 的中立性是优势,但 NVIDIA 体系的深度整合也是真实的引力。
对工程选型来说,最值得记住的是那个分层认知:真正要决定的,是要不要在你的缓存管理层下面挂一个分布式 Mooncake 做 L3——这个问题和”该用 LMCache 还是 HiCache”无关,答案取决于你的引擎、你需要的组件、以及你的 working set 有没有越过本地容量那条线。 把 Mooncake 当成可插拔的数据面底座来用,才是用对它的前提;它从来就不是一个要和谁二选一的缓存方案。
参考资料
[1] Mooncake Joins PyTorch Ecosystem
[3] Updating 1T parameters in seconds — P2P weight transfer in Large Scale Distributed RL
[4] Deploying Kimi K2 with PD Disaggregation and Large-Scale Expert Parallelism on 128 H200 GPUs
[5] Serving Agentic Workloads at Scale with vLLM x Mooncake
[6] Mooncake — LMCache Documentation
[7] SGLang HiCache: Fast Hierarchical KV Caching with Your Favorite Storage Backends
[8] Mooncake x SGLang HiCache System Design
[9] RoadMap: Mooncake Project Overall Roadmap (Issue #1883)
[11] RoadMap: Mooncake Transfer Engine NEXT (Issue #1058)
[12] Mooncake Conductor Architecture Design
[13] Mooncake Conductor Indexer API Design
[14] RFC: Mooncake KV-Store Indexer API Standardization (Issue #1403)
[15] RFC: KV Events API Standardization (Issue #1527)
[16] Guide: vLLM MooncakeStoreConnector
版本对齐信息
| 项目 | 版本 / commit | 日期 | 本文使用位置 |
|---|---|---|---|
| Mooncake | 94b9a6bc |
2026-06-02 | Conductor 文档、vLLM Mooncake connector、Mooncake Store / HiCache 设计文档、本地源码状态核对 |
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。