版本声明:本文基于小米 MiMo 官方博客(2026-05-30);工程数字来自该博客公布的生产数据,未独立验证。
Hybrid SWA 把 KV cache 存储压缩约 7 倍。这是 MiMo V2.5 博客的开篇数字——与 Full Attention 模型相比,计算量降低 ~7.0×,存储需求降低 ~7.0×,在国内同规模模型中仅次于 DeepSeek-V4-Pro 和 Flash[1]。
7× 是模型设计的结论,系统工程从这里才开始。从”模型理论上少用 7 倍显存”到”生产服务 93% 命中率”之间,有一套完整的基础设施要重建。Hybrid SWA 把 KV cache 分裂成了两种有着完全不同有效期的状态——全局可见的 Full Attention KV 和仅对最近 128 个 token 有效的 Sliding Window KV。所有上面的系统工程,都在追这个区别。
一、两种 KV,两套有效期
MiMo V2.5 的 Hybrid SWA 结构是:大多数 Transformer 层只能看到最近 128 个 token(Sliding Window Attention),少数层保留对整个序列的全局可见性(Full Attention)。SWA 层提供局部精度,全注意力层维持全局感知。
系统层面,这个分工产生了一个核心矛盾:Full Attention 的 KV 是 O(N) 的,SWA 的 KV 是 O(W=128) 的。Full Attention KV 随序列增长,历史所有 token 的 KV 未来都可能被前缀复用;SWA KV 只保存最近 128 个 token,窗口外的条目对当前计算毫无意义,随着序列推进持续滚动更新。
在超长上下文下,这个差异被充分放大。博客的 FLOPs 对比图(图 1)显示:在短序列段,Hybrid SWA 与 Full Attention 的差距有限;到接近 1M token 的序列长度,~7× 的计算量优势才完全体现。架构红利从数千 token 开始积累,到百万 token 量级才能完全兑现——这意味着理论节省在短会话场景几乎没有意义,只有长上下文和多轮 agent 场景才是它的主战场。
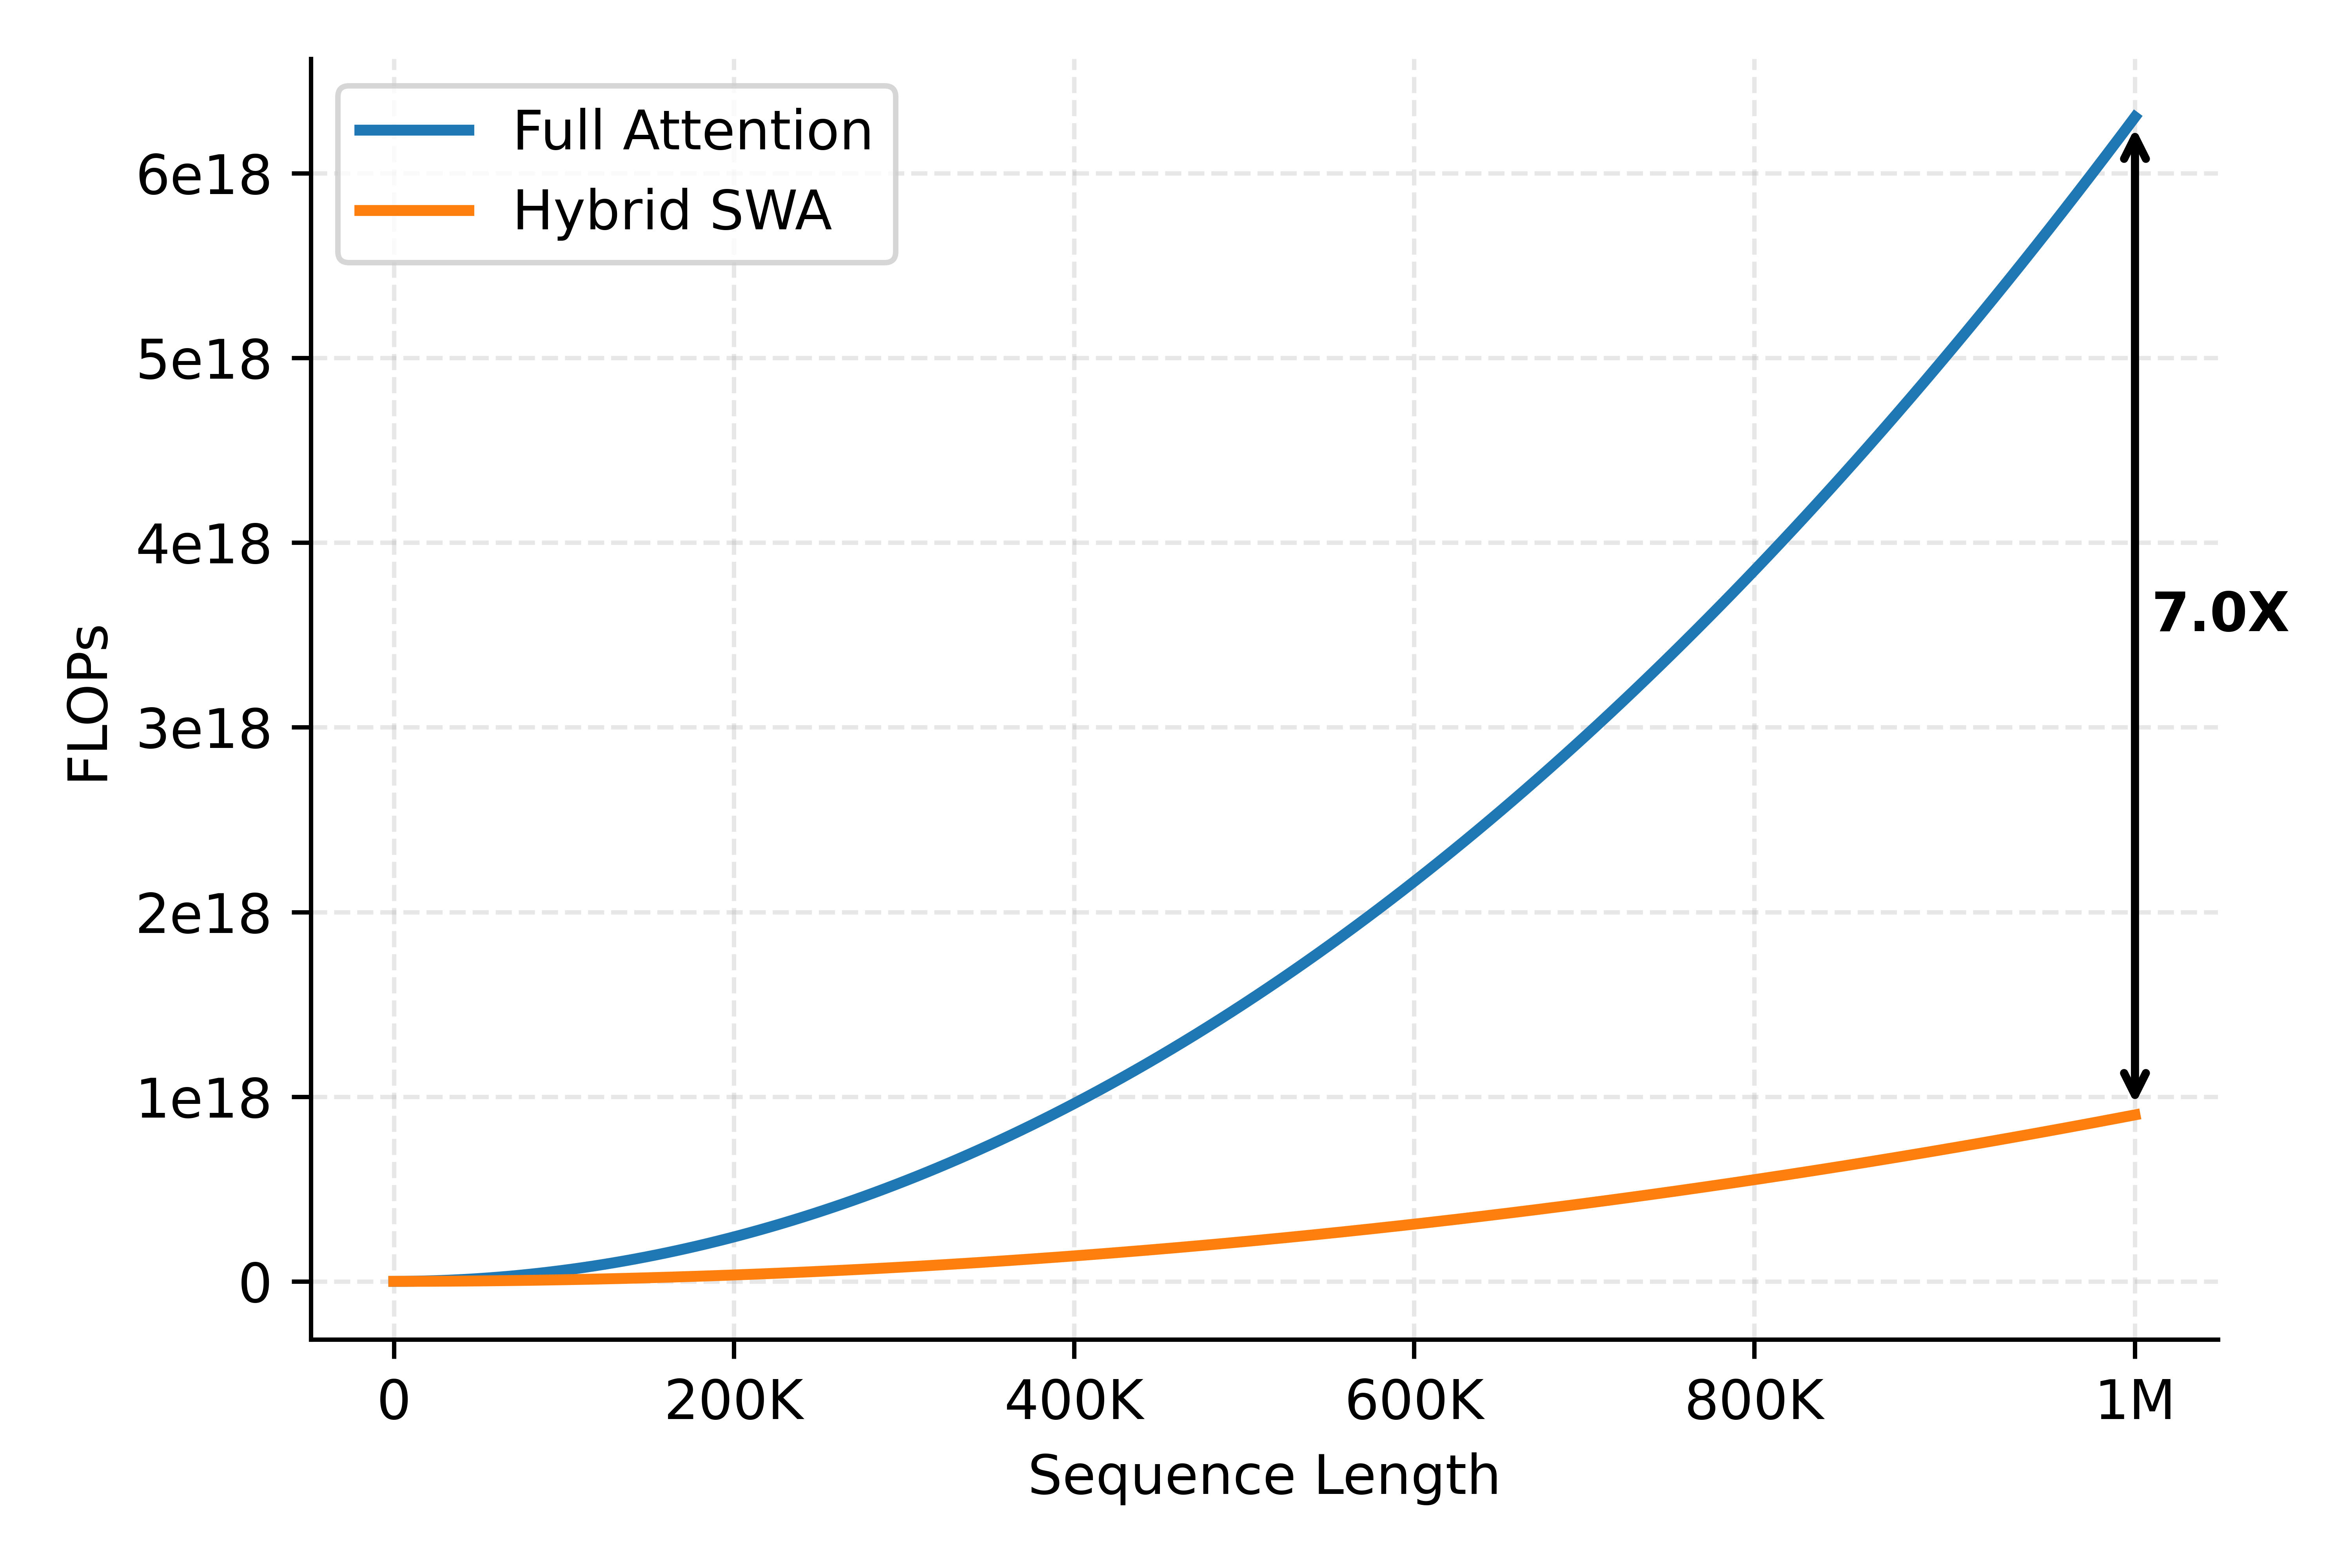
图 1:在接近 1M token 的序列长度下,Hybrid SWA 的 FLOPs 约为 Full Attention 的 1/7;短序列段差距有限,理论优势在长上下文场景才能充分兑现。来源:小米 MiMo 官方博客。
如果把两类 KV 放在同一个池里管理,驱逐策略立刻陷入矛盾:SWA 的旧 token 可以随时驱逐,Full Attention 的旧 token 有前缀复用价值,用同一个 LRU 混着清会误杀有价值的缓存。MiMo 的解法是双池架构——Full Attention Pool 和 SWA Pool 完全分离,各自维护独立的 eviction 策略,互不干扰。
二、前缀树的幽灵命中问题
双池解决了存储管理,但前缀缓存的匹配逻辑还藏着一个更隐蔽的问题。
传统前缀缓存的假设是:token 序列相同,KV 就有效。这在 Full Attention 模型里是正确的。在 SWA 模型里,这个假设会产生”幽灵命中”(phantom hit):新请求的前缀 token 序列与缓存树中某个节点完全匹配,但被命中的那段 KV 里有 SWA 层的条目——这些条目属于当前序列窗口范围之外的 token 位置,用它们做计算会得到错误结果[1]。
MiMo 的解法是修改前缀树的匹配规则:从”token 相等”改为“窗口安全长度”(window-safe length)。匹配长度只计算当前 SWA 窗口内的有效 KV 覆盖,窗口外的旧 SWA token 不参与命中。每个节点维护双状态索引——Full Attention 状态和 SWA 状态各一套,驱逐路径也分开处理:窗口外的 SWA 状态可以单独释放,不影响 Full Attention 的共享复用。
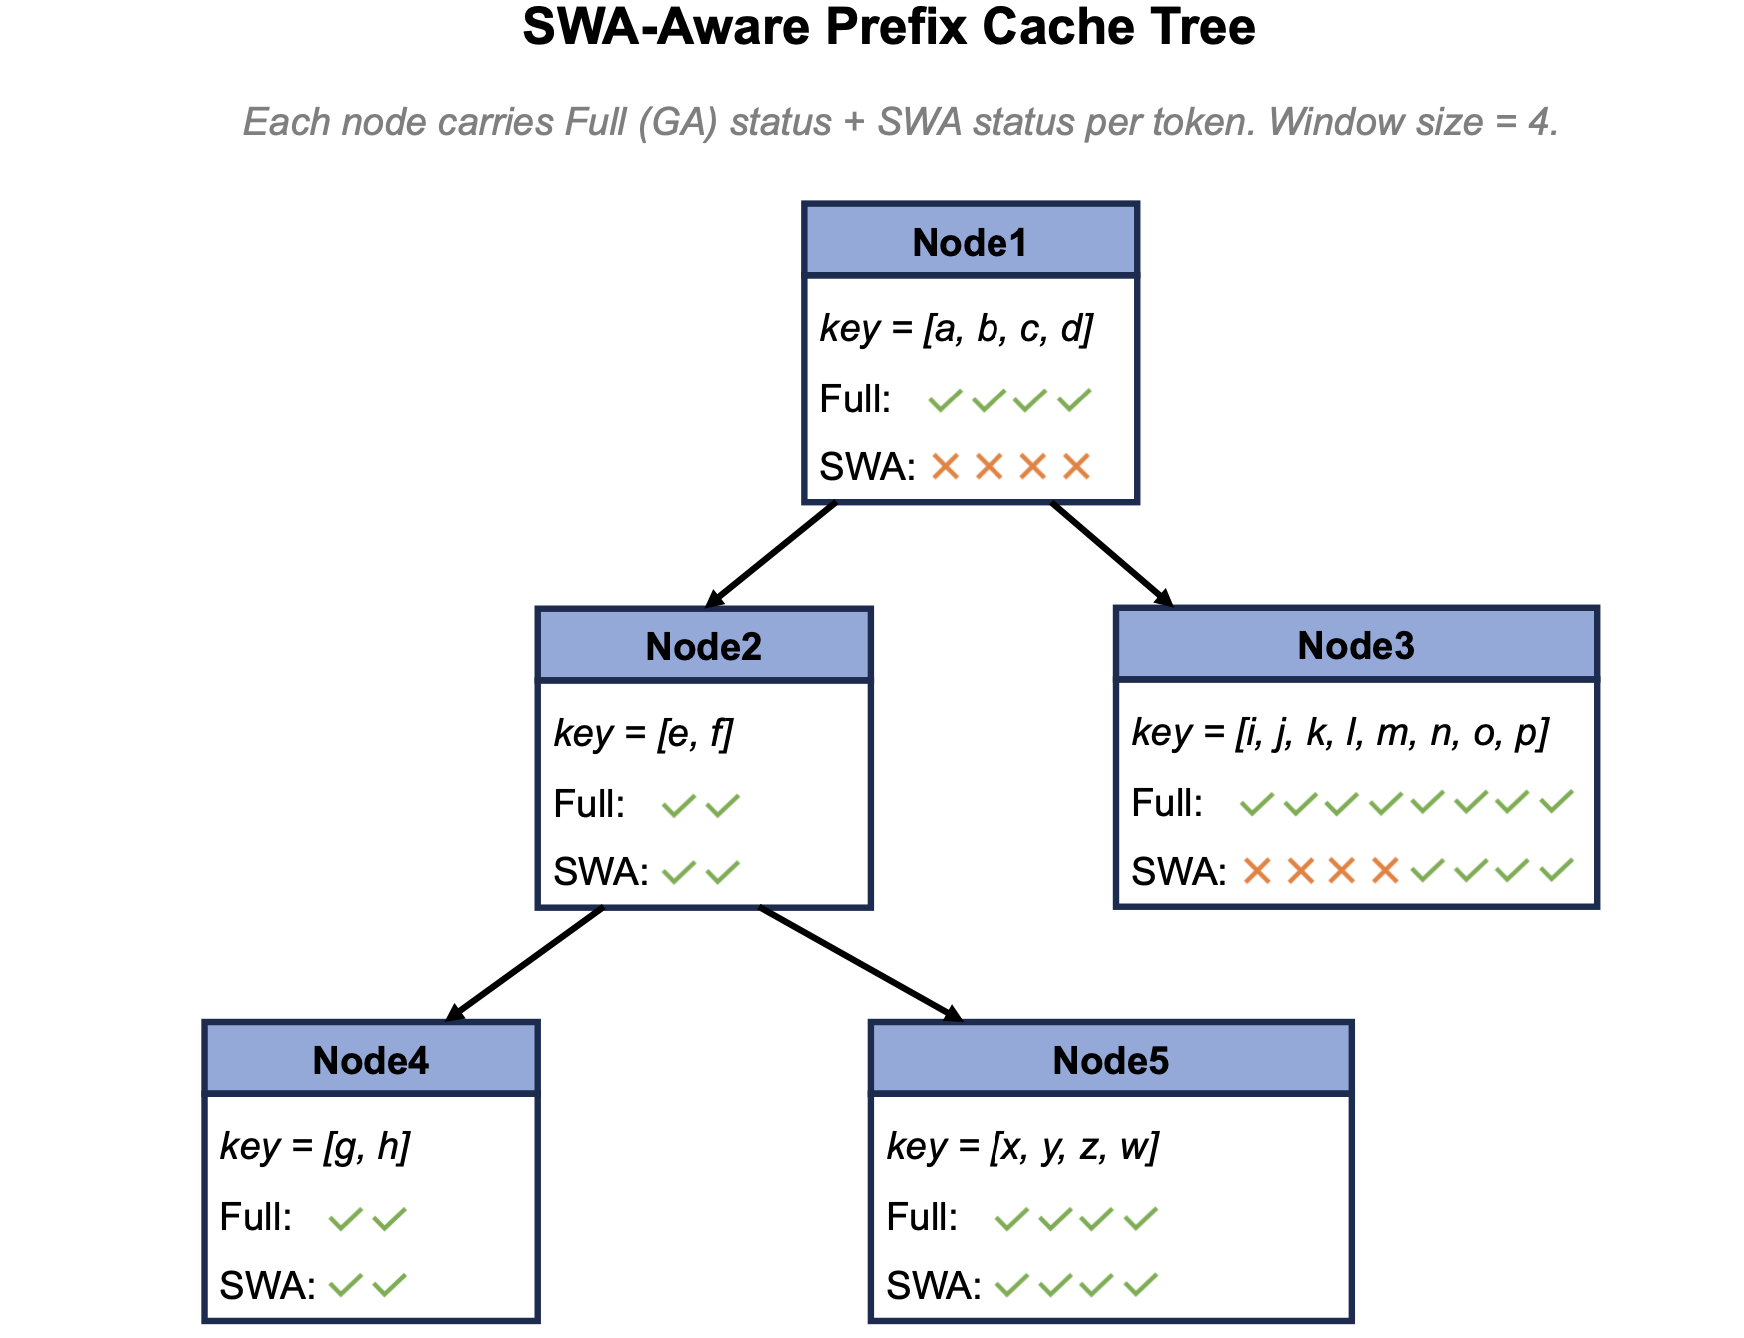
图 2:前缀树每个节点同时追踪 Full Attention 状态和 SWA 状态。匹配基于”窗口安全长度”而非 token 数量——只有在当前滑动窗口内的 SWA KV 才计入有效命中,避免幽灵命中导致的计算错误。来源:小米 MiMo 官方博客。
这个设计与 SGLang 团队为 DeepSeek V4 开发的 ShadowRadix[2] 是独立解决同一问题的两种方案。ShadowRadix 用 tombstoning 机制处理 SWA 的短生命周期——当 SWA 引用计数归零时释放 SWA 缓存但保留压缩缓存(C4/C128 池),MiMo 用双状态索引 + 独立驱逐路径实现相同目的。两个团队在同一个问题上各自收敛,说明这是 hybrid attention 系统工程里的必解题。
三、分布式缓存:让理论节省变成生产数字
单机 KV 管理打通之后,下一层是跨请求、跨节点的缓存复用。
分层异步预取先在单机上发挥作用:GPU 执行当前层计算的同时,把下一层需要的 KV 从 host 侧异步预取到设备。计算和传输的时间窗口重叠,让 KV 加载的显式延迟近似为零。在命中率高的场景下,这个机制把 I/O 成本基本隐藏进计算流水线,避免了加载等待成为吞吐瓶颈。
跨节点层面,MiMo 构建了自己的分布式缓存基础设施 GCache,核心是三层存储(显存 / 磁盘 / 远端)加自动晋升/降级,配合一致性哈希的 key 分布。RDMA 单进程吞吐 170 GB/s(1MB IO),延迟 280μs;开启 GDR(GPU Direct RDMA,直接用 HBM 做源端)时可达约 350 GB/s。GCache 与 GPU 机器上的 Prefill/Decode 节点共置,使用机器内置的 NVMe SSD,不引入独立存储集群的额外网络跳数[1]。
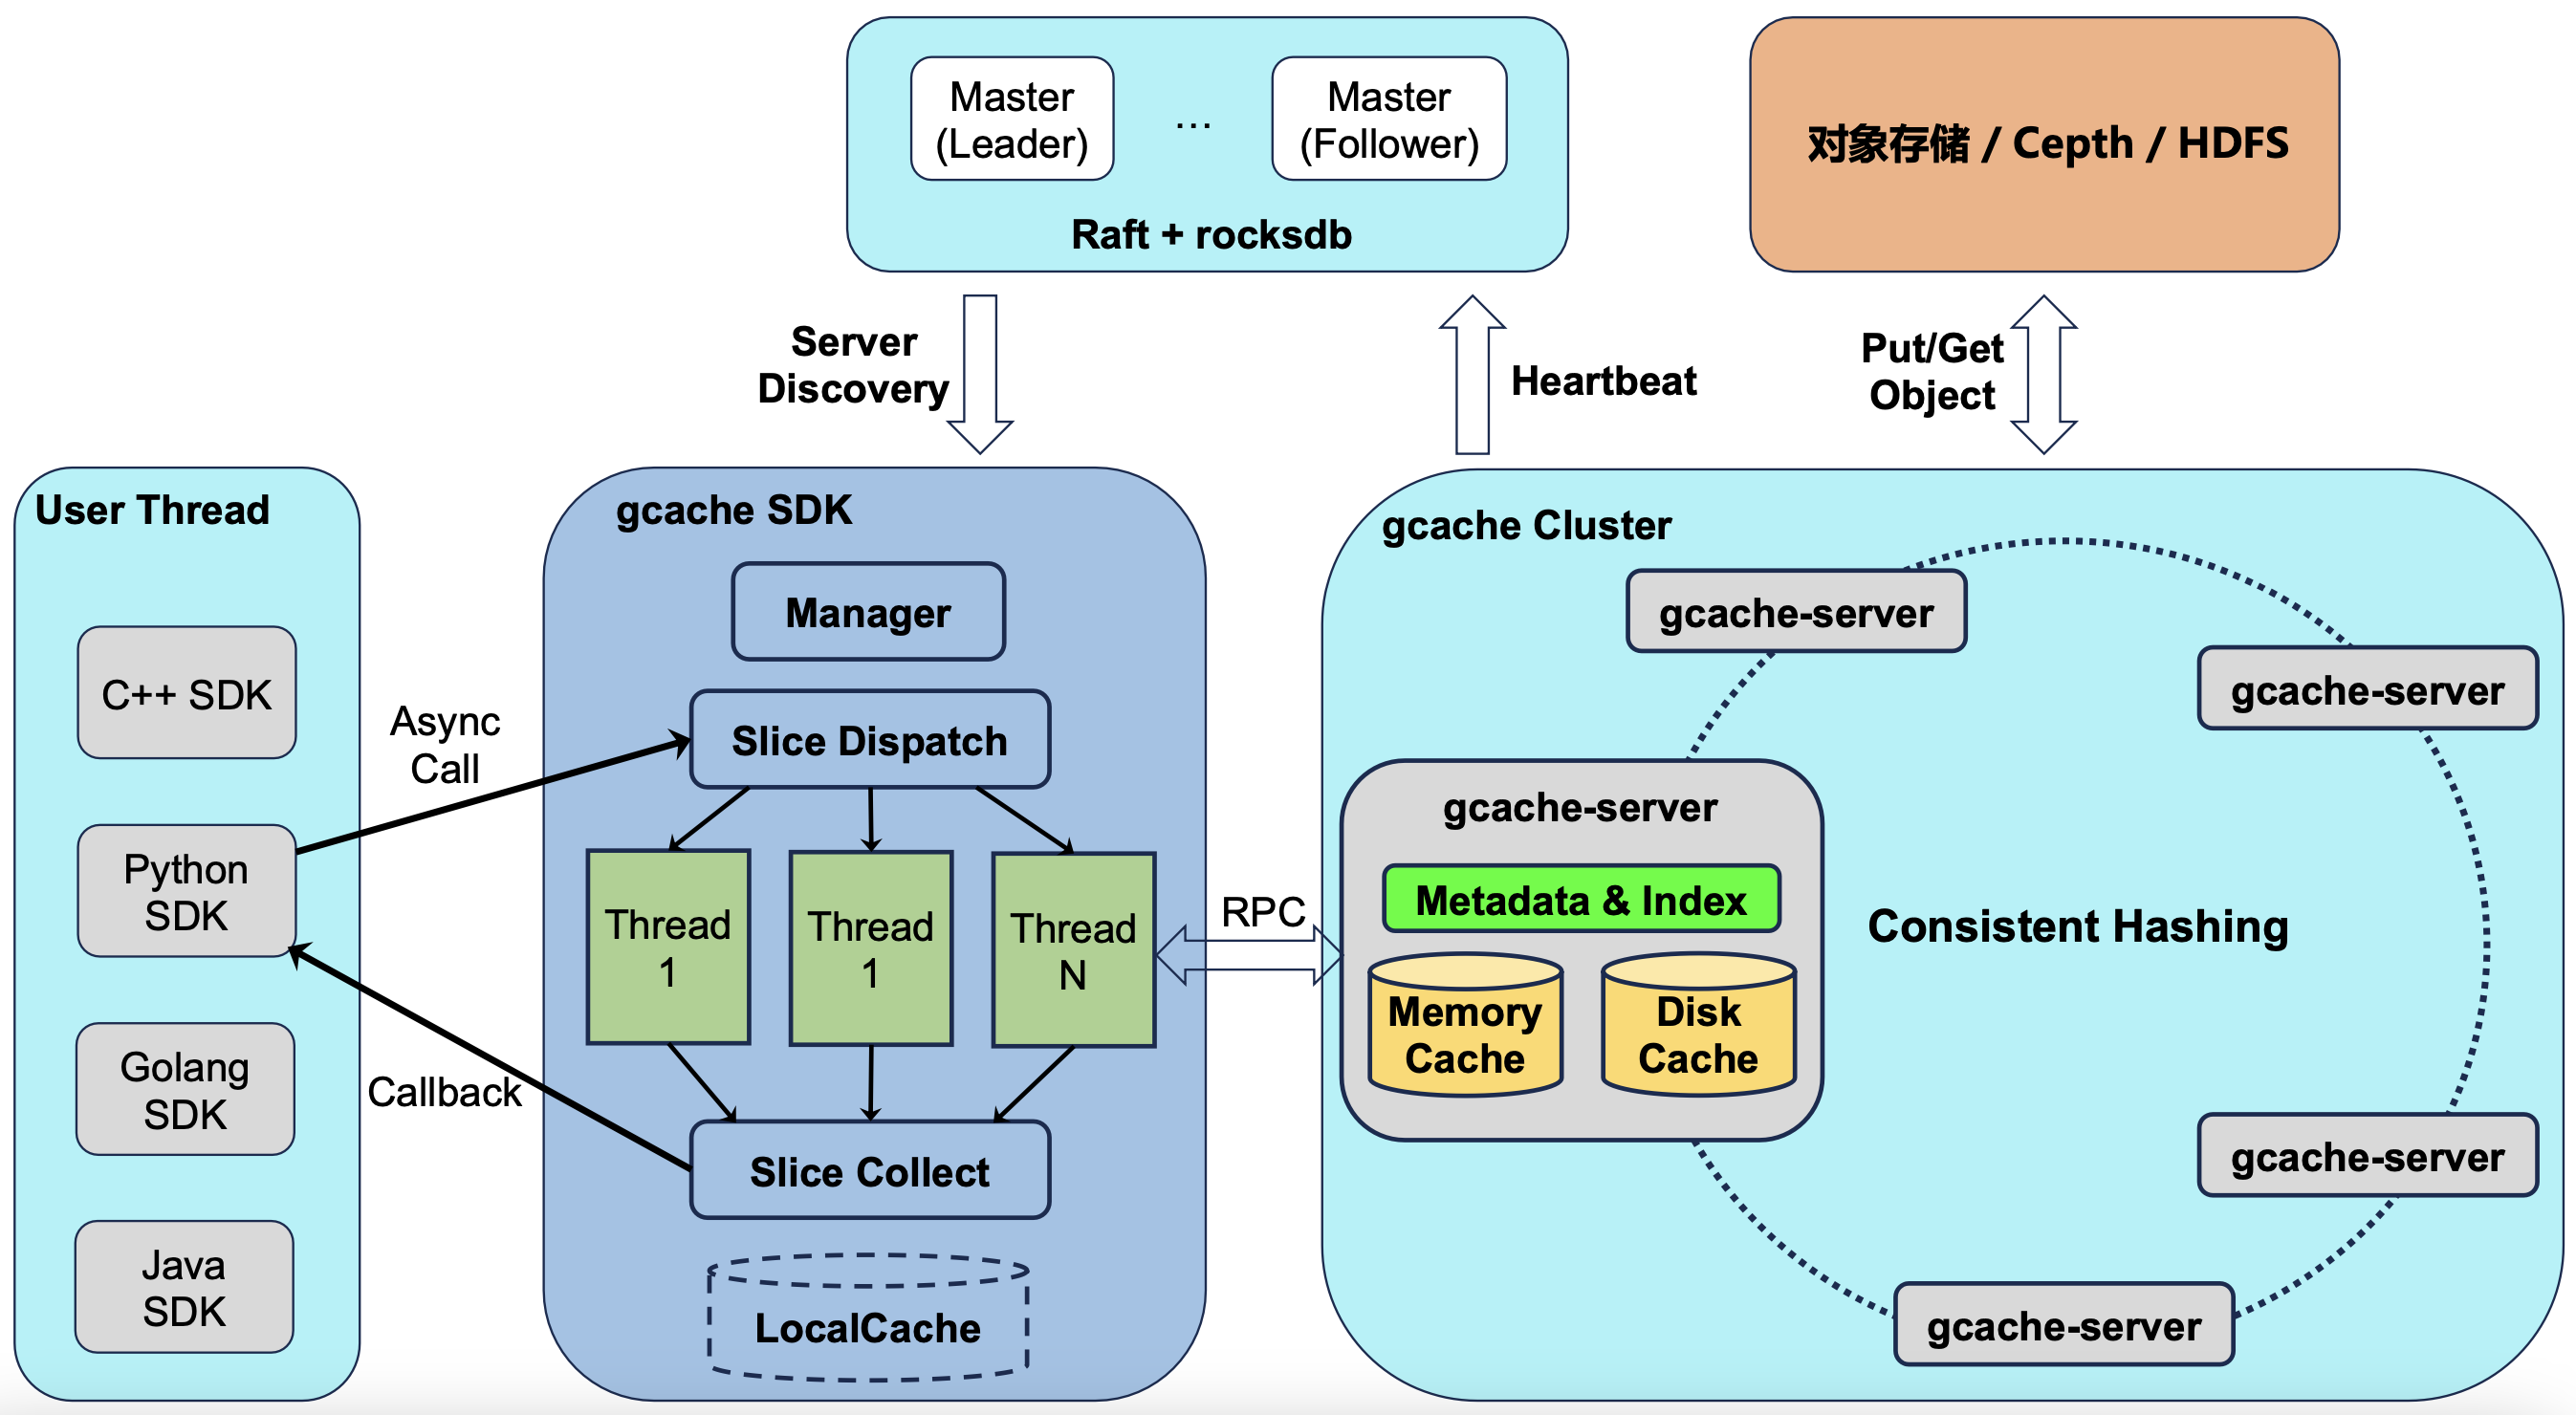
图 3:GCache 与推理节点共置在同一批 GPU 机器上,三层存储(显存/磁盘/远端)配合 RDMA 传输,Raft+RocksDB Master 负责服务发现,不需要独立存储基础设施。来源:小米 MiMo 官方博客。
生产实测:平均 KV cache 命中率 93%,长期用户 95% 以上。这个数字是模型架构的 7× KV 节省、SWA 感知前缀树、分层异步预取和 GCache 分布式存储共同作用的结果——任何一环缺失,数字都不会成立。
四、调度层:把命中率变成路由信号
93% 命中率的物质基础在分布式缓存,它的调度基础在路由层。
MiMo 重写了路由逻辑,核心是一个 KVCache 亲和性调度公式:
score(worker) = matchWeight × prefix_match_percentage − normalized_load
这把路由决策从”谁的队列最短”改成了”谁的缓存最匹配”。同一个请求,发给命中 30% 前缀的机器,比发给命中 5% 前缀但队列更短的机器,实际总计算成本更低。路由器本身是无状态的水平可扩展架构,KVCache 命中状态通过 Redis 集中存储,避免单机路由状态的单点失效。实测:L2 cache 命中率提升约 25%,单机输入吞吐提升约 30%[1]。
TTFT(首 token 延迟)优化沿用了同一个直觉:在队列中优先处理”实际计算 token 少”的请求——前缀命中率高的请求真正需要计算的新 token 更少,优先级更高。同时设置等待时间惩罚机制防止长请求被饿死。
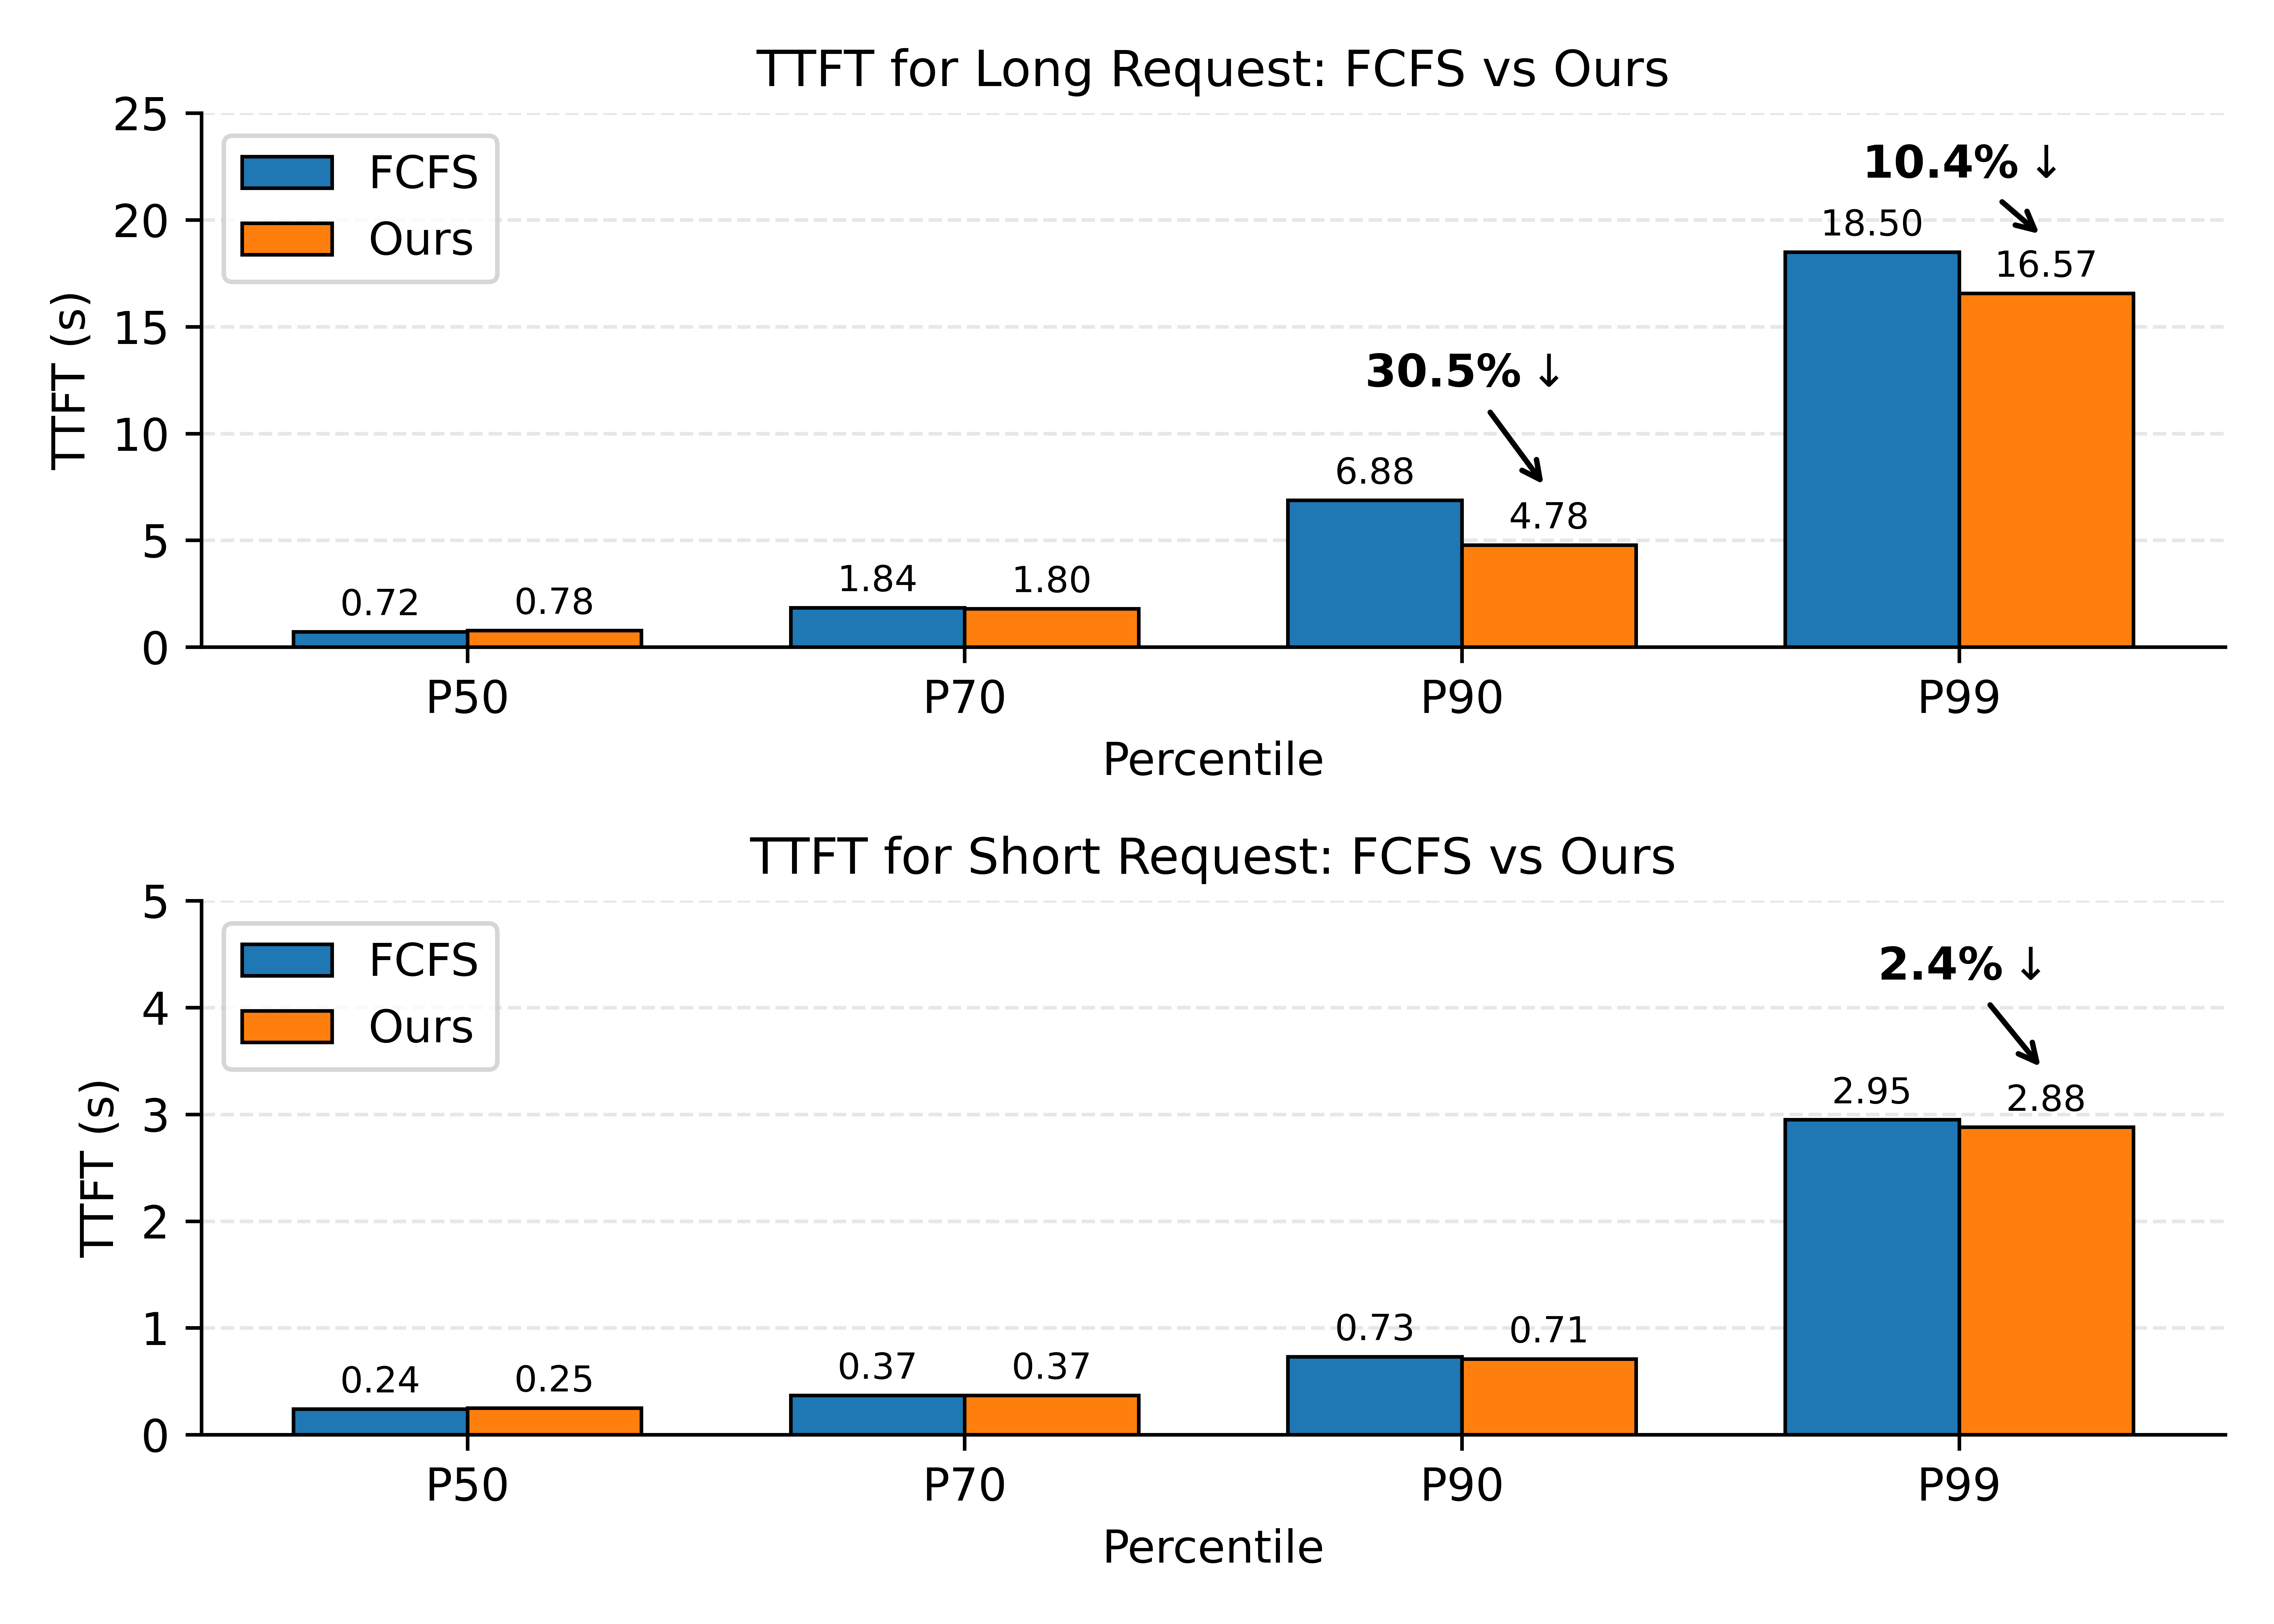
图 4:基于前缀命中率的请求优先级策略(右)与传统 FCFS(左)对比:长请求尾延迟显著改善,短请求性能保持不变。来源:小米 MiMo 官方博客。
长请求 P90 TTFT 降低了 30%,短请求性能保持不变。这个不对称改进——长请求收益大、短请求无代价——直接来自前缀命中率的分布:长请求更可能有可复用的前缀,调度优化在它们身上的发挥空间天然更大。
五、Prefill、Decode 与多模态
Prefill:SWA 的 O(W) 特性让 Expert Parallelism(EP)的通信量减半——prefill 阶段在 EP ranks 间传递的 KV 少了一半——端到端 Prefill 吞吐提升约 40%。三层长度分桶(0–64K / 64K–256K / 256K–1M)把计算量相近的请求分到同一批次,减少 DP-Attention 同步气泡和 Chunked Prefill 的干扰。MoE 本身的专家负载均衡无需额外策略:平均专家负载度 0.8495,接近均匀分布(最优为 1.0),这是训练时负载均衡目标带来的结果,不是推理层的补丁。
Decode:Decode 阶段完整支持 SWA,让 KVCache 有效容量提升约 5×——原本为 Full Attention 分配的大量连续显存,现在可以让位给更多并发请求。MTP(Multi-Token Prediction)加入了 Prefill 阶段支持,0–128 token 序列加速 2.3×,128–256 token 加速 1.5×,对短 agent 序列效果明显。
多模态:多模态的真正瓶颈在 Encoder。引入 Encoder 数据并行(TP=1 配合 DP),跨请求共享单次 Encoder 前向,GPU 图像预处理消除 CPU 瓶颈,并行图像下载通过消息队列解耦。结果:多模态 QPS 从 15 提升到 30,P90 延迟从 100.76ms 降到 82.94ms。视频处理尤其极端:1 小时视频从 156 秒降到 23 秒。加入 Encoder 数据并行之后,QPS 翻倍但平均延迟几乎不变(78.39ms → 80.28ms),这说明 Encoder 此前是一个计算孤岛:单个实例串行处理请求,利用率不高,但它确实卡住了整个多模态流水线。
六、结论
MiMo V2.5 博客记录的是一套从模型架构到生产系统的完整工程账单——告诉你 Hybrid SWA 的每一个理论优势,背后对应哪一层系统需要改什么。
Hybrid SWA 要求从头重新协商 KV cache 管理的每一个合同:双池架构让两类 KV 各走合理的驱逐路径,SWA 感知前缀树防止幽灵命中,GCache 把单机命中逻辑扩展到集群,亲和性调度把命中率转化为吞吐和延迟收益。这套改造的终点是 93% 的生产命中率——理论上的 7× KV 节省,确实在生产中转化成了可测量的服务质量改进。
几个博客没有充分回答的问题值得跟进。三层长度分桶在 1M token 上截止,超过这个边界的请求行为没有记录。SWA 感知前缀树的实际命中率与传统前缀树相比有多少损失,博客没有给出对比数字——93% 命中率是系统整体结果,不是专门针对 SWA 匹配规则修改前后的 ablation。多模态场景的 Encoder 一致性哈希调度(带来 30% 命中率提升)与语言模型侧的 KVCache 亲和调度之间如何协调,也没有展开。
MiMo 团队承诺把部分优化回馈 SGLang 社区(issue #24945)[1]。Hybrid SWA 在生产中的工程经验,目前公开记录最完整的是这篇博客;如果这些实践能进入开源推理框架,混合注意力架构的 serving 系统会少走一段摸索期。
参考资料
[1] MiMo-V2.5 Inference Optimization: Hybrid SWA + MoE + Multimodal at Scale
[2] DeepSeek-V4 on Day 0: From Fast Inference to Verified RL with SGLang and Miles
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。