MiniMax M3 发布稿最值得读的地方,是 MiniMax 把三个过去经常分开讨论的能力放进了同一个产品承诺里:frontier coding / agentic work、1M token context、native multimodality[1]。如果这些能力在后续开源权重和技术报告里成立,M3 的意义会超过“国产 open-weight 模型追上闭源模型”这类叙事。它更像是在回答一个工程问题:长程 agent 到底需要怎样的底座模型,才能避免把上下文、视觉输入和工具轨迹拆成三套系统来维护。
边界也要先摆出来。2026 年 6 月 1 日这篇文章发布时,MiniMax 说技术报告和对应模型权重会在未来 10 天内发布[1]。所以目前可读的是官方披露、API / Token Plan 信息和 benchmark methodology;还不能把 MSA 的所有质量-效率权衡当成可独立复现实验结论。
一、MSA 把长上下文从规格变成执行路径
M3 的技术抓手是 MiniMax Sparse Attention(MSA)。官方给出的数字很硬:在 1M context 长度下,M3 每 token 计算量是上一代模型的 1/20,prefill 阶段提速 9x 以上,decode 阶段提速 15x 以上;在 M3 的 head 配置下,官方称其 operator 路径比 open-source Flash-Sparse-Attention 和 flash-moba 快 4x 以上[1]。
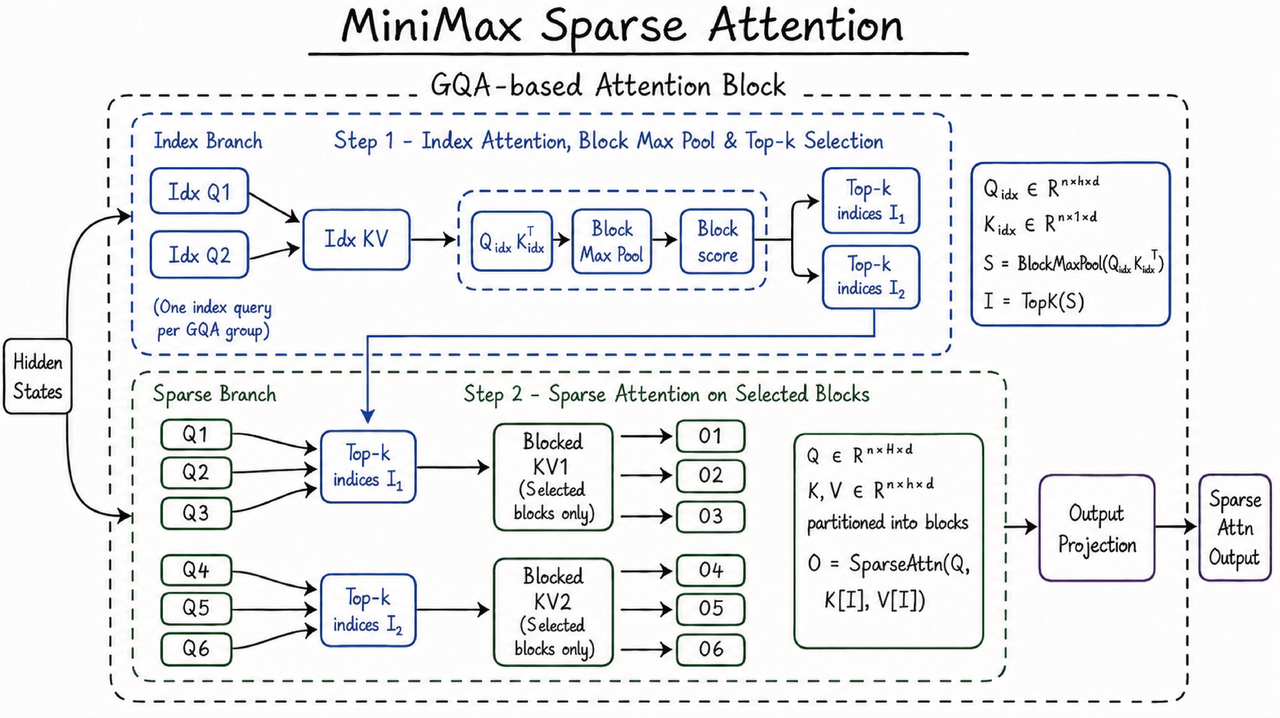
图 1:MSA 把 attention block 分成 Index Branch 和 Sparse Branch:前者用 index query / index KV 做 block score 与 Top-k 选择,后者只在选中的 KV blocks 上执行稀疏 attention。图源:MiniMax 官方博客。
这张图真正有信息量的地方在两层。第一层是 index branch:每个 GQA group 只有少量 index query,先对 block 做粗筛,得到 Top-k block indices。第二层是 sparse branch:普通 Q 不再看完整 KV,而是只读被选中的 blocked KV。MiniMax 特别强调了 operator 侧的实现选择:采用 “KV outer gather Q”,也就是以 KV block 为外循环,把命中同一 block 的 queries 聚合起来处理。长上下文稀疏注意力的瓶颈不只在“少算哪些 token”,还在“被选中的 token 能不能被连续、低开销地读出来”。
这和过去一批 hybrid / sparse attention 工作的系统含义接得上。长上下文进入 agent 产品的前提,是 200K、512K、1M token 处 prefill、decode、KV residency、prefix reuse 和 kernel dispatch 仍然处在可承受范围内。M3 这次把 MSA 放在发布稿第一部分,说明 MiniMax 已经把 context scaling 当作模型架构问题,serving 侧事后补丁已经不够用了。
但 MSA 还有两个需要等技术报告回答的问题。第一,官方只说多组 ablation 中 MSA 在绝大多数能力上匹配 full attention,具体在哪些长文档检索、数学推理、代码仓库理解、多模态视频场景掉点,还没有完整表格。第二,MSA 的 block 选择和模型训练是绑定的,推理框架如果要高效支持,必须理解它的 KV layout、index branch 和 sparse kernel 形态。1M context 的产品化收益,最终会落到模型架构、kernel 和 serving runtime 的共同适配上。
二、M2.7 是 M3 的对照组:同一个 Agent 目标,两种上下文成本
把 M3 和 M2.7 放在一起看,会发现 MiniMax 的主线并没有突然改变。M2.7 发布时,MiniMax 已经把重点放在 agent harness、自我进化、复杂软件工程和办公生产力上:官方说 M2.7 能构建复杂 agent harness,使用 Agent Teams、复杂 Skills 和动态工具搜索,并在开发 M2.7 的过程中让模型更新自己的 memory、构建数十个复杂 skills、根据实验结果改进学习流程和 harness[3]。M2 系列技术报告也把这条线写得很直白:M2 rests on agent-driven data pipelines、Forge agent-native RL system,以及 M2.7 checkpoint 的 self-evolution 能力[4]。
M3 延续了 M2.7 已经打开的 agent 叙事,真正的变化在底层成本结构。M2.7 是一个文本 MoE 模型,NVIDIA 给出的部署摘要是 230B total parameters、10B active per token、256 experts、200K context、62 layers[5]。Hugging Face config 进一步显示,M2.7 的 attn_type_list 全部为 1,num_hidden_layers=62、num_key_value_heads=8、head_dim=128、max_position_embeddings=196608[6]。换成 KV cache 语言,这是一条很传统的全注意力 GQA 曲线:稳定、好支持,但上下文越长,系统账单线性上涨。
M3 的 MSA 正是在这条曲线上开刀。M2.7 证明 MiniMax 已经把 agent 数据、harness 和自我改进流程跑起来;M3 要证明的是,同样的长程 agent 负载可以被推到 1M context、图像/视频输入和 computer use 上,同时不让 prefill、decode 和 KV residency 成为无法承受的成本。M2.7 像是“agent 能力优先”的一代,M3 则把“agent 成本曲线”也放进模型架构本身处理。
这也解释了为什么 M3 发布稿会强调 native multimodality。M2.7 的强项是文本、代码、Office、复杂技能和 agent team;M3 把论文图表、视频帧、桌面状态也纳入同一个模型面。对开发者来说,二者的选择边界会很实际:如果任务主要是 200K 以内的文本/代码 agent,M2.7 已经有成熟 open-weight 生态、vLLM/SGLang/NVIDIA 路径和既有部署经验;如果任务要把整仓代码、长日志、图表、视频或电脑操作塞进一个长程 agent loop,M3 的 1M MSA 和多模态才是新增变量。
三、Coding Benchmark 只是入口,长程轨迹才是主战场
官方给出的 coding / agentic benchmark 数字很集中:SWE-Bench Pro 59.0%,Terminal-Bench 2.1 66.0%,SWE-fficiency 34.8%,KernelBench Hard 28.8%,MCP Atlas 74.2%[1]。模型页还补充了 BrowseComp 83.5,高于 Opus 4.7 的 79.3[2]。
这些数字能说明 M3 进入了 coding agent 的第一梯队,也说明 M3 相比 M2.7 有明确增量:M2.7 官方披露的 SWE-Pro 是 56.22%,Terminal Bench 2 是 57.0%,NL2Repo 是 39.8%[3];M3 在新发布稿中给出的 SWE-Bench Pro 是 59.0%,Terminal-Bench 2.1 是 66.0%[1]。跨 benchmark 版本不能机械相减,但方向很清楚:MiniMax 没有为了 1M context 和稀疏注意力牺牲 coding agent 主线。
更关键的是 MiniMax 对 benchmark 缺口的判断:真实 coding 使用通常是持续协作,用户会澄清需求、改方案、跨上下文分派任务、基于中间结果迭代。为此他们构建了 interactive user simulator,让训练和评测更接近真实协作过程[1]。
这个方向很重要。代码 agent 的难点已经从“会不会生成一段函数”转向长程执行链路:能不能在 50 次工具调用后还记得目标,能不能从失败测试恢复,能不能在上下文变长时保留关键状态,能不能把用户新要求并入已有计划。MiniMax 把 M3 的 1M context 和 coding / agent training 放在同一个叙述里,等于承认了一件事:agent 能力依赖上下文预算、工具轨迹和多轮协作数据共同训练出来,代码生成只是其中一层。
四、两个真实任务比榜单更能说明 M3 的产品野心
官方展示的两个长程任务,一个偏研究复现,一个偏系统优化。
第一个是让 M3 独立复现 ICLR 2025 Outstanding Paper《Learning Dynamics of LLM Finetuning》。M3 连续运行近 12 小时,产生 18 个 commits 和 23 张实验图,完成核心实验复现;官方强调,多模态用于理解论文里的曲线、数据和公式,长上下文用于同时容纳论文、代码和实验日志,coding / agent 能力用于推进长线程执行[1]。
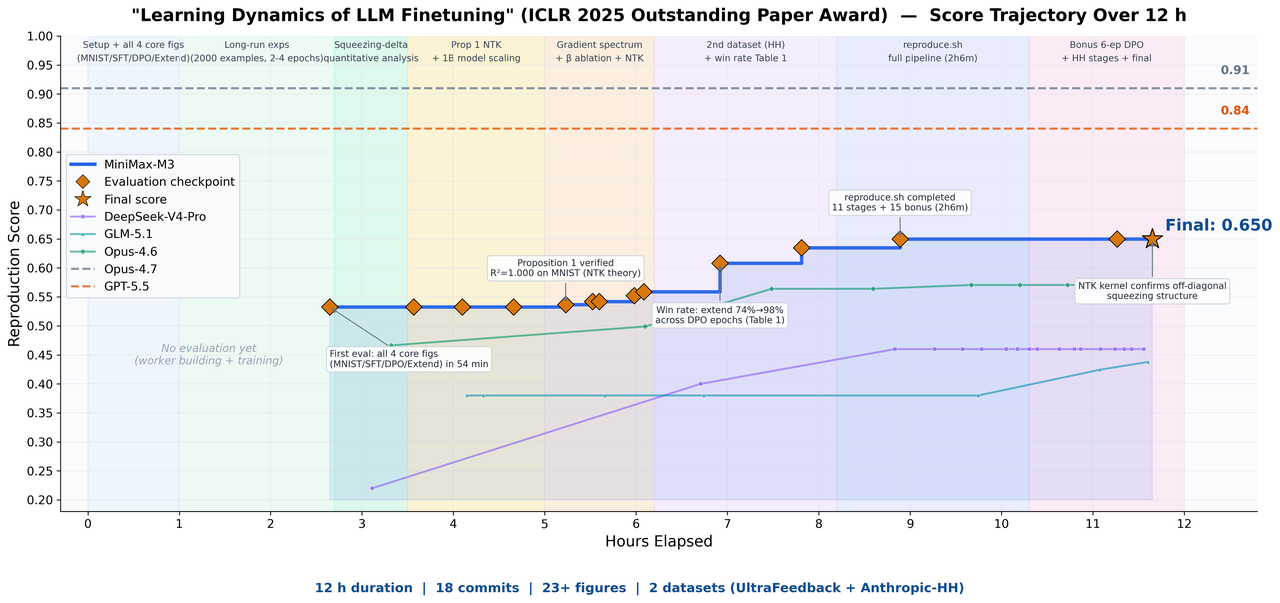
图 2:M3 在 12 小时论文复现任务中的 score trajectory。这个案例把论文阅读、实验代码、日志解释和结果验证放在同一个长程上下文里。图源:MiniMax 官方博客。
第二个是 FP8 GEMM kernel 优化。任务起点很苛刻:只有任务描述、benchmark 脚本和一个不能直接运行的 Triton skeleton,没有可抄的高性能实现。M3 在约 24 小时 内完成 147 次 benchmark submissions 和 1,959 次工具调用,从 baseline 实现、autotune 配置、瓶颈诊断一路推进到 CUDA Graph、persistent kernel 和 host 侧调度优化,最后把 Hopper FP8 峰值利用率从 7.6% 推到 71.3%,相对原始版本 9.4x 提速[1]。
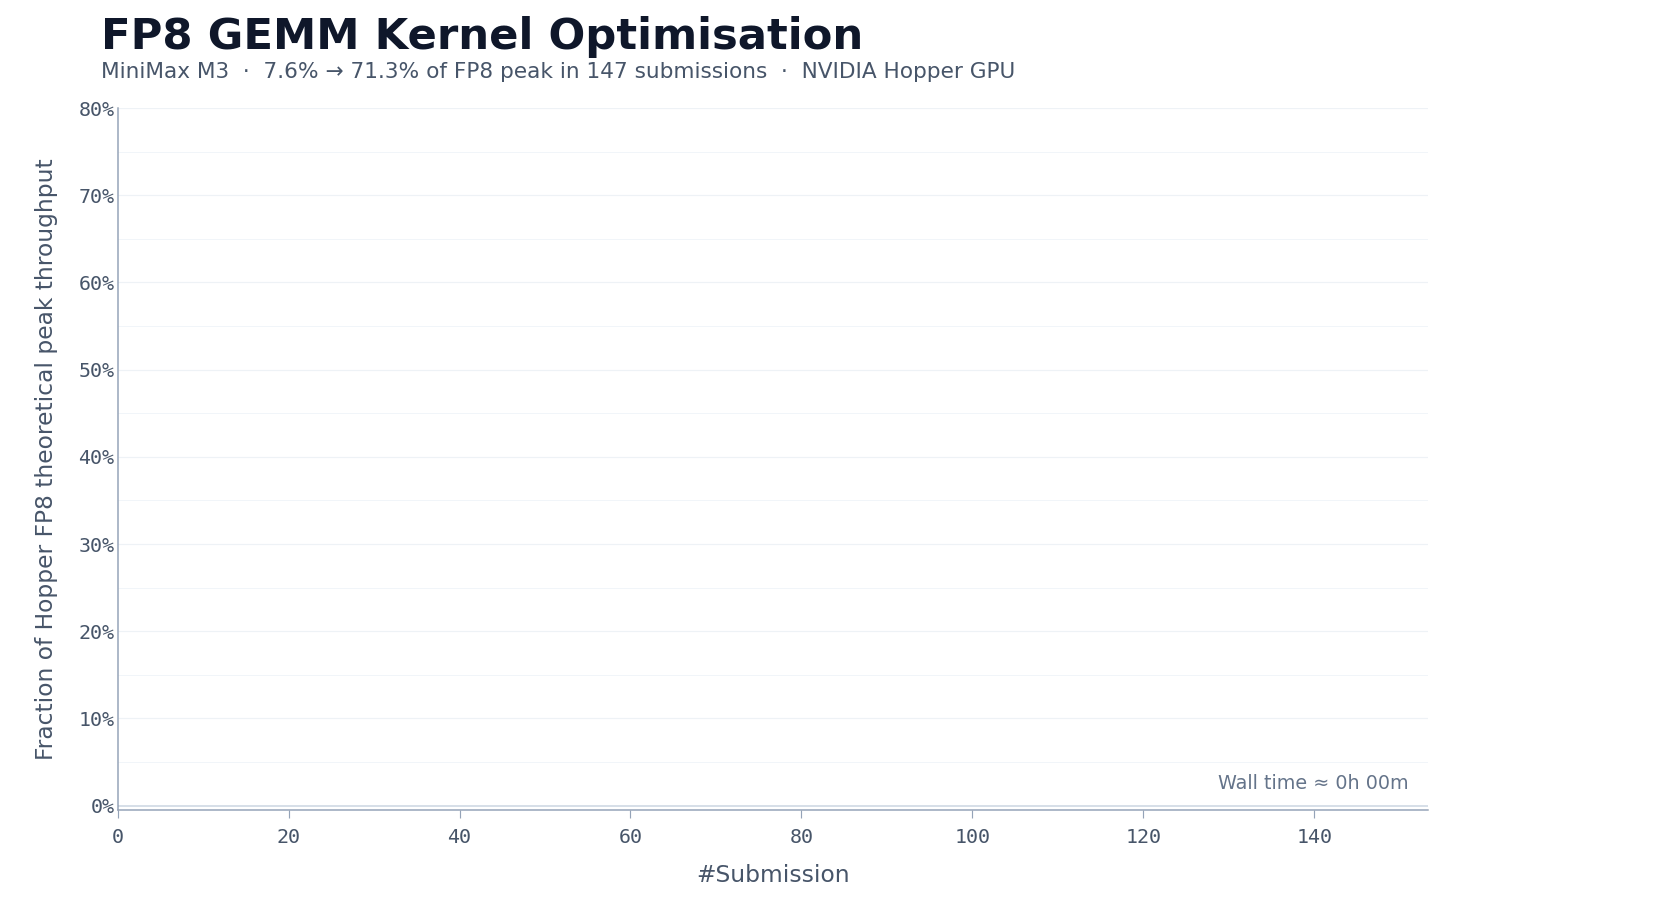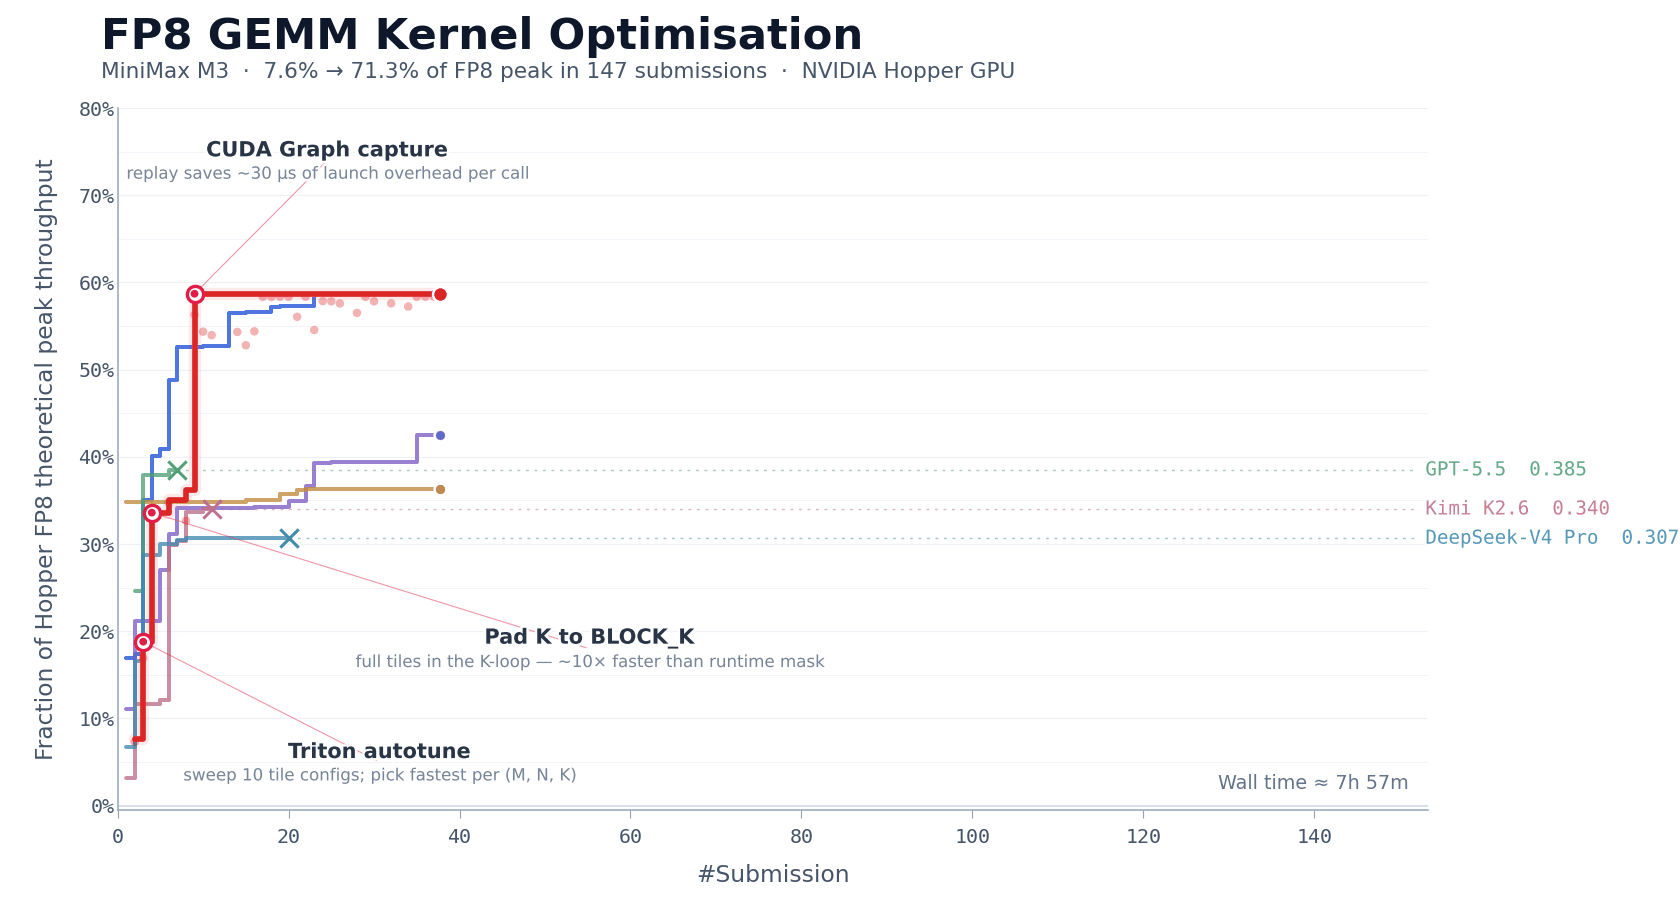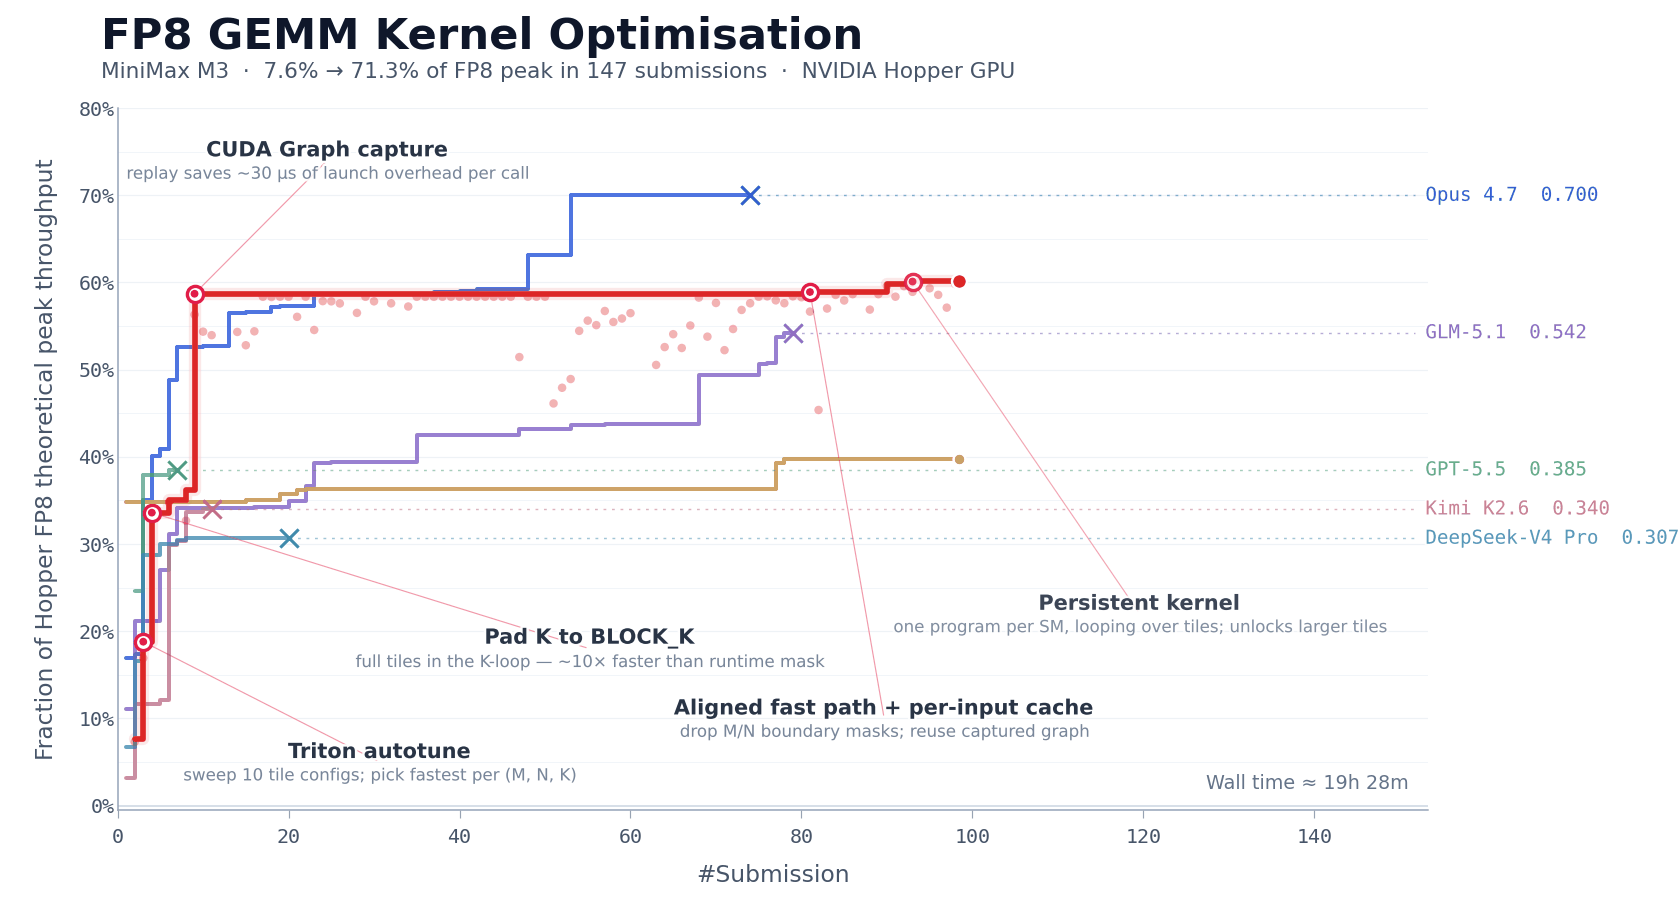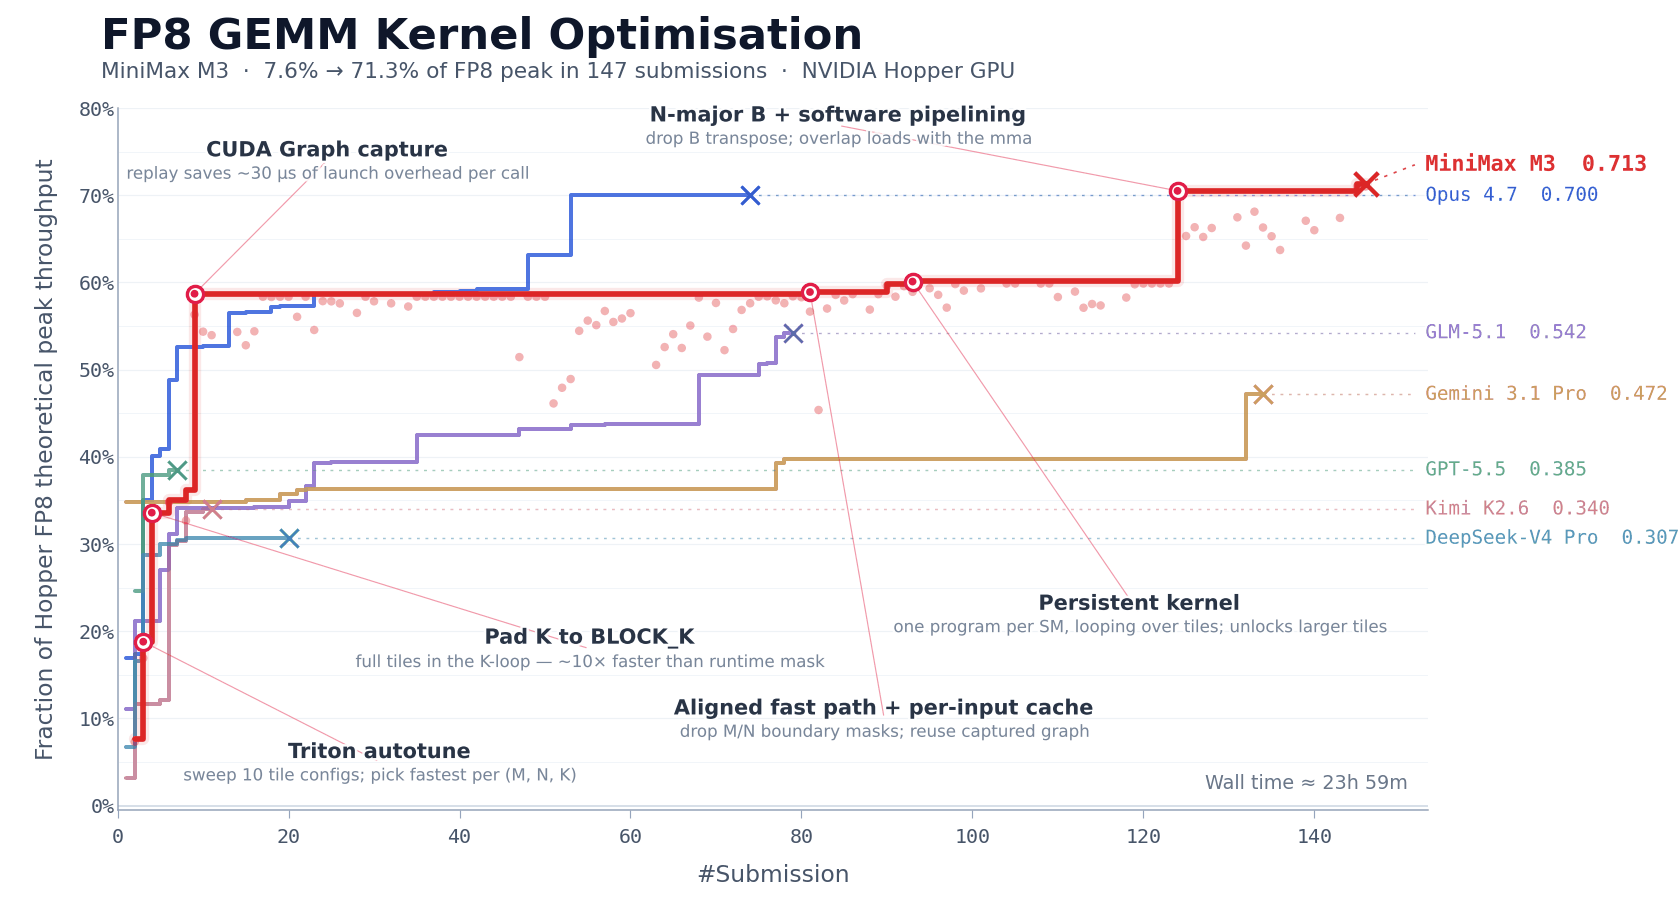
图 3:M3 在 FP8 GEMM kernel 任务里的迭代轨迹。官方特别指出,M3 的最佳解出现在第 145 次提交附近,说明长程探索没有在早期 plateau 后停止。图源:MiniMax 官方博客。
这两个例子的共同点是反馈很密。论文复现里,模型要读图、写代码、跑实验、解释曲线;kernel 优化里,模型要从 benchmark 数字判断下一步改哪里。工具调用历史在这里是一套高密度执行日志,普通聊天记录的缓存直觉已经不够用了。MSA 对长上下文的价值在于保留长程 agent 反复行动后的关键状态,文本容量只是表层收益。
五、多模态被放进同一个 Agent 面
M3 从 step 0 开始做 mixed-modality training,MiniMax 说他们重建了 interleaved data pipeline,把训练数据扩到 100T tokens 量级[1]。这个信息比“支持图片和视频输入”更关键,因为 agent 工作流里的多模态很少是孤立图片问答。真实任务更像这样:读一篇带图表的论文,打开一个网页或 ERP 客户端,理解屏幕状态,根据 Excel 或 PDF 继续操作。
MiniMax Code 的描述也沿着这条线展开:Agent Team 能把大任务拆成多阶段、并发、动态调整的 workflow,通过 Producer + Verifier harness loop 持续产出、反思和纠错;原生多模态让它支持 computer use,例如根据 Excel 批量录入本地 ERP 客户端[1]。
这里的工程含义很直接。多模态如果只是一个旁路 VLM,agent 每次遇到截图、图表、视频帧都要做跨模型交接;长程上下文如果只存在于文本模型里,视觉信息又会在交接时变成压缩摘要。M3 想走的路线是把文本、视觉、工具轨迹和长程计划放进同一个模型空间。这会减少系统拼接成本,也会把失败责任集中到同一个模型-harness 组合上。
六、发布当天最该保留的怀疑
MiniMax 的 evaluation methodology 很长,也很有必要读。很多 benchmark 是内部基础设施复测:SWE-Bench Pro 使用 Claude Code scaffolding,并与官方逻辑对齐;Terminal-Bench 2.1 使用 8C16G sandbox、2 小时 timeout、128K max output tokens;VIBE-V2、SVG-Bench、DRACO 等还涉及内部 benchmark、内部 pipeline 或指定 scoring model[1]。
这些数字仍然有价值。MiniMax 至少把 sandbox、timeout、scaffolding、重复次数、judge model 等关键设置列了出来,读者能判断它们测的是“模型 + harness + 评测环境”的组合能力。问题在于,agent benchmark 天生很难把模型能力和 scaffold 能力分离。M3 的不少结果运行在 Claude Code、Mini-SWE-Agent、Terminus 2 或内部框架上,MiniMax Code 本身又是为 M3 共同训练和设计的 agent 产品。这类成绩更适合被解读为系统能力信号,纯模型能力排名反而会遮蔽 harness 的贡献。
另一个怀疑点在 open-weight 承诺上。模型页写到 M3 将在 Hugging Face 和 GitHub 完整开源,支持私有集群部署和 fine-tuning[2];发布稿说未来 10 天发布技术报告和模型权重[1]。在权重、技术报告、serving 参考实现、MSA kernel 细节都出来之前,M3 的工程可迁移性还缺一块关键证据。M2.7 已经有开源权重、Hugging Face config、NVIDIA NIM、vLLM 和 SGLang 部署路径;M3 在发布当天还停留在 API 和承诺阶段。对 infra 团队来说,真正的问题会很朴素:能不能在自己的推理框架里跑稳 512K / 1M,上下文越长时 P99 怎么变,MSA 的稀疏选择会不会给 KV cache routing 和 prefix reuse 带来新约束。
七、结论:M3 把 open-weight Agent 的成本问题推到台前
MiniMax M3 的发布信号可以压缩成一句话:open-weight 模型开始把 1M 长上下文、长程 coding agent 和原生多模态作为同一个工作负载来优化。 这比单项 benchmark 更有意义,因为 agent 产品真正消耗的是长上下文、工具调用、视觉输入、反复验证和失败恢复组成的整条轨迹。
和 M2.7 对比后,这个判断更具体。M2.7 已经证明 MiniMax 可以把 open-weight MoE 模型推向 agent harness、自我进化和复杂工程任务;M3 试图把同一条路线扩展到 1M context 和原生多模态。从 M2.7 到 M3,MiniMax 的问题意识从“如何让模型参与生产力工作流”推进到“如何让长程多模态 agent 的上下文成本可承受”。
后续最该追四件事。第一,技术报告里 MSA 的质量损失、ablation 和训练方式是否足够清楚。第二,开源权重出来后,社区能否复现 512K / 1M context 的速度和稳定性。第三,MiniMax Code 的 harness 如果开源,Producer + Verifier、Agent Team 和动态 workflow 到底怎样落地。第四,主流 serving runtime 是否需要为 MSA 单独做 KV layout、sparse kernel、prefix cache 和调度适配。
如果这些环节都接上,M3 的价值会从“又一个强模型”变成“open-weight agent 工作负载的成本曲线被重新定价”。如果接不上,它仍然是一篇信息量很高的发布稿,但 infra 团队会继续等待可复现实验和可部署实现。
参考资料
[1] MiniMax M3: Frontier Coding, 1M Context, Native Multimodality — All in One Model
[2] MiniMax M3 - Coding & Agentic Frontier, 1M Context, Multimodal
[3] MiniMax M2.7: Early Echoes of Self-Evolution
[4] The MiniMax-M2 Series: Mini Activations Unleashing Max Real-World Intelligence
[5] MiniMax M2.7 Advances Scalable Agentic Workflows on NVIDIA Platforms for Complex AI Applications
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。