版本历史
版本 日期 说明 v1.0 2026-05-28 初稿,基于 DeepSeek-V4 Technical Report(2026-04-24 发布版)分析 CSA/HCA 混合注意力架构 v1.1 2026-05-30 修订更新:校正 DeepSeek-V3.2 与 PrfaaS 引用、V3.2/GQA8 baseline 口径、CSA top-k、KV cache 数字和定价表述
在 1M token 的上下文窗口下,DeepSeek-V4-Pro 相比 DeepSeek-V3.2 只需要 27% 的单 token 推理 FLOPs 和 10% 的 KV cache;V4-Flash 进一步降到 10% FLOPs 和 7% KV cache[1]。若换成更通用的 BF16 GQA8、head_dim=128 baseline,DeepSeek-V4 系列的 KV cache 约为该 baseline 的 2%。这不是调参换来的增量收益——这是架构级选择直接带来的物理结果。用 DeepSeek 团队的原文说,这套选择背后是把注意力拆成两个相互补充的机制并在层间交替部署:Compressed Sparse Attention(CSA)和 Heavily Compressed Attention(HCA)。
这篇文章不是一篇”V4 发布了什么”的公告综述。我想回答一个更具体的问题:为什么是”压缩 + 稀疏”而非”纯稀疏”或”纯 dense”,这个选择是在什么样的工程约束下做出的,以及它对我们理解注意力架构的演进方向意味着什么。理解这条逻辑线比记住 2% 这个数字更有价值——因为同样的权衡会在下一批模型中重演。
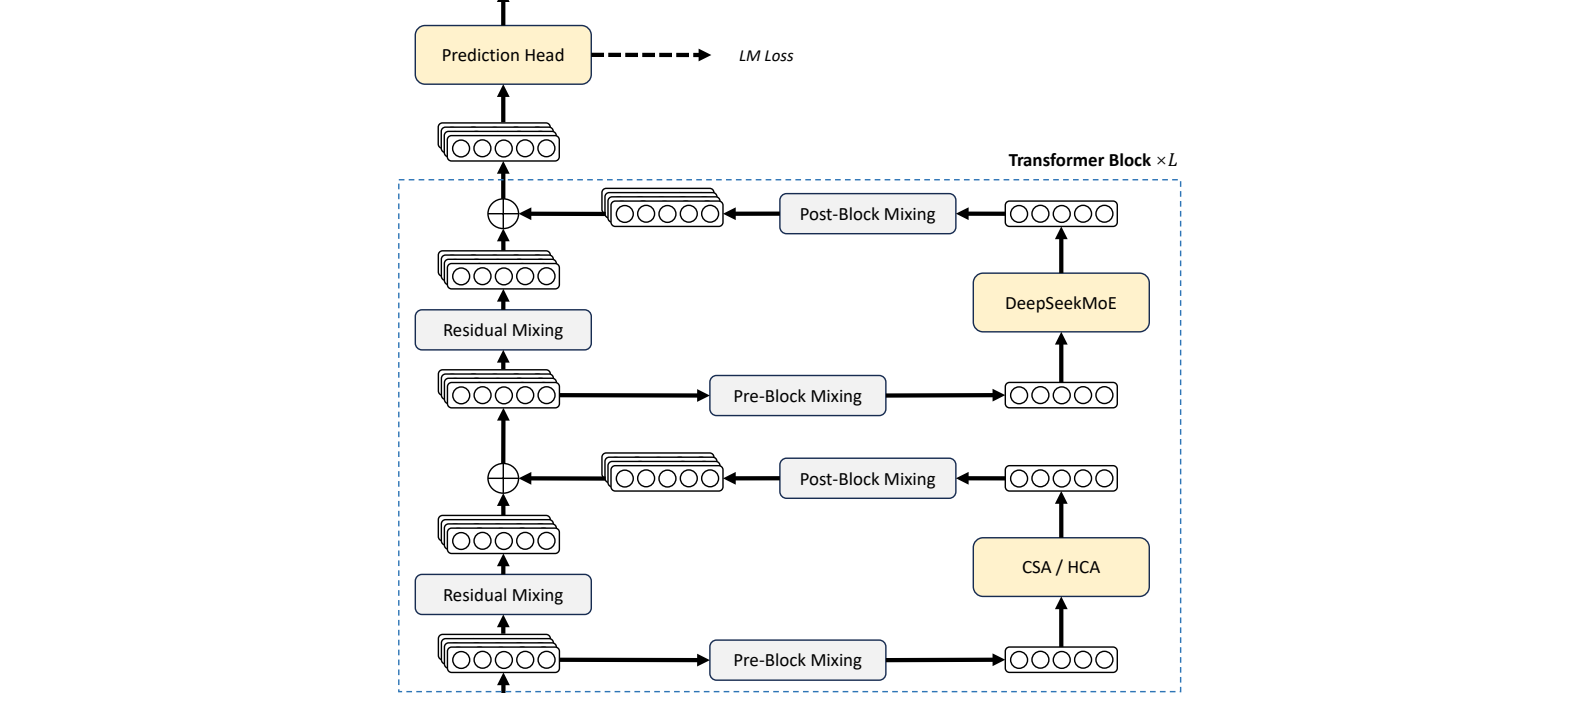
图 1:V4 的整体架构。注意力层在 CSA 和 HCA 之间交替,前馈层用 DeepSeekMoE,残差连接升级为 manifold-constrained hyper-connections(mHC)。来源:DeepSeek-V4 Technical Report Figure 2。
一、1M context 的物理账单:为什么 dense attention 已经走到头了
先算一笔账。在标准 GQA-8、BF16 存储格式下,1M token 上下文的 KV cache 是多少?KV cache 大小 = 2 × num_layers × num_kv_heads × head_dim × seq_len × 2 bytes(BF16)。以 LLaMA 3 70B 的参数架构(80 层、8 KV 头、128 head_dim)来算,这大约是 2 × 80 × 8 × 128 × 1M × 2 ≈ 327 GB。一张 H200 的 HBM 是 141GB。在这个口径下,仅 KV cache 就已经超过单卡容量——即使你用 GQA 把 KV 头压到 8 个。
这不是一个”可以通过工程优化改善”的问题,这是一个硬件约束直接压到模型结构上的问题。所以过去两年注意力架构优化的主线其实很清楚:不是只让 O(N²) 的 exact attention 算得更快,而是同时降低 prefill 计算、decode 每步扫描长度,以及 KV cache 的常数项。
三条路线平行演进过来了:
MLA(Multi-head Latent Attention) 走的是 KV 结构压缩路线。DeepSeek-V2 用低秩 KV 压缩矩阵把 KV cache 压到原版的 6.7%(压缩 93.3%),吞吐提升 5.76x[2]。这条路线的好处是精度损失可控——低秩近似有一个成熟的数学框架做支撑——但压缩率的上限由秩决定,秩太低会系统性丢失信息。
稀疏注意力 走的是选择性计算路线。DeepSeek-V3.2 的 DeepSeek Sparse Attention(DSA)用轻量级 indexer 对每个 query 选出最重要的 token 子集,只对这些子集做 attention[3]。这条路线的好处是保留了原始 token 的精确 representation——你看到的 token 没有被压缩过——但”选出最重要的子集”本身就需要额外的前向计算,而且对于某些需要全局视野的任务,稀疏选择可能会漏掉关键信息。
压缩注意力 走的是另一条路。Kimi Linear 采用 3:1 的 KDA-to-MLA 层间混合,把大多数层换成固定状态的线性注意力,同时保留周期性的 MLA 全局层来维持全局信息流;论文给出的结果是 KV cache 使用量最高降低 75%,1M context decode 吞吐最高提升 6x[4]。PrfaaS 工作从 serving 系统侧补上了另一组数字:在 8×H200 上,Kimi Linear 的 KV throughput 约 4.66 Gbps,而 MiniMax-M2.5 这类 GQA dense 模型约 59.93 Gbps,约为 13x 差距[5]。这说明 hybrid attention 降低 KV throughput,不只是模型效率问题,也是跨数据中心 prefill serving 能不能成立的物理前提。
V4 的不同之处在于:它不是在这三条路线中选一条,而是把”压缩”和”稀疏”拆成两种独立的注意力模式,在层间交替部署。这个选择在直觉上不显然——为什么不干脆所有层都用同一种最高效的模式?答案在下一节。
二、CSA:4:1 压缩域上的稀疏选择
CSA 的核心思路可以概括为三步:先压缩、再选择、最后只对选中的做 attention。
第一步:压缩。 每 4 个连续 token 的 KV 被”折叠”成一个压缩表示。折叠的方式不是简单的平均值——它是一个 softmax-gated 池化,带学习的 positional bias。这意味着模型学会了”哪些 token 的哪些维度在压缩时更值得保留”,而不是均匀地把 4 个 token 的信息揉在一起。压缩后,序列长度从 N 变成了 N/4。
第二步:稀疏选择。 在压缩后的 KV 上,一个叫 lightning indexer 的模块为每个 query 头打出一个相关性分数。indexer 对压缩后的 keys 做一次轻量级的 ReLU-scored multi-head dot product,选出 top-k 个压缩块:V4-Flash 取 512,V4-Pro 取 1024。关键细节:indexer 的 QK 路径用 FP4 量化,对 HBM 带宽的消耗极低。
第三步:attention。 对选中的 top-k 个压缩 block 做标准的 MQA(Multi-Query Attention),同时一个独立的滑动窗口分支覆盖最近的 128 个未压缩 token。这两个路线的结果在 softmax 前合并——同一层里既有”全局稀疏视野”(通过压缩块的稀疏选择),也有”精确局部视野”(通过滑动窗口)。
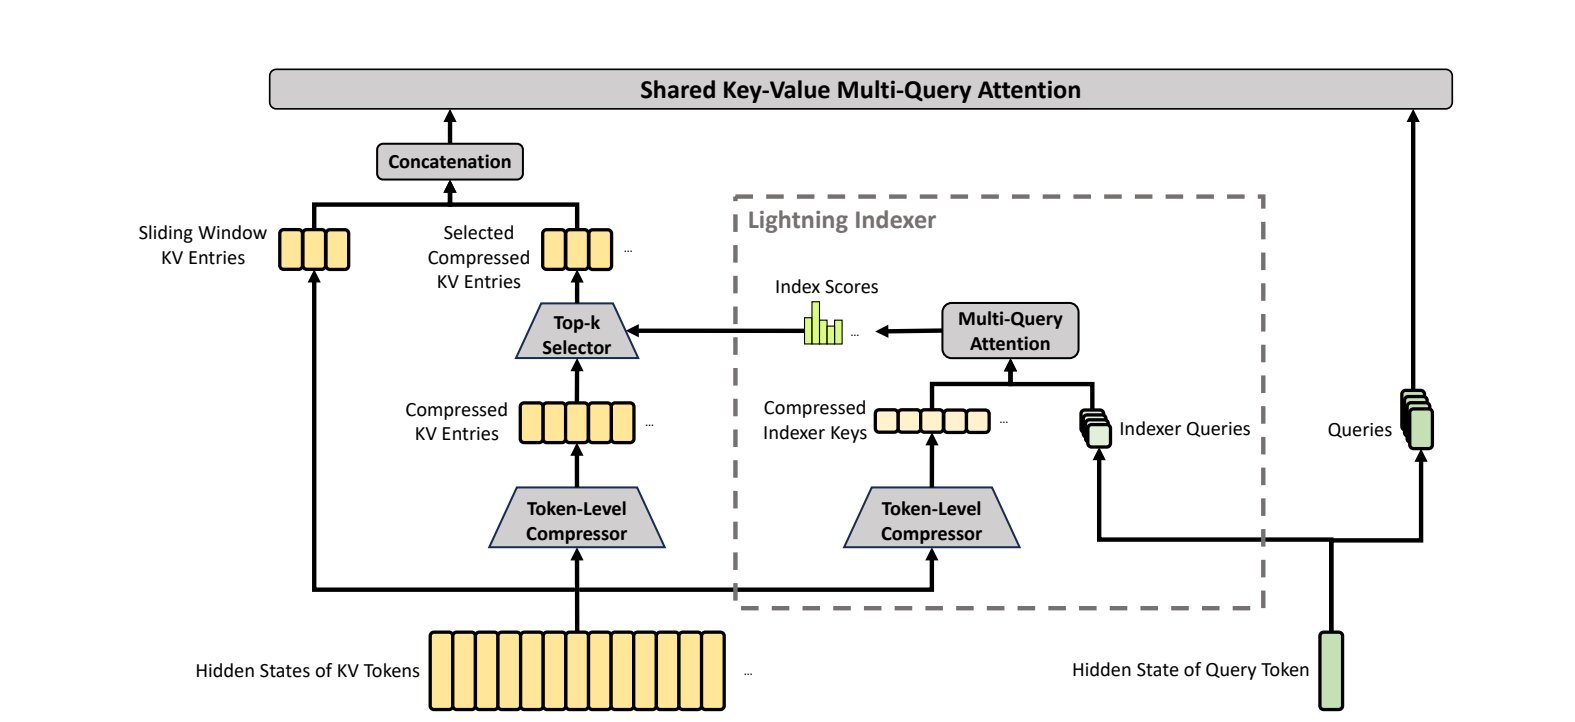
图 2:CSA 的完整流程。compressor(4:1 softmax-gated pooling with positional bias)→ lightning indexer(FP4 ReLU-scored top-k)→ 压缩域上的稀疏 attention + 滑动窗口。来源:DeepSeek-V4 Technical Report Figure 3。
CSA 的工程洞察:把稀疏选择放在压缩域上做,indexer 的搜索空间本身就缩小了 4 倍。在一个 1M token 的序列上,压缩后只有 250K 个压缩块,indexer 只需扫描压缩块而非原始 token,再从中选出 Flash 的 512 个或 Pro 的 1024 个候选块。这就是”压缩 + 稀疏”的乘法效应——不仅是 KV cache 本身变小了,连”决定看哪里”的成本也变小了。
但 CSA 不是银弹。4:1 压缩意味着每个压缩块的信息密度是原始 token 的 4 倍——当 query 需要精确区分在 4 个 token 范围内被合并的细粒度信息时,CSA 可能漏掉。这就是为什么 V4 没有在所有层都用 CSA。
三、HCA:拿精度换全局视野的极致压缩
HCA 在理念上和 CSA 截然不同。如果 CSA 是”压缩后精选”,HCA 就是”压缩后全看”。
压缩比从 4:1 跳到 128:1。每 128 个连续 token 被折叠成一个压缩块。128x 压缩意味着一个 1M token 的序列压缩后只剩约 8K 个压缩块——这个规模下,密集注意力是可行的。HCA 在压缩域上做标准的 MQA,每个 query 不对任何 token 做稀疏选择——它对整个压缩序列”全看”。
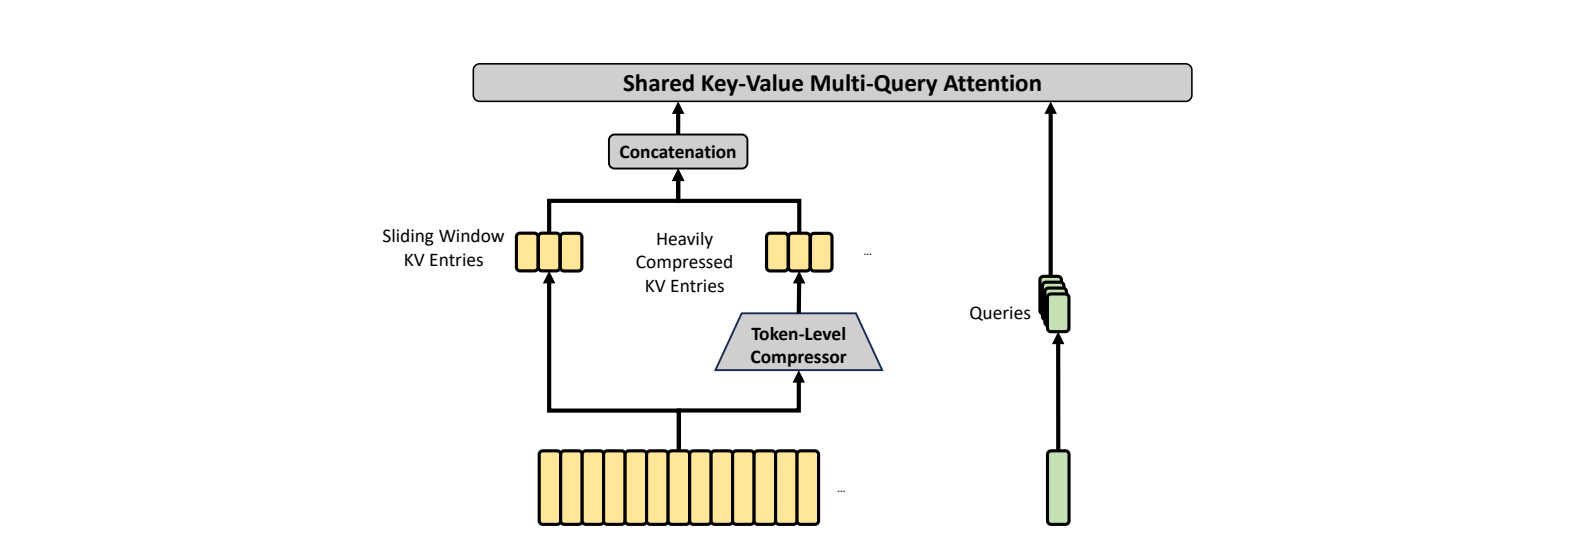
图 3:HCA。128x 的 heavy compressor 后做密集 MQA——压缩序列足够短,dense attention 的计算量可忽略。滑动窗口分支补充局部精度。来源:DeepSeek-V4 Technical Report Figure 4。
为什么需要 HCA:128x 压缩的信息损失是巨大的——单个压缩块覆盖了 128 个 token 的语义,几乎不可能保留细粒度的 token 间关系。但 HCA 提供的是 CSA 无法提供的东西:对全局上下文的完整视野。CSA 的 top-k 选择永远看的是”最重要的一小组压缩块”,这些块之外的任何信息对 CSA 来说都不存在。但 HCA 的 8K 个压缩块覆盖了整个上下文——只要有任何一个压缩块里存了你需要的信息,HCA 就能看到它。
层分配策略:V4-Pro 的 61 层里,第 0-1 层用 HCA(在 embedding 之后立刻建立全局视野),第 2-60 层在 CSA 和 HCA 之间交替。这个交替模式不是对称的——DeepSeek 团队明确提到”不同层承载不同的注意力模式,强制同一种机制会浪费容量”[6]。早期层用 HCA 建立全局感知,后续层在 CSA(局部精确对应重要块)和 HCA(全局模糊覆盖)之间轮换,最后用一个 MTP 预测块收尾(只跑滑动窗口)。
FP8 和 BF16 的分工:两种 attention 的 KV 条目采用混合存储格式:RoPE 维度保留 BF16,其余维度使用 FP8。这不只是节省内存——FP8 KV 存储配合 CSA indexer QK 路径的 FP4 量化,意味着模型把长上下文里最重的数据搬运路径尽量压到低精度格式中。
四、2% 这个数字的工程含义:为什么压缩路线同时改变了三件事
现在回到开头那个 2% 的数字。这个数字是 CSA/HCA 的序列维压缩、混合 KV 精度,以及具体层数、head 数和 head_dim 配置共同作用的结果。拆开来看:
第一,数量级缩小了 KV cache 的物理尺寸。 在 1M token 的上下文下,DeepSeek-V4-Pro 的 KV cache 约为 DeepSeek-V3.2 的 1/9.5;如果对比 BF16 GQA8 baseline,则约为 2%。相比之下,前面那组标准 GQA-8 估算需要约 327GB,仅 KV cache 就超过两张 H200 的 HBM。在同等 GPU 条件下,模型可以同时服务更多并发请求或更长的上下文窗口——压缩不是在”压缩”上下文中节省的质量,而是在管理 GPU 内存的硬约束。
第二,改变了前缀缓存(prefix caching)的工程假设。 LMSYS 为 V4 开发的 ShadowRadix[7] 是一个为混合注意力设计的原生前缀缓存机制。它的核心洞察:压缩后的 C4/C128 KV 的生命周期远远长于 SWA KV。一个 10K token 的请求,SWA 只需要保留最后 128 个 token,但它的压缩 KV(C4 和 C128)可以完整保留并在后续请求中被重用。ShadowRadix 用”虚拟全 token slot + 多池 shadow 投影”统一管理三池的引用计数——压缩池和未压缩池各自独立管理生命周期——当 SWA 计数器归零时释放 SWA 缓存但保留压缩缓存。前缀缓存的有效命中率被压缩 KV 池的持久性显著抬高。
第三,让 SSD 和 CPU offload 成为经济上可行的方案。 antirez(Redis 作者)在给 V4 Flash 写的专用引擎 DwarfStar 里,把磁盘 KV cache 当作一等公民——KV 状态可以持久化到 Apple Silicon 的 NVMe SSD 上,下一个会话不需要重新 prefill[8]。SGLang 的 HiSparse 方案把 CPU DRAM 当作 C4 KV 的扩展存储池,GPU 只保留最近被 indexer 选中的”活跃”压缩块,其余的在 CPU 端等待调度——在 2×B200 上,这个方案把长上下文吞吐量推高了 3x[7]。压缩 KV 让 PCIe 带宽不再天然成为 offload 的第一瓶颈——与 dense KV 相比,传输量已经小到可以被系统调度和计算重叠消化一部分。
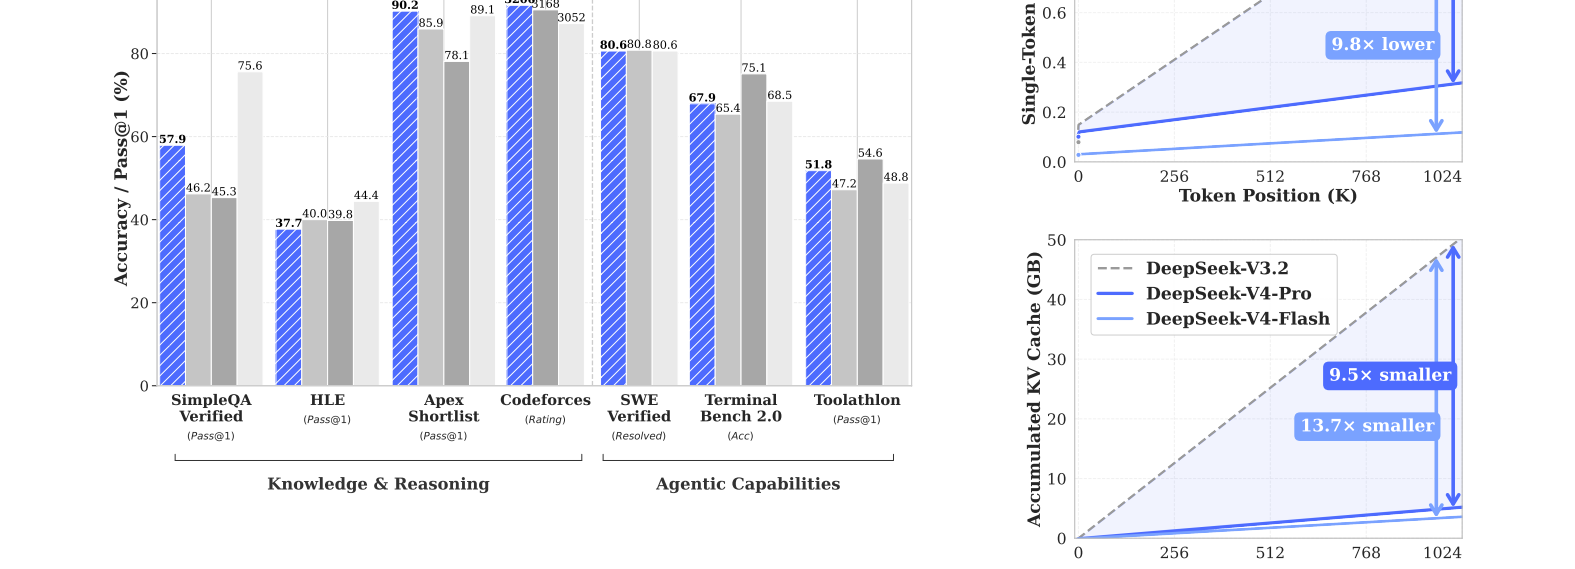
图 4:左半部分显示 V4 在基准测试中的竞争力;右半部分显示单 token FLOPs 和 KV cache 随序列长度的增长——V4-Pro 和 Flash 的曲线斜率远低于 V3.2。来源:DeepSeek-V4 Technical Report Figure 1。
SGLang 团队的数据进一步量化了这个优势。在 200K-900K 上下文的范围内,SGLang 在 V4 上的 decode 吞吐量在 B200 上仅下降了不到 10%(199 → 180 token/s),在 H200 上仅从 266 降到 240 token/s[7]。对于 dense attention 模型来说,200K → 900K 的 decode 吞吐量下降通常在 50% 以上——这就是 2% KV cache 在物理上的直接体现。
五、这条路线意味着什么:注意力架构的一次分叉
到这里我们可以做一个判断了。CSA/HCA 不是对 V3.2 的 DSA 稀疏注意力的”增量迭代”——它是把压缩和稀疏从”同一种机制的两个方面”拆成了”两种独立的注意力算子”,然后通过层间交替来解决两者各自的弱点。
这个分叉的意义不在”V4 做得比别的好”,而在”它选择的是一个和主流不同的方向”。让我们把视野拉宽来看三条路线的现状:
FlashAttention 方向(IO 感知 exact attention)一直在把 O(N²) 的 HBM 访问量往下压——这个路线没有改变计算复杂度,只是在优化数据移动。它的优势是精确性(不丢失任何 token 的信息),代价是内存占用量仍随序列长度线性增长。
稀疏注意力方向(选择性计算)通过降低实际参与计算的 token 数量来降 FLOPs。挑战在”选择器”本身的额外开销和遗漏关键信息的风险——V3.2 的 DSA 在这条路上走得很好,但”只看一部分”的安全网建立在一个假设上:被选中的 token 已经包含了 query 需要的大部分信息。
压缩注意力方向(结构性压缩)走的是完全不同的路线——先减少 representation 的数量,再在这个缩小的空间里做标准的注意计算。CSA 和 HCA 的差异只在压缩率和后续操作(稀疏 vs 密集),但它们共享同一个前提:压缩信息表示的损失,在统计上可以被压缩后更全面的视野所补偿。
V4 的真正创新是把这三条路线重新编排了一次。 CSA 用”压缩 + 稀疏”的组合拳同时解决了 FLOPs(稀疏选择降低了实际计算量)和 KV cache(压缩降低了存储量)。HCA 用”极端压缩 + 密集”的组合拳保住全局视野——这时候 128x 压缩对精度的影响被压缩序列的完整性所补偿。
这个编排的后果是成本结构的根本性变化。DeepSeek API 文档显示,V4-Pro 在 75% 折扣口径下的输入价约 $0.435/MTok,输出价 $0.87/MTok,缓存命中输入价约 $0.003625/MTok;并注明该价格会在 2026-05-31 15:59 UTC 后正式调整为原价的 1/4[9]。如果拿 GPT-5.4 Nano 的 $0.20 输入、$0.02 cached input、$1.25 输出做参照,V4-Pro 的普通输入并不更便宜,但 cache-hit input 便宜约 5.5x,输出价也更低。这个成本结构的背后至少部分来自架构选择带来的长上下文与缓存命中成本变化。
但 V4 也不是无代价的。DeepSeek 团队在报告里自己承认 V4-Pro-Max 的性能”落后 SOTA 前沿模型约 3-6 个月”[1]。在 Agent benchmark 上,V4-Pro-Max 在 SWE Verified(80.6%)、MCPAtlas(73.6%)、Terminal Bench 2.0(67.9%)上都与 GPT-5.4 和 Opus 4.6 处于同一梯队,但胜出的场景并不是”所有方面都更强”——它是”用成本优势覆盖了能力差距”。CSA 的 indexer 在短上下文场景下(< 8K token)会产生额外的 FP4 projection 开销,此时的性价比不如纯 dense attention 的 Flash 模型。StreamIndex 论文[10] 用精确的内存分析证明:CSA 的 indexer 中间 FP32 score tensor 在 65K 上下文(V4-Flash 维度)时高达 256 GB,标准实现直接 OOM——你需要额外的工程手段(chunked partition-merge top-k)才能推到 1M。
六、结论:2% 是结果,不是出发点
回答开篇的问题。”为什么是压缩 + 稀疏而非纯稀疏或纯 dense”——因为这些元素解决的物理约束不同,而组合起来是一种乘法而不是加法。压缩让模型在面对长上下文时先缩小可操作空间;稀疏让它在这个压缩空间里进一步聚焦;极端压缩的密集注意力为它保留”看到全局”的安全网。KV cache 压到 GQA8 baseline 的约 2%,不是因为任何一个子机制有多强,而是序列压缩、混合精度和层间分配共同凑出了乘积效应。
这件事的实际意义超出了 V4 这个帖子的范围。在模型能力趋于平缓、推理成本成为部署主要约束的阶段,注意力架构的选择不再是一个”学术兴趣”——它会直接改变长上下文 API 定价和 cache-hit 经济性的物理基础。从 GQA 到 MLA 到 DSA 到 CSA/HCA,每一次架构变迁都对应着一次成本曲线的陡峭位移。V4 把这条成本曲线又往下推了一截。
这条路线还没有解决的问题:① CSA/HCA 的有效性在多大程度上依赖 1M+ 的上下文长度——在 4K-32K 的”日常范围”里,Flash 的 FlashAttention 路线是否仍是最优选择?② 压缩表示是否适合多模态扩展——图像和多帧视频的 attention 模式与文本不同,128x 压缩是否会系统性丢失视觉 token 的空间关系?③ StreamIndex 的 chunked top-k 方法[10] 解决了 indexer 的 OOM,但 chunked 策略引入的 set-overlap recall 损失在极端长上下文(10M+)场景下会有多大?
这三条线——压缩、稀疏、IO 优化——会继续在一个越来越紧的硬件约束三角形里博弈。V4 证明了压缩路线可以走得很远,但没有证明它是最优终点。
参考资料
[1] DeepSeek-V4 Technical Report
[2] DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model
[3] DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models
[4] Kimi Linear: An Expressive, Efficient Attention Architecture
[5] Prefill-as-a-Service: KVCache of Next-Generation Models Could Go Cross-Datacenter
[6] DeepSeek-V4: a million-token context that agents can actually use
[7] DeepSeek-V4 on Day 0: From Fast Inference to Verified RL with SGLang and Miles
[8] DwarfStar: DeepSeek V4 Flash local inference engine for Metal and CUDA
[10] StreamIndex: Memory-Bounded Compressed Sparse Attention via Streaming Top-k
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。