推理模型生成的几千个 CoT token 都要把 KV cache 写进 GPU HBM——一个 7B 模型产生 2000 token 的推理链,单请求就要占用约 800 MB HBM,batch size=8 时 KV cache 独占超过 6 GB。现有回答几乎一致:识别并永久逐出低重要性 token,把显存放出来。但这个思路对推理型负载是一场灾难——把一半 KV cache 删掉,DeepSeek-R1-Distill-Qwen-7B 在 GSM8K 上的准确率从 71% 崩塌到 2.5%。
这篇来自 USC 和 Wisconsin-Madison 的论文换了一个问题:不是“哪些 token 可以被丢弃”,而是 “哪些 token 不需要待在 HBM?” [1]。答案藏在计算机体系结构里——内存层级。论文设计了一套语义感知的四层系统,把低重要性 token 搬到 CPU DDR 里,在每次 attention 计算前预取回 GPU。预取回来的 token 以全精度参与计算,贡献的 attention term 和从未离开过 GPU 完全一样。论文把这种设计形式化为“零近似误差 offloading”,并由此推导出核心发现:准确率只取决于你永久丢弃了多少 token(逐出比例),与 HBM 里还留了多少无关。
一、为什么逐出对推理是灾难
论文首先给了一组定性数据:对 DeepSeek-R1-Distill-Qwen-7B 在 50 道 GSM8K 题上的 attention 分布进行采样,token 重要性呈显著长尾——前 20% 的 token 捕获了 56.5% 的累积 attention 质量,后 50% 贡献不到 10%。
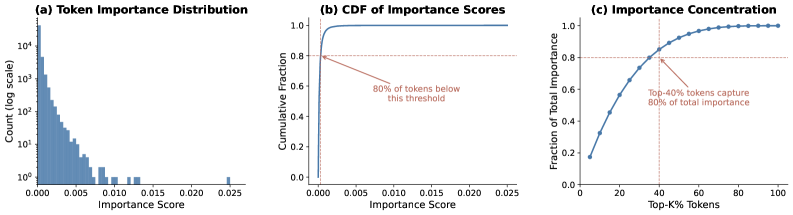
图 1:推理 token 的重要性呈长尾分布——前 20% token 捕获 56.5% 的 attention 质量,底部 50% 贡献不到 10%。来源:论文 Figure 1。
这种分布给人一种错觉:既然大多数 token 在大多数时刻是“冷”的,为什么不能直接丢掉?论文接着用 streaming eviction 实验给了斩钉截铁的回答:准确率从 70% budget 时的 22% 断层崩落到 50% budget 时的 0%。 这不是渐进退化,而是悬崖。
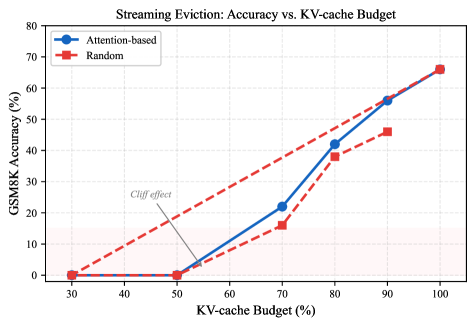
图 2:attention-based 逐出优于随机,但在 50% 预算时准确率崩塌到 0%。来源:论文 Figure 2。
悬崖效应的根因是 推理链和叙述文本有结构性的区别。叙述文本中,两段前的句子通常已经冗余;推理链不同——第 50 步计算出的中间变量可能在 500 步后被引用,且这种引用不可预测、非单调。逐出一个推理 token 不是丢掉一个低频信号分量,而是从运行中的程序里删除一行代码。 丢失不会衰减,而是会复合——每一个缺失的中间结果都会污染所有依赖它的下游步骤。
论文用 H2O 格式的 heavy-hitter 逐出做了额外验证:在 budget ≤ 256 时准确率仅 2%,在 budget=1024 时也只有 30%。同时,R-KV——当前最先进的逐出方法——在论文的复现实验中只达到了 0–32% 的准确率。这不是 scoring function 不够聪明的问题,而是任何建立在“永久删除”基础上的方法在面对推理负载时都有一个不可逾越的物理天花板。
有一个常被忽略的细节加剧了这一问题。注意力分数驱动的重要性 scoring 和梯度-based scoring 之间的秩相关性接近零(Spearman ρ = −0.13)。这说明两种方法给 token 排的序完全不同——它们捕捉的是截然不同的重要性信号。但更关键的是:即使换一套 scoring,被排在底部的 token 发生了置换,逐出的破坏性并不会消失,只是被逐出的对象变了。
二、四层语义感知内存层级
论文的核心贡献是一套按重要性对推理 token 进行分类的实时分层机制:
- T0(HBM):受保护 token(prompt、attention sink、recent window)加上最高重要性的推理 token,留在 GPU HBM。
- T1(DDR):中等重要性 token,全精度存放在 CPU 内存中,每次 attention 计算前预取回 GPU。
- T2(Compressed):低重要性 token,以降低精度(如 8-bit 量化)存储在 CPU 内存。论文的实验揭示了一个意外发现:推理 token 对精度异常敏感,8-bit 量化使准确率从 58% 跌到 20%——这使 T2 在当下更像设计占位符而非工作层,也指出了推理感知压缩是一个待解决的问题。
- T3(Evicted):已永久销毁的最低重要性 token——但仅占总 token 的 3–10%。
层级边界每 64 个 decoding step 重新计算一次,把 O(n log n) 的排序成本摊销到 64 次前向传播上。关键设计在于:T1 token 在下一轮 attention 之前被预取回 GPU,以全精度参与计算,贡献的 attention term 与该 token 从未离开 HBM 时的贡献等价。
论文将这种保证形式化为 Proposition 1(零误差 DDR offloading):
若所有 T1 token 在 attention 计算前被预取回 GPU,则 attention 输出与 T0 和 T1 之间的划分无关。近似误差仅取决于 T3 ——即被永久逐出的 token 数量,与 T0/T1 的分割比例无关。
这直接导出整篇论文最核心的一组实验数据。
三、核心实验:逐出比例决定一切
论文在 GSM8K 上做了一个受控的 3×3 网格实验:三个 HBM 比例(30%、50%、70%)交叉三个逐出比例(3%、5%、10%)。结果读起来像一次干净的物理实验。
在同一逐出列内按列读:3% 逐出时三种 HBM 配置下的准确率分别为 58%、62%、56%——跨度仅 6 个百分点。5% 逐出时,跨度缩小到 4 个百分点。所有列内差异均不显著(p > 0.3)。现在按行读:同一 HBM 比例下,逐出比例从 3% 变到 10%,准确率最多跳变 18 个百分点。
你丢弃了什么决定准确率;你把剩下的存哪里无关。
论文将这一直观发现推到了更大规模和更多 benchmark 上。在 n=200 的 GSM8K 上,仅 3% 逐出时层级系统保持 65.0% 准确率——即 71% full-cache baseline 的 91.5%(p=0.14,与基线无显著差异)。H2O 格式的纯逐出在同一预算级别崩溃到 2%。在 MATH-500 上,层级系统在 3% 逐出时达到 22.5%(71% 的 baseline 保留率),而纯逐出直接产生零正确回答。在 14B 模型上,层级系统在 10% 逐出时达到 90% 准确率——不仅恢复,还在采样方差范围内与 86% 的 full-cache baseline 持平——同时将 HBM 占用减半。
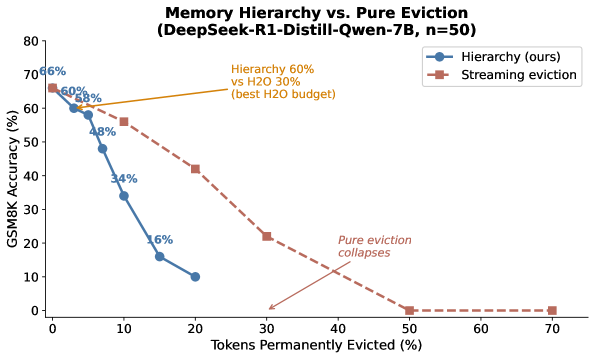
图 3:在相同逐出比例下,将低重要性 token offload 到 DDR 的层级系统大幅优于永久删除的纯逐出策略。来源:论文 Figure 3。
论文还在 MATH Level-5(最难的竞赛数学题,平均推理链 3800 token)和 ARC-Challenge(科学推理)上验证了规律:逐出崩塌到 0%,层级系统至少恢复一部分准确率。规律不是数学推理独有的,而是 CoT 推理本身的属性。
这里有第二个关键细节常被忽略:论文直接复现了 R-KV——把该方法的联合重要性-冗余度评分算法部署到与层级系统完全相同的 GSM8K 样本上(n=50)。R-KV 在 budget=256 时准确率为 0%,budget=512 时为 6%,budget=1024 时为 32%。而层级系统在 3% 逐出下即可达到 56–62%。这不是预算调节的问题——它反映的是逐出和 offloading 之间的根本不对称:无论 scoring function 有多聪明,都无法恢复被永久销毁的信息。
论文更进一步对此前声称在 10–34% KV budget 下“无损压缩”的研究提出了直接质疑。论文自己的实验表明,即使只永久逐出 3% 的 token,也会在 n=200 的 GSM8K 上损失 8.5% 的相对准确率。而该领域常见的 n=50 样本量对应的 95% Clopper-Pearson 置信区间宽度为 ±12–15 个百分点——宽到足以掩盖有意义的退化。
四、系统原型:数据搬移真的只占 5–7%
整篇论文的主张建立在一个前提之上:PCIe 传输有实际代价,但这代价足够小,使 offloading 成为净收益。论文用一个完整的原型验证了这一前提(RTX 5080,PCIe Gen5 x16,int8 模型)。
在 64 token 的逐出间隔下,GPU→CPU offload 仅需 1.1 ms,CPU→GPU prefetch 需 1.5 ms。在典型运行点(约 600 token offload),传输耗时分别为 8.6 ms 和 13.1 ms。带宽饱和在 ~22 GB/s(GPU→CPU)和 ~15 GB/s(CPU→GPU),分别是 PCIe Gen5 x16 理论峰值 63 GB/s 的 35% 和 24%。CPU→GPU 的非对称瓶颈主要来自非 pinned 内存分配;生产环境使用 cudaHostAlloc 会显著改善这一情况。
端到端测试中,层级系统(50% HBM / 10% 逐出)在 GSM8K 上达到 78% 准确率——与 76% 的 full-cache baseline 在采样方差范围内持平——同时 throughput 从 21.8 token/s 降至 18.7 token/s,降幅仅 14%。
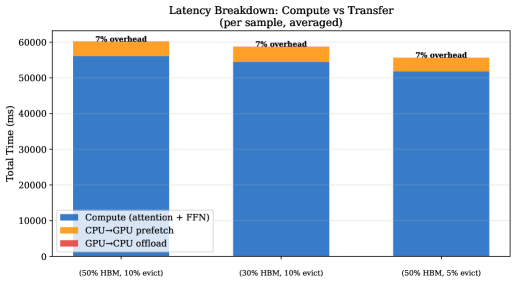
图 4:GPU↔CPU offload + prefetch 合计仅占推理总时长的 5–7%,模型计算仍占主导。来源:论文 Figure 7。
延迟分解清晰地回答了那个最直接的质疑:offload 和 prefetch 合计仅占推理总时长的 5–7%,剩余 93–95% 仍被模型计算占据。 传输在 64 step 间隔进行批量处理,并与 non-attention 层重叠,这一设计使开销保持较低水平。
论文还给出了 scaling projection。在 batch size=8、quantized 7B 模型上,KV cache 已占 GPU 显存的 52%;在 70B 模型上(int4 weights + batch serving),它飙升至 70%。在这些区间内,层级系统对 KV cache 的 50–70% offloading 可转化为 2–48 GB 的 HBM 节约——这直接决定了一个推理服务是否能在单张消费级 GPU 上运行,还是必须上多 GPU 配置。
五、论文真正贡献的不是一套实现,而是一个方向转换
这篇论文值得被记住的,不是四层分层的具体实现(每 64 step 重新排名,attn scoring 比 gradient scoring 好 8 个百分点),而是它提出的那个问题方向:“不是哪些 token 该丢掉,而是哪些 token 不需要待在 HBM。”
这让人想起文件系统中的缓冲池或操作系统中的虚拟内存——当昂贵资源不够用时,解决方案不是删掉数据,而是把数据分到不同成本的存储层级里。在 KV cache 领域,此前数十篇论文投入大量精力打磨越来越智能的逐出策略,但逐出本身就建立在推理链中可丢弃 token 的假设之上。这篇论文用实验表明这个假设不对——推理链中不存在“可安全丢弃”的 token,只有在任何给定时刻“冷”的 token。
论文也诚实地处理了层级系统的一个当前局限:T2 压缩层。8-bit 量化直接毁了推理准确率,原因是推理 token 对精度的敏感程度远超典型语言建模中的 token。这为后续研究留下了一个明确方向:推理感知的压缩。
另一个值得在意的边界是系统原型的单请求场景。KV cache 本身体量较小(~0.5 GB vs 14 GB fp16 模型 weights),绝对 HBM 节约并不起眼。论文有自知之明——它的 scaling projection 明确指向这种设计的收益随 batch size 和序列长度复合增长。但在真正的生产环境(多请求交错、不可预测的 batch composition、现实 PCIe 争用)下,5–7% 的开销是否能保持、prefetch 时序是否依然精确,仍是一个开放问题。
尽管如此,这不会减损这篇论文的核心价值。写到这里,把它放进更大的语境里看:在过去半年里,KV offload 方向涌现了 KVDrive[2](注意力驱动的滑动窗口缓存 + SFC 流水线)、Tutti[3](GPU-centric SSD KV store)、Beluga[4](CXL 共享内存池)和 Dynamo KVBM 四层 offload[5]。这些工作从不同入口进入同一个问题:如何把 KV cache 低成本地扩散到 GPU HBM 之外的更多存储层级里。这篇论文给这个问题增加了一个新维度——在推理型负载上,offload 不是逐出的降级替代,它是逐出的唯一正确替代。逐出本身就选错了基础操作。
参考资料
[1] Not All Thoughts Need HBM: Semantics-Aware Memory Hierarchy for LLM Reasoning
[2] KVDrive: Multi-Tiered KV Cache Management for Long-Context LLM Serving
[3] Tutti: GPU-Centric SSD KV Cache for Long-Context LLM Serving
[4] Beluga: CXL-based KV Cache Memory Pool for Disaggregated LLM Serving
[5] NVIDIA Dynamo: A Datacenter-Scale Distributed Inference Serving System
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。