版本声明:本文分析基于 LMCache main 分支(2026-04)、vLLM 0.19.0 ROCm 版与 MiniMax-M2.5 FP8 MoE 模型;除非特别说明,以下描述均基于此版本。
多轮 agent 负载和单轮 chat 对 KV cache 的需求不在同一个尺度。一次 Claude Code 任务可能跑几十次模型调用,每轮都背着 20K–150K token 的上下文,其中 93–97% 是跨轮复用的固定前缀。如果把每轮调用都重新 prefill 一整遍,GPU 有 95% 的时间在重复自己已经做过的事。
LMCache 团队在 2 张 AMD MI300X 上跑了一组系统评测:用 739 条匿名化 Claude Code agent 对话 trace 重放,对比了无缓存、HBM 前缀缓存和 LMCache CPU DRAM 三级缓存三种策略。这篇文章的核心价值不只是证明”LMCache 能在 AMD 上跑”——它更清晰地揭示了一个常被评测忽略的事实:KV cache 分级策略的胜负不是由策略本身决定的,而是由 Regime 决定的。在低负载下 HBM 前缀缓存完胜;压力上去后 LMCache 的 DRAM tier 发挥非线性优势。而合成 benchmark 因为制造不出足够的内存压力,会给出 LMCache 负收益的误导性结论。本文把这组实验的部署流程、关键陷阱、评测数据和策略判定逻辑整理成一份可参照的 field note。
一、实验环境与评测架构
实验硬件是 2 张 AMD MI300X(每张 192GB HBM,gfx942),搭载 MiniMax-M2.5 230GB FP8 MoE 模型,TP=2。推理框架选用 vLLM 0.19.0 ROCm 版 + LMCache main 分支(HIP 源码编译)。评测驱动使用了 callanjfox/WEKA 的 kv-cache-tester,重放 739 条匿名化 Claude Code 对话 trace[3]。
每条 trace 的中位起始上下文 20,160 token,中位结束上下文 115,008 token,对话持续约 60 分钟。tester 生成合成内容来匹配每条 trace 的 input token 数,同时保留真实 assistant 回复让模型实际 decode。预热阶段先用 50% 的 canonical prefix(约 12K token 共享 tool/system 内容)注入服务,然后以 TTFT SLO 为门控动态伸缩并发用户——这种控制回路和生产系统的负载均衡器行为一致。
评测分四个阶段:1)冒烟测试确认服务响应;2)单 prompt 冷热对比,验证 LMCache 缓存路径是否真实生效;3a)低负载 agent trace replay(8 并发 / 32K 上下文);3b)高负载压力测试(32 并发 / 100K 上下文,GPU 内存利用率压至 0.78);4)合成 benchmark 受控扫参(cache rate 0%–100%,16K 上下文)。阶段 4 的存在是这份评测的额外价值——它在同一套硬件上完整呈现了”真实 agent trace”和”合成 benchmark”在结论上的系统性差异[1]。
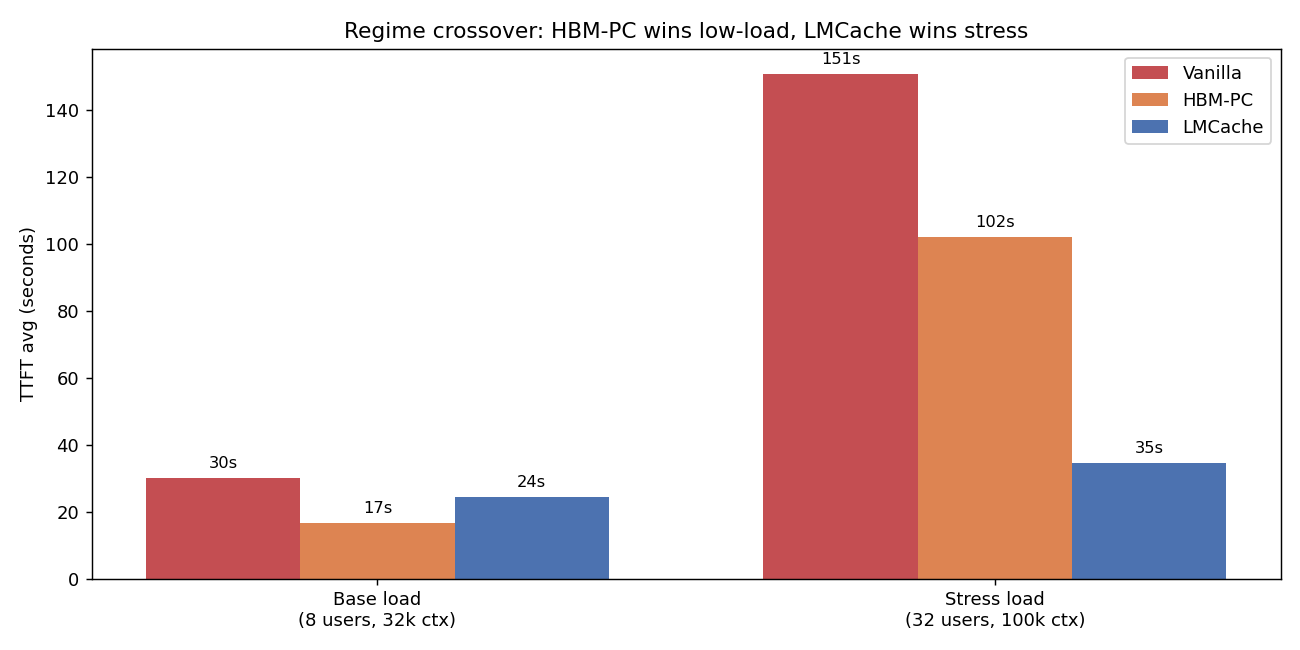
图 1:LMCache 的 Regime 交叉概念图——在低负载下 HBM 前缀缓存足够,当 working set 持续超过 HBM 有效容量后,LMCache DRAM tier 开始发挥作用。来源:LMCache Blog 原图。
二、在 MI300X 上部署的三个致命陷阱
PyPI 的 pip install lmcache 装的是 CUDA 链接的 c_ops.so,在 ROCm 环境直接报错 libcudart.so.12: cannot open shared object file。必须从源码编译:
git clone --depth 1 https://github.com/LMCache/LMCache.git /work/LMCache
cd /work/LMCache && BUILD_WITH_HIP=1 pip install -e . --no-build-isolation
编译前还要卸载 lmcache==0.4.3 作为依赖拉进来的 CUDA-only 包(nixl-cu12、nixl_ep、cupy-cuda12x),否则 vLLM 0.19 的 quark 量化配置模块会无条件 import nixl_ep,模型还没加载就抛出 libcuda.so.1 的 ImportError。
编译通过后,三个配置错误是问题高发区:
第一,PYTHONHASHSEED=0 不可省略。 Python 的 hash() 是进程级随机的。TP 环境下 worker 0 把 prompt 哈希到一个 cache key,worker 1 对同一个 prompt 哈希到另一个 key——即使同一个 client 发两次完全相同的请求,命中率也是 0。症状是日志出现 LMCache hit tokens: 0, need to load: 0。这个问题在 LMCache 文档里有效,但在实际操作中极容易被跳过,在本文实验中是整个缓存路径能否”解锁”的关键开关。
第二,--enable-prefix-caching 必须开启,即使你在用 LMCache。LMCache 复用了 vLLM 的 prefix-cache 哈希函数来推导 cache key。不开启时日志显示 LMCache WARNING: Could not load 'builtin' from vLLM. Using builtin hash.,行为不可预测。
第三,不要设置 LMCACHE_SAVE_DECODE_CACHE=true。 它会同步把每一步 decode 的 KV 写入 CPU,可能将 GPU pipeline 序列化,实测中出现过 100–250 秒的卡顿。Decode 缓存的复用率在实践里极低——每步 decode 都产生唯一的新 tail——offload 开销是纯损失。
此外,MiniMax-M2 系列官方 vLLM recipe 中有一个 fuse_minimax_qk_norm 编译 pass[4],但在 vLLM 0.19.0 之后才添加。如果版本被钉住就不要把它写进启动命令。
部署后的冒烟检测方法:发送同一个请求两次,第一次应显示 hit tokens: 0(冷启动),第二次应显示非零命中数。如果第二次仍是 0,先修 PYTHONHASHSEED 再继续。
三、核心发现:Regime 决定胜负
Phase 2(单 prompt 验证) 确认了 LMCache 的缓存路径在 MI300X 上真实生效。1K 上下文冷热加速 2.0×,2K 上下文达到 10.7×——差距主要来自 prefill 被完全跳过。
Phase 3 低负载(8 并发 / 32K 上下文) 是 HBM 前缀缓存的胜利区:完成请求数 52 vs LMCache 的 25 vs 无缓存 9;平均 TTFT 16.66s vs 24.29s vs 30.05s;峰值并发 8 vs 3 vs 2。这个场景下 working set 舒服地躺在 HBM 里,LMCache 的 connector 开销(cache-key 处理、lookup、传输检查)变成净损失。
Phase 3 压力测试(32 并发 / 100K 上下文) 彻底翻牌:GPU 内存利用率被压到 0.78,制造 HBM 紧张。
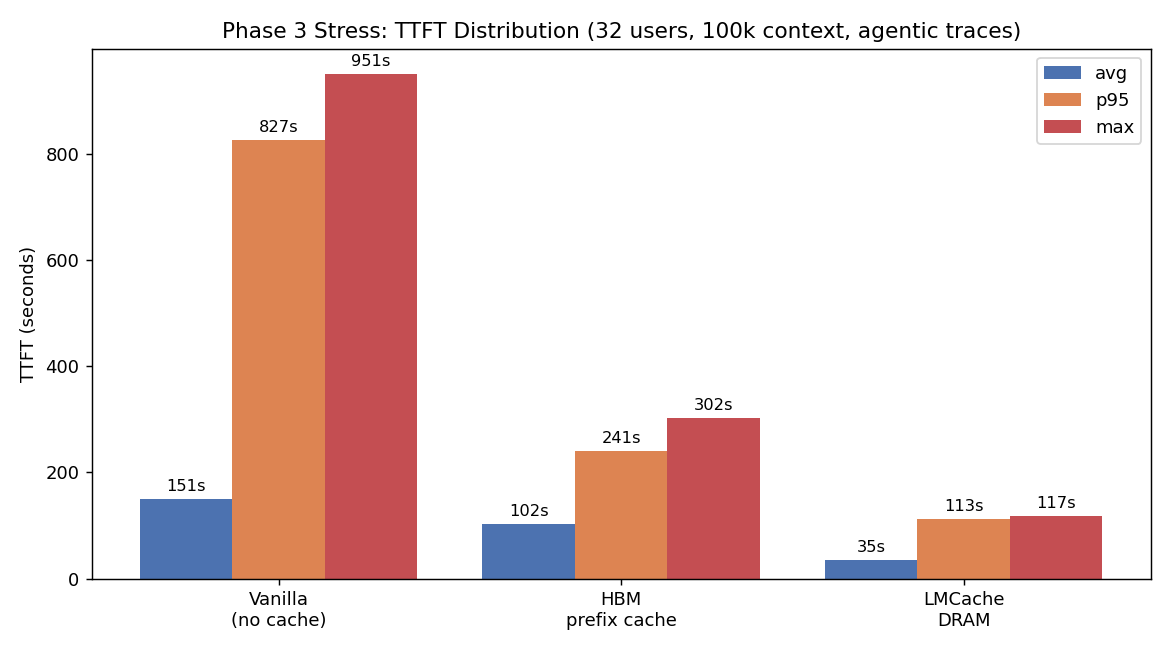
图 2:Phase 3 压力测试下三种策略的 TTFT 分布对比。LMCache 的 p95 TTFT 112.78s vs HBM-PC 240.87s vs Vanilla 826.69s。来源:LMCache Blog 原图。
在这个 Regime 里,LMCache 相对 HBM 前缀缓存:平均 TTFT 降到 1/3(34.59s vs 102.17s),p95 TTFT 砍到不到一半(112.78s vs 240.87s),最大 TTFT 从 301.72s 砸到 117.38s,完成请求数提升 2.3 倍(28 vs 12)。同一个 HBM 预算下,LMCache 多 hold 了 36% 的 working set(312K vs 230K token)。
这个交叉点大约在 250K–300K token 持续 working set。低于 100K token 直接用 HBM 前缀缓存;100K–250K HBM 前缀缓存踩线,开始监控 eviction;250K–500K 区间 LMCache DRAM 成为必要;超过 500K 需要考虑 NVMe L3 tier。
LMCache 团队的评测还暴露了一个底层发现:在整个实验范围内,输出吞吐量只有 1–8 tok/s 总量级。MiniMax-M2.5 + TP=2 + AITER 在 MI300X 上是 decode-bound 的——KV cache 策略只攻击 prefill 侧,decode 侧仍然是更硬的瓶颈。这意味着在实际生产部署中,KV 缓存分层是必要的但不够充分。下一份优化预算应该花在 FP8 KV cache(2× 容量、<0.5% 质量损失)、speculative decoding(Eagle-2/Medusa 2–3× decode 加速)和 PD 分离(2 节点以上规模解决 prefill 阻塞 decode)上。L2 cache 解决的是”要不要重新 prefill”的问题,量化解决的是”能装多少同时在线请求”的问题,speculative decoding 解决的是”每步 decode 有多快”的问题——三者互补,但丢任何一个都会在另一个维度上撞到天花板。
四、合成 benchmark 为什么低估 L2 Cache
Phase 4 用 cache_rate_tester.py 跑了一组受控扫参:在 16K 上下文下,固定 cache hit rate 为 0%/25%/50%/75%/100%,测量三种策略的吞吐量。结果 LMCache 在所有 hit rate 下吞吐量都低于 HBM 前缀缓存,差距约 10–17%。
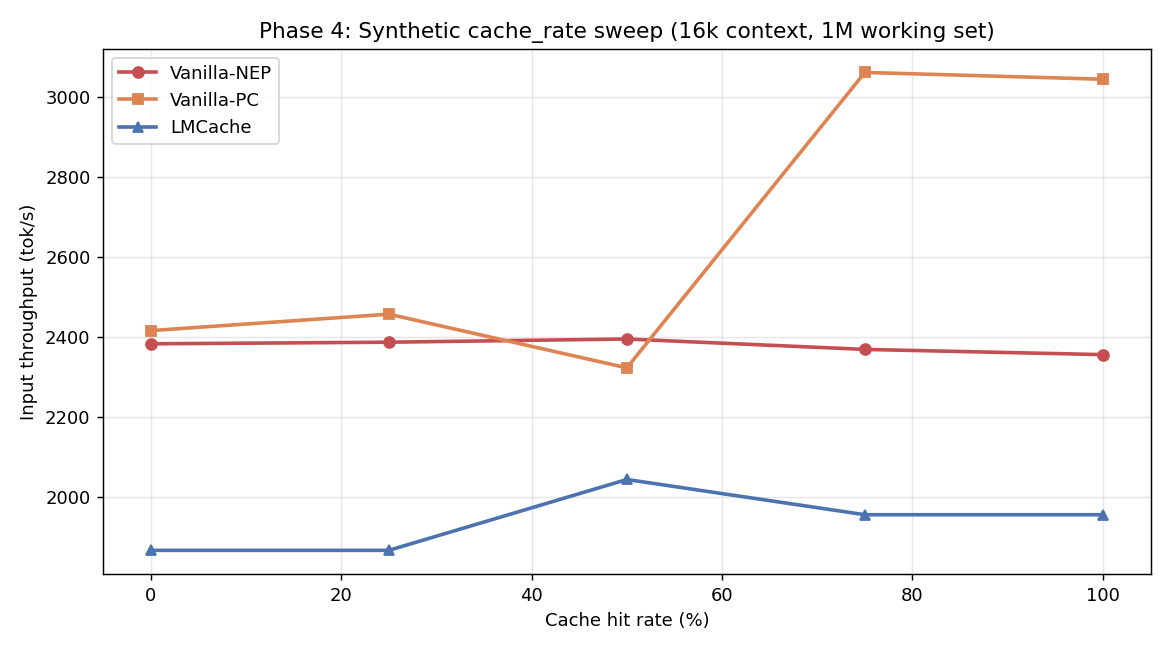
图 3:Phase 4 合成 benchmark——LMCache 在所有 cache hit rate 下吞吐量均低于 HBM 前缀缓存。根因是 16K 上下文无法制造足够 HBM 压力让 L2 tier 介入。来源:LMCache Blog 原图。
这个”负收益”的根因不是 LMCache 不能复用 KV cache,而是 16K 上下文的合成测试没有制造出足够的 HBM 压力。MiniMax-M2.5 每个 16K 请求的 KV cache 只有约 1.9GB。2 张 MI300X 共 384GB HBM,加载 230GB FP8 模型后约剩 154GB——在 TP=2 下还有大量余量让活跃 KV block 留在 HBM 里。在这种条件中 vLLM HBM 前缀缓存已经能在命中时跳过 prefill,LMCache 的 DRAM tier 基本没有用武之地,但每条请求仍然要过一遍 connector 的开销路径。
这是特殊的”最差情况”:缓存复用存在,但 HBM 没有被逼到必须起用 CPU DRAM 的程度。一个公平的 L2 cache 评测需要同时满足两个条件——前缀复用和HBM 压力。只控制前者(hit rate)而忽略后者(working set 是否超出 HBM 容量),评测结果会对 L2 cache 策略系统性地不利。LMCache 团队把两种场景放在同一套硬件上对比,相当于提供了”在什么情况下 benchmark 不具有代表性”的正面案例分析。
五、部署建议与已知风险
综合这组实验,在 MI300X 上部署 LMCache 的关键步骤:
- 从源码编译,
BUILD_WITH_HIP=1是唯一正确路径,不用 PyPI wheel PYTHONHASHSEED=0是硬性要求,不是可选优化——缺失直接导致 0% 命中率- 启用 vLLM 的 prefix cache(
--enable-prefix-caching),让 LMCache 复用其哈希函数 - 不要开启
LMCACHE_SAVE_DECODE_CACHE——decode 端 offload 是纯开销 - L2 pool 给足容量(
LMCACHE_MAX_LOCAL_CPU_SIZE=64GB+),DRAM 便宜,eviction 代价高 - 优先用 FP8 模型权重和 FP8 KV cache,最大化 HBM L1 容量,推迟 L2 介入时机
- 用
LMCache hit tokens: N日志监控生产环境缓存路径是否正常
策略选择的核心决策树围绕一个判断:估算你的持续 working set vs HBM 有效容量。大部分 chat 负载 working set 在 100K token 以下,HBM 前缀缓存足够。当部署转向 agent 负载、多轮工具调用、或共享 system prompt + tool definition 前缀的多租户服务时,working set 很容易超过 250K token——此时 L2 KV cache 的收益从”可忽略”跳到”非用不可”。
已知风险:实验中触发了一次 TP=2 + LMCacheConnectorV1 的 shm_broadcast 死锁——两个 TP worker 都存活、没有 preemption、没有等待中的请求,但超过 6 分钟没有任何推进。复现了一次但在不同参数下未能稳定复现,暗示 vLLM 和 LMCache 之间的 KV connector 路径在 ROCm 环境下存在偶发的同步问题。在 TP ≥ 4 的生产部署中,这个风险需要主动追踪 upstream。
参考资料
[1] Benchmarking LMCache for Multi-Turn Agentic Workloads on AMD MI300X
[3] kv-cache-tester: Claude Code Agentic Trace Replay Toolkit
版本对齐信息
| 组件 | 版本/标识 | 备注 |
|---|---|---|
| vLLM | v0.19.0 ROCm | ROCm 容器镜像 vllm/vllm-openai-rocm:v0.19.0 |
| LMCache | main 分支(~2026-04) | 从源码 HIP 编译(BUILD_WITH_HIP=1),非 PyPI 发布版 |
| MiniMax-M2.5 | FP8 MoE(230 GB) | TP=2,GPU memory utilization 0.78(stress)/ 0.85(others) |
| AMD MI300X | gfx942, 192 GB HBM × 2 | ROCm 7.0.0 |
| 评测工具 | kv-cache-tester(callanjfox/WEKA) | 739 条匿名化 Claude Code agent trace |
| 参考博客 | 2026-05-12 发布 | LMCache Blog,作者 Andy Luo & LMCache Team |
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。