推理系统正在从“单个 engine 把 token 算完”走向“一个超节点里多种 worker 共同服务同一条请求”。Prefill worker 生成 KV,decode worker 接着吐 token;长上下文 block 要下沉到 CPU、SSD、对象存储;RL 训练里的 actor 等着 learner 更新权重;MoE 的 expert parallelism 还要随负载重新排布。每条路径看起来都可以各写一套搬运逻辑,但规模一上来,真正难维护的恰恰是这些路径之间的重复状态、重复连接和重复 metadata。
NVIDIA 在 2026 年 3 月发布的 NIXL 文章[1],把重点放在一个更底层的问题上:推理系统里的数据面能否抽成一层。agent 负责本地资源,metadata 描述远端可访问性,descriptor 表达要搬的 buffer,backend 对接 UCX、GDS、S3、POSIX、RDMA、NVLink 等不同路径。换句话说,NIXL 的目标是让上层框架不再把 KV cache transfer、long-context KV storage、RL weight streaming、elastic EP 各自写成一套独立的数据搬运协议。
这篇阅读笔记把 NIXL 放在“推理超节点”的视角里看:它解决的边界在哪里,哪些收益来自统一抽象,哪些前提仍然依赖 NVIDIA 生态、网络拓扑和硬件近邻。
一、NIXL 解决的是推理数据面的分裂
NVIDIA 官方博客把 NIXL 的核心用例列得很直白:disaggregation 中把 KV block 从 prefill worker 搬到 decode worker;long-context 场景把 KV cache 存到长期介质以避免后续重算;weight transfer 用于快速启动或 resharding;RL 里从 learner 向 actor 流式传输更新后的权重;elastic expert parallelism 里 dispatch / combine 阶段要支持动态重配置[1]。
这些用例表面上都在做网络传输,深层问题却是动态服务里的同一组状态管理:源数据在哪里,目标 worker 能不能访问,应该走哪条 backend,传输发起后是否能和计算重叠,worker 增删或故障时 metadata 如何失效。过去每个 inference framework 都能在自己的场景里把这件事做出来,但一旦系统同时包含 P/D 分离、KV offload、weight streaming 和 EP 重配置,重复实现就会变成状态管理债务。
Dynamo 文档把这件事拆成三层:scheduling 决定 prefill 和 decode 怎么排;memory management 管 KV block 在 GPU、CPU、SSD、remote storage 之间怎么流动;NIXL 负责低延迟数据移动,把 KV cache 在节点之间和 memory hierarchy 之间搬过去[4]。这个分层很关键。NIXL 不替 router 做决策,也不替 KVBM 决定哪些 block 值得保留;它只把“执行一次正确的数据移动”变成可复用能力。推理超节点需要的正是这种边界清晰的数据面。
二、agent / metadata / descriptor / backend 是真正的抽象
NIXL 的设计入口落在 transfer agent。官方文档把 agent 放在 conductor 进程里,由上层 runtime 负责分配内存、处理请求、通过 side channel 或 etcd / Redis 交换序列化 metadata[2]。每个 agent 有全局唯一名字,可以管理一台 DGX 里的多个 GPU,也可以代表一个 worker 进程里的本地资源集合。
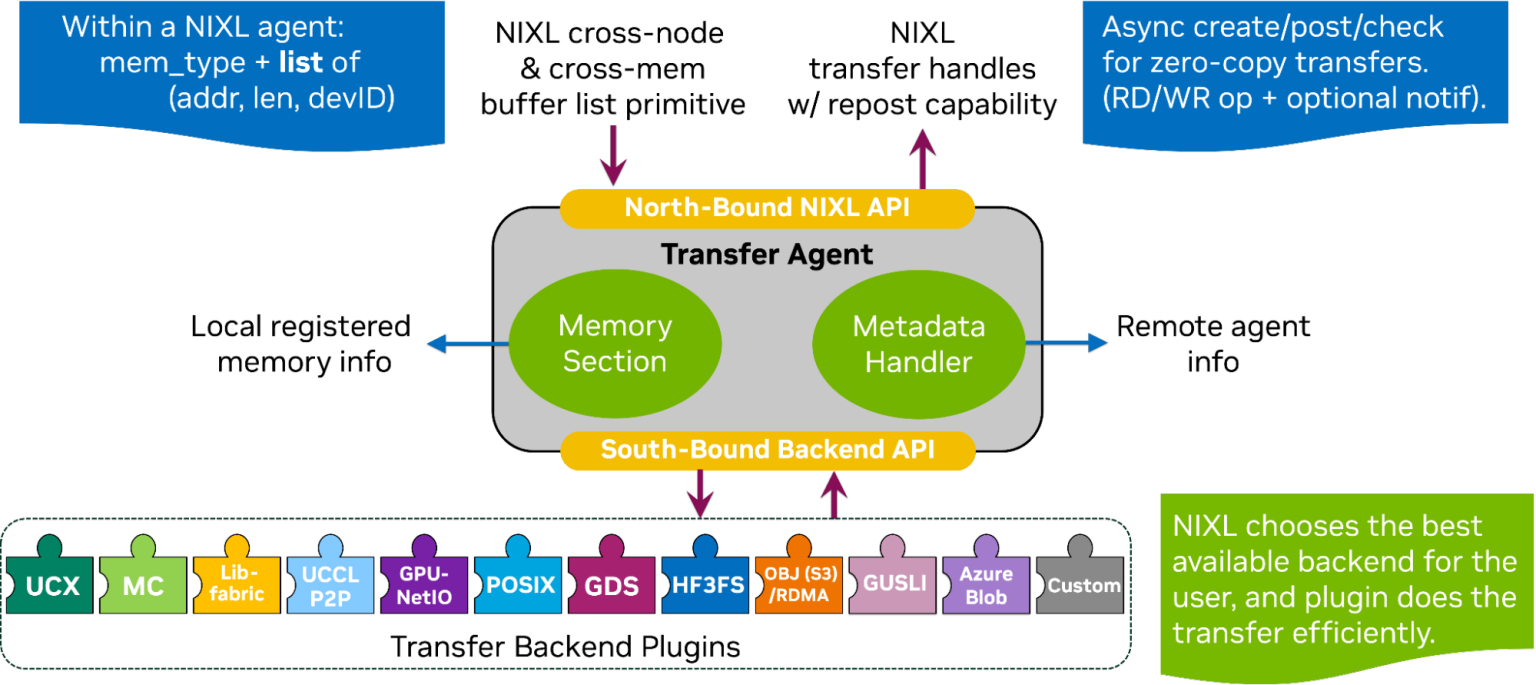
图 1:NIXL 把本地 memory section、远端 metadata handler 和底层 transfer backend 收进同一个 transfer agent。上层框架提交 descriptor,agent 决定后端路径。来源:NVIDIA Technical Blog [1]。
Memory section 统一描述 HBM、DRAM、NVMe-oF、object storage、file 这类不同存储空间。Descriptor 则把一次 transfer 拆成一组地址、长度、设备 ID 和 backend metadata。Backend plugin 负责真正的执行路径,例如 UCX 做跨节点网络通信,GDS 做 GPU 与存储之间的数据搬运。Metadata handler 管的是远端可访问性:连接信息、remote segment identifier、backend 生成的 public data,以及缓存失效。
这套抽象的工程含义很具体。上层框架不需要为“GPU 到 GPU”“GPU 到 SSD”“对象存储到 GPU”分别维护完全不同的调用习惯;它提交本地 descriptor、远端 descriptor、目标 agent 名字和读写方向,NIXL 通过双方可用 backend 与 memory type 选择路径。NIXL backend guide 里把 southbound API 拆成 capability、connection management、memory registration、metadata management、transfer operations、notification handling 等几组接口[3],抽象对象已经上升到 backend 生命周期。
这个设计也暴露了 NIXL 的第一个边界:metadata 交换不可能凭空消失。NIXL 可以缓存 metadata,避免每次传输都重新取远端信息;也可以在 worker 加入、移除、失败时失效远端 agent metadata。但它仍然假设上层 conductor 或 metadata service 可靠地把这些信息分发出去。生产里最麻烦的 bug 往往出在控制面和数据面状态不一致,NIXL 把数据面统一了,但没有取消控制面的责任。
三、KV cache transfer 是入口,长上下文存储才是放大器
P/D 分离是理解 NIXL 最直接的入口。Dynamo 的 disaggregated serving 文档把流程写成三步:prefill engine 计算 prefill 并生成 KV cache,prefill engine 把 KV cache 转给 decode engine,decode engine 执行 decode[5]。高性能路径的关键在第二步:Dynamo 使用 NIXL 从 prefill engine 的 VRAM 直接把 KV cache 转到 decode engine 的 VRAM,并且 transfer 是 non-blocking,GPU forward pass 可以继续服务其他请求。
如果只看这一步,NIXL 像是一个更通用的 GPU-to-GPU transfer 库。但 agentic inference 把问题放大了。Dynamo 2026 年 4 月的 agentic inference 文章给了一组很有冲击力的数据:Claude Code 同一 worker 后续请求可达到 85-97% cache hit;4 个 Opus teammate 的 aggregate cache hit rate 达到 97.2%;读写比为 11.7:1[6]。一旦请求从单轮 chat 变成几十轮工具调用,KV cache 进入写一次、读多次的访问模式,跨 worker 的可寻址性比单次 transfer 更重要。
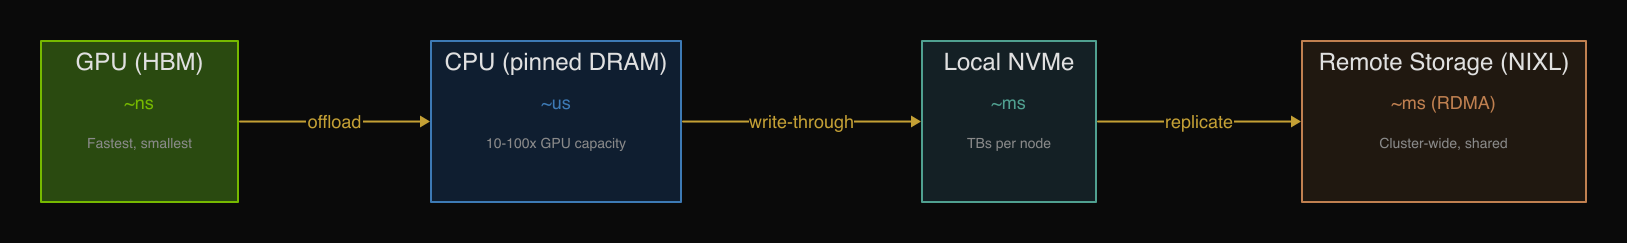
图 2:Dynamo / KVBM 把 KV cache 推向 GPU、CPU、local NVMe、remote storage 四层层次。NIXL 的角色是让 block 能在这些层之间被统一寻址和搬运。来源:NVIDIA Dynamo blog [6]。
这也是 long-context KV storage 会和 NIXL 绑定在一起的原因。KVBM 把 KV block 从 GPU HBM 写穿到 CPU pinned DRAM、local NVMe、remote storage,block 按 sequence hash 去重后成为可被任意 worker 读取的共享对象[6]。在这个模型里,NIXL 不只是把 prefill 结果送给 decode;它还要支持 worker 从共享层拉取旧 block、预取即将被 agent 复用的 prefix、把 decode 新生成的 KV 写回公共层。
这里有一个容易被忽略的成本判断:一次命中共享 KV 不等于免费。只有当重算成本高于读取路径上的 latency、带宽占用和 lookup 开销时,offload / reload 才划算。长上下文、重复工具定义、multi-agent 共享 prefix 是 NIXL 最容易产生收益的区域;短 prompt、低复用、网络拓扑较差的部署,可能会把节省的 compute 又花回数据移动上。
四、weight streaming 和 elastic EP 让 NIXL 超出 KV cache 范围
如果 NIXL 只服务 KV cache,它会被自然归类为 KVBM 或 P/D 分离的内部组件。但官方博客把 weight transfer、RL weight streaming、elastic expert parallelism 也放进核心用例[1],这让它更像推理系统里的通用数据移动层。
RL weight streaming 的压力来自训练和推理耦合。Learner 端持续产生新权重,actor 端需要尽快拿到更新,同时还要保留推理吞吐。这里搬运的对象已经从一个请求的中间状态,转向模型服务本身的版本流。Weight transfer 则对应冷启动、扩容和 resharding:新 GPU worker 启动时,如果权重已经在 host memory、storage 或其他 GPU 上,系统希望用最快路径把它送到目标 worker,避免每个节点各自重复加载。
Elastic EP 的信号更有意思。MoE 推理里 expert dispatch 和 combine 本来就依赖高带宽低延迟通信;一旦 expert placement 可以随负载动态变化,通信路径和 metadata 也要跟着变。NIXL 的动态 metadata exchange 正是为这种长期运行、节点加入移除、失败恢复的服务形态准备的[1]。问题形态已经从固定 rank 对之间的一条连接,扩展成持续变化的 agent 集合如何保持数据面可寻址。
从这个角度看,NIXL 的价值应和 NCCL 分开理解。NCCL 擅长集体通信和训练/并行计算里的规整通信模式;NIXL 面向的是推理服务里的点对点、异步、非连续、跨 memory tier 的数据移动。它们的交集在带宽和延迟,分野在 workload 形态。推理超节点需要的很多搬运并不整齐:有的 block 在 GPU,有的在 SSD,有的在对象存储,有的目标 worker 刚加入服务。这类不规整性才是 NIXL 要接住的部分。
五、边界:vendor-agnostic 叙事和硬件拓扑现实之间
NVIDIA 对 NIXL 的定位带着一个强声明:vendor-agnostic,可以运行在多种环境;官方文章提到 AWS EFA、Trainium / Inferentia、Azure RDMA,以及正在和 Google Cloud 合作支持 RDMA 与 GPUDirect-TCPXO[1]。Dynamo 文档也写到支持 vLLM、SGLang、TensorRT-LLM,并计划扩展非 NVIDIA 硬件支持[4]。
这个方向值得肯定,但不能把“API vendor-agnostic”和“性能 vendor-neutral”混在一起。NIXL 的抽象可以包住 UCX、GDS、S3、POSIX、Mooncake、3FS 等不同 backend;真正决定收益的仍然是 GPU、NIC、PCIe / NVLink、RDMA、storage client、NUMA 拓扑之间的物理路径。GPUDirect RDMA、GPUDirect Storage、NVLink / NVSwitch 这类能力越完整,NIXL 越容易把抽象成本摊薄;如果部署落在普通 Ethernet、跨 AZ 对象存储、GPU 与 NIC 拓扑不近邻,统一 API 仍然能减少开发复杂度,但未必能给出同样的尾延迟。
另一个边界是调度与数据移动的耦合。NIXL 可以选择 transfer backend,却不知道某个 KV block 是否值得搬、某个 prefetch 是否会命中、某个 worker 是否马上被 autoscaler 回收。这些判断属于 Dynamo router、KVBM、planner 和业务 harness。NIXL 的抽象越干净,上层越不能偷懒;否则系统会拥有漂亮的数据面,却用错误策略把冷 block 预取到 GPU,把高价值 prefix 留在慢层。
六、结论:NIXL 是超节点的数据面,完整答案还在上层
NIXL 最有价值的判断,是把推理系统里的“搬运”从各个功能模块中抽出来。KV cache transfer、长上下文 KV storage、RL weight streaming、elastic EP 看起来属于不同问题,但它们都需要 agent、metadata、descriptor、backend 这套共同语言。统一之后,上层框架可以把注意力放回路由、缓存策略、生命周期和 SLA,不用在每条新路径上重新写连接管理与 backend 适配。
它的边界同样清楚。NIXL 不能替代 KVBM 判断 cache 价值,不能替 router 做 workload placement,也不能绕过硬件拓扑带来的带宽和尾延迟。它更像推理超节点里的数据移动层:当你的系统已经走到 P/D 分离、跨层 KV offload、动态扩缩容、MoE 专家重排和 RL actor 更新同时存在的阶段,它让这些路径共享一套数据面。对于还停留在单 engine、短上下文、低复用的部署,NIXL 的抽象收益可能暂时大于性能收益。
所以我会把 NIXL 看成一个信号:推理框架的竞争正在从 kernel 和单机 engine,延伸到超节点内部的数据面。真正要继续追的,是它在非理想拓扑、混合硬件和高 churn worker 环境里,能否稳定地把 metadata、调度策略和真实传输性能对齐。
参考资料
[1] Enhancing Distributed Inference Performance with the NVIDIA Inference Transfer Library
[3] NIXL Backend Plugin Interface Overview
[4] NVIDIA Dynamo Documentation: Introduction
[5] NVIDIA Dynamo Documentation: Disaggregated Serving
[6] Full-Stack Optimizations for Agentic Inference with NVIDIA Dynamo
版本对齐信息
本文引用 NIXL GitHub 文档但不做源码级调用链分析。NIXL repo ai-dynamo/nixl 查询时间为 2026-05-26,main HEAD 为 f8e2221f96db(2026-05-26),最新 tag 为 v1.1.0 / 05e4243f5ed(2026-05-12)。
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。