Dynamo 1.0 最容易被一句“生产可用的分布式推理框架”带过去,但这句话真正有分量的地方,在于它把推理系统从 engine 周边的优化集合,推进成了一套控制面和数据面的组合。NVIDIA 在 2026 年 3 月发布的 Dynamo 1.0 博客给了很多数字:Blackwell 上结合 disaggregated serving 和 wide expert parallel,DeepSeek R1-0528 的 tokens/sec/GPU 可以做到最高 7x;agentic inference 场景里,Dynamo + NeMo Agent Toolkit 给出最高 4x 更低 TTFT 和 1.5x 更高吞吐;多模态 embedding cache 在 GB200 上让图像请求 TTFT 最高下降 30%、吞吐最高提升 25%;ModelExpress 在 H200 上给 DeepSeek v3 这类 MoE 模型带来最高 7x 模型加载加速[1]。
这些数字当然重要。更值得读的是,Dynamo 1.0 把性能问题拆成了四类生产系统问题:请求怎么分派,KV cache 怎么跨 worker 流动,模型副本怎么快速恢复,Kubernetes 怎么按拓扑组织角色。它的“production-ready”指向的是一层操作系统式能力:调度、内存管理、数据传输、故障处理和可观测性,都开始从 serving engine 周边进入推理集群本体。
一、7x 吞吐背后,是 P/D 分离进入机柜尺度
NVIDIA 博客把 Dynamo 1.0 的性能锚点放在 SemiAnalysis InferenceX:DeepSeek R1-0528、FP4、1k/1k、约 50 tok/sec/user 的交互设置下,Dynamo 结合 disaggregated serving 和 wide expert parallel,在 GB200 NVL72 上给出最高 7x tokens/sec/GPU 提升[1]。这个图值得放在文章开头,因为它把 Dynamo 的定位说得很清楚:优化对象已经越过单个 GPU forward pass,扩展到多节点、多角色、多数据对象共同运行时的系统效率。
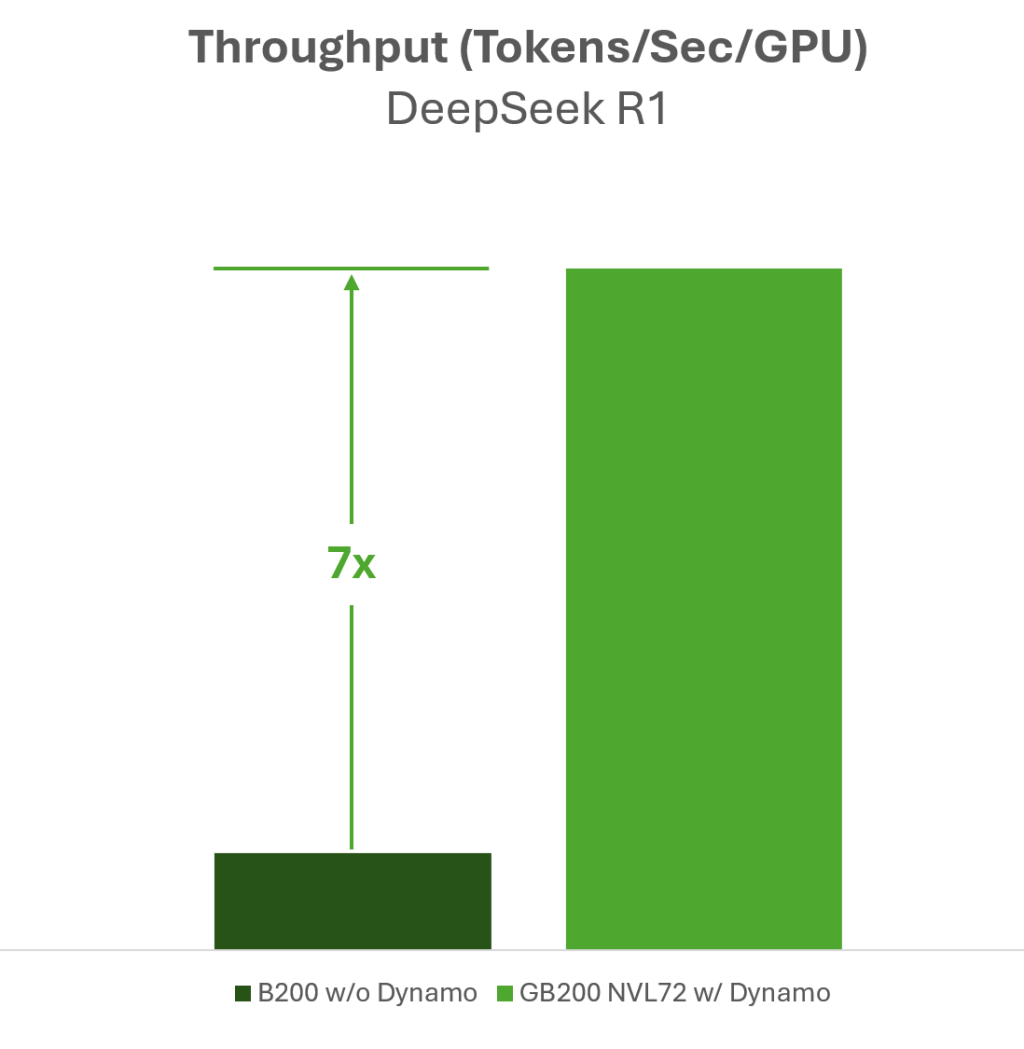
图 1:这张柱状图直接比较 B200 without Dynamo 与 GB200 NVL72 with Dynamo 的 DeepSeek R1 tokens/sec/GPU,并标出 7x 差距。它支撑的是本文第一节的判断:Dynamo 1.0 的核心收益来自机柜尺度的 disaggregated serving 与 expert parallel 组合,重心已经超出单个 worker 内部的小修小补。来源:NVIDIA 技术博客。
P/D 分离的直觉并不复杂:prefill 主要消耗算力,decode 主要被 KV cache 读取和显存带宽限制。把两者拆开后,prefill worker 和 decode worker 可以独立扩缩容,系统也可以把 KV cache 从一个角色传给另一个角色。难点在于,一旦走到多节点,系统必须同时回答三个问题:KV cache 转移的延迟是否抵消了分离收益,prefill 和 decode 的 worker 比例是否匹配,worker 放在同一个 NVLink domain、同一个 rack、还是跨 rack。
Dynamo 文档把它的底座概括为三件事:scheduling、memory management 和 data transfer。disaggregated serving 需要调度器避免 prefill 和 decode 互相干扰,需要 KV cache 管理器处理 offload/onload,也需要 NIXL 这样的低延迟传输层在节点和存储层级之间移动 KV cache[3]。这组能力合起来,才让 P/D 分离从论文和 demo 变成可以被 Kubernetes 组织的生产形态。
二、Agentic inference 让路由器必须读懂请求意图
Agent workload 把普通 serving 的盲点放大了。一次 coding agent 任务可能有几十到几百次模型调用,每次都携带长系统 prompt、工具定义、会话历史和临时推理内容。NVIDIA 的 Dynamo agentic inference 文档里用 Claude Code 会话做例子:一个 42-call session 中 cache reads 达到 891K tokens,writes 是 76K tokens,read/write ratio 为 11.7x;后续调用同一 worker 时 cache hit rate 可以达到 85-97%[6]。这类 workload 的成本关键,已经从“单次请求多快”扩展到“系统能不能把高价值前缀留住并路由回来”。
Dynamo 1.0 在这里引入了 agent hints。harness 可以把 latency sensitivity、expected output length、priority、cache control 这类 metadata 传给 frontend、router 和 KV cache manager;router 再用优先级、预期 OSL、KV overlap、worker load 去决定请求落点[1][6]。这很像把 agent harness 和推理集群之间的暗号变成了协议字段:用户只是等一次任务完成,系统内部却可以区分“前台请求”“后台子任务”“即将恢复的工具调用”“生命周期很短的 reasoning block”。
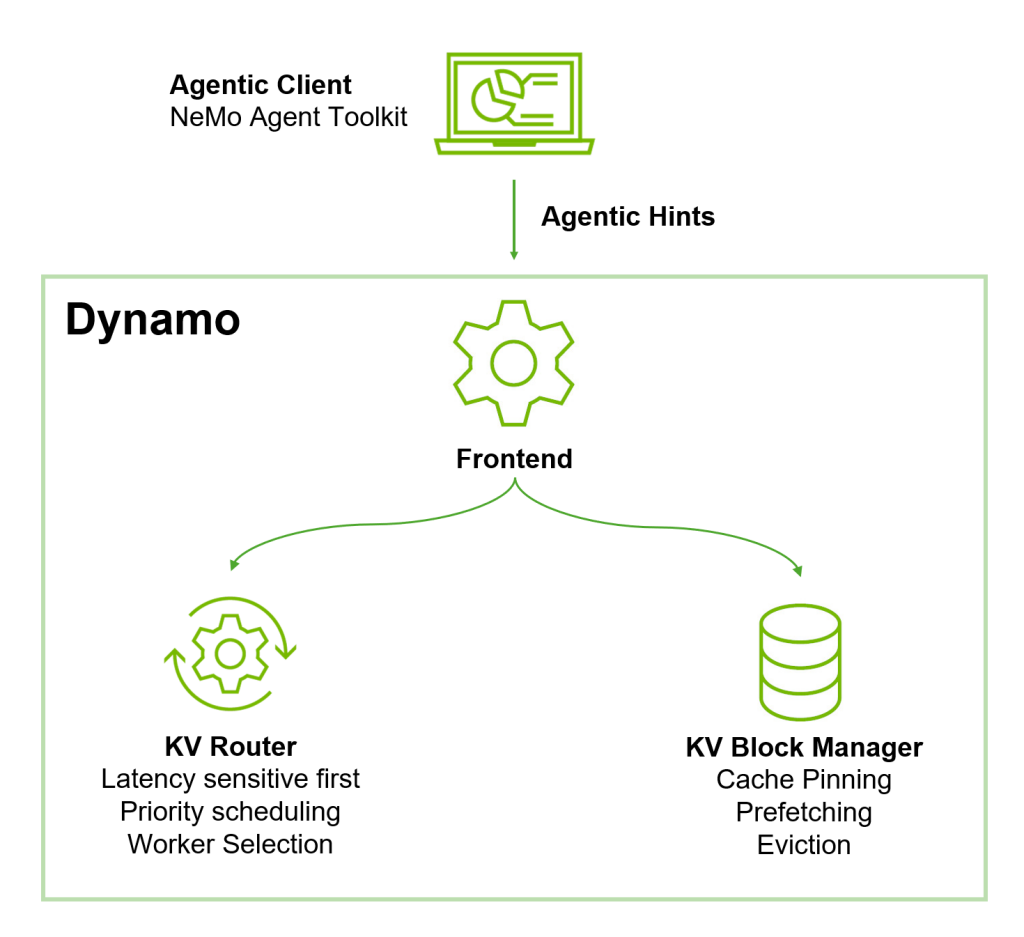
图 2:图中 NeMo Agent Toolkit 将 Agentic Hints 送入 Dynamo Frontend,随后分流到 KV Router 与 KV Block Manager;Router 负责 latency-sensitive first、priority scheduling 和 worker selection,KVBM 负责 cache pinning、prefetching 与 eviction。它对应的是本文第二节讨论的 harness-to-runtime 语义传递。来源:NVIDIA 技术博客。
这里的判断很直接:agentic inference 会逼迫 serving runtime 承认“请求带有语义”。系统 prompt 和工具定义是高复用资产,reasoning token 常常是一次性中间态;工具调用等待 2-30 秒,不应该因为 LRU 老化就丢掉整段 prefix;subagent 结束后的 KV block,也不该继续挤占高价值缓存。Dynamo 的 agent hints、cache_control、priority scheduling 和 KV-aware placement,都是在把这组 workload 语义下沉到 runtime。
三、ModelExpress 解决的是扩缩容的冷启动债
生产集群不会稳定地运行固定副本数。流量上来要扩容,worker 掉线要补位,rolling update 要换版本,大模型 serving 的每一次新副本启动都可能重复下载权重、从远端存储加载、应用优化、编译 kernel、构建 CUDA graph。Dynamo 1.0 的 ModelExpress 把这个路径拆成两个复用动作:checkpoint restore 和 model weight streaming[1]。
checkpoint restore 的思路是先完整跑一次初始化,把 ready-to-serve 状态捕获下来;新副本上线时从这个 checkpoint 恢复,跳过重复构建。model weight streaming 则让一个 initial worker 先加载模型,再通过 NIXL 和 NVLink 把权重流式传给其他 worker,减少每个副本都去打远端存储的放大效应。NVIDIA 给出的数字是,DeepSeek v3 这类大 MoE 模型在 H200 上模型加载时间最高可以加速 7x[1]。
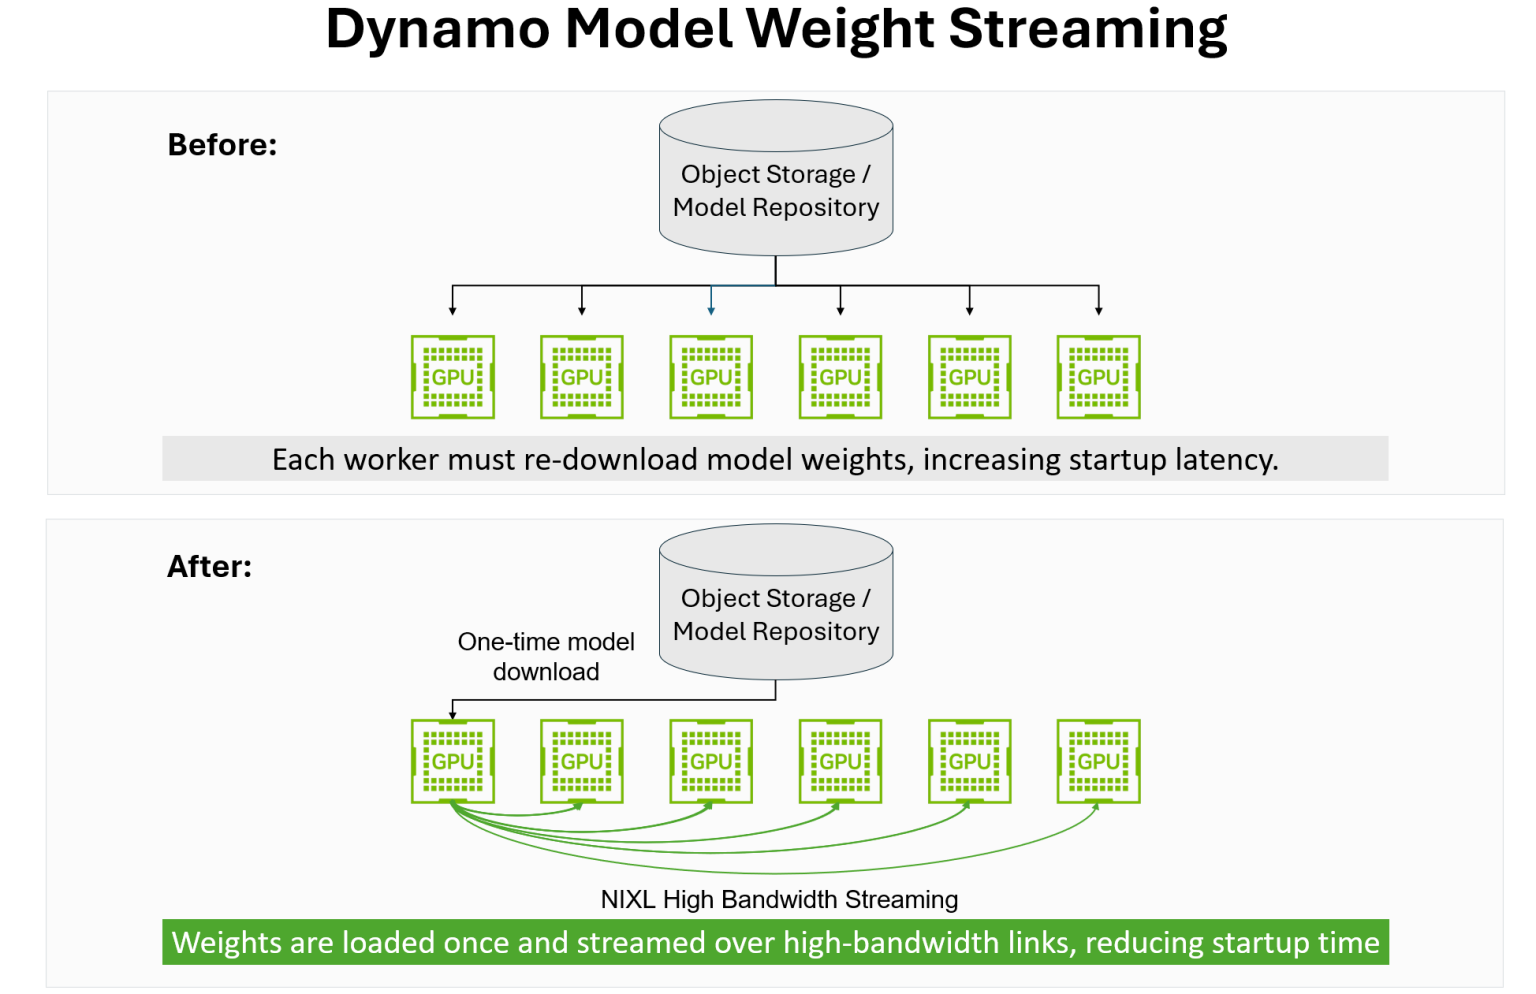
图 3:上半部分展示每个 worker 都从对象存储重复下载权重,下半部分展示一个 worker 完成 one-time model download 后,通过 NIXL high-bandwidth streaming 把权重分发给其他 GPU。它对应的是本文第三节的冷启动债:扩缩容瓶颈从远端存储读取转向可复用的数据面传输。来源:NVIDIA 技术博客。
这部分很容易被看成启动优化,其实它属于容错和弹性控制面的核心。大模型服务的可用性不只取决于请求路径有没有 fallback,也取决于一个新 worker 能不能在可接受时间内变成可路由目标。模型越大、MoE 专家越多、CUDA graph 和 backend-specific 优化越重,冷启动债越会进入 SLO。ModelExpress 把这个债转成可缓存、可传输、可恢复的状态对象。
四、KVBM 把 KV cache 从显存张量变成多层存储对象
Dynamo 1.0 的另一个关键点,是 KV Block Manager 开始承担更清楚的存储系统角色。博客提到 KVBM 新增对象存储支持、global KV event emission,以及可 pip 安装的独立模块;文档也把 Dynamo 的性能组合归纳为 disaggregated serving、KV cache-aware routing 和 KV cache offloading 三件事[1][3]。
KV offload 的意义不只是“显存不够就放到便宜介质”。在长上下文和 agent workload 里,KV block 有身份、有生命周期、有位置、有热度。一个 block 可能在 GPU HBM、CPU pinned memory、本地 SSD、远端对象存储之间移动;router 需要知道它在哪里,indexer 需要维护全局位置,worker 需要决定读取、预取还是重算。Dynamo 的 KVBM event emission 正是在给 router 提供一致的 cluster-wide block location 视图。
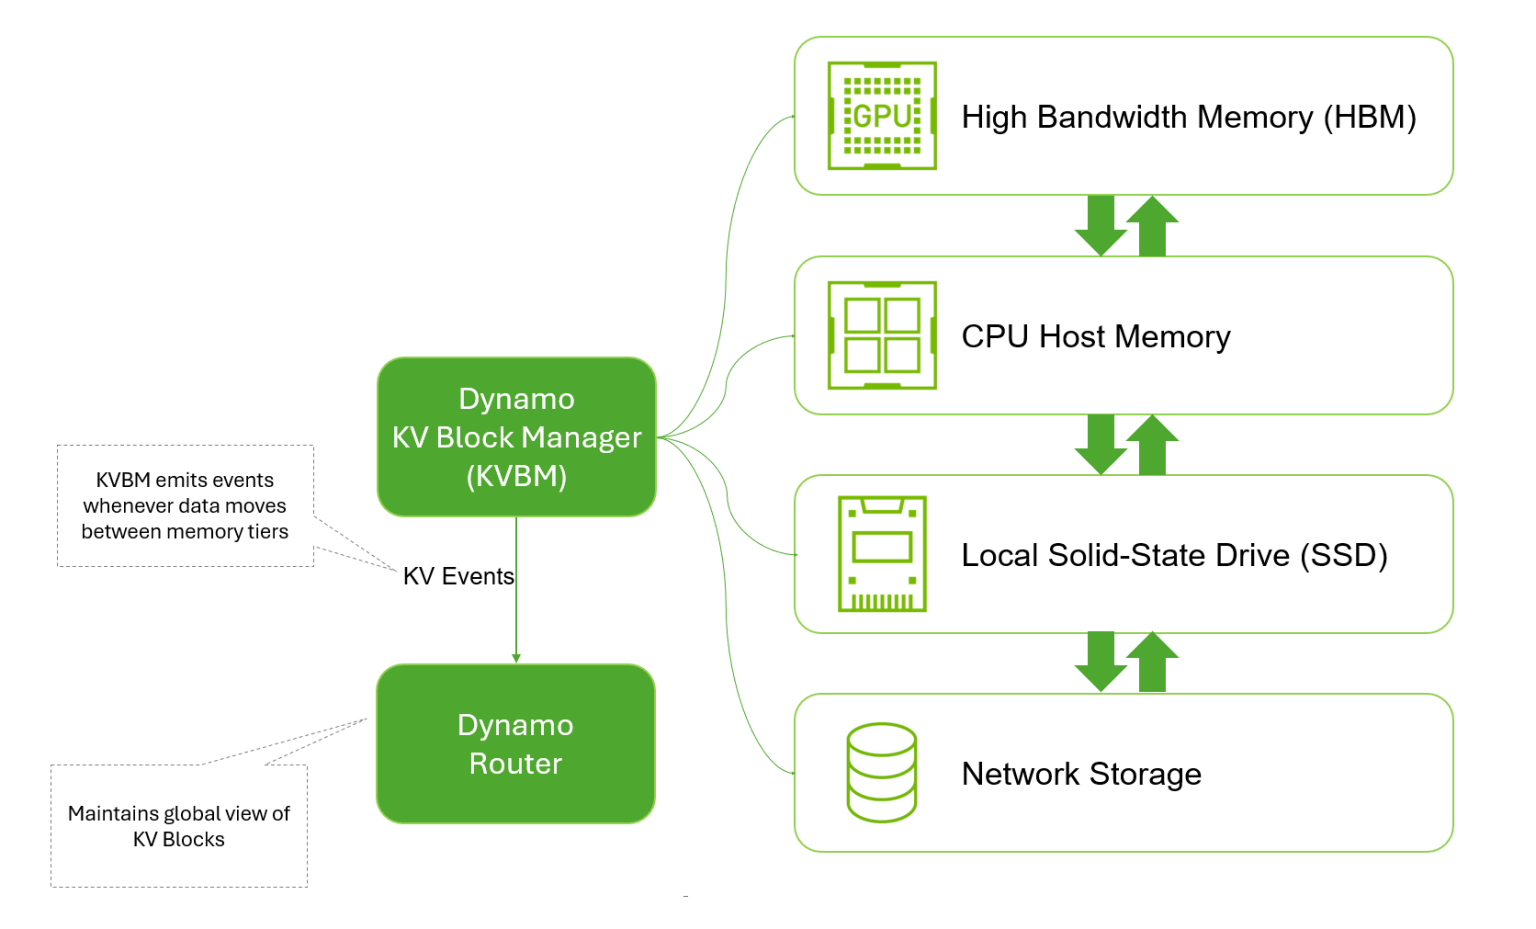
图 4:图中 KVBM 管理 HBM、CPU host memory、本地 SSD 和 network storage 四层 KV cache,并向 Dynamo Router 发出 KV Events,让 Router 维护全局 KV block 视图。它对应的是本文第四节的判断:KV cache 已经从 worker 内部显存张量变成可索引、可迁移、可 offload 的存储对象。来源:NVIDIA 技术博客。
这里有一个工程上的分水岭。传统 engine 内部的 KV cache 管理,主要服务于单 worker 显存利用率;Dynamo 要做的是跨 replica、跨 engine、跨存储层级的 cache locality。NVIDIA 新闻稿把 Dynamo 的核心构件拆成 KVBM、NIXL 和 Grove:KVBM 管内存,NIXL 管快速数据移动,Grove 管 Kubernetes 多节点扩展[2]。这三个名字放在一起,说明 Dynamo 的 KV cache 叙事已经进入数据面:cache block 是可以被索引、迁移、offload、预取和路由的对象。
五、Kubernetes 生产化:拓扑契约比部署脚本更关键
Dynamo 1.0 的 release notes 里,Kubernetes production readiness 占了很重的篇幅:Dynamo Operator、v1beta1 DynamoGraphDeploymentRequest、config versioning、GPU auto-discovery、rolling updates、Inference Gateway EPP integration、LoRA routing-aware placement,以及多种 Kubernetes deployment recipes[4]。这类内容看起来不如 7x 性能数字亮眼,却是“production-ready”最扎实的部分。
多节点推理的部署对象已经超出一个简单 Deployment。一个 Dynamo serving stack 里可能有 frontend、router、prefill workers、decode workers、KVBM、NIXL transfer、Planner、Profiler、Gateway plugin;这些组件还要满足拓扑约束,例如 prefill 和 decode 尽量靠近,KV transfer 避免跨越昂贵链路,frontend 可以放在 CPU-only 节点附近,GB300 NVL72 这类 rack-scale 系统还要理解 NVLink fabric domain[1][3]。
Grove 在这里扮演的是“把角色一起调度”的 Kubernetes 层。它提供 hierarchical gang scheduling、topology-aware placement、多级 HPA、启动顺序和 rolling update 策略[3]。这其实是在给 Kubernetes 补 AI serving 的作业语义:prefill pod 和 decode pod 分开启动但必须共同可用;router 没有 worker 信息就不能可靠路由;worker 启动顺序影响模型加载和 checkpoint restore;拓扑错误会把 P/D 分离的收益吃掉。
六、边界:Dynamo 1.0 仍然是强 NVIDIA 语境下的系统答案
Dynamo 1.0 的价值很明确,边界也要说清楚。第一,它的最强性能叙事建立在 NVIDIA 自己的硬件和软件栈上:GB200/GB300 NVL72、NVLink/NIXL、TensorRT-LLM、CUDA graph、Kubernetes operator、Grove。文档强调 Dynamo 支持 vLLM、SGLang 和 TensorRT-LLM,也提到正在扩展 Intel XPU 和 AMD 硬件支持[3];但从 1.0 的公开数字看,最完整的生产故事仍然围绕 NVIDIA 平台展开。
第二,Dynamo 的复杂度是真实成本。Release notes 里列出大量 breaking changes:KV router flags 改名,disaggregation flag 语义反转,connector flag 被 --kv-transfer-config 替代,KV events 改成显式 opt-in,Planner CLI 改为 config file,Prometheus metrics 命名空间也做了重构[4]。这些变化说明 API 在走向稳定,同时也提醒部署者:Dynamo 1.0 已经比“加一个 router”重得多,它是一套需要版本治理、迁移计划和观测体系的生产平台。
第三,很多收益依赖 workload 结构。Agent hints 对 coding agent 和多轮工具调用很有价值;embedding cache 对重复图像请求有效;ModelExpress 对频繁扩缩容和大 MoE 模型更敏感;KV offload 对长上下文、高复用 prefix、跨 worker cache sharing 更有意义。一个短 prompt、低并发、单模型、单节点服务,未必需要把整套 Dynamo 都搬进去。Dynamo 的合理入口,应该从最痛的系统瓶颈开始:只用 Router、只用 KVBM、只用 NIXL,或者直接采用完整 Kubernetes flow。
七、这篇发布最值得带走的判断
Dynamo 1.0 的主线,已经超出 NVIDIA 发布一个 inference server 的层面。更准确的理解是:推理正在从“模型 engine 的吞吐优化”进入“AI factory 的运行时组织”。当请求变成长会话 agent,模型变成大 MoE,多模态输入带来 encoder/prefill/decode 分离,集群变成 NVL72 rack-scale domain,系统优化就会自然上移到调度、缓存、传输、拓扑和容错。
这也是 Dynamo 1.0 的 production-ready 真正含义。它没有把所有问题一次性解决,也不会替代 vLLM、SGLang、TensorRT-LLM 这类 engine;它在 engine 之上搭了一层让多节点推理可以被配置、被路由、被扩缩、被恢复、被观测的系统软件。未来的推理框架竞争,很大一部分会发生在这层:谁能把 KV cache、agent state、model weights 和 topology metadata 管得更像操作系统,谁就更接近真实生产负载。
参考资料
[1] How NVIDIA Dynamo 1.0 Powers Multi-Node Inference at Production Scale
[5] NVIDIA Dynamo, A Low-Latency Distributed Inference Framework for Scaling Reasoning AI Models
[6] Full-Stack Optimizations for Agentic Inference with Dynamo
版本对齐信息
- Dynamo release:
v1.0.0,tag commitb1818dc,GitHub release 发布于 2026-03-13。 - NVIDIA 技术博客与新闻稿:均发布于 2026-03-16。
- Dynamo docs:引用页面当前显示 Latest
v1.1.1;本文只把它用于组件分层和概念解释,版本判断仍以v1.0.0release 与 1.0 官方博客为准。
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。