IMPRESS 的 KV cache 管理器从 SSD 读回 1.8MB 的数据块,只为了拿到其中 28KB 真正有用的 token——读放大 56 倍。这不是某个极端请求的个案:在 RTE 数据集上跑 Qwen2.5-7B,大约 31% 的请求读放大在 12 倍以上。ContiguousKV 这篇文章要回答的问题很直接:剪枝算法按 token 选重要 KV,I/O 系统按 chunk 搬运数据,中间这道粒度鸿沟是 Re-Prefill 阶段最大的性能瓶颈,而解决它的钥匙不是更聪明的调度器,是让两边用同一种语言说话。
一、Re-Prefill 为什么是瓶颈
长共享 prefix 的推理场景正在变成常态。RAG 中一份文档回答几十个 query,多轮对话中 system prompt 和聊天历史被反复消费,code completion 中同一个文件被多次引用——这些场景的共同特征是大量请求共享一段相同的长 prefix。为了避免每次请求都把整段 prefix 重新 prefill 一遍,系统会把 prefix 的 KV cache 持久化到存储(CPU 内存或 SSD),新请求进来时直接加载复用。这个加载 + 对新 suffix token 做 prefill 的过程就是 Re-Prefill 阶段[1]。
但 Re-Prefill 有两个天生的结构性问题。第一,prefix KV cache 的数据量极大——Qwen2.5-7B 的单 token KV cache 就有约 28KB(3584 hidden dim × 8 KV heads × 2B/float × 2 tensors),128K token 的 prefix 就是 3.5GB。全量加载既不现实也无必要。第二,每层计算都依赖对应的 prefix KV 先加载完——加载和计算之间存在严格的逐层串行依赖,GPU 要么等 I/O,要么算完等下一层的 I/O。
所以现有的 offloading 系统会先做 KV cache 剪枝,只加载被判定为”重要”的 token。SOTA 方案 IMPRESS 就是这么干的[1]:用 H2O 这类注意力分数驱动的剪枝算法选出关键 token,然后从 SSD 加载对应的 KV cache。但这个思路催生了一个新问题——剪枝输出的是一组散落在 prefix 各处的 token 索引,而 I/O 系统的读写单位是以 64 token 为一组的固定 chunk。你只需要 11 个 token,但它们分布在 9 个 chunk 里,系统就得把那 9 个 chunk 全读进来。
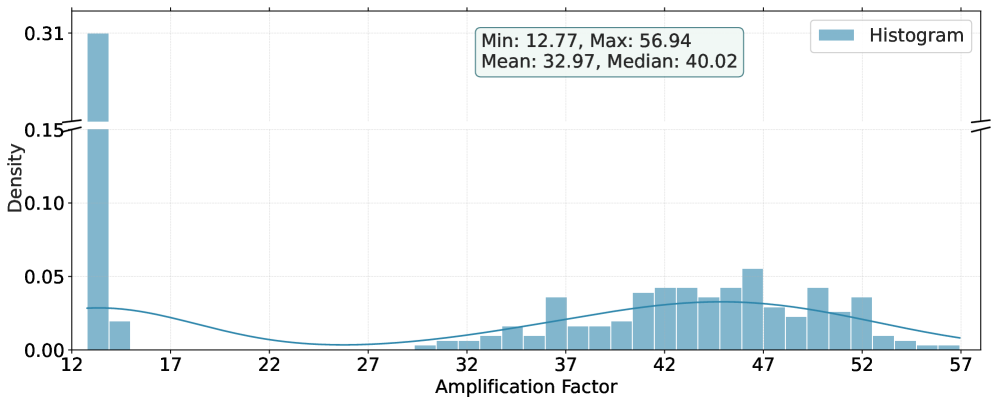
图 1:IMPRESS 在 RTE 数据集上服务 Qwen2.5-7B 时的读放大分布。约 31% 的请求读放大超过 12 倍,极端情况下可达 56 倍。来源:论文 Figure 4。
二、粒度错配的根源
读放大不是实现细节,它直接决定了 Re-Prefill 的资源效率。IMPRESS 的延迟分解显示,在 5%–50% 的 KV cache budget 范围内,I/O 阶段(加载 probe key + 加载关键 KV)始终占据 65% 以上的时延,GPU 计算只占不到 35%。而且即使开了有限的重叠,逐层串行依赖意味着 GPU 仍有大量时间空等数据。
换一个角度理解这个现象:剪枝算法在语义层面工作,它关心的是”哪些 token 对当前 query 最重要”——这是一个 token 到 token 的选择问题,天然是细粒度的。而 I/O 系统在工程层面工作,它关心的是”怎么用最少的 IOPS 读出最多的数据”——为此必须用足够大的读写单元来摊薄每次操作的开销。两套逻辑各说各话,中间没有一个翻译层。
论文把这个问题抽象得很清晰:这是一个算法粒度与系统粒度的错配(granularity mismatch)。剪枝算法输出的是 token 级别的选择结果,但 I/O 接口只能用固定大小的 block 去取数据。当 64-token 的 block 中只有 3–4 个 token 真正需要时,其余 60 个 token(约 1.7MB)的 I/O 纯属浪费。
Qwen2.5-7B: 单 token KV ≈ 28KB
IMPRESS chunk (64 tokens): 64 × 28KB ≈ 1.8MB per chunk
有效 token per chunk: 平均 3–5 个 → 有效数据 84–140KB
读放大: 1.8MB / 100KB ≈ 18x (典型值)
更糟糕的是这种浪费随 chunk size 和剪枝比率同步放大。剪枝越激进(budget 越小),每个 chunk 里需要的数据占比越低,读放大越严重。换句话说,系统越想压缩 I/O 量,越制造出大量无效 I/O——这是一条自我抵消的优化路径。
三、ContiguousChunk:让剪枝和 I/O 说同一种语言
ContiguousKV 的核心思路是把粒度对齐到剪枝算法这一侧,而不是让剪枝迁就 I/O。具体做法是引入 ContiguousChunk——一个 16 token 的连续 token 组——作为系统所有关键操作的最小单元:KV 缓存存储按 ContiguousChunk 组织,重要性评分按 ContiguousChunk 聚合,I/O 读写按 ContiguousChunk 寻址,缓存淘汰也按 ContiguousChunk 决策。
当剪枝算法在 token 级别完成重要性计算后,分数被按 ContiguousChunk 内聚合成一个 chunk 级分数。选定重要的 ContiguousChunk 后,系统读入的每一个 chunk 都完整被计算使用——零读放大。16 token 这个配置不是拍脑袋定的:它刚好让每个 ContiguousChunk 的数据量(Qwen2.5-7B 上约 448KB)处于一个既能有效利用 SSD 带宽、又不会因颗粒太细而变成大量碎片化随机读的平衡点。
这个设计的本质是承认剪枝算法的语义正确性,然后让 I/O 系统去适配它,而不是反过来。代价是数据管理的复杂性上移了——ContiguousChunk 既是存储单元也是淘汰单元,缓存管理的策略必须感知每个 chunk 的语义价值,不能简单地按 LRU 数访问次数。
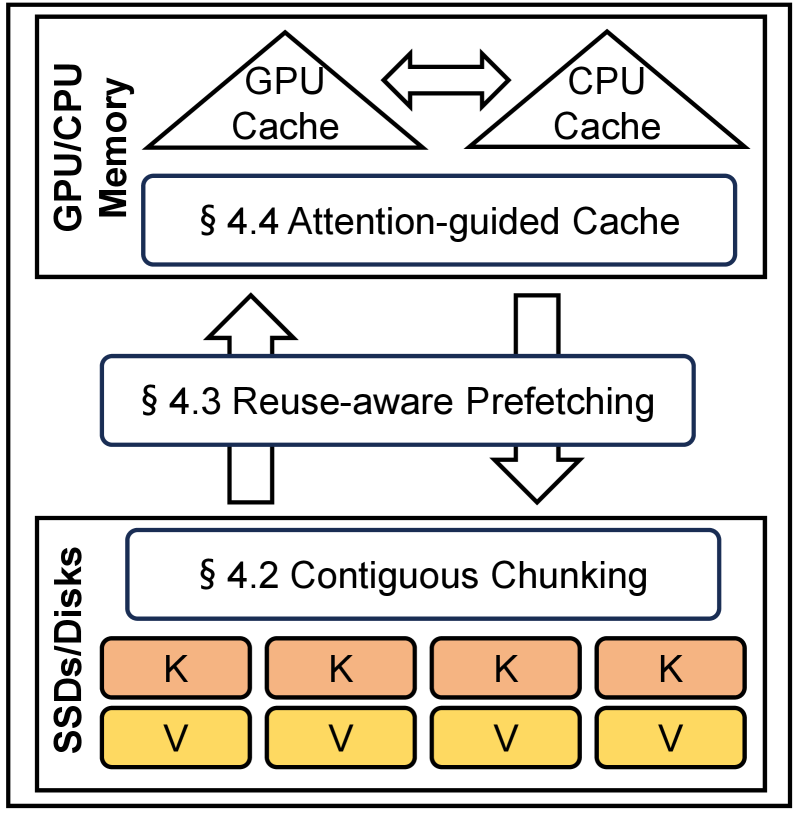
图 2:ContiguousKV 的三层架构:ContiguousChunk 抽象层统一存储和 I/O 粒度,两级预取引擎隐藏 I/O 延迟,注意力驱动的缓存管理器按语义价值分配内存。来源:论文 Figure 6。
四、跨层相似性:预取可以跑在计算前面
消除读放大解决了 I/O 效率问题,但逐层串行依赖导致的 GPU 空转还在。ContiguousKV 的第二步是用预取把 Re-Prefill 变成流水的。
论文做了一个关键的观测:Transformer 各层选出的重要 ContiguousChunk 索引高度相似,尤其是相邻层之间。在这个观测基础上,ContiguousKV 把一个 Period(连续 4 层)内的所有层共享同一组重要 ContiguousChunk 索引,索引由 Period 首层确定,后续层直接复用。
一个观测带来两个层面的预取机会。
Period 内预取:Period 首层完成重要性判定后,系统立刻为 Period 内所有后续层异步发起 KV cache 加载。当 Layer 1 在计算 attention 时,Layer 2、3、4 的 KV 数据已经在 I/O 通道上排队了——这些层轮到计算时,数据大概率已在 GPU 内存就绪。
Period 间预取:相邻 Period 的重要 ContiguousChunk 索引覆盖率在 52%–64% 之间。ContiguousKV 利用这一点,在上一个 Period 完成时就把它使用过的 ContiguousChunk 列表发送给下一个 Period 作为预热候选项。下一个 Period 的判定完成后,只需要补载那些没有被预取覆盖的差异 chunk,I/O 量大幅减少。
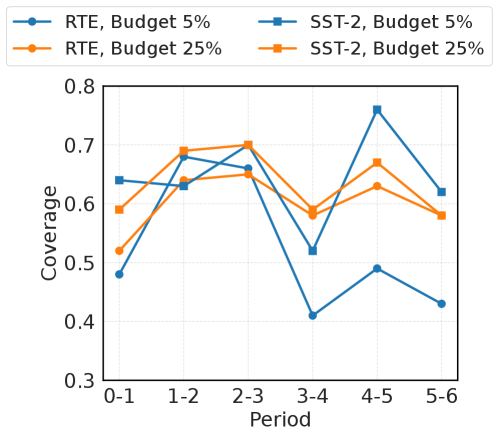
图 3:默认 Re-Prefill 流程(上)中,每层 I/O 和计算串行交替,GPU 和 I/O 子系统交替空闲。ContiguousKV 的两级预取(下)通过 Period 内和 Period 间的异步预取,将 I/O 提前到计算之前,把 Re-Prefill 变成流水线。来源:论文 Figure 8。
把 Period 设置成 4 层是一个权衡:Period 太小(比如 2 层),重要性判定本身的开销占比变大;Period 太大(比如 8 层以上),相邻 Period 的相似性可能明显衰减,预取命中率下降。论文没有给出所有尺寸的敏感性分析,但 52%–64% 的 Period 间覆盖率和 4 层的默认 Period size 在 Qwen2.5-7B 上验证有效。
五、注意力驱动的缓存策略
粒度统一和预取解决了 I/O 效率问题,但 GPU/CPU 内存有限,不能把所有 ContiguousChunk 都缓存。传统缓存策略(LRU、LFU)按访问频次驱逐,IMPRESS 的评分策略也只是把静态重要性权重叠加到访问频次上——它们都不感知当前 query 需求的变化。
ContiguousKV 用 attention 分数来驱动缓存决策。每个缓存的 ContiguousChunk 维护两个动态值:累积注意力重要性(每次参与计算时叠加其 attention score)和访问频率。两者的乘积作为缓存评分。GPU 和 CPU 各自维护一个最小堆,低分 chunk 被逐级降级——从 GPU 驱逐到 CPU,从 CPU 驱逐到 SSD。
这和前面提到的”让剪枝和 I/O 说同一种语言”一脉相承:同一个 ContiguousChunk 既是剪枝的决策单元、I/O 的传输单元,也是缓存的驱逐单元。当一个 chunk 对当前 query 不再重要,它会自然地从 GPU → CPU → SSD 这条链路上逐级下沉,不需要额外的热度衰减逻辑。
六、边界与没回答的问题
论文在 Qwen2.5-7B/14B/70B 上跑出了 3.85 倍的 Re-Prefill 加速(vs IMPRESS),输出质量保持稳定。但有几件事需要保留态度。
第一,实验基于 FlexGen,不是生产级推理框架。FlexGen 的设计目标是极限吞吐而非低延迟,它的调度逻辑和生产系统中以 continuous batching 为核心的调度机制差异很大。ContiguousChunk 的粒度选择(16 tokens)在 Qwen2.5 上验证过,换到 Llama-3(hidden dim 4096、KV heads 8)或 DeepSeek-V3(MLA 架构,KV cache 结构和标准 transformer 不同),最优 chunk size 可能需要重新标定。
第二,Period 大小固定为 4 层,不同模型、不同深度的层间 similarity 分布差异有多大,论文没有展开。对于 70B 模型(80 层),4 层的 Period 意味着 20 个 Period,Period 间的累积误差和预取精度衰减可能成为新的瓶颈。
第三,论文在单请求场景下评测,没有讨论多请求并发下的 I/O 竞争。在实际部署中,多个请求同时发起 Re-Prefill,预取线程池、SSD 队列深度、GPU 显存的争夺都可能改变论文报告的加速比。这一点在 ContiguousChunk 成为 I/O 单元后更值得关注——大量细粒度随机读请求集中爆发时,NVMe 的随机读 IOPS 是否还撑得住。
七、这篇论文最值得被记住的地方
ContiguousKV 的价值不在 3.85x 这个数字本身。这篇文章真正值得记住的,是它换了一种视角看 KV cache 剪枝与 I/O 的关系:粒度差本身就是一个一级瓶颈,从存储、传输到缓存的统一抽象——填平它比优化其中任何一步都重要。
在 AI Infra 领域,这种”对齐两个子系统粒度”的思路反复出现——PagedAttention 对齐了逻辑 block 和物理页[2],RadixAttention 对齐了 prefix 匹配和 Radix tree 的节点粒度[3]。ContiguousChunk 是同一类思路在 offloading 场景下的延伸。如果未来有哪个推理框架把 ContiguousChunk 级别的语义缓存集成进 continuous batching 的 KV block 管理系统,我一点都不会意外。
参考资料
[1] ContiguousKV: Accelerating LLM Prefill with Granularity-Aligned KV Cache Management
[2] Efficient Memory Management for Large Language Model Serving with PagedAttention
[3] SGLang: Efficient Execution of Structured Language Model Programs
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。