一次 Claude Code 任务可能跑 50 次模型调用,每次都背着 30K token 以上的固定上下文。多轮对话、RAG、agent 工具链——这些工作负载的共同特征是:请求之间有大量共享前缀,KV cache 的恢复直接决定了用户感知到的首 token 延迟(TTFT)。
现有系统在这个问题上只有两条路:要么把前缀重新 prefill 一遍,纯算力换时间;要么从外部存储把 KV cache 加载回来,纯带宽换时间。近年也有几项工作尝试让计算和 I/O 重叠,但它们的优化粒度停留在”单个请求”上——对每个请求按 token 维度二分,前半段重算、后半段加载。这个思路的边界在哪里?当多个请求同时挤在共享的 GPU 和 I/O 资源上时,per-request 的最优组合不等于 batch 层面的全局最优。
UIUC 与 NUS 联合团队在 arXiv 上提交的 CacheFlow[1] 提出了一个不同的视角:KV cache 恢复不应该被建模为”重算还是加载”的二选一,甚至不应该是”在哪切分”的一维决策。它是一个多维度可分解的并行调度问题——token 维度、layer 维度、GPU 维度各自暴露了可以被利用的结构化依赖关系。论文的核心贡献在于把这三种并行性统一到了一个名为”双指针调度”的框架下,并且证明最优恢复时间恰好是重算和 I/O 成本的调和平均——无论在什么硬件条件下,这已经是理论上能达到的最好结果。
一、恢复成本的非均匀性:为什么简单的二分不够
先看一组数字:重算 2,000 token 的 KV cache 和重算 500 token,在 Qwen3-8B 上的延迟差距并不大——因为 attention 的二次复杂度在短序列区间被固定开销(kernel launch、权重加载)淹没。但序列拉到 30K token 之后,重算成本开始以超线性速度增长。与此同时,I/O 加载的成本近似线性,带宽越高越接近纯传输时间。这两条曲线不是平行的——它们在不同序列长度区间里各自占优。
这意味着,对每个请求做一个固定的切分点是不够的。一个 500 token 的系统 prompt 和一个 20K token 的多轮对话历史,最优的”重算 vs 加载”比例完全不同。更关键的是,每条请求内部也不是均匀的:attention 机制下,越靠后的 token 重算代价越高(需要 attend 到更多前序 token),所以即使对同一条请求,”前半段重算、后半段加载”这个一刀切策略也不是最优的——它没有利用 token 之间代价的异质性。
CacheFlow 的核心直觉就在这里:既然 token 的代价是非均匀的,而且重算和 I/O 可以并行执行,为什么不从两端同时推进——从前往后重算便宜的 early token,从后往前加载昂贵的 late token?
二、二维双指针:token 和 layer 两个方向上的 meet-in-the-middle
CacheFlow 把上述直觉形式化成了两个维度的双指针策略。
Token 维度的双指针是最直观的一层。给定一个前缀请求,按 FlashAttention 的 block size(通常 512 token)切分成多个 chunk。初始化两个指针——compute pointer 指向 chunk 0,I/O pointer 指向最后一个 chunk。compute pointer 从前往后重算,I/O pointer 从后往前加载,二者并行推进,在某个中间 chunk 相遇时恢复完成。整个过程没有冗余工作:每个 chunk 只被处理一次,要么重算要么加载。
这个设计的关键在于优先级的分配:越靠后的 chunk 重算成本越高(quadratic attention),所以 I/O pointer 从末端开始撤,把最贵的 chunk 优先交给 I/O——前提是带宽允许。如果带宽很窄(比如 10 Gbps 的云实例间链路),加载一个 chunk 的时间可能比重算还长,那 I/O pointer 自然会让出更多工作给 compute pointer。这里的自适应性不是靠运行时 profiling 实现的,而是双指针机制本身的收敛行为——哪个方向处理得快,哪个方向就推进得更远,最终的相遇点自然落在最优位置。
Layer 维度的双指针处理的是另一类情况。当序列很短(比如几百 token)时,重算成本被固定开销主导,token 维度的切分意义不大。CacheFlow 改用 layer 维度:从底层 layer 0 开始前向重算激活值,从顶层 layer L-1 开始反向加载 KV cache,两个指针在某个中间层”切断”。这个策略在短序列场景下比重算所有 layer 或加载所有 layer 都更优,因为它避开了深层 layer(激活值更大、重算更贵)的完全重算。
这两个维度不是二选一。CacheFlow 通过离线 profiling 找出一个序列长度阈值 LΔ——当请求的缓存前缀长度超过 LΔ 时走 token 维度的双指针,否则走 layer 维度。这个阈值是硬件绑定的(GPU 算力、I/O 带宽),与具体输入内容无关,因此可以上线前一次性标定,运行时零开销查询。
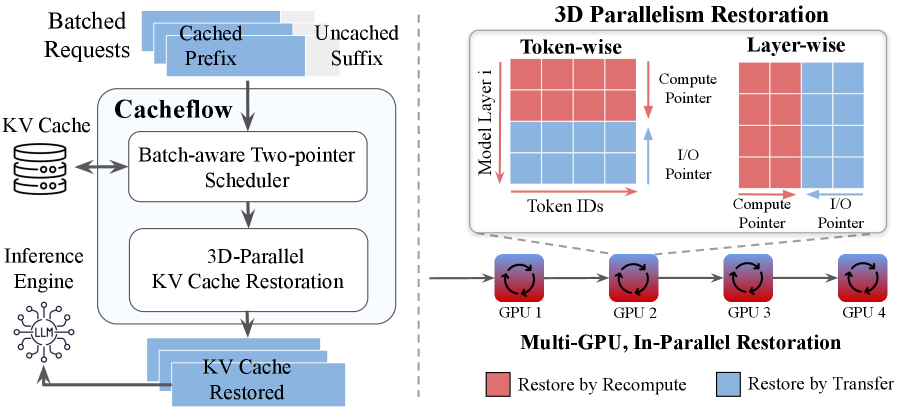
图 1:CacheFlow 的三维并行架构。token 维度和 layer 维度各自独立执行双指针 meet-in-the-middle;多 GPU 维度通过 boundary activations 解耦,各 GPU 并行恢复本地 shard 的 KV cache。来源:论文 Figure 2。
三、第三维:多 GPU 并行的关键——边界激活值
当模型大到需要跨 GPU 做 pipeline parallelism 时,CacheFlow 引入了第三个维度:多 GPU 并行。
直觉上说,如果模型的 L 层被切分到了 S 个 GPU 上,每个 GPU 理论上只能管自己的那 L/S 层。按传统的流水线执行,GPU 0 必须先跑完它的层、把中间激活值传给 GPU 1,GPU 1 才能开始——KV 恢复被串行化了。CacheFlow 的解耦方案很简洁:每个 GPU 在缓存 KV cache 的同时额外存储一份”边界激活值”——即该 GPU 负责的第一层所需要的输入 hidden state。这个量远小于整个 KV cache(只是一个 token embedding 级别的向量,不是所有层的中间状态),存储和传输开销可以忽略。
有了边界激活值,每个 GPU 可以在不等待上游的情况下独立启动本地 KV cache 恢复。论文的推导表明,在理想条件下——各 GPU 的层数分配均衡、I/O 带宽均匀——多 GPU 并行带来的加速比恰好是 S 倍(见论文公式 2)。实验也印证了这个分析:在 2×L40S 部署下,CacheFlow 相比纯 2D(单 GPU 内 token+layer 并行但跨 GPU 串行)平均恢复延迟从 0.29s 降到 0.21s,提升 38%。
这里有一个值得细品的细节:边界激活值之所以能工作,是因为 transformer 的层间信息流是单向的——layer i 的输出只依赖 layer i-1 的输出。这个架构特性在分布式推理里通常被视为并行度的约束(pipeline bubble),CacheFlow 反过来把它变成了并行恢复的前提条件。同样的结构特性,换个角度看就成了资源。
四、批级调度:当”每个请求都最优”不再是全局最优
前三个维度解决的是单个请求内部的并行性。但生产环境里 GPU 和 I/O 带宽是共享资源,多个请求同时恢复 KV cache 时会出现争用。CacheFlow 在这里做了整篇论文里最务实的扩展:把双指针的优先级从 per-request 推到了 batch 级别。
具体做法:每个请求维护自己的 compute pointer 和 I/O pointer,但 I/O 带宽的分配不由请求各自决定,而是由一个全局调度器按”剩余重算成本最大优先”的规则分配。逻辑很直接——长请求的尾部 token 重算成本最高(quadratic attention),把有限的 I/O 带宽优先分配给它们,能避免最多的重算工作。短请求的 I/O pointer 即便推进慢一些,compute pointer 也能较快地追上,因为短序列的重算本来就不贵。
这个设计把一个看似复杂的批级优化问题简化成了一个贪心策略:每次迭代把 I/O 带宽分配给”当前剩余工作最多的请求”。论文的消融实验显示,batch size 从 2 增到 8 时,CacheFlow 相比纯 per-request 策略的加速比从 1.6× 升到了 2.6×——批量越大,全局调度的收益越显著。这正好印证了论文开篇的判断:per-request 最优在批处理场景下是不够的。
五、实验结果:10%–62% 的 TTFT 下降说明了什么
CacheFlow 在 Qwen3-8B、Llama-3.1-8B、Qwen3-30B-A3B 三个模型上做了评测,覆盖了 L40S、A100、H100 三种 GPU 和 10/40/80 Gbps 三种 I/O 带宽条件。工作负载选了 WildChat(开放域对话)、LMSys-Chat(多轮对话)、SWE-Bench(agent 编码)三类真实 trace。
整体 TTFT 降低 10%–62%。这个跨度本身就透露了一个论文没直接说的信息:恢复瓶颈到底有多严重取决于工作负载和硬件。在最理想条件下(短序列 + 高带宽),现有方案已经不差;在长序列 + 低带宽的条件下,CacheFlow 的改进空间最大。从 CDF 图来看,CacheFlow 在所有分位数上都左移了曲线,尾部(P90–P99)改善尤其明显——这说明批级调度有效压低了 straggler 效应,不只是在平均值上好看。
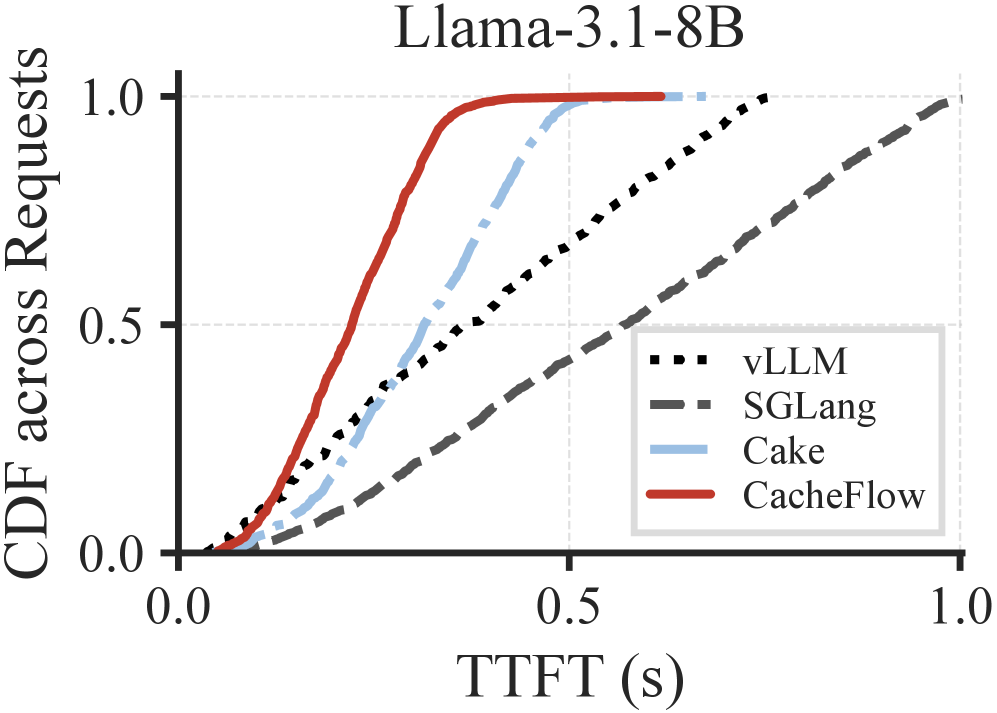
图 2:WildChat 工作负载下的 TTFT 累积分布。CacheFlow 在所有分位数上左移 CDF,尾部改善尤其明显。来源:论文 Figure 4(a)。
资源利用率的变化比延迟数字更能说明 CacheFlow 做了什么。LMCache 纯加载时 GPU 利用率只有 10%,I/O 拉满;vLLM 纯重算时 GPU 91% 但 I/O 空闲。CacheFlow 同时把 GPU 拉到 88%、I/O 拉到 78%——让两个维度的闲置时间互相填满。把这组数字和前面双指针的设计放在一起看,改善的来源就很清楚了:双指针机制让 I/O 等数据的时候 GPU 在重算,重算等前序 token 的时候 I/O 在加载,两个维度的空闲 slot 被交叉覆盖。
序列长度的影响也很直接。6K token 时 CacheFlow 相比 vLLM 和 SGLang 快 1.1×,30K token 时快 1.7×。vLLM 的纯重算策略在长序列下呈现超线性增长,CacheFlow 通过计算与 I/O 重叠把增长曲线压得更平缓。双指针优先把 I/O 用在了尾部——而尾部恰好是 attention 成本最高的区域。
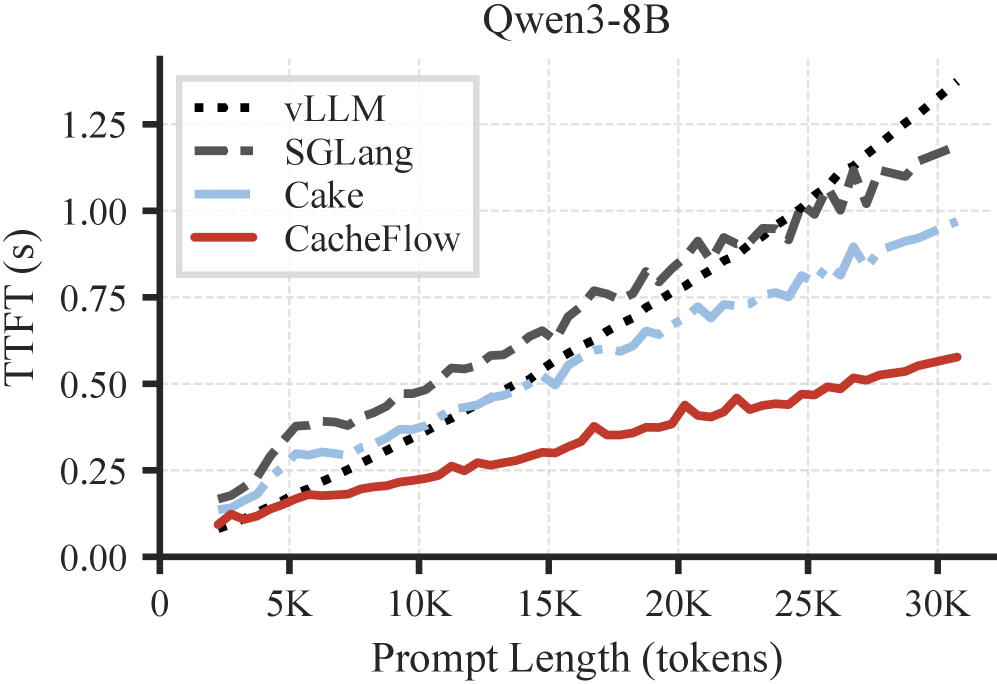
图 3:不同序列长度下的 TTFT。vLLM 纯重算随序列长度超线性增长,CacheFlow 通过计算与 I/O 重叠将增长曲线压平。来源:论文 Figure 6。
有一组实验比论文自己强调的数字更有信息量:在 40 Gbps 和 80 Gbps 下,CacheFlow 相比最优 baseline 的加速比分别是 1.7× 和 1.5×。带宽越高,加速比反而越小。这说明 CacheFlow 的核心价值不在”让 I/O 更快”,而在于”让 I/O 和计算各自做自己擅长的事”——带宽有限时 I/O 是瓶颈,CacheFlow 通过计算 overlap 补上了等数据的空闲;带宽充足时纯 I/O 方案已经很快,CacheFlow 的额外收益主要来自批级调度对 straggler 的压制。
六、边界与疑问
读完这篇论文,我的核心判断是:CacheFlow 对 KV cache 恢复问题的重新建模——从单维二选一到多维并行调度——是这个方向上一个值得认真对待的框架切换。它的理论优雅度在于:证明了”最优恢复时间的下界就是重算和 I/O 成本的调和平均”,然后通过三维双指针达到了这个下界。从”选重算还是选加载”到”把这个有向无环依赖图并行化”,这是问题建模层面的切换,比任何一个具体切分策略都更有生命力。
但论文没有回答几个问题。第一,双指针策略的前提是”重算和 I/O 可以真正并行执行”,这要求 GPU 有足够的 computing unit 和 memory bandwidth 同时跑 prefill kernel 和 PCIe/NVLink 数据传输。在消费级 GPU 或共享云实例上,这个假设未必成立——论文的实验全在数据中心级 GPU 上完成,没有覆盖 T4/L4 这类更受限的硬件。第二,边界激活值的存储开销随 GPU 数量线性增长,论文没有给出不同模型规模下的具体存储增量数据,这对 8 卡或 16 卡 TP 的大规模部署是一个需要验证的变量。第三,Layer-wise 双指针策略依赖离线 profiling 来确定 LΔ 阈值,但没有讨论 profiling 在不同 GPU 代际之间的可迁移性——在 H100 上测出的 LΔ 能不能直接用在 B200 上?
还有一个更高层面的问题:CacheFlow 的整个设计建立在”KV cache 需要从外部存储恢复”这个前提上。如果未来 GPU 显存继续增长、或者 KV cache 压缩技术(量化、token 剪枝)把单请求缓存压缩到了可以常驻显存的量级,那恢复问题本身的紧迫性就会下降。这个方向值得关注,但它不改变 CacheFlow 的方法论价值——把”看起来只能串行做的事”拆成可并行的依赖图,这个思维方式不绑定具体瓶颈。
参考资料
[1] CacheFlow: Efficient LLM Serving with 3D-Parallel KV Cache Restoration
[2] vLLM: Efficient Memory Management for Large Language Model Serving with PagedAttention
[3] SGLang: Efficient Execution of Structured Language Model Programs
[4] LMCache: An Efficient KV Cache Layer for Enterprise-Scale LLM Inference
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。