提到用 SSD 做 KV Cache,做过部署的人第一反应是”太慢了”。但慢在哪?SSD 的读写带宽并不低——论文里用的 Solidigm D7-PS1010 企业级 SSD 单盘峰值读带宽就超过 10 GB/s。真正的问题不是带宽不够,而是带宽用不出来。PagedAttention 把 KV cache 切成 16-32 token 的碎片页,一次 128K 上下文的 KV 恢复需要发出 25 万次散落的小 I/O。CPU 依次发起这些 I/O、处理中断、同步 GPU——这一串控制面上的开销把有效带宽打到了实际可用带宽的零头。这篇文章读的 Tutti 论文[1],做的核心事情就是把 CPU 从 KV Cache I/O 的控制路径上拿掉,让 GPU 自己管自己的存储。
一、SSD 接入 KV Cache:带宽够用,控制面跟不上
论文把问题拆得很清楚。LLM 推理系统里 KV Cache 的容量已经成了 MaaS 的核心成本瓶颈——HBM 放不下,DRAM 也不够(论文数据:即使 2TB DRAM 也只够存约 5 分钟的 KV cache),最终必须落到 NVMe SSD 上。但一旦落到 SSD,paged memory layout 就把存储性能彻底拖垮了。
具体来说,vLLM 和 SGLang 把 KV cache 按 token 维度切成不连续的 block(每块 16-32 token),这是 GPU 内存管理的标准做法[2]。但当这些 block 被 evict 到 SSD 再 reload 时,逻辑上连续的 KV cache 变成了几十万次小块随机读。以 Qwen3-32B 为例,64 层、block size 64、128K token 的 KV 恢复,需要 fetch 约 25.6 万个散落的 80KB 对象——每次 I/O 都需要 CPU 发起、处理文件系统元数据、做地址转换、同步 GPU。
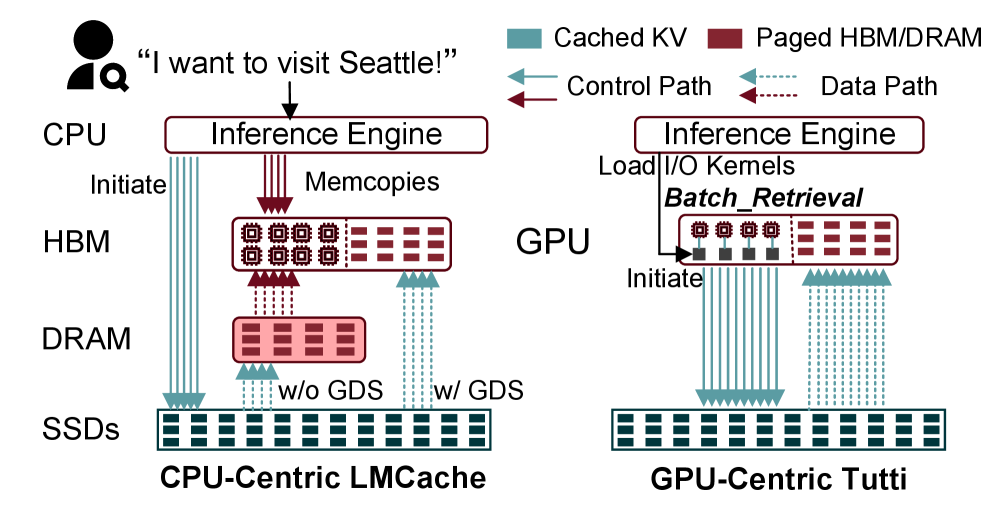
图 1:CPU-centric(左,LMCache 含 GDS)与 GPU-centric(右,Tutti)的 KV Cache 访问路径对比。GDS 虽然绕过了 CPU 的内存拷贝,但每个 I/O 仍需 CPU 发起。来源:论文 Figure 1。
GDS(GPU Direct Storage)被很多系统视为 SSD KV Cache 的解法,它确实能跳过 CPU-GPU 之间的数据搬移,让 SSD 和 GPU 通过 PCIe P2P DMA 直接通信。但论文指出一个关键事实:GDS 只解决了数据面的问题,控制面仍然在 CPU 手里——每个 I/O 请求仍然需要 CPU 构造、提交到 NVMe 队列。在 25 万次小 I/O 的场景下,CPU 的 I/O 提交吞吐量本身就成了瓶颈。
论文在 vLLM v0.17.0 上跑了实测:LMCache-SSD 的 GPU bubble time 超过 70%(也就是说 GPU 有七成时间在等数据);开了 GDS 之后,GPU bubble 仍然高于 70%。更糟的是,vLLM 版本越新、计算越快,SSD 这一侧的 I/O 瓶颈就越突出——在 v0.12.0 上 SSD 还勉强比 recomputation 快一点,到了 v0.17.0 就已经不如重算了。
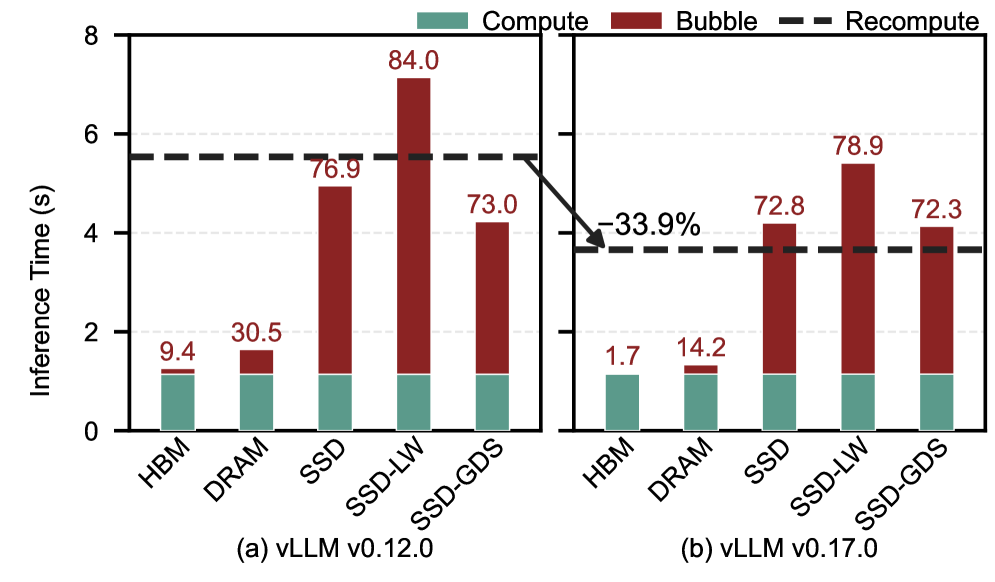
图 2:Llama3-8B 在 64K 序列、75% 缓存命中率下的 GPU bubble 时间对比。虚线为 recomputation 性能。DRAM 退化的轻,SSD 即使上了 GDS 和 layer-wise pipelining 仍然有超过 70% 的 bubble。来源:论文 Figure 2。
这就引出了 Tutti 要解决的核心问题:不是让 SSD 更快,而是让 GPU 能自己发起和管理对 SSD 的 I/O,把 CPU 从控制路径上完全移走。
二、Tutti 的设计逻辑:让 GPU 管自己的存储
Tutti 的设计有一条非常清晰的逻辑线:既然瓶颈在 CPU 的控制面开销,那就让 GPU 自己直接操作 NVMe 队列。但这条路走起来有三层挑战。
第一层是抽象。GPU-centric storage 在块设备和文件系统层面已有工作(BaM[3]、GeminiFS[4]),但这些抽象对 KV cache 不直接适用——LLM 引擎需要的不是读写一个文件或块,而是在 GPU 显存和 SSD 之间按 layer 批量搬动 KV block。Tutti 在 GeminiFS 之上构建了一个 GPU-centric KV cache object store:每个 GPU 内存 block 映射为一个 object,每个 object 通过 Tensor-Stripe 布局对应到 NVMe 文件上的物理 extent,CPU 只负责异步地把 I/O 描述符(IOCB)准备好丢给 GPU,剩下的由 GPU 自己完成。
第二层是 I/O 提交。这里 Tutti 做了一个关键的设计选择:GPU io_uring(gio_uring)。模仿 CPU 侧 io_uring 的思路,GPU 侧也搞了一对 lock-free ring buffer(SQ/CQ),驻留在 GPU HBM 里但通过 non-cached mmap 让 CPU 可见。CPU 在 off-critical-path 上准备好 IOCB——每个 IOCB 最多携带 2048 个 I/O context——然后 GPU kernel 从 SQ 里取走、提交、等 CQ 完成,全程不经过 CPU。同时通过 NVIDIA green context 做硬件级 SM 分区,把 I/O kernel 和 compute kernel 隔离到不同的 SM 域,避免 I/O 占用 compute 资源。
第三层是调度。这是论文最精妙的部分,也是很多系统工作容易忽略的地方。单纯做异步 I/O + SM 分区还不够,因为两个隐藏的竞争会把性能打回去:
一个是 读写 I/O 之间的带宽互殴。论文发现,当读写并发打在同一个 SSD 上时,总带宽不是简单的加法分享——而是直接掉 60%。原因是 NVMe 内部 cache 被大块读和写同时争夺,导致 SSD 内部效率急剧下降。
另一个是 I/O kernel 和 compute kernel 抢 SM。在非抢占式 GPU 调度下,一个长时间运行的 I/O kernel 可以让关键的 compute kernel 排队等资源。
Tutti 的解法是 slack-aware I/O scheduler:离线 profiling 每一层在不同 prefix 长度下的 compute slack window(计算间隙里有多余的 SM 且没有读写冲突),在线根据查表决定何时发多少 I/O。读优先于写(读在 prefill 的 critical path 上,写延迟到 decode 阶段处理),读写不并发(避免带宽互殴),发 I/O 不超出 profiled slack 窗口(避免抢 SM)。
这一套设计下来,CPU 的参与从 O(layer × blocks) 降到了 O(layer)——这个降维是整个架构的逻辑锚点。
三、两个容易被忽略的工程选择
除了三条主线设计,论文里有两个细节值得单独拿出来说,因为它们是 Tutti 能跑到 25.9 GB/s 检索带宽的直接原因,但很容易被”GPU 直接操作 NVMe”这个大叙事盖过去。
第一个是 SGL 替代 PRP。NVMe 要描述 GPU 显存地址给 SSD 控制器,有两种方式:PRP(Physical Region Page)需要每 4KB 一个指针,对于一个 60GB KV cache 池来说,PRP list pages 本身就要吃掉 3.75GB HBM。Tutti 换成 SGL(Scatter Gather List),每条 SGL entry 只需 16 字节描述一大块连续内存,同样 60GB 的映射表降到约 15MB。带来的不只是内存节省——SGL 减少了 PCIe 上 control path 的开销,论文的 microbenchmark 显示 SGL 的读写带宽分别是 PRP 的 31 倍和 91 倍。这个数放在 AI Infra 的优化里不多见——通常几个百分点的提升就值得写一段了,91 倍的差距说明 PRP 在 KV cache 场景下基本是废的。
第二个是 staging buffer 引发的 OOM。LMCache-GDS 依赖 cuFile 驱动做 GDS 传输,cuFile 需要在 GPU 显存里分配 staging buffer——在长上下文中这个 buffer 会直接撑爆显存。论文在 GLM-4-9B-Chat-1M(支持 1M token 上下文)的 2-GPU 测试中,LMCache-GDS 在 512K 和 640K prefix 上直接 OOM 挂掉,而 Tutti 因为是推理引擎 native 的内存管理、不需要单独 staging buffer,成功跑到 640K 且 TTFT 仅 1.2 秒。这个对比的价值不在于 Tutti 更快——而在于 I/O 加速方案如果以”第三方插件”的方式嵌入推理引擎,在极端场景下可能连活都活不下来。
四、实验结果的核心信号
论文在 LEval 和 LooGLE 两个长上下文 benchmark 上跑了一系列实验,用的是 Llama3-8B 单卡和 GLM-4-9B-Chat-1M 双卡 TP。先把四个最有信息量的数字列出来:
- TTFT 降低 78.3%:在 vLLM v0.17.0 + LEval 最高负载点,Tutti vs LMCache-GDS 的 TTFT 从不可用的高延迟降到了可上线级别。
- 请求率翻倍:在 1s TTFT SLO 约束下,Tutti 的 achievable request rate 是 GDS 的 2 倍、DRAM 的 1.5 倍。
- 成本降 27%:按 H100 $5/小时、DRAM $0.0088/GB/h、SSD $0.000082/GB/h 的云定价,SSD 比 DRAM 便宜约 100 倍/GB。Tutti 把 SSD 带宽用到了接近物理上限,避免了 GDS 方案因 I/O 瓶颈导致的 GPU 利用不充分。
- 检索带宽 25.9 GB/s vs 11.9 GB/s:双 SSD RAID-0 下,Tutti 的 raw retrieval bandwidth 是 LMCache-GDS 的 2.08 倍,且在不同序列长度下保持线性增长,而 LMCache-GDS 在 11.9 GB/s 就饱和了。
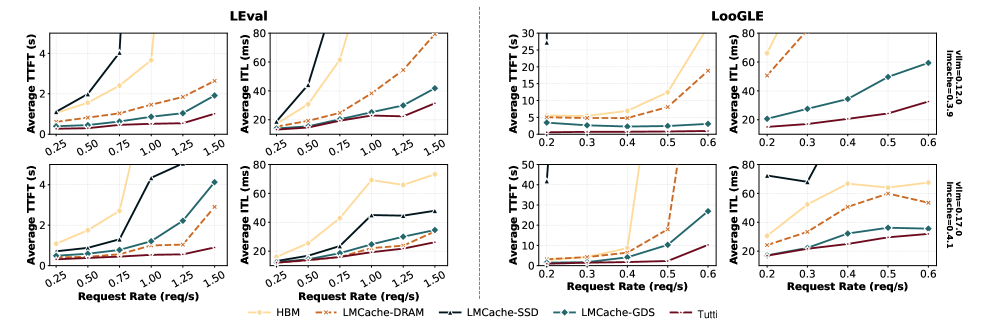
图 3:Llama3-8B 在 LEval 和 LooGLE 上的端到端 TTFT 与 ITL,对比 vLLM v0.12.0 和 v0.17.0 两个版本。Tutti 在所有请求率下保持最低且最稳定的延迟曲线。来源:论文 Figure 8。
但我觉得这些数字背后有一个更值得记住的信号,在 ablation study 的 Figure 13 里:Tutti 把 compute→I/O-bound 的 crossover point 推到了 98.3% 的缓存命中率。在此之前 GPU bubble 基本为零(平均约 25ms)。对照 LMCache-SSD 的 crossover 远低于这个数值。这意味着在绝大多数生产场景下——只要命中率没到 98% 以上——SSD KV cache 在 Tutti 上的表现和 DRAM 没有实质区别,而 SSD 的容量几乎是无限的。论文自己也说了:”SSD-backed Tutti achieves nearly the same inference performance as DRAM-backed LMCache, while providing almost infinite capacity.”
五、适用边界
这篇论文解决了一个关键的工程节点,但也有一些边界需要标注。
首先,Multi-node scaling 目前还只完成了 node-local 的快速路径。论文提到未来会做 GPU-initiated RDMA 来实现跨节点的 GPU-to-GPU KV 传输,但当前版本跨节点时仍然需要 CPU 中转。所以 Tutti 现在更适合单机大容量 SSD 场景——这对于大多数 MaaS provider 来说已经覆盖了主要需求,但在超大规模集群下还不是端到端的 GPU-centric。
其次,slack-aware scheduling 依赖离线 profiling。profiling 结果可以在同一部署配置下复用,但换模型、换 GPU、换 vLLM 版本都需要重新跑一轮。论文没有讨论 profiling 的自动化程度和耗时,这对实际部署中的运维成本有直接影响。
第三,论文目前的集成仅限于 vLLM,通过 KVConnector 接口实现的。SGLang 等其他推理引擎走的是自己的 KV cache 管理路径,移植成本不同。不过 Tutti 的核心组件(gio_uring、slack scheduler)本身是推理引擎无关的,上层适配不应该构成根本障碍。
最后,这篇论文最大的价值可能不在 Tutti 这个系统本身,而在于它把一个很多人默认接受的假设打了个问号——”SSD 做 KV cache 就是慢,没法跟 DRAM 比”。论文的数据说明,慢的不是 SSD,是把 SSD 当块设备用的那一层 CPU control path overhead。只要把这个 overhead 消除,SSD 的物理带宽足够支撑生产级的 KV cache serving。这个结论对其他在做 KV cache tiered storage 的团队,值得认真对待。
参考资料
[1] Tutti: Making SSD-Backed KV Cache Practical for Long-Context LLM Serving
[2] Efficient Memory Management for Large Language Model Serving with PagedAttention
[3] BaM: A Case for Enabling Fine-Grained High Throughput GPU-Orchestrated Access to Storage
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。