KV cache offloading 这个方向过去两年最热闹的话题是”怎么找到更少的 critical KV 条目”。从 Quest 的空间分块到 MagicPIG 的 LSH 近似,再到 PQCache 的乘积量化,各家都在卷一件事:用更小的索引、更少的计算,尽可能准地挑出那些对当前 query 最重要的 key-value 对。KVDrive[1] 这篇来自港科大的论文没有继续加码这条路线,而是问了一个更基础的问题:找到之后怎么办?
这个问题的实际分量比看起来重得多。论文在 L20 服务器上的实测数据显示,现有 offloading 系统中,KV 选择(selection)和取数(fetching)两个阶段合计占了将近 50% 的解码时间——它们串行执行,GPU 在此期间大量空闲。更关键的是,当 batch size 和上下文长度同时放大,这个问题不是线性的:batch=8、上下文 122K 时,Llama-3-8B 的 KV cache 已经接近 100GB,远超任何单卡显存,而 DRAM 也很快被塞满。KVDrive 的核心判断是,瓶颈不在”选得准不准”,而在”选出来之后怎么管理、怎么搬、怎么用”——这是一个系统问题,不是算法问题。
一、问题的重新定位:三个发现
KVDrive 通过一组消融实验把问题拆成了三个具体发现,每个发现都指向一个被忽略的系统瓶颈。
第一,critical KV 条目有跨步时间局部性。现有系统大多遵循”用后即弃”的模式——每个解码步选出一组 critical KV,用完就扔掉。ShadowKV[2] 和 PQCache[3] 做了小幅改进,保留最近一步的条目(窗口 ×1),复用率有限。KVDrive 的分析往前多看了一步:连续多步的 critical KV 条目之间存在显著重叠,扩大滑动窗口能带来远超线性比例的传输减少。具体来说,在 6.25% 稀疏预算下,窗口从 ×0 提升到 ×3,每步的 host-to-GPU 传输量从 500MB 以上降到了不到 12.5MB。这个发现意味着,用额外一点点 GPU 显存做缓存(模型参数和中间激活占完之后通常还有余量),能换来传输量的数量级下降。
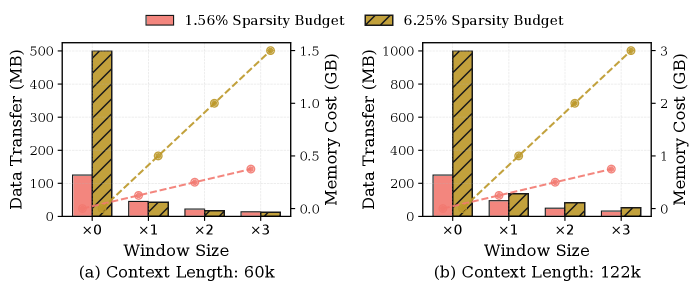
图 1:扩大 critical KV 滑动窗口可大幅减少 host-GPU 传输量。在 6.25% 稀疏预算下,窗口从 ×0 到 ×3,每步传输从 >500MB 降至 <12.5MB。来源:论文 Figure 3。
第二,KV 选择加取数占解码时间近 50%,且随 batch size 和上下文长度一起放大。三个代表性系统的时间分解图很直白——选择(selection)和取数(fetching)的阶段占比越来越重。Quest[4] 的选择延迟最重,因为每个 query 要同时跟 chunk 的 min 和 max key 比较;ShadowKV 用均值 key 做代表,选择快一些;RetroInfer[5] 用聚类 centroid,更快一点。但不管哪种索引方案,它们都串行执行选、取、算三步,直接把 GPU 卡在等数据的空档期。
第三,直接把 SSD 当成大号慢 DRAM 是死路。论文测试了一个受 FlexGen[6] 启发的 strawman 方案——把 KV cache 以 memory-mapped 方式存到 SSD 上,每层用时再按需加载。结果吞吐量惨不忍睹:GPU-SSD 带宽瓶颈让解码几乎停滞。但当 KVDrive 用稀疏同步替代整层搬移、用 SSD-aware 布局做连续 I/O 后,SSD 配置仅比纯 DRAM 方案低 40% 吞吐量——这是一个质的差别。
这三个发现放在一起指向同一个结论:KV cache offloading 的瓶颈不在空间选择精度,而在时间调度效率。滑动窗口缓存解决的是”能不能少搬”的问题;弹性流水线解决的是”搬的时候 GPU 别闲着”的问题;三层存储解决的是”DRAM 放不下的时候别崩盘”的问题。三个机制互相依赖——缓存命中率越高,流水线要搬的数据越少;流水线越密集,SSD 延迟越能被掩盖。
二、系统架构与核心机制
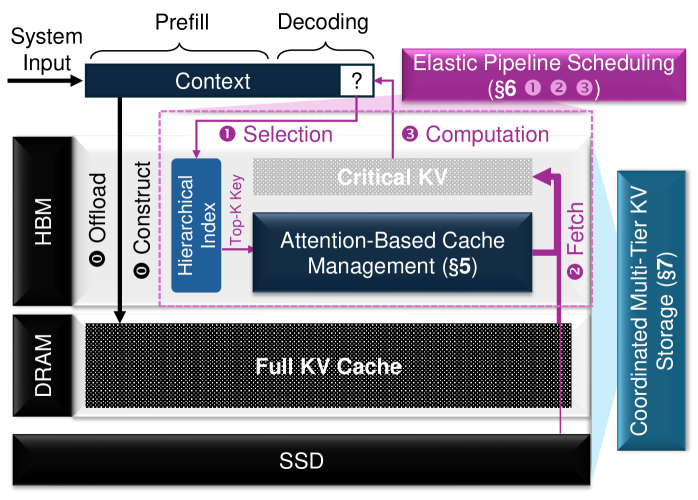
图 2:KVDrive 系统架构。prefill 阶段将全量 KV cache 卸至 DRAM/SSD 并构建分层索引;解码阶段通过弹性流水线调度(①选择→②取数→③计算)协同三层存储。来源:论文 Figure 6。
KVDrive 的系统架构(图 2)把解码流程拆成三个独立调度的阶段:通过 GPU 上的分层索引选出 critical KV 条目,从 DRAM 或 SSD 中抓取这些条目到 GPU HBM,在 GPU 上对缓存命中条目和新抓取条目的并集做 attention 和前馈计算。
索引设计上,KVDrive 结合了空间分块和相似性聚类,采用了一个分层结构。KV cache 先按 chunk 分块,每个 page 的 mean key 作为代表,再往上形成 cluster centroid。论文声称相比全局 K-means 的 ANNS 方案,这个分层结构保留了连续 token 之间的语义连续性,检索精度更高;相比纯空间分块(Quest、ShadowKV),匹配精度持平,但索引体积缩小 50%,查找速度提升 2×。索引小不仅省显存,更重要的是让 selection 阶段变快——这是流水线第一环的关键延迟。
三个核心机制——attention-aware 缓存管理、弹性流水线、多层存储——形成一个闭环。缓存管理决定哪些数据需要搬运(减少数据量),流水线决定搬运跟计算的时序关系(掩盖延迟),多层存储决定数据放在哪里(扩大容量上限)。
三、滑动窗口缓存:用注意力信号替代 LRU
KVDrive 的 in-GPU 缓存方案最有启发性的地方不是工程实现,而是思路的转向:它用模型自身的注意力分数代替了传统的 LRU/LFU 作为缓存替换策略。
这是一个非直觉的决策。LRU 和 LFU 依赖的是访问历史——最近用过的、或者最频繁用过的,就保留。但 transformer 的注意力机制天然提供了一个更好的信号:当前步的注意力分数本身就指示了哪些 KV 条目在下一步更可能被重用。论文验证了这一点——在当前步排名前 M 的 critical KV 条目,在下一步的 Top-K 集合中出现的概率很高,而且随着 M 增大,这个重叠率上升后快速饱和。把缓存预算集中在高注意力条目上是高效的策略。
具体实现上,KVDrive 在 GPU 显存里维护了一个覆盖最近若干步的滑动窗口,窗口大小由离线 profiling 决定——在参数、激活、buffer 之外能塞多少就塞多少。每一步窗口向前滑动一个 token:新 critical KV 从 host memory 抓取,窗口内注意力分数最低的老条目被淘汰。这个 lookahead eviction 策略直接让约 80% 的 critical KV 条目在 GPU 缓存里命中,意味着每步只有约 20% 的数据需要真正过 PCIe。
更精妙的是 2D 窗口缩放。不同层的不同 attention head 对窗口大小的敏感度差异很大。有些 head 扩大窗口带来远超平均的传输减少,说明它们在建模长距离依赖;有些 head 扩大窗口收益很小,说明它们主要关注局部。KVDrive 把这个问题形式化为变种多重选择背包问题(MCKP),给每个 layer-head pair 分配不同的窗口大小,用贪婪算法离线求解,几分钟就跑完。最终效果是:同样的 GPU 缓存预算下,传输量比统一窗口分配更低。
论文在实验中还做了一个有意思的消融:把 lookahead eviction 策略单独扣出来,装到 Quest、ShadowKV、RetroInfer 上跑——结果三个系统在多数配置下命中率都提升了 0.9% 到 3.9%。这套基于注意力分数的淘汰逻辑是通用的,不是 KVDrive 独享的。
四、弹性流水线:让 CPU、GPU、I/O 同时忙碌
如果缓存管理回答的是”搬多少”,弹性流水线回答的是”怎么搬才不卡”。
传统 offloading 系统之所以 GPU 利用率低,不是因为单个操作慢,而是三个操作——选择(selection)、取数(fetching)、计算(computation)——串行排着队。选择是 GPU I/O-intensive(扫描索引、打分),取数是 PCIe transfer-bound,计算是 GPU compute-bound。它们本质上争抢的是不同的硬件资源,但串行执行让能跑的资源也跟着等。
KVDrive 的 SFC disaggregation(Selection-Fetching-Computation 解耦)把这个三步舞拆成了独立编排的微批次。一批请求被切成多个 micro-batch:GPU 对当前 micro-batch 做 selection 的同时,CPU 在评估上一个 micro-batch 的缓存命中/缺失状态,I/O 在搬运更早 micro-batch 的 KV 条目。等所有 micro-batch 的 fetching 都完成,整个 batch 一起上 GPU 做计算。缓存元数据更新跟计算重叠,不额外占时间片。
这套设计的难点在于三个参数的联合调优:index centroid 数量、GPU 缓存大小、micro-batch 大小。Centroid 越多选择越准,但选择延迟越高——KVDrive 靠分层索引把 centroid 数量砍半还不丢精度,等于在起点就压低了 selection 延迟。缓存越大取数越少,但 CPU 端 hit/miss 评估变重——系统通过预热阶段渐进增加缓存直到两个时间打平。Micro-batch 太小带来频繁 kernel launch 开销,太大造成流水线气泡——短时校准跑一遍就定下来。
还有一个被论文正面回应的争议点:为什么不在 CPU 上做 attention?MagicPIG[7] 等此前工作主张 CPU attention 更适合 offloading 场景,因为 GPU attention 的数据搬运开销太大。KVDrive 用 roofline 模型给出了相反的结论:缓存命中率达到 80% 后,每步只有少量数据需要过 PCIe,operational intensity 保持在 CPU-GPU 带宽阈值以上,此时 GPU attention 的吞吐量确实高于 CPU。这个判断的前提是缓存命中率够高——命中了就不需要搬运——而这恰好是前面滑动窗口缓存的任务。两个机制在分工上是高度耦合的:缓存负责减少数据量,流水线负责掩盖剩余延迟。
五、三层存储与成本再平衡
KVDrive 在多层存储上的贡献,用一句话概括是:它证明了把 SSD 正确纳入 KV cache 层次结构后,长上下文推理的成本结构可以被彻底改写。
论文最让人印象深刻的一个实验不是跟同行的对比,而是在消费级 RTX 4090(24GB 显存)上跑 KVDrive,去跟企业级 H20(96GB 显存)上跑标准内存内推理做对比。
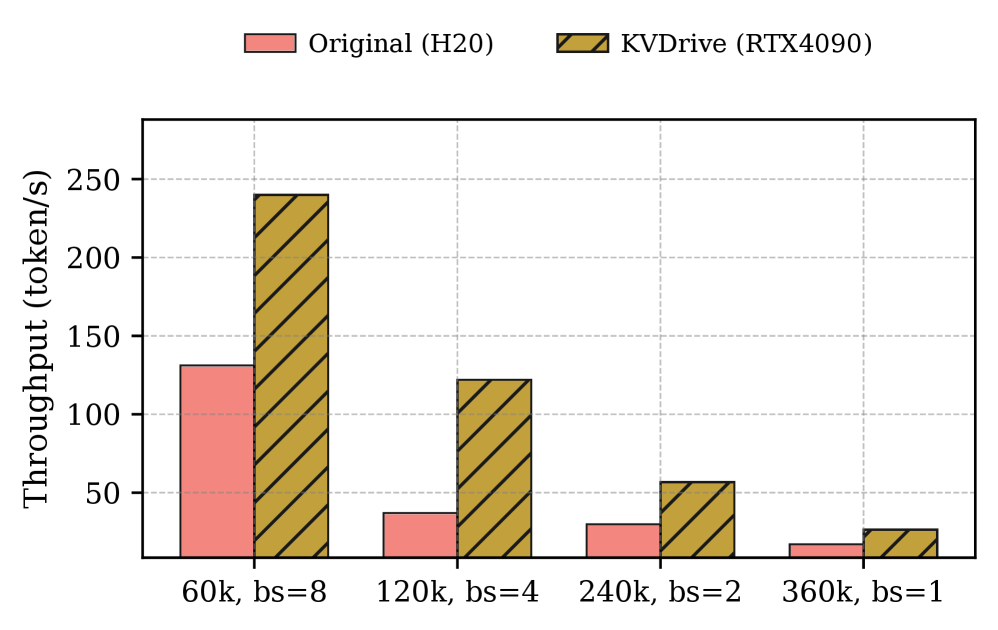
图 3:消费级 RTX 4090(24GB)+ KVDrive vs 企业级 H20(96GB)baseline。KVDrive 使 RTX 4090 在长上下文场景下达到 H20 基线 3 倍的吞吐量。来源:论文 Figure 23b。
结果很直接(图 3):RTX 4090 + KVDrive 的吞吐量是 H20 baseline 的 3 倍。不是说 RTX 4090 比 H20 强——而是说 24GB 显存加正确设计的存储层次,在实际长上下文场景下比 96GB 显存的裸跑更高效。
这背后是三层存储协调工作的结果。prefill 阶段结束时,系统利用最后几个 token 在整个前缀上的 attention 分布(观察窗口),给每个前缀位置的 KV 条目打重要性分。高分的放进 HBM,次高的放进 DRAM,全量存 SSD 作为后备。这和 SnapKV[8] 用观察窗口做 KV 压缩的思路一脉相承,但目的不同——不是压缩,是分层放置。
到了 SSD 这一层,KVDrive 做了大量的 I/O 模式适配。SSD 的随机读跟顺序读差距可以到十倍以上,而 attention 的访问模式天然是随机的——不同 query 感兴趣的位置散落在整个前缀里。KVDrive 的 SSD-aware layout 通过语义连续性打包(语义相近的 KV 条目在 extent 内连续存放)和 layer-head 分区(每个层-头独立占据一段 SSD 区域),把散点访问重组成了大块顺序 I/O。结合 parallel sparse synchronization 中的 block-level 稀疏取数(只搬需要的 KV block,不搬整层),SSD 带宽被用到了刀刃上。
在 DRAM+SSD 配置下,KVDrive 的吞吐量仅比纯 DRAM 配置低 40%,而作为参照的 FlexGen-style 整层搬移方案基本不可用。对于真实部署场景——数据中心 GPU 节点通常只配 100GB 左右主机内存,边缘设备更少——这个 40% 的性能损失换来了数倍的上下文容量扩展,是一个可接受的 tradeoff。
六、这篇论文改变了什么
这篇论文最值得被记住的地方,我认为不是数字(1.74× 吞吐量提升),也不是单个技巧(lookahead eviction 或 SFC disaggregation),而是它对问题本身的重新界定。
在 KVDrive 之前,KV cache offloading 的主流叙事是”算法精度战争”——谁能用更少的索引、更小的开销,更准地找到 critical KV 条目。这篇论文用一组系统测量把镜头拉远了:在真实部署中,选择精度不是瓶颈,数据搬运和调度效率才是。这个判断的成立有一个重要前提——sparse attention 本身(无论是空间分块还是聚类)已经能在一个合理的精度水平上工作,继续卷精度收益递减;但搬运效率的改善空间还很大。
我理解的边界条件是这样几个。
第一,KVDrive 的索引构建依赖 prefill 阶段的 attention 计算,尤其 importance-guided warm-up 需要 prefill 最后几步的 attention 分布做分层放置。对于极短 prompt 的场景(prefill 本身就几步 attention),这个信息的可靠性需要验证。
第二,所有实验都在单卡场景下完成。分布式推理(TP、PP)下 KV cache 跨卡分布、流水线跨节点协调的复杂性没有被覆盖。论文也没有涉及 continuous batching 下的 cache 生命周期管理——多个不同长度的序列共用缓存时,lookahead eviction 和 2D window scaling 的策略会有变化。
第三,论文的 Future Work 部分提到了几个值得关注的方向:多模态模型的 KV cache 访问模式跟纯文本不同;存内计算(PIM)可能把 selection 和 partial computation 下沉到存储层;KVDrive 的分层存储设计天然适合跟量化结合——热块用高精度(FP16),冷块激进量化(INT4),用微小的量化/反量化开销换更高的有效 I/O 带宽。
论文的工程实现是扎实的:arXiv v1,2026 年 5 月 18 日提交,9,000 行 Python + 1,000 行 C++ + 3,000 行 CUDA,代码开源。截至目前还没有被顶会接收的消息,但作为一个可运行的完整系统原型,它的三个核心机制——滑动窗口缓存、弹性流水线、三层存储——各自都有独立于具体实现的方法论价值。
参考资料
[1] KVDrive: A Holistic Multi-Tier KV Cache Management System for Long-Context LLM Inference
[2] ShadowKV: KV Cache in Shadows for High-Throughput Long-Context LLM Inference
[3] PQCache: Product Quantization-based KVCache for Long Context LLM Inference
[4] Quest: Query-Aware Sparsity for Efficient Long-Context LLM Inference
[5] RetroInfer: A Vector-Storage Approach for Scalable Long-Context LLM Inference
[6] FlexGen: High-Throughput Generative Inference of Large Language Models with a Single GPU
[7] MagicPIG: LSH Sampling for Efficient LLM Generation
[8] SnapKV: LLM Knows What You Are Looking for Before Generation
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。