版本声明:本文分析基于 Novita AI 于 2026-05-18 发布的 PegaFlow 博客及 GitHub 仓库(novitalabs/pegaflow,查询日期 2026-05-22);项目仍处于活跃开发阶段,部分实现细节可能变动。
vLLM 每次重启,进程内的 KV cache 随之消失。不管之前缓存了多少热点前缀,下一次启动一切从零开始。在 500 GiB 的主机 KV 池场景下,这个代价是 71.4 秒的冷启动时间。Novita AI 和 vLLM 团队在今年 5 月 18 日发布的博客里给出了一个数字:PegaFlow 把这个数字压到 33.2 秒[1]。2.15 倍加速不是因为推理变快了,而是因为缓存幸存了进程重启。
这个冷启动数字是理解 PegaFlow 最好的切入点。它说明这套方案的价值不在于”更快的缓存实现”,而在于改变了 KV cache 的生命周期假设:从”一个 vLLM 进程的存活期”延长为”整个推理服务的运行期”。
一、从进程内状态到独立守护进程
大多数外部 KV 缓存方案都在 Python 层面实现——增加序列化接口,把 KV 块写到 Redis 或对象存储,下次请求时反序列化回来。PegaFlow 的选择更激进:把 KV cache 管理从 vLLM Python worker 完全剥离,交给一个独立的 Rust 守护进程。
vLLM worker 与本地 PegaFlow daemon 之间通过两条通道通信:CUDA IPC 用于显存共享,gRPC 用于调度指令。CUDA IPC 的含义是零拷贝——vLLM 把一段 GPU 显存的句柄传给守护进程,后者可以直接访问这块显存而不需要经过 CPU 内存中转。gRPC 通道则负责传递块管理指令:哪些块需要固定、何时驱逐、哪些请求需要远程预取。
整个 Rust 核心(代码库 80.8% Rust,18.8% Python)运行在 Tokio 异步 runtime 上,规避了 Python GIL。这意味着 cache 管理操作可以在守护进程侧异步完成,vLLM Python worker 的推理主路径不会因为锁竞争而暂停。
守护进程的独立生命周期是关键。只要 PegaFlow daemon 保持存活,vLLM worker 重启不会影响已缓存的 KV 块。冷启动加速正是这一特性的直接体现:重启后的 vLLM 拿到的是一个已经预热好的缓存,而不是空池子。
这个设计也带来了一个新的运维依赖:PegaFlow daemon 成了必须的 sidecar。如果守护进程崩溃,vLLM 失去外部缓存访问;如果 daemon 重启,缓存是否能从 SSD 快速恢复取决于配置。博客里没有讨论这些失败场景,而这些正是决定生产可用性的细节。
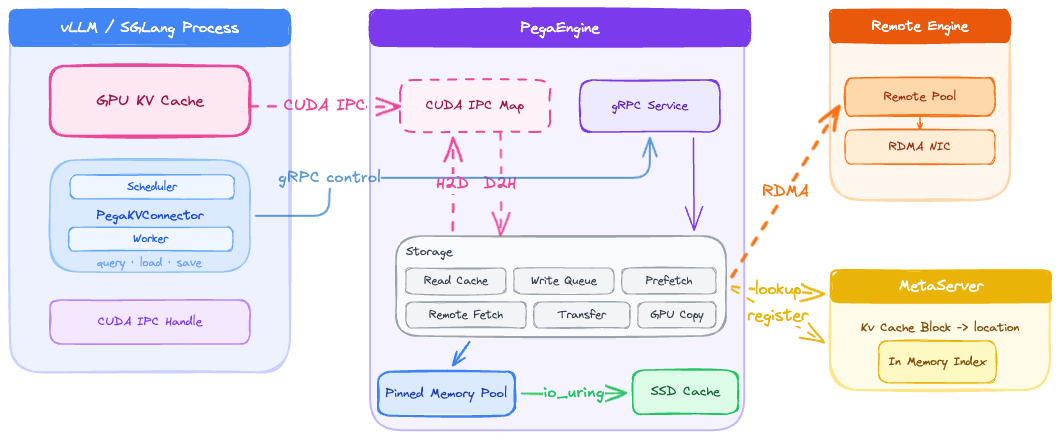
图 1:PegaFlow 作为独立守护进程运行,vLLM worker 通过 CUDA IPC 共享 GPU 显存,通过 gRPC 传递调度指令。多个模型实例可以连接同一个 daemon,共享同一块 KV 池。来源:vLLM 博客原图。
二、三层存储:DRAM、RDMA、SSD
KV 块在 PegaFlow 内按层分布:
L1 是本地 pinned DRAM,NUMA-aware 分配,layer-wise DMA 传输以最大化硬件带宽。L2 通过 RDMA READ 访问远端节点的 DRAM——博客里的测试场景是单次读取 ≥1 GiB 的大前缀 KV 段,在内部生产集群上测得平均吞吐量 194 GB/s、P99 250 GB/s、峰值 261.6 GB/s。一段 24 GiB 的 KV 数据大约需要 100 ms 取回。L3 是本地 SSD,通过 io_uring 异步 I/O 读写,稳态单盘吞吐约 6.5–6.6 GB/s,峰值 6.9 GB/s。
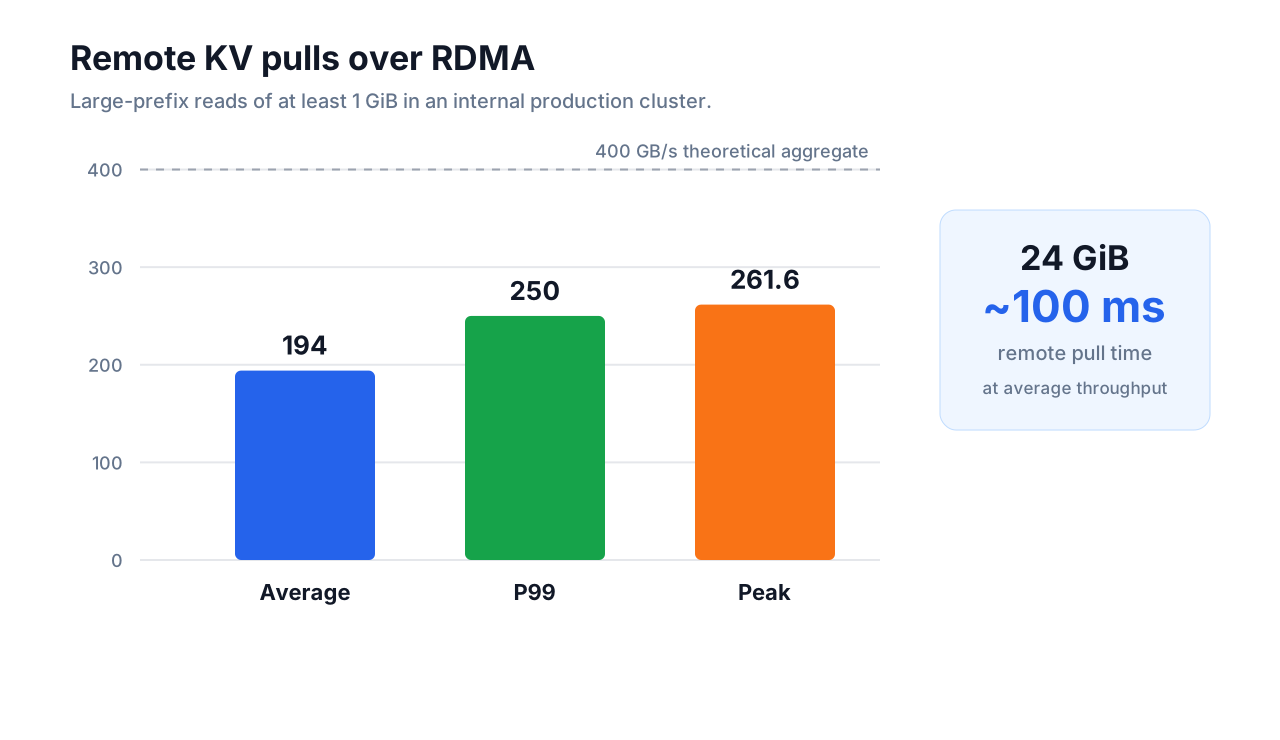
图 2:内部生产集群的 RDMA READ 吞吐量分布。大前缀读取(单次 ≥1 GiB)的平均吞吐 194 GB/s,P99 250 GB/s,峰值 261.6 GB/s。来源:vLLM 博客原图。
RDMA 那层的 100 ms 延迟值得认真对待。这个数字只有放在”远程取回 vs. 本地重算”的比较里才有意义。对于一段 30K token 的系统 prompt,在 70B 模型上 prefill 可以轻松超过 500 ms;这时 100 ms 的远程取回是明确划算的。对于 2K token 的短前缀、小模型,prefill 可能只需 20–30 ms,远程取回反而成了负担。
PegaFlow 的 cache 调度层必须在运行时做这个判断,但博客里既没有给出决策阈值,也没有描述策略接口。这是一个对性能影响很大的黑盒,也是 PegaFlow 在生产部署中最需要可调性的地方。
三、多实例共享:命中率实验的真实含义
博客里覆盖面最广的测试是单节点 8 个 Qwen3-8B 实例共享 KV 池的场景:
| 指标 | PegaFlow | 传统方案 |
|---|---|---|
| 吞吐量 | 11.97 req/s | 7.68 req/s |
| 平均 TTFT | 5.26 s | 8.22 s |
| 命中率 | 52.35% | 11.77% |
56% 吞吐量提升和 36% TTFT 下降是真实的,但 11.77% 的基线命中率说明了比较前提:传统方案里 8 个实例各自管理自己的本地池,相同的系统 prompt 在 8 个池子里分别被缓存了一份,跨实例的请求无法互相借用。PegaFlow 打通隔离边界之后,同一份缓存对 8 个实例可见,命中率从 11.77% 升到 52.35% 是零共享到全面共享的一步跨越。
4.4 倍命中率提升源于这个隔离假设的改变,它衡量的是”有跨实例共享”对”无跨实例共享”的增益,代表不了 PegaFlow 对同类外部缓存方案的领先幅度。对于已经在用 Mooncake 或其他外部 KV 存储的团队,这个数字需要在新的参照系里重新读——博客没有做这层横向比较,是理解这份数据时需要自己补的背景。
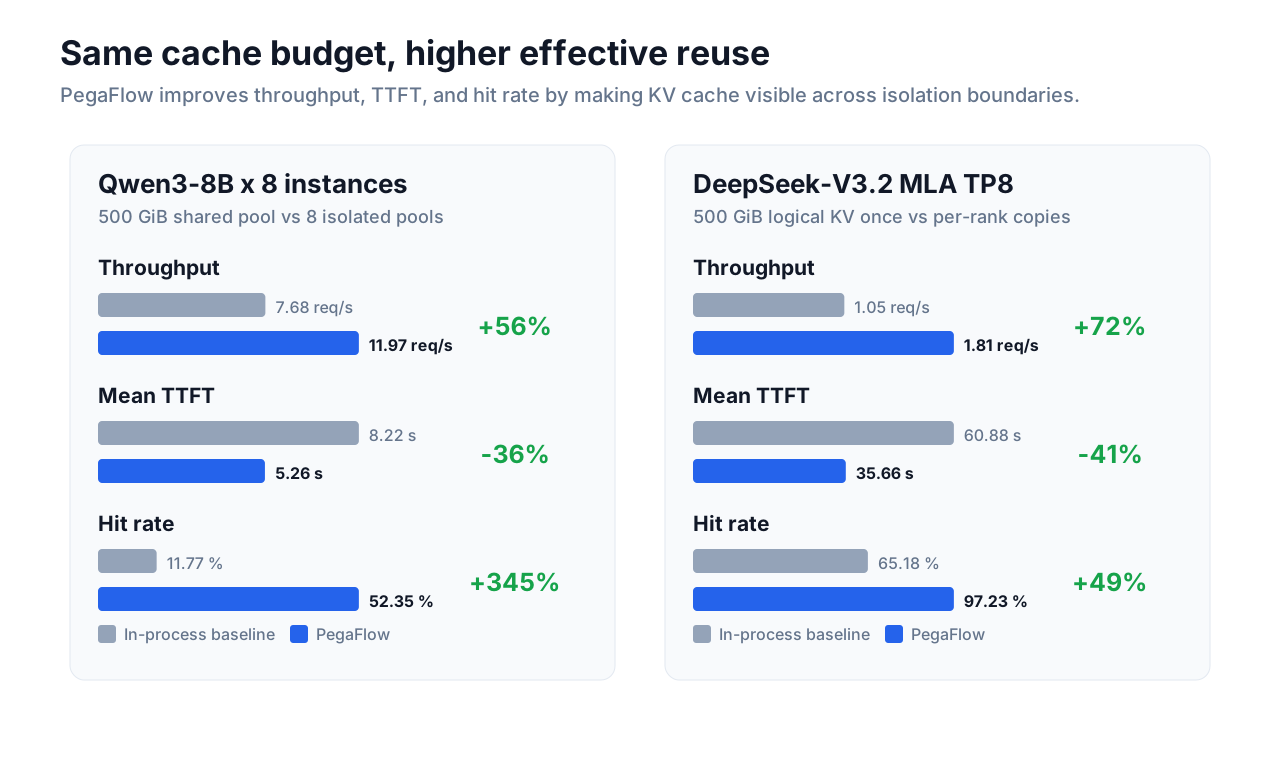
图 3:单节点 8 个 Qwen3-8B 实例共享 KV 池(PegaFlow)vs. 独立本地缓存(传统方案)。命中率从 11.77% 到 52.35%,吞吐量提升 56%,平均 TTFT 下降 36%。来源:vLLM 博客原图。
四、MLA 去重:最有技术含量的那层
DeepSeek-V3.2 + TP8 场景的测试结果更值得关注:吞吐量从 1.05 req/s 提升到 1.81 req/s(72%),平均 TTFT 从 60.88 s 降到 35.66 s(41%),命中率 97.23% vs. 65.18%[1]。
这背后的机制是 MLA(Multi-head Latent Attention)逻辑 KV 去重。MLA 是 DeepSeek 系列使用的低秩注意力架构,它把 KV cache 压缩到一个低维潜在空间,而不是逐 head 存储完整的 K/V 向量。这带来了一个去重机会:不同请求如果共享相同的潜在 KV 表示,可以指向同一份缓存,而不是存多份。
传统方案里,即使请求共享相同的前缀,如果缓存以”膨胀后的完整 KV”形式存储,每个实例还是要维护一份。PegaFlow 在逻辑层(压缩的 latent KV)匹配和存储,再在使用时按需还原,命中率的提升直接来自于这个层次的去重效率。97.23% 命中率是一个很高的数字,在 65.18% 基线上的增量说明有相当一部分请求在 token 层面不完全相同,但在潜在 KV 表示层面是可以共享的。
五、这篇博客没有回答的问题
公开基准测试(H800 + Llama-3.1-8B)的结果是博客最亮眼的数字:平均 TTFT 从 572.5 ms 降到 61.5 ms,P99 从 1113.7 ms 降到 77.0 ms——接近 9 倍提升[1]。这来自 warm-start 场景,即缓存已预热后的重用效率,数字真实但不代表冷启动的用户体验。
但有几个问题博客没有回答:
命中率上界的测量。博客提到用 HyperLogLog 在线估算理论命中率上界(r* = (N - U) / N),24 小时窗口内存占用 <1 MiB,误差约 0.8%。这是个好的设计——知道理论上界意味着可以判断当前命中率还有多少提升空间。但博客没有给出测试工作负载下的上界数字,读者无法判断 52.35% 的命中率是接近天花板还是还有很大空间。
跨节点访问的调度策略。RDMA 层的 100 ms 取回延迟是在什么条件下划算的?这个阈值如何配置?如果 SSD 更快,什么时候应该选 L3 而不是 L2?这些调度策略对不同工作负载的影响很大,但博客里是黑盒。
与 Mooncake 的定位差异。Mooncake 同样是 vLLM 生态里的外部 KV 存储方案,同样支持 RDMA 和跨节点共享[2]。PegaFlow 和 Mooncake 的边界在哪里?博客完全回避了这个比较。对于评估方案的工程师,这是必须自己做功课的一环。
六、结论
PegaFlow 代表了一个明确的架构选择:把 KV cache 从推理进程的内部状态变成独立管理的持久化资源。冷启动加速(2.15x)和多实例命中率(11.77% → 52.35%)是这个选择最直接的收益;MLA 逻辑 KV 去重是目前最有技术含量的部分,也是 DeepSeek 场景下吞吐量改善最显著(72%)的来源。
KV cache 的生命周期管理正在从”进程级临时状态”走向”集群级持久化资产”,PegaFlow 是这个方向上一个经过内部生产验证的实现。它还没有回答所有问题:调度策略的可调性、与其他外部 KV 方案的关系、守护进程自身的故障容忍——这些留给后续版本和实际部署去验证。
对于已经在跑高命中率工作负载的团队(长系统 prompt、多轮对话、agentic 调用),PegaFlow 的冷启动持久化和多实例共享是值得认真评估的。对于短 prompt 低命中率场景,RDMA 取回的额外延迟是否划算,在试验之前难以从理论上判断。
参考资料
[1] vLLM x Novita AI: PegaFlow for Production-Grade External KV Cache
[2] Mooncake: A KV Cache-centric Disaggregated Architecture for LLM Serving
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。