版本历史
版本 日期 说明 v1.0 2026-05-21 初稿,基于 SGLang commit 55ba03db6(2026-05-20),覆盖七种存储池类型的 buffer 形状与内存公式v1.1 2026-05-21 新增第 9.1 节:五款旗舰 MoE 跨模型 KV cache 对比,补充各模型注意力机制说明,明确 Qwen3.5 混合 GDN 架构;修正 MiniMax M2.7 为全注意力 GQA(非滑动窗口)
一次 LLaMA-7B 的推理请求,每个 token 在 KV cache 中占用 512 KB 显存;换成 DeepSeek-V2 的 MLA,这个数字降到 67.5 KB——差 7.6 倍。这个差距既不来自量化,也不来自分页策略,而是注意力架构本身决定了每 token 需要保留多少中间状态。推理服务能同时容纳多少请求、最大上下文能开到多长、KV cache 在 GPU 和 CPU 之间怎样分层流转——这些生产层面的硬约束,全部从”每 token 多少字节”这个数字推出。
SGLang 在存储池层用类型体系把这种差异显式化了[1]。它为每种注意力架构定义独立的池类型,每种类型有自己的 buffer 形状、内存公式和传输协议。截至 commit 55ba03db6,SGLang 实现了七大类存储池,覆盖 MHA/GQA、MLA、DSA、DSV4 多级压缩、SWA 混合窗口、FP4 量化和 Host 端分层存储。本文逐一推导这些类型的内存公式,再把它们拉到同一张表里做横向对比。
一、类型体系与选择逻辑
SGLang 的 KV cache 池继承自抽象基类 KVCache,按注意力架构分化出以下层次[1]:
KVCache(抽象基类)
├── MHATokenToKVPool              # MHA/GQA 标准注意力
│   ├── MHATokenToKVPoolFP4       # MHA + FP4 量化
│   └── NoOpMHATokenToKVPool      # Embedding / 纯 Prefill
├── MLATokenToKVPool              # MLA 潜向量注意力
│   ├── MLATokenToKVPoolFP4       # MLA + FP4 量化
│   └── DSATokenToKVPool          # DSA = MLA + 稀疏索引
│       └── HiSparseDSATokenToKVPool
├── DeepSeekV4SingleKVPool        # DSV4 三级压缩
└──(组合池)
    ├── SWAKVPool                 # 全注意力 + 滑窗双池
    └── HybridLinearKVPool        # Mamba + Attention 混合

HostKVCache(抽象基类)
├── MHATokenToKVPoolHost          # MHA Host 端(HiCache L2)
└── MLATokenToKVPoolHost          # MLA Host 端(HiCache L2)
池的选择在启动时完成,由 pool_configurator.py 的工厂函数根据模型配置决定[2]。判断链路依次检查:模型是否为 DeepSeek-V4 → 是否启用 DSA 并使用 MLA 后端 → 是否启用 MLA 后端 → 是否有混合 SWA 层 → 是否含 Mamba 层 → 否则退回 MHA。这意味着池类型是模型架构的函数——加载 LLaMA 永远得到 MHA 池,加载 DeepSeek-V3 永远得到 DSA 池,运行时无法切换。
类型体系的继承关系本身编码了架构事实。DSA 池是 MLA 池的子类,共享 MLA 的潜向量 buffer 逻辑,只额外管理一块 indexer buffer。工厂并不把 DSA 当作独立分支,而是先判断 MLA,再在 MLA 池内部通过子类分化出 DSA。继承层次就是架构关系:”DSA = MLA + 稀疏索引”这个等式直接写进了 class 定义里。
1.1 两级地址映射
所有池类型共享同一套地址映射基础设施。SGLang 用两级表把请求路由到物理 KV 存储[1]:
请求 → ReqToTokenPool[req_idx, position] → token 在 KV 池中的物理位置 loc
                                                ↓
                                       k_buffer[layer][loc]  /  kv_buffer[layer][loc]
ReqToTokenPool 是一张 [max_batch_size, max_context_len] 的 int32 映射表,每行对应一个请求,记录它每个 position 在物理 KV 池中的 slot 索引。Prefill 阶段一次性分配 extend_num_tokens 个 slot,decode 阶段每步只增长 1 个 token。物理 slot 不需要连续,地址映射解耦了逻辑序列和物理存储。
这一层映射对所有池类型透明——无论底层是 MHA 的三维 buffer、MLA 的二维压缩 buffer 还是 DSV4 的字节流,上层调度和缓存管理看到的都是统一的 token 位置索引。
二、MHA/GQA:标准三维存储
MHA(Multi-Head Attention)和 GQA(Grouped-Query Attention)共享同一个池实现 MHATokenToKVPool[1],区别仅在 num_kv_heads 的取值。MHA 的 KV head 数等于 attention head 数(如 LLaMA-7B 的 32),GQA 通过减少 KV head 降低存储(如 LLaMA-3.1-8B 将 KV head 压到 8)。
每层 buffer 形状:
| Buffer | Shape |
|---|---|
| K cache | [S, num_kv_heads, head_dim] |
| V cache | [S, num_kv_heads, v_head_dim] |
其中 S = max_total_num_tokens + page_size,多出的 page_size 用于 padding slot 的 dummy 输出。K 和 V 分开存储,各自独占一组 per-layer buffer,这是 MHA 类型最显著的结构特征。
每 token 内存公式:
cell_size_MHA = num_kv_heads × (head_dim + v_head_dim) × num_layers × dtype_size
head_dim 和 v_head_dim 通常相等(如 128),dtype_size 取决于存储精度(FP16 = 2 bytes, BF16 = 2, FP8 = 1)。
数值示例 — LLaMA-7B(FP16, TP=1):
num_kv_heads = 32, head_dim = v_head_dim = 128, num_layers = 32, dtype_size = 2

cell_size = 32 × (128 + 128) × 32 × 2
          = 32 × 256 × 64
          = 524,288 bytes ≈ 512 KB/token

每层每 token = 32 × 256 × 2 = 16,384 bytes(16 KB)
GQA 的作用是线性压缩 num_kv_heads。LLaMA-3.1-8B 把 KV head 从 32 降到 8(TP=1 时),cell_size 缩小 4 倍至约 128 KB/token。但 GQA 不改变 buffer 的三维形状 [S, H, D],只是 H 维度变小。从存储池的视角看,GQA 是 MHA 在 head 维度上的参数化缩减,底层池实现完全相同。
这个 512 KB/token 的数字是后续所有压缩手段的基准线。
三、MLA:潜向量压缩
MLA(Multi-head Latent Attention)是 DeepSeek 系列引入的注意力架构变体[1],核心做法是把多个 KV head 的信息压缩成一个低秩潜向量。传统 MHA 为每个 KV head 独立存储 head_dim 维的 K 和 V;MLA 用一个类似 LoRA 的降维操作,把所有 head 的 KV 信息编码到 kv_lora_rank 维的联合表示中,推理时再通过 up-projection 矩阵还原。
每层 buffer 形状:
| Buffer | Shape |
|---|---|
| KV cache(合并) | [S, 1, kv_cache_dim] |
head 维度固定为 1——这是 MLA 与 MHA 的根本结构差异。多头信息被压进了 kv_cache_dim 这一个维度里,其中:
kv_cache_dim = kv_lora_rank + qk_rope_head_dim
kv_lora_rank 是 LoRA 压缩后的潜向量维度(DeepSeek-V2 为 512),qk_rope_head_dim 是 RoPE 位置编码维度(通常 64)。RoPE 部分无法被 LoRA 压缩——位置编码需要保留原始维度以保证旋转变换的位置感知能力——必须单独存储在潜向量之外。
另一个关键差异:MLA 把 K 和 V 合并成同一份 buffer。MHA 的 K 和 V 各占一份 per-layer 数组,MLA 只有一份 kv_buffer。这个合并不仅减少了 buffer 数量,也改变了 PD 传输和 Host 端存储的协议结构。
每 token 内存公式:
cell_size_MLA = (kv_lora_rank + qk_rope_head_dim) × num_layers × dtype_size
数值示例 — DeepSeek-V2(FP16, 60 层):
kv_lora_rank = 512, qk_rope_head_dim = 64, num_layers = 60, dtype_size = 2

cell_size = (512 + 64) × 60 × 2
          = 576 × 120
          = 69,120 bytes ≈ 67.5 KB/token

每层每 token = 576 × 2 = 1,152 bytes(1.125 KB)
对比 MHA 单层的 16 KB,MLA 单层仅 1.125 KB,单层压缩比约 14 倍。跨模型的总量对比需要考虑层数差异——DeepSeek-V2 有 60 层,LLaMA-7B 有 32 层——但即便 MLA 多了近一倍的层数,总 cell_size 仍然只有 MHA 的七分之一。这说明注意力架构的压缩增益远大于层数的线性增长。
MLA 的代价在推理端的计算开销:decode 阶段每步需要通过 up-projection 矩阵把潜向量还原成完整的多头 KV 表示,增加了矩阵乘运算量。存储和传输上的收益在 PD 分离和长上下文场景下尤其显著——KV cache 传输量和容量需求同步下降,而在显存受限的生产环境中,这通常是更紧的约束。
四、DSA:在 MLA 上叠加稀疏索引
DSA(Double Sparse Attention)是 DeepSeek-V3 引入的注意力优化[1],在 MLA 的压缩 KV 之上叠加一个稀疏注意力检索索引。在存储池层的表现很直接:DSATokenToKVPool 继承 MLATokenToKVPool 的全部 buffer,再额外分配一块 indexer buffer。
每层 buffer 构成:
| Buffer | Shape | 来源 |
|---|---|---|
| KV cache | [S, 1, kv_cache_dim] |
继承自 MLA |
| Indexer K + scale | [num_pages, page_size × indexer_unit] (uint8) |
DSA 新增 |
Indexer 存储 FP8 量化后的 attention key 及其 scale 参数,用于稀疏 attention 的 top-k 候选检索。index_head_dim 和 quant_block_size 均固定为 128。
Indexer 每 token 存储量推导:
indexer_bytes_per_token = index_head_dim + (index_head_dim / quant_block_size) × 4
                        = 128 + (128 / 128) × 4
                        = 128 + 1 × 4
                        = 132 bytes
128 bytes 是 FP8 index key 的本体(128 个 FP8 元素,每个 1 byte),4 bytes 是整个量化块的 scale 参数(128 个元素共享一个 float32 scale)。
每 token 内存公式:
cell_size_DSA = cell_size_MLA + indexer_bytes_per_token × num_layers × element_size

             = (kv_lora_rank + qk_rope_head_dim) × num_layers × dtype_size
               + 132 × num_layers × 1
末尾的 × 1 明确标注 indexer buffer 使用 uint8 存储。
数值示例 — DeepSeek-V3(FP8, 61 层):
MLA 部分  = (512 + 64) × 61 × 1 = 35,136 bytes ≈ 34.3 KB
Indexer   = 132 × 61 × 1        =  8,052 bytes ≈  7.9 KB
总计      = 43,188 bytes                         ≈ 42.2 KB/token
注意这里 MLA 部分使用 FP8 存储(dtype_size = 1),所以比 FP16 的 DeepSeek-V2 每层减半。Indexer 占总存储量的 18.6%——不到五分之一的额外开销换来了稀疏注意力的检索能力。如果将 MLA 部分切换到 FP16,MLA 部分翻倍至 70.3 KB,indexer 不变,总计 78.2 KB/token。这个对比说明,数据精度(FP8 vs FP16)和稀疏索引是两个独立的存储开销维度,叠加效果是可预测的。
五、DeepSeek-V4:三级压缩注意力
DeepSeek-V4 的存储池 DeepSeekV4SingleKVPool 是当前最复杂的一种[3]。它把 Transformer 层分为三个级别——SWA(滑窗注意力层)、C4(4 倍压缩层)和 C128(128 倍压缩层),每个级别有独立的存储策略和容量预算。
Buffer 形状与单 token 字节构成:
DSV4 的每层 buffer 退化为二维的 [num_pages, bytes_per_page_padded](int8/uint8),所有分量被打包成紧凑字节流。单个 token 的字节数由以下四部分拼接:
bytes_per_token = qk_nope_head_dim (FP8)                           → 448 bytes
               + qk_rope_head_dim × bf16_itemsize (BF16)           → 64 × 2 = 128 bytes
               + qk_nope_head_dim / quantize_block_size (FP8 scale)→ 448 / 64 = 7 bytes
               + scale_pad                                         → 1 byte
               = 584 bytes
nope(非 RoPE)部分用 FP8 压缩以节省空间,rope 部分保持 BF16 以保证位置编码精度,7 bytes 的 scale 记录 FP8 量化的每块缩放因子,1 byte padding 补齐对齐。Page 对齐使用 576 字节为单位:
bytes_per_page_padded = ceil(page_size × 584 / 576) × 576
每 token 总内存公式(bytes_per_full_token)包含七个分项[2]:
bpft = r_swa × B_kv × L_total                     ① 所有层的 SWA 窗口内 KV
     + 1/(4 × s_c4) × B_kv × L_c4                 ② C4 层的 1/4 压缩 KV
     + 1/128 × B_kv × L_c128                       ③ C128 层的 1/128 压缩 KV
     + 1/4 × B_idx × L_c4                          ④ C4 层的 indexer
     + r_swa × (R_c4 / W) × B_c4s × L_c4           ⑤ C4 状态池
     + r_swa × (R_c128 / W) × B_c128s × L_c128     ⑥ C128 状态池
     + r_swa × (R_c4 / W) × B_c4is × L_c4          ⑦ C4 indexer 状态池
公式各项含义:
| 分项 | 符号 | 物理含义 |
|---|---|---|
| ① | r_swa × B_kv × L_total |
所有层在滑窗范围内保留完整 KV 的开销 |
| ② | 1/(4 × s_c4) × B_kv × L_c4 |
C4 层把窗口外 token 以 1/4 比率压缩存储 |
| ③ | 1/128 × B_kv × L_c128 |
C128 层以 1/128 比率做极端压缩 |
| ④ | 1/4 × B_idx × L_c4 |
C4 层的稀疏索引(同样 1/4 压缩) |
| ⑤⑥⑦ | 状态池项 | 维持各级压缩上下文连贯性的 ring buffer 和状态 |
关键变量:
| 符号 | 含义 |
|---|---|
B_kv |
584 bytes(上面推导的单 token 字节数) |
B_idx |
indexer 字节 = index_head_dim + index_head_dim/128 × 4 |
r_swa |
swa_full_tokens_ratio(滑窗容量比) |
s_c4 |
C4 shrink factor(HiSparse 时 > 1,进一步收缩 C4 容量) |
W |
swa_page_size(滑窗大小) |
R_c4, R_c128 |
各级 ring buffer 大小 |
L_total, L_c4, L_c128 |
各级别的层数 |
七个分项中前四项是 KV 数据和索引的直接存储,后三项是维持多级压缩所需的辅助状态结构。这些辅助开销在工程上不可省略——没有 ring buffer 和状态池,C4/C128 的压缩上下文会在窗口滑动时断裂。
DSV4 还引入了独立的容量分配公式。给定总可用显存和 bpft,系统依次计算:
full_token  = floor(available_bytes / bpft)
swa_tokens  = full_token × r_swa
c4_tokens   = full_token / (4 × s_c4)
c128_tokens = full_token / 128
每一级的 token 容量都是 full_token 按压缩比缩放的结果。DSV4 把”token 容量”从一个数字展开成了一组多级容量预算。
六、SWA 混合池:按层分离的双池策略
SWA 混合池 SWAKVPool 针对的是 Gemma2、Command-R、MiMo 这类在部分层使用全注意力、部分层使用滑窗注意力的模型[4]。它的压缩来源与 MLA 系列完全不同——不改变单层 buffer 形状,而是按层切分容量:滑窗层只需要保留窗口长度内的 token,不需要和全注意力层共享同样大小的存储池。
池结构分为两个独立子池:
| 子池 | 容量 | 存储层数 |
|---|---|---|
full_kv_pool |
size(全注意力 token 数) |
全注意力层数 |
swa_kv_pool |
size × swa_full_tokens_ratio |
滑窗层数 |
swa_full_tokens_ratio 通常远小于 1,因为滑窗只需覆盖窗口范围内的 token。
每 token 内存公式:
cell_size_SWA = full_per_token × num_full_layers
              + swa_ratio × swa_per_token × num_swa_layers
其中每层的 per-token 大小沿用 MHA 公式:
full_per_token = num_kv_heads × (head_dim + v_head_dim) × dtype_size
swa_per_token  = swa_num_kv_heads × (swa_head_dim + swa_v_head_dim) × dtype_size
如果模型全部是 SWA 层(num_full_layers = 0),公式退化为 swa_per_token × swa_layers_num。
两个子池内部各自使用标准 MHA 的 [S, H, D] buffer 形状,通过参数化创建——token_to_kv_pool_class 可以传入 MHATokenToKVPool 或 MHATokenToKVPoolFP4,使得 SWA 可以和 FP4 量化叠加。SWA 本质上是一种容量优化策略,不改变单层的存储结构,只改变全局的容量分配比例。
七、FP4 量化:正交于架构的数值压缩
FP4 量化是一个可以叠加在 MHA 或 MLA 之上的存储压缩层[1]。它把 FP16/BF16/FP8 的 KV 值量化为 FP4(4-bit 浮点),每两个 FP4 值打包到一个 uint8 字节中,同时维护一组 scale 参数记录量化缩放因子。
MHA FP4 的 buffer 形状变化:
| Buffer | 原始 MHA | FP4 量化后 |
|---|---|---|
| K cache | [S, H, D] |
[S, H, D/2] (uint8) |
| V cache | [S, H, D_v] |
[S, H, D_v/2] (uint8) |
| K scale | — | [S, (H × D) / 16] (uint8) |
| V scale | — | [S, (H × D_v) / 16] (uint8) |
FP4 把 K/V buffer 最后一个维度减半(两个值一字节),同时新增 scale buffer——每 16 个原始元素共享一个 scale。
每 token 内存公式:
cell_size_FP4 = cell_size_MHA / 2
              + (num_kv_heads × head_dim × num_layers × 2 × kv_size) / scale_block_size
第一项是值本体减半,第二项是 K 和 V 各一份 scale 的额外开销(× 2 代表 K + V),scale_block_size 固定为 16。
MLA 的 FP4 变体遵循同样的逻辑[1]:KV buffer 从 [S, 1, kv_cache_dim] 变成 [S, 1, kv_cache_dim/2],外加 [S, kv_cache_dim/16] 的 scale buffer。
FP4 与架构类型正交:MHA 模型叠加 FP4 后 cell_size 约为原来的 55%(减半加 scale 开销),MLA 模型同理。但 4-bit 的精度损失需要逐模型验证——并非所有模型都能承受 FP4 KV 量化带来的质量衰减,这是一个需要在部署评测中确认的工程判断。
八、Host 端存储与传输粒度
8.1 Host 端四种内存布局
HiCache L2 层将 KV cache 从 GPU 卸载到 CPU 主机内存,MHATokenToKVPoolHost 支持四种布局[5]:
| 布局 | Shape | 传输特点 |
|---|---|---|
layer_first |
[2, L, S, H, D] |
每层数据在内存中连续,逐层异步传输时访问模式最优 |
page_first |
[2, S, L, H, D] |
每个 token 的所有层连续,适合一次传输整个 token 的 KV |
page_first_direct |
[2, P, L, ps, H, D] |
分页直接映射,page 对齐传输 |
page_head |
[2, P, H, ps, L, D] |
Head 优先排列,利于部分 head 选择性传输 |
第一个维度 2 代表 K 和 V 两份缓存。四种布局的总容量相同——同样多的字节只是排列顺序不同——影响的是 CUDA stream 异步传输的内存访问效率。layer_first 是 HiCache 默认推荐的布局,因为 HiCache 的传输以逐层为执行单位。
Host 端每 token 大小和 GPU 端公式一致:
size_per_token_host = head_dim × num_kv_heads × num_layers × dtype_size × 2
Host 端不做额外压缩,只改变排列。
8.2 PD 传输粒度
PD(Prefill-Decode Disaggregation)架构下,KV cache 从 Prefill 节点向 Decode 节点传输,所有架构统一使用 page 级别粒度。token 索引通过以下转换得到 page 索引:
page_index = kv_indices[::page_size] / page_size
传输协议支持 Mooncake(RDMA 批量传输,按层分组)和 NixL 两种后端。MHA 和 MLA 的传输格式有一个关键差异:MHA 先传所有层的 K 再传所有层的 V(K/V 分离传输),MLA 每层只传一份统一的 KV buffer。
每 page 传输数据量:
| 架构 | 每 page 传输量 |
|---|---|
| MHA | page_size × num_kv_heads × head_dim × dtype_size × 2 × num_layers |
| MLA | page_size × kv_cache_dim × dtype_size × num_layers |
MLA 的 PD 传输量和存储量同比下降——传输瓶颈与存储瓶颈在 MLA 上同时被缓解。
Prefill 端分 chunk 发送 KV 时,非最后一个 chunk 需要 page 对齐:实际发送的 token 范围会截断到最近的 page 边界,避免产生跨 page 的不完整传输。
8.3 HiCache Offload 与 L3 存储
HiCache L2 的 GPU ↔ CPU 传输以 page 为分配单位,但数据搬运按逐层执行[5]。写入路径:分配 host page → 对每层调用 CUDA stream 异步复制。读取路径:分配 device page → 逐层 load_to_device_per_layer()。这种”page 分配 + 逐层传输”的分离设计允许 HiCache 对不同层使用不同的传输时机——热层优先搬运,冷层延迟加载。
L3 层(Host ↔ 持久存储)使用 hash-based 寻址,传输粒度升级为 page batch。batch_get_v2() / batch_set_v2() / batch_exists_v2() 操作以 storage_batch_size 个 page 为一批处理。后端支持 Mooncake Store、NixL、3FS、LMCache 等多种存储引擎。
九、横向对比与工程判断
把七种存储池拉到同一张表里做横向对比:
Buffer 结构对比:
| 维度 | MHA/GQA | MLA | DSA | DSV4 | SWA 混合 | FP4(叠加) |
|---|---|---|---|---|---|---|
| K buffer | [S, H, D] |
— | — | [P, B_padded] |
双池各自存 | 原 shape 半维 |
| V buffer | [S, H, D_v] |
— | — | 含在上面 | 双池各自存 | 原 shape 半维 |
| KV buffer | — | [S, 1, C] |
[S,1,C] + idx |
含在上面 | — | + scale buffer |
| K/V 关系 | 分离存储 | 合并为一 | 合并 + 索引 | 紧凑字节流 | 分离(每子池) | 不变 |
| 公式项数 | 1 | 1 | 2 | 7 | 加权和 | 叠加项 |
数值对比(每 token 总字节数):
| 模型 | 架构 | 层数 | 精度 | cell_size | 相对 MHA 基线 |
|---|---|---|---|---|---|
| LLaMA-7B | MHA | 32 | FP16 | 512 KB | 1.00× |
| LLaMA-3.1-8B | GQA | 32 | FP16 | 128 KB | 0.25× |
| DeepSeek-V2 | MLA | 60 | FP16 | 67.5 KB | 0.13× |
| DeepSeek-V3 | DSA | 61 | FP8 | 42.2 KB | 0.08× |
公式汇总:
MHA:   cell = H × (D + D_v) × L × s
MLA:   cell = (R + D_r) × L × s
DSA:   cell = cell_MLA + 132 × L
DSV4:  cell = 七项加权和(见第五节)
SWA:   cell = full_per × L_full + ratio × swa_per × L_swa
FP4:   cell = cell_base / 2 + scale_overhead
总容量: max_tokens = floor(available_bytes / cell_size)
        max_tokens = floor(max_tokens / page_size) × page_size
9.1 跨模型实测:五款旗舰 MoE 在 100K 上下文的 KV Cache 占用
把公式套到当前主流旗舰模型上,以 100K token 上下文、BF16 精度统一计算(Qwen3.5 的 DeltaNet 固定状态单独计入):
| 模型 | 注意力架构 | 关键参数 | cell_size | 100K tokens |
|---|---|---|---|---|
| Qwen3.5 397B-A17B | Hybrid GDN + periodic full GQA | 45 linear attention layers + 15 full attn layers, H_kv=2, D=256, D_v=128 | 22.5 KB/tok (+固定 45 MB) | 2.4 GB |
| Kimi K2.6 (1T MoE) | MLA | 61 layers, R=512, D_r=64 | 68.6 KB/tok | 7.0 GB |
| DeepSeek V3.2 | DSA (MLA + Indexer) | 61 layers, R=512, D_r=64, idx=132B | 76.5 KB/tok | 7.8 GB |
| GLM 5.1 (754B MoE) | DSA (MLA + Indexer) | 78 layers, R=512, D_r=64 | 97.8 KB/tok | 10.0 GB |
| MiniMax M2.7 (230B MoE) | GQA(全注意力) | 62 layers, H_kv=8, D=128 | 248 KB/tok | 25.4 GB |
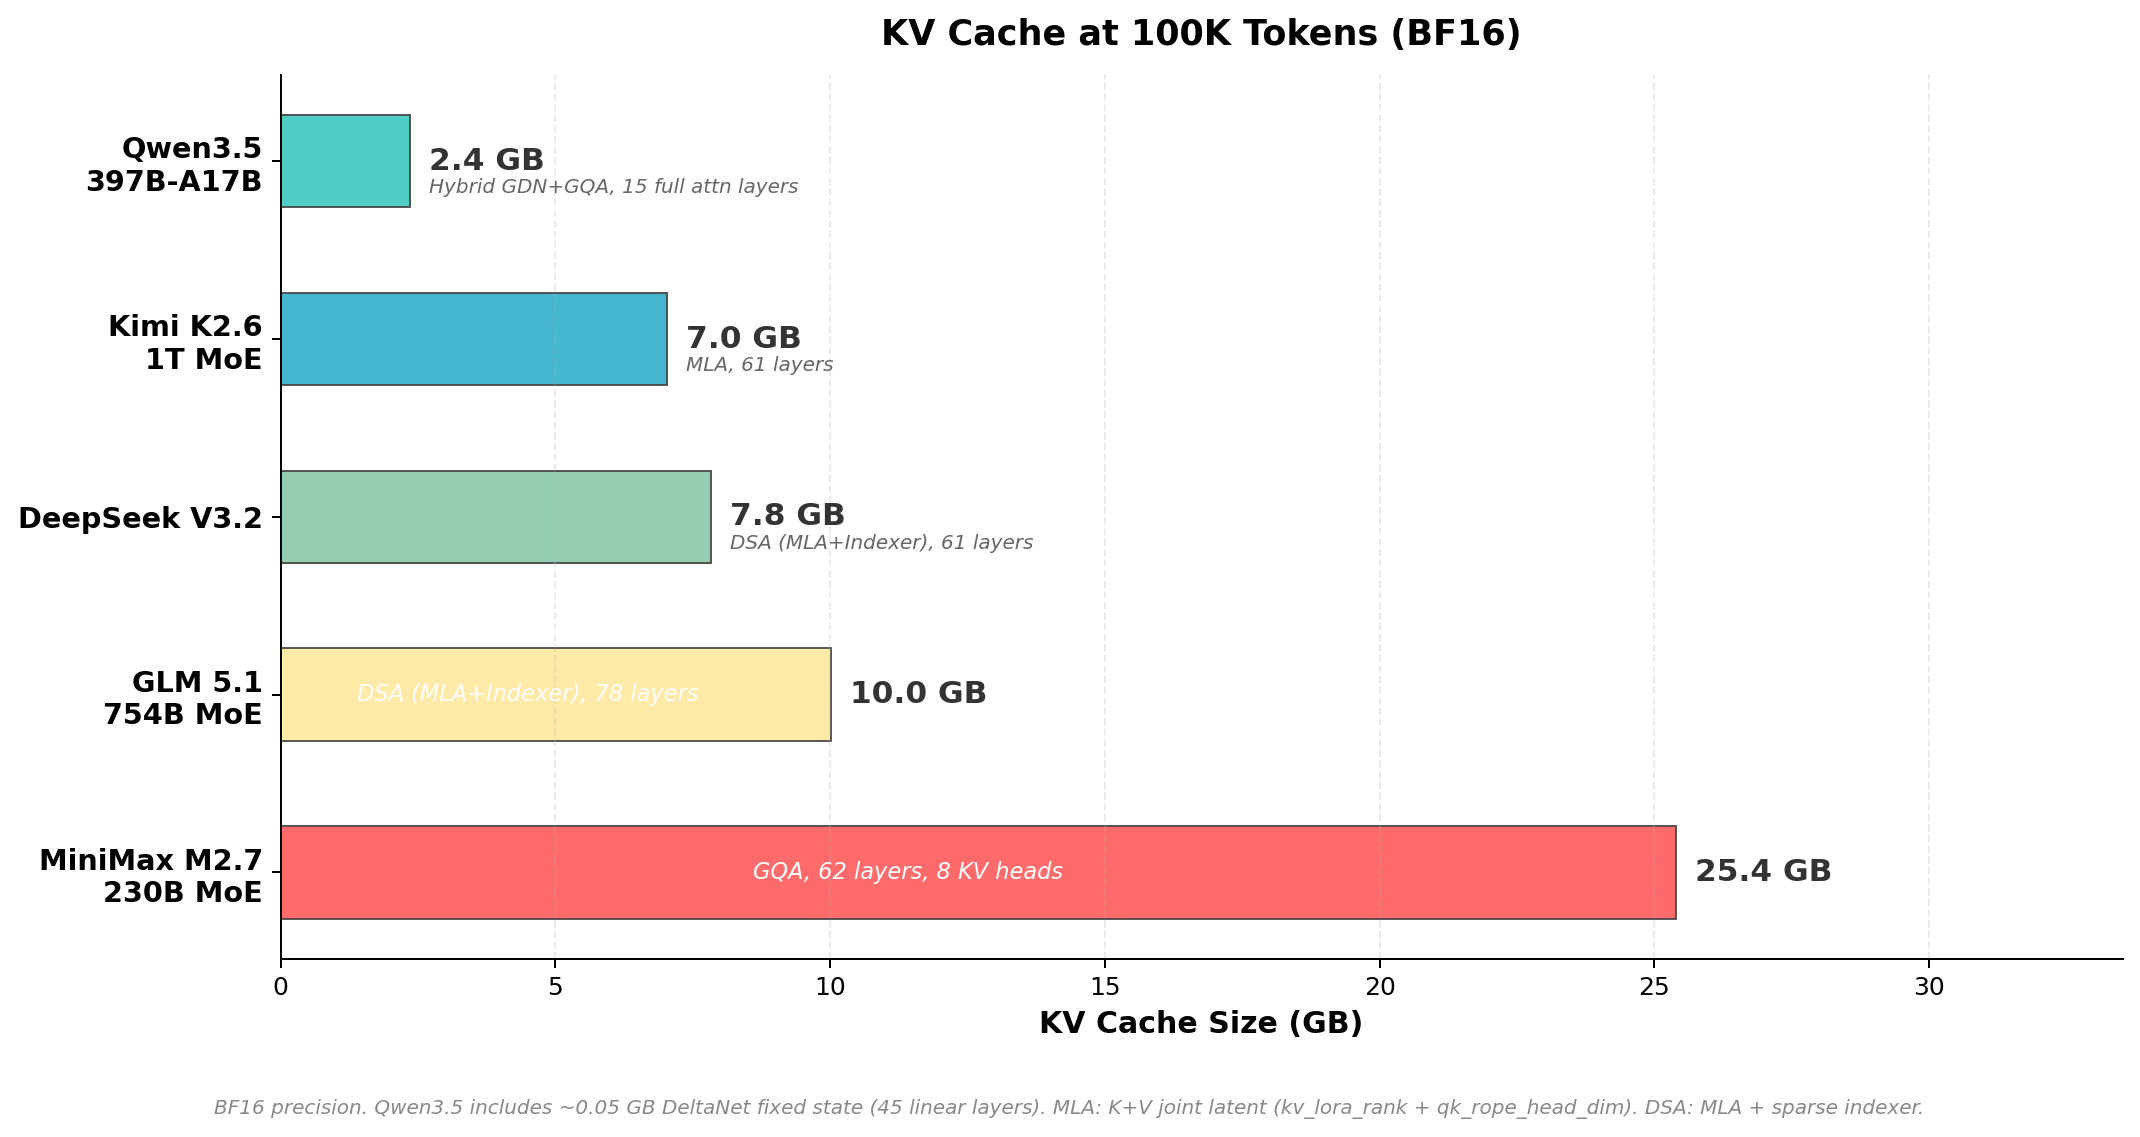
图 1:以 BF16 精度计算,各家注意力机制分别是:Qwen3.5 采用混合 GDN 架构(45 层 Gated DeltaNet linear attention + 15 层 full GQA),Kimi K2.6 采用 MLA,DeepSeek V3.2 与 GLM 5.1 采用 DSA(MLA + indexer),MiniMax M2.7 采用全注意力 GQA(8 KV heads × 62 layers)。特别说明:Qwen3.5 的 DeltaNet 层保存固定递归状态(~45 MB),token 级 KV 只来自 15 层 full attention,因此总量最低;M2.7 的 62 层全部为全注意力(config.json 中 attn_type=1),每 token 的 GQA 存储成本在五款模型中最高。数据来源:各模型 HuggingFace config.json。
最大和最小之间相差 10.8 倍。这个差距完全来自注意力架构选择,和模型总参数量无关——Kimi K2.6 有 1T 参数,KV cache 却只有 230B 参数 MiniMax M2.7 的三分之一。
(v1.1 更新) Qwen3.5 的数字最低,原因是它用 Gated DeltaNet 替换了 75% 的 Transformer 层。config 里的 layer_types 显示为三层 linear_attention 后接一层 full_attention,总计 45 层线性注意力和 15 层 full attention[10]。DeltaNet 层的”KV cache”是固定大小的递归状态(约 45 MB/请求),不随上下文增长。60 层中只有 15 层需要存 token 级 KV,而且这 15 层只有 2 个 KV head——这使得它在 100K 上下文下的内存占用只有 MLA 模型的三分之一。代价是线性注意力在长距离依赖上的表达能力弱于完整 softmax attention,Qwen3.5 用混合架构平衡了这一取舍。
MLA 阵营(Kimi K2.6、DeepSeek V3.2、GLM 5.1)集中在 7-10 GB 区间。三者共享 kv_lora_rank=512, qk_rope_head_dim=64 的 MLA 基座,差异来自两个维度:DSA indexer 的有无(Kimi 无 indexer,DeepSeek/GLM 有,增加约 11-18%)和层数(GLM 78 层 vs 其余 61 层,多出 28%)。
(v1.1 更新) MiniMax M2.7 的 62 层全部为全注意力 GQA。config.json 中 attn_type_list 62 层均为 attn_type=1[9],且不包含 sliding_window 字段——滑动窗口在 M2.7 上既不是默认行为,也不是可选能力。HuggingFace 上随模型发布的 configuration_minimax_m2.py 虽然在 docstring 和参数列表中出现了 sliding_window,但那是从 Mixtral config 类复制的模板代码(docstring 中甚至保留了 MiniMaxM2-8x7B 这样的 Mixtral 模型名),sliding_window 默认 None 且从未被 config.json 激活。
MiniMax 官方文档详细解释了为什么 M2 系列最终选择全注意力[11]:团队在预训练阶段尝试过 Hybrid SWA(通过 CPT 做层间/层内混合),发现随着上下文增长性能持续退化,尤其在 agent 任务上。根本原因是预训练阶段建立的全局注意力模式——retrieval heads 和 induction heads——无法在 SWA 的 CPT 阶段被有效调整。LMSYS/SGLang 与 MiniMax 的联合博客进一步确认[12],MiniMax 投入了数千亿到万亿 token 级别的 SWA 预训练实验,所有变体在 agent 任务和复杂长上下文评测上均未达标,最终回退到全注意力。该博客还提到 M2 开源版本中”不小心留下了 SWA 推理代码”,进一步说明 SWA 在发布时就已经被废弃。
主流推理框架的实现与这一结论一致:vLLM 的 MiniMaxM2DecoderLayer 不传 attn_window_size 参数,默认 None(全注意力);SGLang 的 M2 模型代码中零引用 sliding_window 或 window_size,使用 RadixAttention 无窗口配置。25.4 GB 是真实的全量 KV 占用,不存在窗口回收的空间——M2.7 在五款模型中 KV cache 成本最高,根源是 8 个 KV head、128 维 head_dim、62 层的三重乘积,且没有 MLA 压缩或线性注意力层来降低每 token 开销。
几个跨类型的工程观察:
K/V 分离与合并是最显著的结构分野。MHA 把 K 和 V 独立存储在两组 per-layer buffer 里;MLA 系列(MLA、DSA、DSV4)将它们合并成一份 kv_buffer。这个选择向上级联:PD 传输时 MHA 先传完所有层的 K 再传 V,MLA 每层传一份统一 buffer;Host 端 MHA 用 2 倍的首维度标记 K/V 分区,MLA 只需一份;FP4 量化时 MHA 需要分别对 K 和 V 各自维护 scale,MLA 只需要一组。两条路径的协议代码完全不同。
公式复杂度反映设计决策的密度。MHA 是一项乘积,MLA 引入 LoRA rank 和 RoPE 拆分,DSA 叠加 indexer,DSV4 展开为七项加权和。每增加一项,就意味着多了一个无法在部署后调整的工程决策。DSV4 七项参数中的每一个都绑定了特定的权衡:C128 用 1/128 的极端压缩比换来了 ring buffer 和 state pool 的额外开销;C4 的 shrink factor 让 HiSparse 进一步压缩容量但增加了重算概率。这些选择在模型架构层冻结,不在推理框架的调参范围内。
总容量由最简单的除法决定。无论池类型多复杂,最终可容纳的总 token 数都归结为 available_bytes / cell_size 再按 page 对齐。cell_size 是唯一变量。降低 cell_size 的每一种手段——GQA 减少 KV head、MLA 的潜向量压缩、FP4 的数值量化、SWA 的容量分配——都线性增加可服务的总 token 数。在 GPU 显存固定的前提下,每 token 便宜一倍,能同时服务的上下文就多一倍。
架构选择是主变量,量化是次变量。从 MHA 到 MLA 的切换带来 7-15 倍压缩,从 FP16 到 FP4 的量化大约再贡献 2 倍。两者可以叠加,但量级差一个数量级。选择服务哪个模型,比选择用什么量化精度,对系统容量的影响大得多。
十、结论
SGLang 的 KV cache 存储池体系用类型层次把”KV cache 管理”拆解成了七种结构上不同的子问题。MHA 和 MLA 的 buffer 形状差异是物理性的——三维 [S, H, D] 和二维 [S, 1, C] 无法用同一段高效代码处理。DSV4 的七项公式同样对应着七个各自独立的工程决策,每一项都无法被简化掉。
横向对比揭示的核心规律:注意力架构是每 token 内存代价的主变量。从 MHA 到 MLA 带来的 7-15 倍存储压缩,量级远超 FP4 量化能提供的 2 倍。总容量公式 available_bytes / cell_size 的简洁性意味着,选定模型(从而选定池类型和 cell_size)之后,系统能承载多少并发请求、最大上下文多长,在第一次推理请求到达之前就已经可以算出来。
参考资料
[1] SGLang memory_pool.py — MHA/MLA/DSA/FP4 池实现
[2] SGLang pool_configurator.py — 池工厂与 cell_size 公式
[3] SGLang deepseek_v4_memory_pool.py — DSV4 池实现
[4] SGLang swa_memory_pool.py — SWA 混合池
[5] SGLang memory_pool_host.py — Host 端存储布局
[7] Kimi-K2-Instruct config.json
[10] Qwen3.5-397B-A17B config.json
[11] MiniMax 官方文档 — Why Did MiniMax M2 End Up as a Full Attention Model?
[12] LMSYS Blog — No Free Lunch: Deconstruct Efficient Attention with MiniMax M2
版本对齐信息
| 仓库 | 分支 / 标签 | commit 前缀 | 日期 |
|---|---|---|---|
| sgl-project/sglang | main | 55ba03db6 |
2026-05-20 |
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。