多轮对话场景下的 KV cache 管理有一个被广泛低估的系统瓶颈:当历史 KV 被缓存在主机内存(performance layer)和 SSD(capacity layer)组成的两层存储中时,现有系统的端到端延迟比”所有 KV 都在主机内存”的理想情况高出 3.8 倍,吞吐量低 2.0 倍。差距的根源是两个子系统之间完全没有信息交换——计算引擎调度请求时不知道 KV 在哪一层存储、要加载多久,存储系统驱逐 KV 时不知道用户的对话模式和下次访问时间。
清华大学和中国电信联合发表在 FAST’26 的 Bidaw[1] 提出了一个直接的修正思路:让计算引擎和存储系统互相看见对方的状态,用双向感知(bidirectional awareness)同时解决请求调度和缓存驱逐两端的低效。这篇文章拆解它的核心机制、关键观测和实验边界。
一、问题有多严重:百万轮真实对话的三个观测
Bidaw 的分析建立在一个来自工业伙伴的真实交互式对话负载上,包含超过一百万轮对话,平均每用户 22.4 轮交互,平均查询 36 token、回答 45 token。这个负载的规模和结构远超 ShareGPT(平均仅 5.7 轮)和 Mooncake(长序列但非交互式)的公开数据集,能够暴露出多轮交互特有的存储访问模式。
论文从这份负载中提炼出三个关键观测。第一,每个用户的 KV 在存储中驻留时间很长——对话持续数十分钟,期间 KV 持续占用空间,导致并发缓存的 KV 总量迅速膨胀到 performance layer 容量的 3.91 倍。第二,KV 访问的时间局部性很差。用户发完一个问题后要花时间读回答、思考、再提下一个问题,这段间隔里大量其他用户的请求涌入,使得相邻两次 KV 访问之间的 weighted reuse distance 远超 performance layer 的容量——80% 的 KV 访问的 reuse distance 超出了 200GB 的 performance layer。第三,不同请求的 KV 加载时间差异极大。KV 大小从几 MB 到几百 MB 不等,加上两层存储之间带宽差距悬殊(主机内存数十 GB/s vs. SSD 1.5 GB/s),加载时间的变异系数在任何时间窗口内都超过 90%。
这三个观测共同指向一个结论:在多轮对话场景中,KV 加载是整个 serving 管线的系统瓶颈,而且传统的 FIFO、LRU 等缓存策略在这种访问模式下命中率只有约 20%。
二、双向感知:让计算引擎和存储各自知道对方在做什么
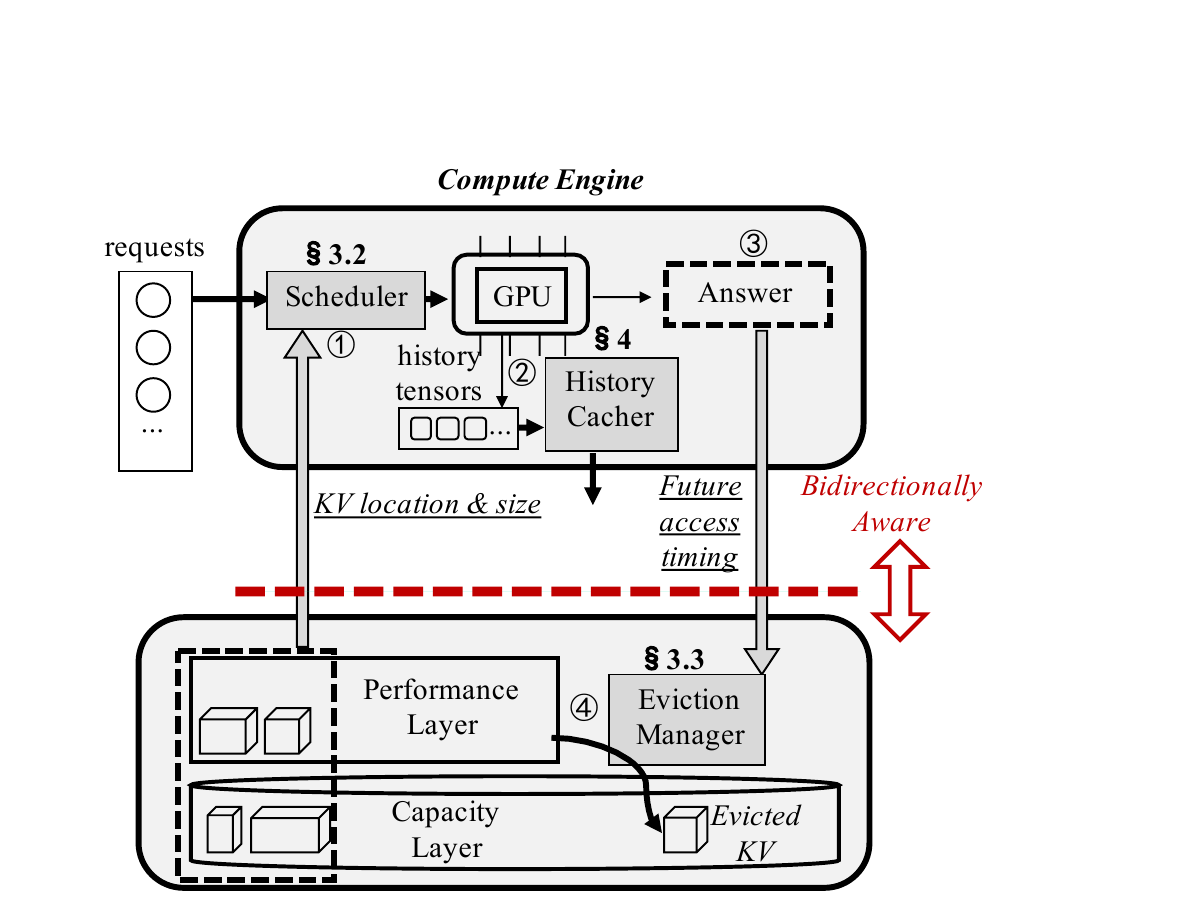
图 1:Bidaw 系统总览——计算引擎向存储传递 KV 位置与大小信息驱动调度,存储从计算引擎获取模型回答长度预测未来访问时间驱动驱逐。来源:论文 Figure 9。
Bidaw 的架构分为两条信息通路。从上到下:计算引擎在调度请求时感知每个请求的 KV 存储位置和大小(I/O-aware scheduling)。从下到上:存储系统在驱逐 KV 时利用计算引擎生成的模型回答长度来预测用户下次访问时间(previous-answer-based eviction)。
这个设计的关键洞察是——在现有系统中,这两类信息本来就存在,只是没有被跨组件传递。计算引擎知道每个请求的 KV 在哪一层、有多大,但调度器选择忽略它;模型每轮生成的回答长度直接决定了用户的思考和阅读时间,从而决定了下次 KV 访问的间隔,但存储系统从未接触到这个信号。Bidaw 做的是把已有信息接上正确的消费者。
三、I/O 感知调度:先做快的,但不饿死慢的
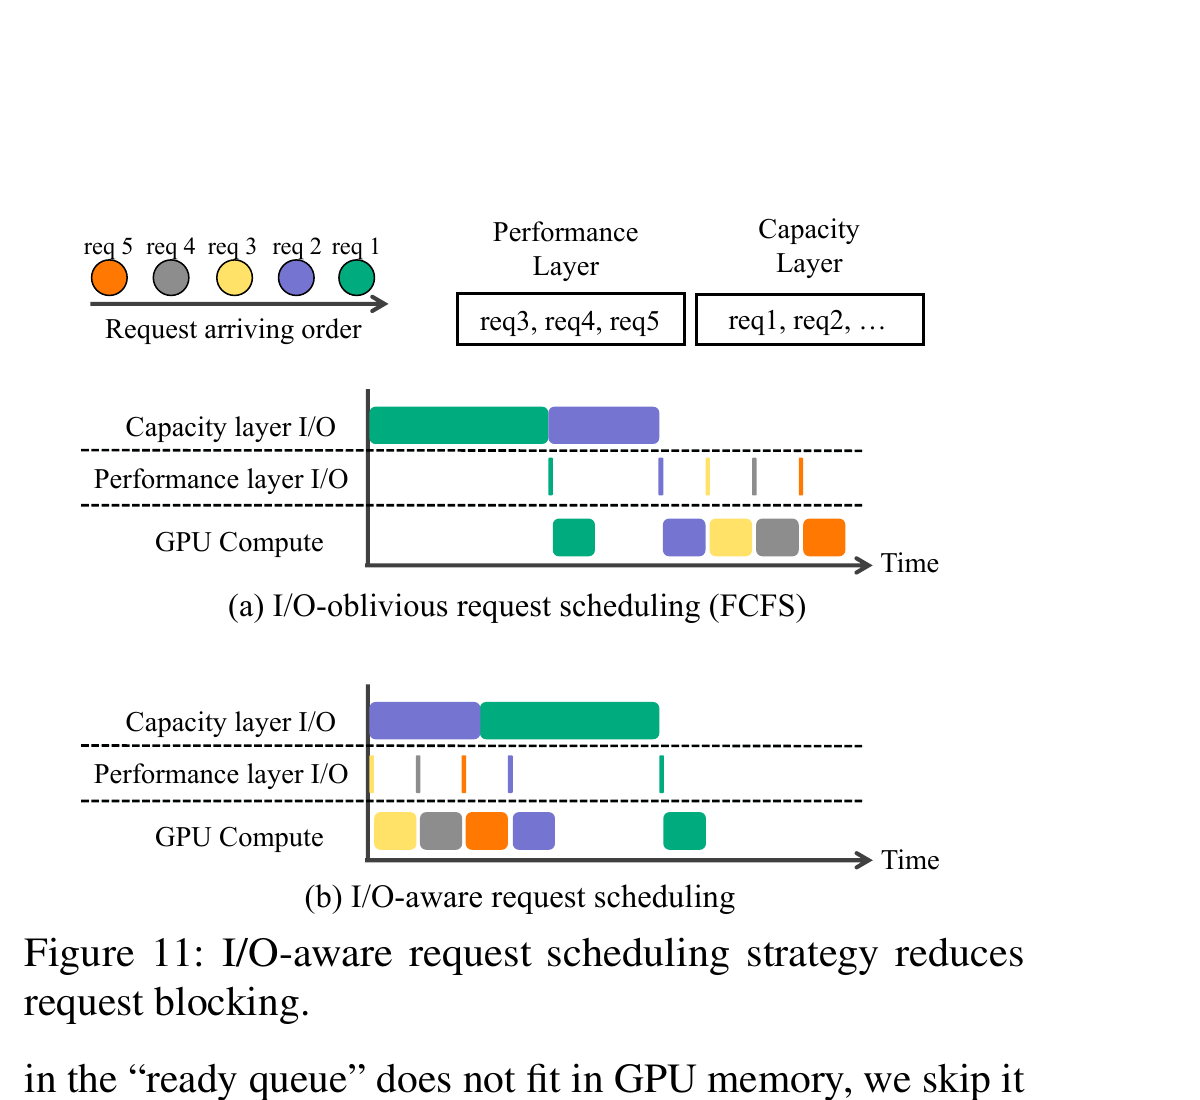
图 2:上图为传统 FCFS 调度,一个大 KV 请求的慢 I/O 阻塞了后续所有请求;下图为 Bidaw 的 I/O 感知调度,performance layer 请求立即执行,capacity layer 请求并行加载不阻塞。来源:论文 Figure 11。
传统 FCFS 调度的问题在于:当一个 KV 在 capacity layer 的请求被调度时,它的慢 I/O(几百毫秒)会阻塞后续所有请求,即使后面的请求 KV 已经在 performance layer 中、只需几毫秒就能加载完成。
Bidaw 用双队列分离解决这个问题。KV 在 performance layer 的请求进入 ready queue,可以立即被调度到 GPU 计算;KV 在 capacity layer 的请求进入 preparing queue,等 KV 被加载到 performance layer 后再提升到 ready queue。这样 capacity layer 的慢 I/O 不再阻塞 performance layer 的快请求。
preparing queue 内部的调度也不是简单的 FCFS。论文设计了一个 disk-HRRN 策略,综合考虑 KV 大小和等待时间:response ratio = 1 + (waiting time / KV size)。小 KV 请求优先发起 capacity layer 读取(因为它们完成快、能更早释放带宽),同时大 KV 请求的优先级随等待时间单调递增,避免饿死。当 preparing queue 中的请求被提升到 ready queue 时,它按原始到达时间而非提升时间插入队列,避免被 FCFS 推到队尾产生不必要的额外延迟。
实验显示,I/O 感知调度把请求排队时间从 5.76 秒降到 2.45 秒,降幅 57.5%。
四、用回答长度预测下次访问:一个出人意料的强相关
论文中最有意思的观测是:在交互式 LLM serving 中,一个 KV 的 weighted reuse distance 的下界与上一轮模型回答长度呈强正相关——跨 12 个时段的 Spearman 相关系数从 0.94 到 0.98。
这个相关性的物理解释很直观。多轮对话中,用户在收到模型回答后需要阅读、理解、然后组织下一个问题。回答越长,用户的处理时间越久,间隔期间涌入的其他用户请求越多,对应 KV 的 reuse distance 就越大。这个规律根植于人类认知速度和交互式对话的固有节奏,不依赖于特定模型或对话领域。
Bidaw 利用这个相关性来预测每个用户的下次 KV 访问距离的下界。但预测下界只是驱逐决策的一半——另一半是判断”reuse distance 大的 KV 是否还有可能命中”。论文通过模拟 Belady 最优策略发现,即使 weighted reuse distance 超过了 performance layer 容量,在某些距离范围内命中率仍然非零。Bidaw 把 reuse distance 分成三个区间:small(一定命中)、promising(概率命中)和 extreme(一定不命中),用 ghost cache 动态追踪每个区间的实际命中率,最终为每个用户的 KV 计算一个综合命中潜力(hit potential)。命中潜力最低的 KV 被优先驱逐。
这个驱逐策略把 performance layer 的 miss rate 降低了 57.6%(相比 queue-enhanced 策略)和 69.9%(相比 FIFO/LRU)。
五、Storage-Efficient Tensor:用更紧凑的中间结果换空间
论文还提出了一个独立但有意义的优化。在 GPU 推理过程中,每个 decoder layer 生成多种中间 tensor,它们之间可以互相转换,但大小和计算节省量差异悬殊。传统方案直接缓存 KV tensor 本身。Bidaw 分析了 OPT-13B 模型中 7 种中间 tensor 的 cost efficiency(每单位存储空间节省的 FLOP),发现 tensor 6(归一化后的激活值)的 cost efficiency 达到 51.0 GFLOP/MB,远超传统 KV tensor 的 30.5 GFLOP/MB。缓存这个更紧凑的 tensor,在加载到 GPU 后用空闲的 SM 转换成 KV tensor,只需数十毫秒的额外计算,换来的是 performance layer 能容纳更多用户的历史数据。
这个优化对 MHA(Multi-Head Attention)架构的 LLM 有效,因为 MHA 的 KV tensor 较大、压缩空间可观。对 GQA 架构的模型,KV tensor 本身已经很小,直接缓存 KV 反而更划算。
六、实验边界与开放问题
Bidaw 在 A800 + 200GB 主机内存 + 1.5 GB/s SSD 的配置上,将 OPT-13B 的响应延迟降低了最高 3.58 倍,吞吐量提升了最高 1.83 倍,在多个模型规模(6.7B 到 30B)上持续优于 CachedAttention 和 FlashGen。尾延迟方面,P90/P95/P99 分别降低 52.96%/49.30%/47.03%(对比 CachedAttention)。在 ShareGPT 公开数据集上,Bidaw 同样能维持 1.40 倍的吞吐量优势,但改善幅度小于内部数据集——因为 ShareGPT 缺乏真实的用户间歇时间戳,previous-answer-based eviction 的信号无法充分发挥。
几个边界需要明确。首先,论文使用的模型(OPT 系列、Qwen 7B/14B)均为 MHA 架构,storage-efficient tensor 优化对当下主流的 GQA 模型(如 Llama 3、Qwen2.5)不适用。其次,SSD 带宽设定为 1.5 GB/s(SATA RAID-5),这在 NVMe SSD 普及的环境下偏保守——更高的 SSD 带宽会缩小两层存储之间的带宽差距,可能削弱双队列分离的收益。第三,回答长度预测的强相关性建立在”用户主动阅读并回复”这个前提上,纯自动化的 agent 调用场景下这个假设不成立。
但论文最有价值的贡献或许是一个系统层面的判断,它超越了具体的调度或驱逐算法:KV cache 管理中,计算引擎和存储系统不应该各自为政。当这两个子系统开始交换信息——哪怕只是 KV 位置和回答长度这样轻量的信号——系统整体就能逼近”所有 KV 都在快速存储”的理想上界。对于任何需要在有限主机内存下服务大量并发多轮对话的部署场景,这个思路值得认真对待。
参考资料
[4] vLLM: Efficient Memory Management for Large Language Model Serving with PagedAttention (SOSP’23)
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。