稀疏注意力听起来像一个计算优化问题:既然每一步 decode 只需要看 top-k KV,就少算那些权重接近零的历史 token。但 LMSYS 这篇 HiSparse 博客真正戳中的地方在另一层:top-k 只减少了“被计算的 KV”,没有自动减少“必须常驻 GPU 的 KV”。当完整上下文仍然压在 HBM 里,sparse attention 很快从算力问题变成容量问题[1]。
HiSparse 的判断很工程化:既然 sparse decode 每步只访问一小部分 KV,就让 GPU HBM 只保留热点区域,把非活跃 KV 主动卸载到 host memory,再用一个专门的 swap-in kernel 在 cache miss 时把需要的条目搬回来。这个方向没有改变模型的稀疏模式,却改变了服务系统能承载的并发形态。
一、top-k sparse attention 没有消除 HBM 容量墙
标准 self-attention 在长上下文下的 O(n²) 计算和 IO 成本很高,sparse attention 通过只访问部分 KV 来降低 decode 阶段开销。问题在于,系统为了保证 top-k 命中后能快速取数,通常仍要把完整上下文的 KV cache 放在 GPU HBM 里。换句话说,计算路径稀疏了,存储布局仍然是密集的。
这会把 batch size 卡在 HBM 容量上。LMSYS 在 GLM-5.1-FP8、32k input + 8k output、PD-colocated 8xH200 的场景里给了一个直观结果:baseline sparse attention 的 token-generation throughput 很早就进入平台期,而 HiSparse 在并发增加时继续接近线性扩展,256 concurrent requests 下超过 baseline 3 倍[1]。
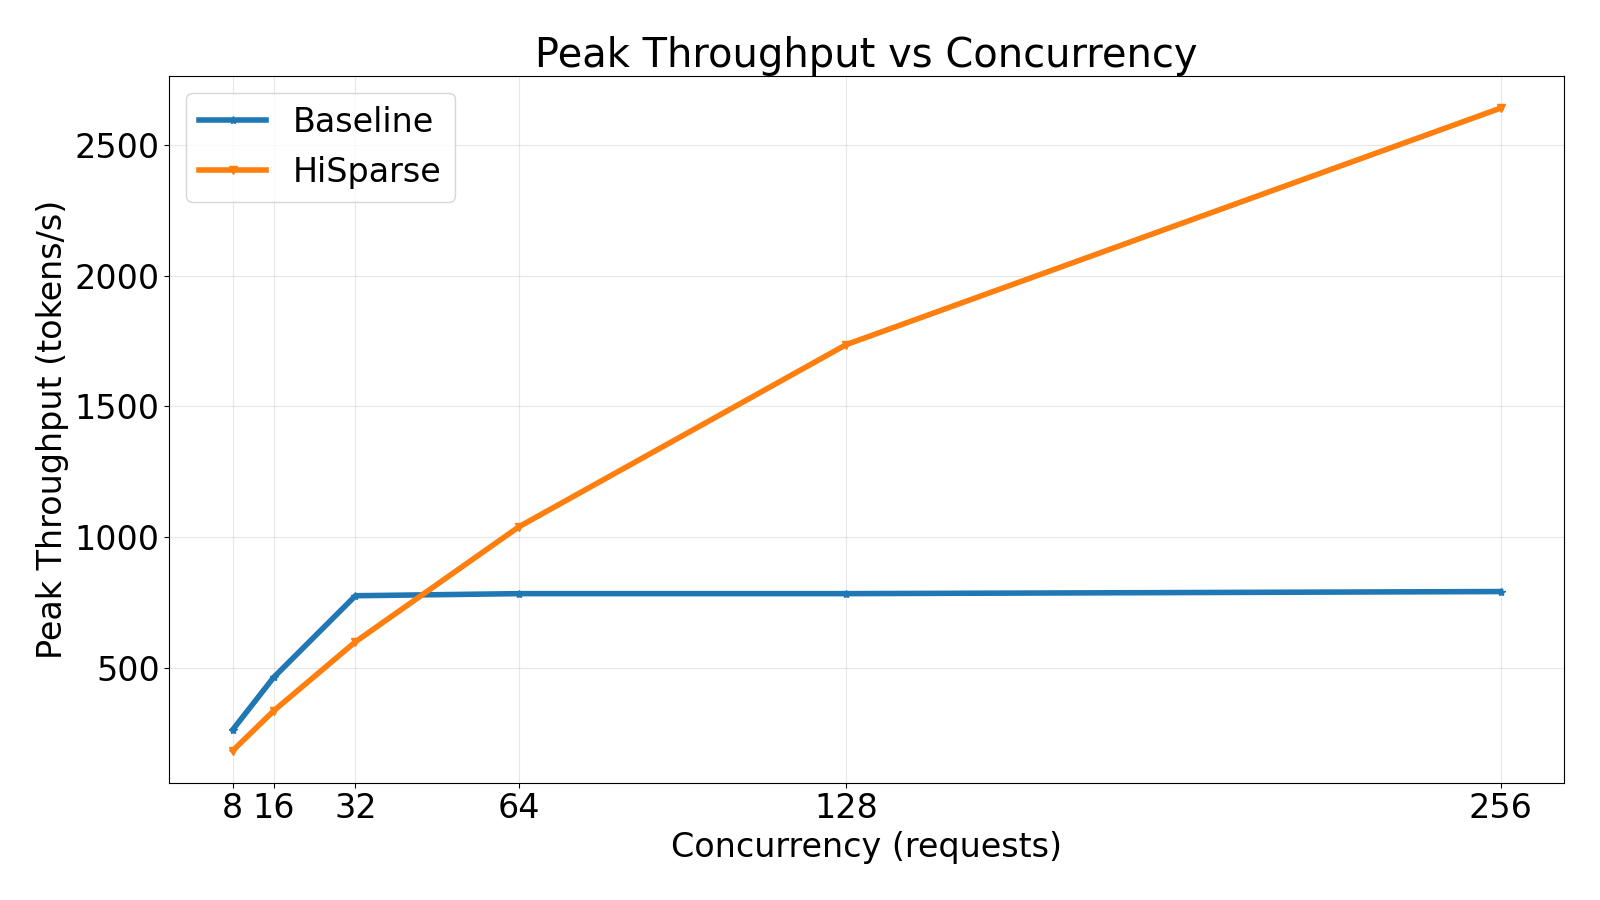
图 1:baseline sparse attention 很快被 HBM 容量限制住,HiSparse 通过把非活跃 KV 卸载到 host memory,让吞吐随并发继续扩展。来源:LMSYS HiSparse blog。
这张图最有信息量的地方其实是低并发区间。HiSparse 在低并发时会引入额外 IO 开销,因为 sparse KV loading 的代价还没有被容量收益抵消。它的工作区间是高并发长上下文场景,本质上是容量换吞吐。把这个前提讲清楚,比单独记住 3x 或 5x 更重要。
二、HiSparse 的系统假设:热点 KV 留在 HBM,冷 KV 下沉到 host memory
HiSparse 沿用了 SGLang HiCache 的分层缓存思路。HiCache 解决的是历史 KV cache 复用问题:当多轮对话和共享前缀越来越长,单靠 GPU 内存保存历史 cache 会降低命中率,所以系统需要把 GPU、CPU、外部存储组织成一个层次化缓存体系[2]。HiSparse 把同一类思想放到了 sparse attention 的 decode 路径里。
核心结构很直接:GPU HBM 上维护 hot device buffer,host memory 保存更多 inactive KV entry。decode 时,sparse attention 先决定当前 step 需要访问哪些 top-k KV;如果目标 KV 已经在 device buffer,直接参与计算;如果发生 miss,就从 host memory swap in,同时按 LRU 策略挑选 eviction candidate,把 device buffer 继续留给近期更可能复用的 KV。
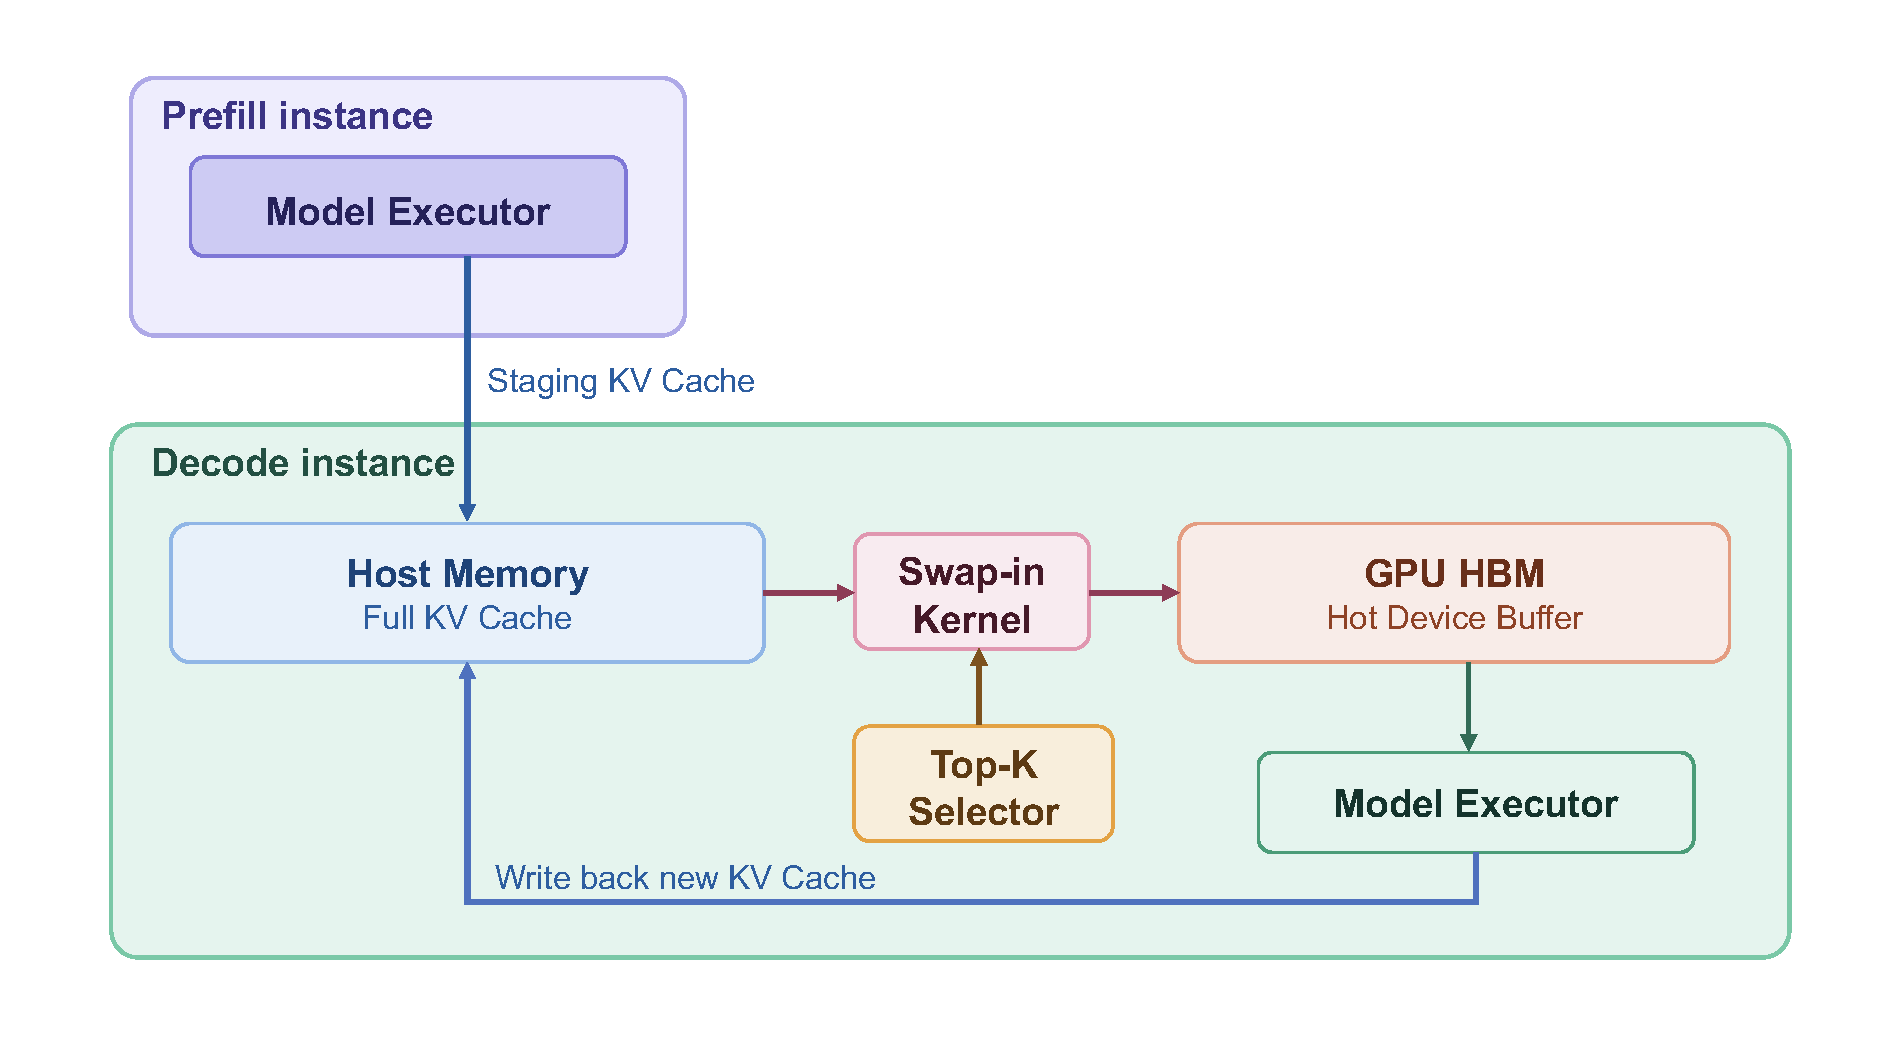
图 2:HiSparse 在 GPU HBM 维护 hot buffer,在 host memory 保存更大的 inactive KV 集合。图里展示的是 P/D 分离形态,但 LMSYS 表示该设计同样适用于 colocated instance。来源:LMSYS HiSparse blog。
这个设计的微妙之处在于,它把 sparse attention 的“选择”拆成了两层。模型或 attention backend 负责决定当前 step 的 top-k 访问集合;HiSparse 负责让这个访问集合对应的 KV 以尽量低的延迟出现在 HBM 中。前者是算法语义,后者是内存系统。工程上最容易出问题的地方,也正在这两层交界处:top-k 分布如果频繁跳动,host-to-device swap 就会落在 decode critical path 上。
三、swap-in kernel 才是 HiSparse 的关键路径
LMSYS 在博客里把 Efficient Swap-in Kernel 单独拎出来,是有原因的。分层内存方案最怕把控制面和数据面拆得太碎:每次 miss 都要查表、找 victim、更新 page table、触发 host-to-device copy,如果这些动作被串行化,sparse attention 节省下来的计算很快会被 IO 和调度开销吃掉。
HiSparse 的专用 CUDA kernel 同时做三件事:识别 top-k cache miss,按照 LRU 选择被驱逐的 device buffer entry,更新 page table 并把需要的 KV 从 host memory 拉回 GPU[1]。这一步把 miss handling 收进 decode 路径里可控的设备端逻辑,避免后台搬运线程把延迟抖动留给调度器兜底。
博客里的 miss count 实验用 DeepSeek-V3.2、top-k=2048、LongBenchV2 展示了 hot buffer size 和 eviction policy 的影响。device buffer 从 2048 slots 增到 4096 slots 后,miss count 明显下降;LRU 也比缺少局部性利用的策略更稳。这个数字没有直接给出端到端 latency,但它解释了 HiSparse 的性能条件:swap-in 次数越少,分层内存越像容量扩展;miss 越频繁,host memory 就会变成 decode 的刹车。
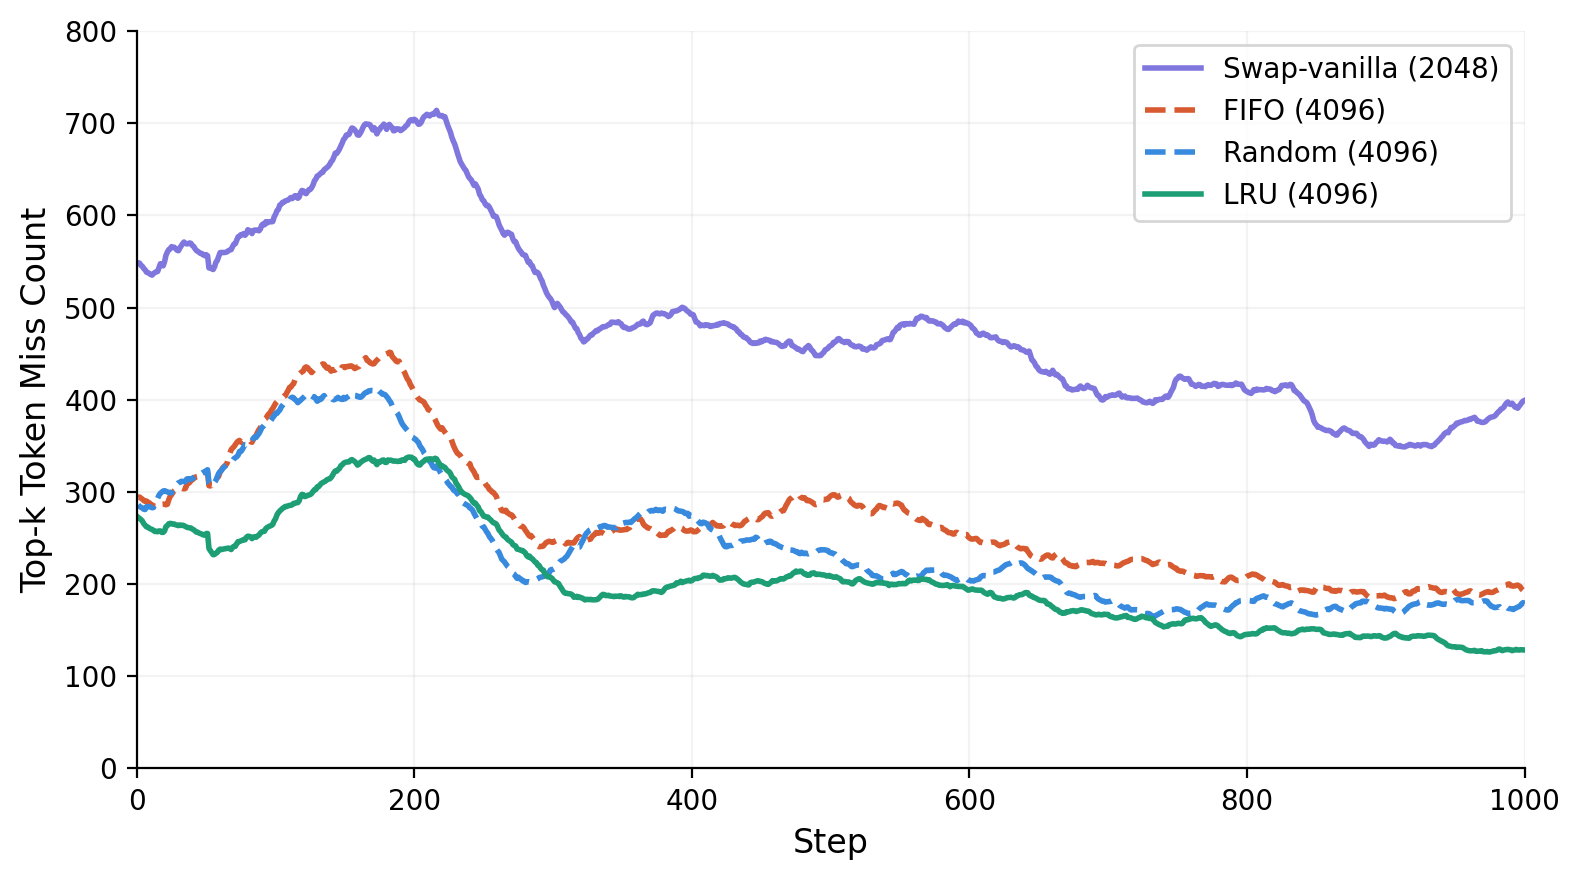
图 3:更大的 hot device buffer 和 LRU eviction 会降低 top-k cache miss count。对 HiSparse 来说,miss count 是吞吐收益能否兑现的前置指标。来源:LMSYS HiSparse blog。
站在系统调优角度看,top_k、device_buffer_size 和 host_to_device_ratio 这三个参数会决定 HiSparse 的工作区间。官方示例里,PD-disaggregation decode instance 使用 top_k=2048、device_buffer_size=6144、host_to_device_ratio=10;单机 8xH200 colocated 配置则给出 device_buffer_size=4096、host_to_device_ratio=8[1]。这些值更像生产入口参数,不能当作算法论文里的固定常数。实际部署需要根据上下文长度、并发、模型 sparse pattern 和 CPU-GPU 带宽重新扫。
四、吞吐收益来自高并发,不来自单请求魔法
HiSparse 最容易被误读成“sparse attention 再快 5x”。原文给出的范围更窄:GLM-5.1-FP8 在不同 input/output sequence 配置上,长上下文场景可达到最高 5x throughput improvement;同时作者明确说 HiSparse 目前是 experimental feature,面向 high-concurrency scenarios,并且会因 top-k cache miss 引入额外 IO overhead[1]。
这组边界很关键。单请求、低并发、短上下文下,GPU HBM 还没有被 KV cache 压满,主动卸载会增加一条 host-to-device 数据路径。HiSparse 要赢,需要两个条件同时成立:一是完整 KV footprint 已经限制 batch size,二是 sparse pattern 有足够局部性,让 hot buffer 命中率维持在可接受范围。前者提供容量收益,后者控制 IO 成本。
这也解释了为什么 HiSparse 和 P/D disaggregation 放在一起看更自然。Prefill 节点负责长输入计算,decode 节点承受高并发、长时间驻留的 KV 压力。decode 侧如果只能靠 HBM 容量撑住所有上下文,batch size 会很快撞墙;如果能把不活跃 KV 下沉,decode 节点就能把 HBM 留给当前真正参与计算的热点。P/D 分离把计算阶段拆开,HiSparse 则继续把 decode 内部的 KV 生命周期拆开。
五、从 HiCache 到 HiSparse:SGLang 的缓存路线正在变厚
把 HiSparse 放进 SGLang 的缓存演进里看,会更容易理解它的价值。RadixAttention 解决共享前缀复用,HiCache 把历史 KV 扩展到多级存储,HiSparse 则处理 sparse attention 下“完整 KV 常驻 HBM”的浪费。三者都围绕同一个系统事实展开:长上下文服务里,KV cache 已经是推理系统的主要资产,不能再被当成 attention kernel 的附属数据结构。
HiCache 博客里给过两个生产数字:Novita AI 在 Qwen3-Coder-480B 场景中,把平均 TTFT 降低 56%、吞吐翻倍、cache hit rate 从 40% 提到 80%;Ant Group 在 DeepSeek-R1-671B 的 P/D 分离部署里,cache hit 相比 full recomputation 平均减少 84% TTFT[2]。这些数字讨论的是历史 KV 复用,HiSparse 讨论的是 sparse KV 驻留,但它们共同指向一件事:推理框架的竞争正在从“有没有 KV cache”进入“如何管理 KV cache 的生命周期”。
HiSparse 当前支持使用 DeepSeek Sparse Attention 的模型家族,包括 DeepSeek-V3.2 和 GLM-5.1。这个覆盖范围还很窄,作者也把它放在 future work 里,计划继续扩展到更多 emerging architectures,包括 hybrid models[1]。因此它现在更像一条清晰的工程路线,距离泛化到所有 long-context 模型还需要更多模型覆盖和生产验证。
六、结论
HiSparse 最值得记住的判断是:稀疏注意力落地以后,系统瓶颈会从“算哪些 token”继续下钻到“这些 token 的 KV 住在哪里”。top-k attention 减少了每步计算集合,但只要完整 KV 还常驻 HBM,高并发长上下文服务依然会被容量限制住。HiSparse 用 host memory 承接 inactive KV,再用 hot buffer 和 swap-in kernel 把访问路径接回 GPU,给出了一个很 SGLang 式的回答。
这条路线的适用边界也很明确。它需要高并发、长上下文、可预测的 sparse locality,以及足够好的 CPU-GPU 带宽;低并发或 miss 频繁的 workload 可能只会看到额外 IO。后续真正该追的是两个问题:更高带宽平台(例如 Grace Blackwell)能不能把 swap-in 成本进一步压低;以及 hybrid / sparse 模型越来越多之后,推理框架会不会把“分层 KV 生命周期管理”做成默认能力,覆盖更多模型家族。
参考资料
[1] HiSparse: Turbocharging Sparse Attention with Hierarchical Memory
[2] SGLang HiCache: Fast Hierarchical KV Caching with Your Favorite Storage Backends
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。