KV cache 的内存占用随 context length 和 batch size 线性增长——在 FP16 时代,一个 70B 模型跑 32K token 的对话,KV cache 本身就能占去数十 GB 显存。FP8 把这个数字减了一半,而 NVIDIA 在 Blackwell 上推出的 NVFP4 KV cache 方案,在 FP8 的基础上再减一半,最终落到 4-bit per value。
从 FP16 到 FP8 是精度减半,从 FP8 到 4-bit 同样是精度减半,但两步的代价并不对称。FP8 量化已经成熟,精度损失几乎可以做到不可见;4-bit 能否达到同等效果,取决于量化在计算流程的哪个位置发生。NVFP4 KV cache 的核心设计选择,是把这个边界放在 attention 计算的两侧:KV 在显存里是 4-bit,但 attention kernel 运行前先 dequant 回 FP8,计算完成后再 requant 写回 cache。
一、量化边界比量化位数更关键
NVFP4 的 attention 流程可以拆成三步:从 cache 取出 K/V(NVFP4,4-bit)→ dequant 成 FP8 → 跑 attention → 把新 token 的 K/V requant 成 NVFP4 写回[1]。
这个设计的核心在于:attention 的计算精度由 FP8 保障,量化误差只出现在存储边界,不会在矩阵乘法中积累。如果反过来——在 4-bit 精度下直接跑 attention——精度损失就会显著扩大,因为内积运算对低精度的误差放大效应比简单存储高得多。
换一种说法:NVFP4 KV cache 是一个存储优化,不是一个计算优化。Blackwell GPU 的 Tensor Core 跑 attention 仍然在 FP8;节省下来的是显存带宽和 HBM 容量,不是 FLOPS。在评估适用场景时,这一点值得记住——真正的瓶颈在内存,收益就会实现;如果瓶颈在计算,NVFP4 对吞吐的改善有限。
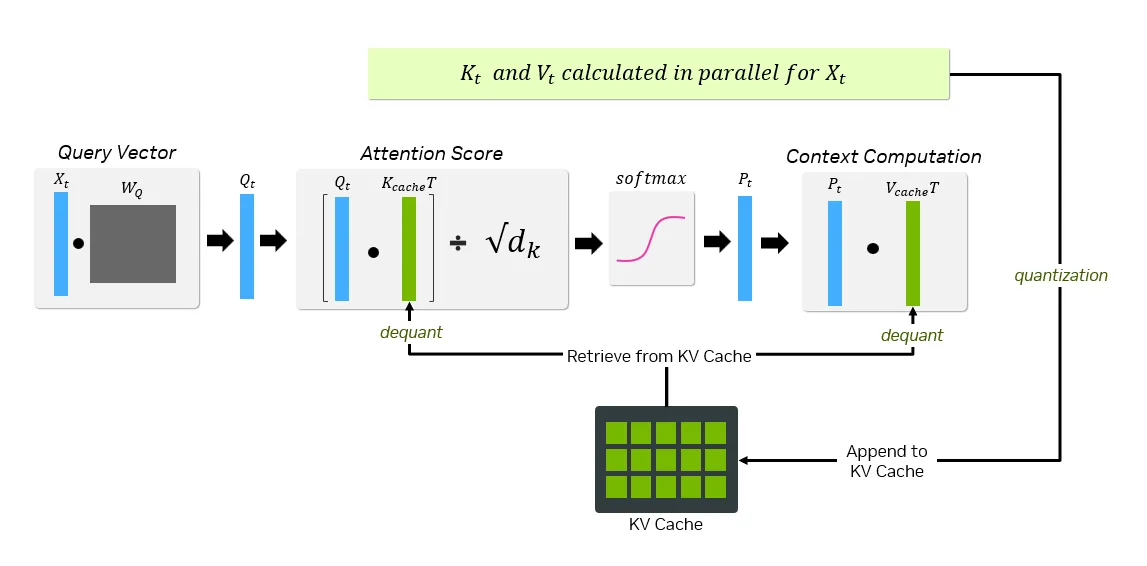
图 1:K/V 从 cache 取出后先 dequant 到 FP8,attention 计算结束后再 requant 写回。量化误差只发生在存储边界,不在矩阵乘法中积累。来源:NVIDIA Technical Blog。
二、三个数字背后的因果链
NVIDIA 给出的性能数字有三组:内存减少约 50%(vs FP8)、TTFT 最高改善 3x、精度损失 < 1%[1]。这三个数字不是孤立的,它们通过一条特定的因果链连接。
内存减半意味着在相同显存容量下可以缓存两倍的 K/V 历史。对于服务多个并发请求的推理集群,这直接体现为 cache hit rate 的提升——博客数据显示比 FP8 高出最多 20%。hit rate 提升之后,更多请求可以复用已有的 KV 序列,避免 prefill 重算,TTFT 随之下降,最高到 3x。
3x 的 TTFT 改善不是”计算变快了”,而是”缓存命中了,不用重算”。这个收益对 context 短、并发低的场景几乎不存在——如果每个请求都是全新 prefix,hit rate 本来就接近 0,NVFP4 省出来的 cache 空间也无法转化为延迟收益。
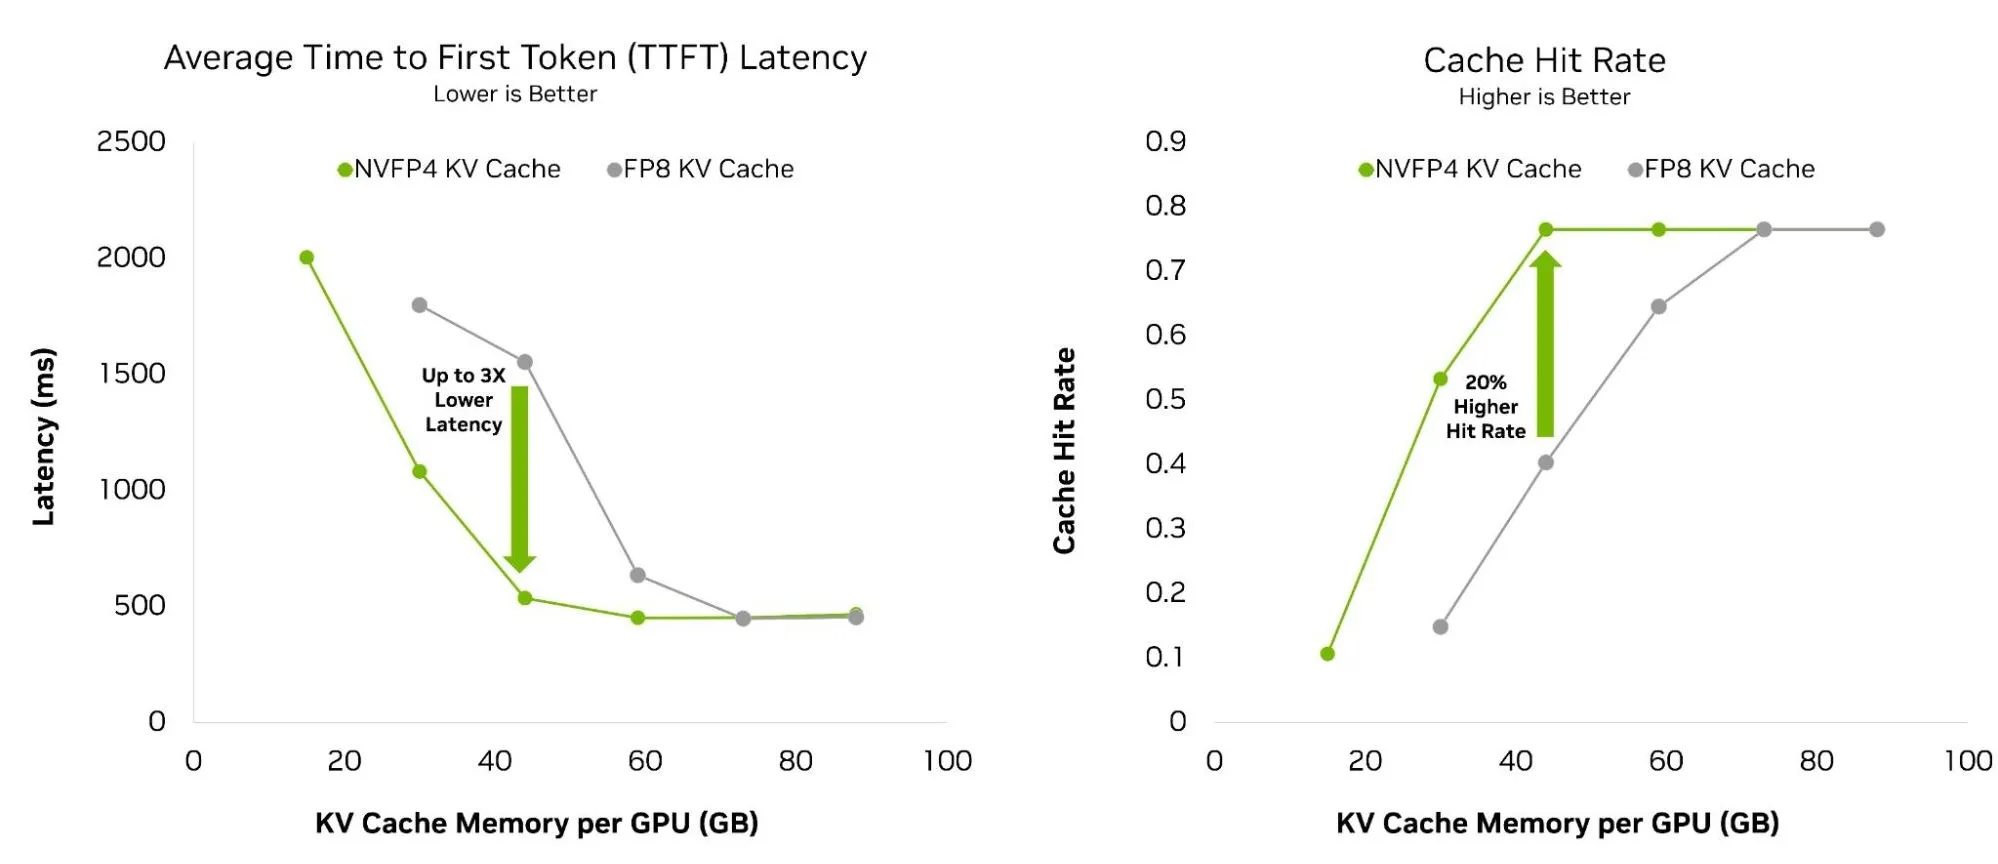
图 2:NVFP4 相比 FP8 的 TTFT 延迟与 cache hit rate 对比。TTFT 的改善直接由 hit rate 提升驱动,最高 3x 延迟降低对应 cache hit rate 提升约 20%。来源:NVIDIA Technical Blog。
精度方面,在 Qwen3-Coder-480B-A35B 上的实测结果是:MMLU-PRO 77.4%(FP16 是 78.2%)、MBPP 79.9%、Ruler 64K 94.6%[1],三个 benchmark 全部控制在 1% 损失以内。这套结论在代码生成、知识问答、长文档推理三类任务上都成立,说明精度的边界并非特定任务驱动的。
三、NVFP4 不选 MXFP4 的理由
MX(Microscaling)系列格式是 Open Compute Project 主推的开放 4-bit 标准,AMD、Intel、Arm 均宣布支持,设计目标是跨硬件的互操作性。NVIDIA 在 KV cache 量化上没有选 MXFP4,而是用了自家的 NVFP4。差别在两处:block scaling 的粒度(NVFP4 更细)和 scaling factor 的格式(NVFP4 用 E4M3 FP8,精度高于 MXFP4 的 integer 或 E5M2 方案)。在 Llama 3.3 70B 的 MMLU 实测中,NVFP4 比 MXFP4 高出约 5%[1]。
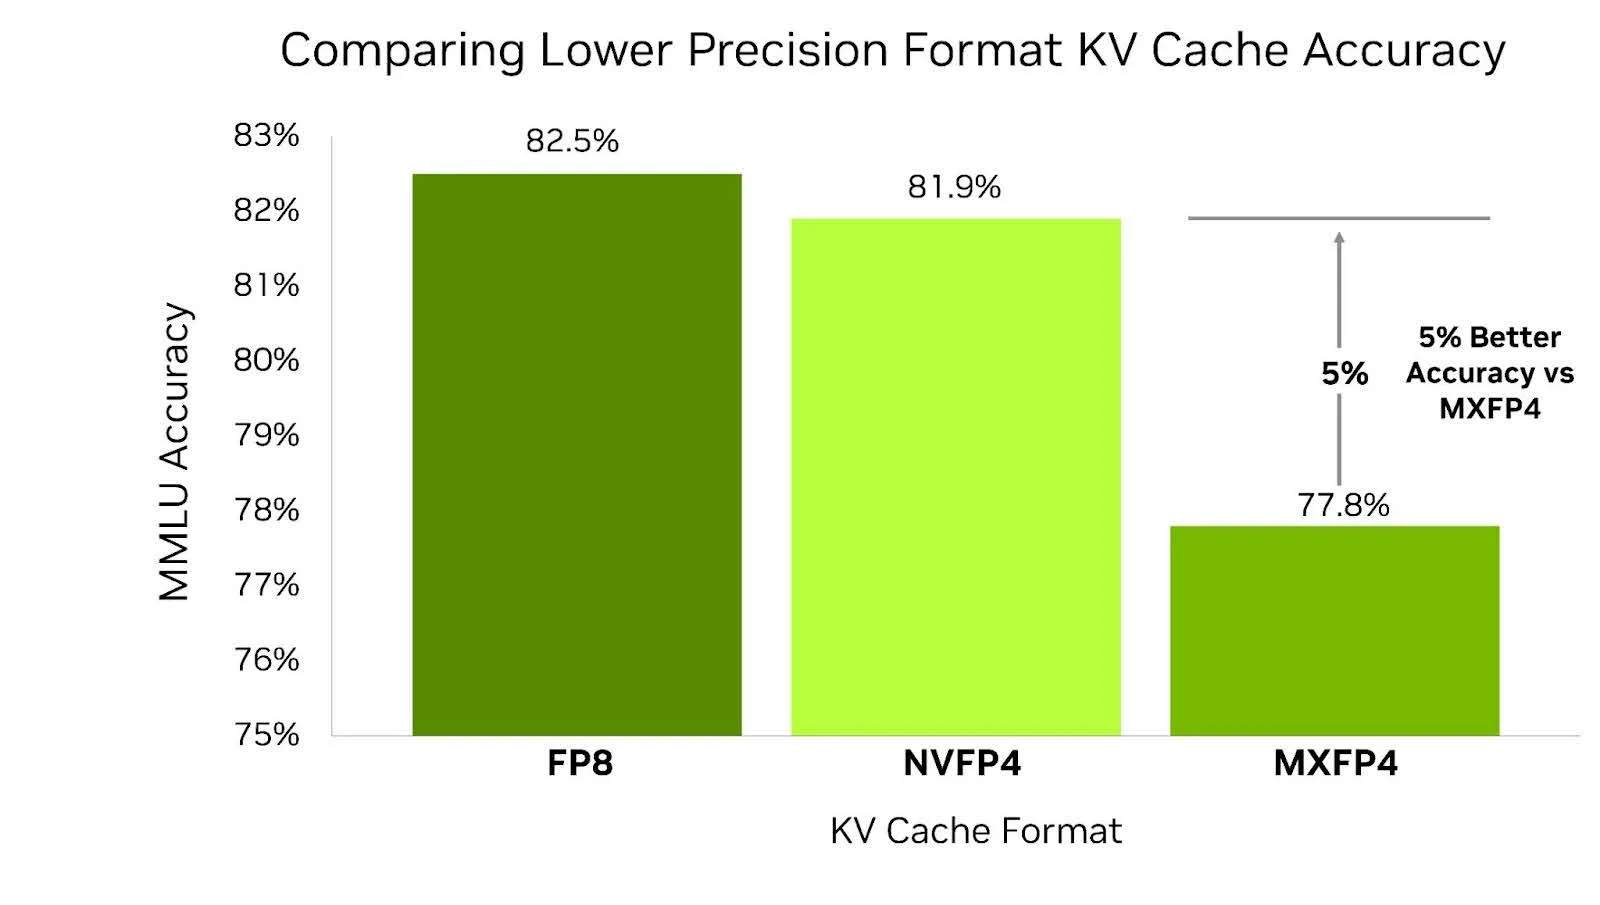
图 3:NVFP4 与 MXFP4 在 MMLU 上的精度对比(Llama 3.3 70B)。细粒度 block scaling 和 E4M3 FP8 scaling factors 是 NVFP4 精度优势的来源,约 5% 的差距在量化格式选择里相当显著。来源:NVIDIA Technical Blog。
这是一个精度与兼容性之间的权衡:NVFP4 把 Blackwell 的硬件特性压榨到极致,代价是离开 Blackwell 就无法使用相同的量化方案。对于已经全面迁移 Blackwell 的推理集群,这个选择合理;对于需要跨平台部署的场景,MXFP4 的兼容性更值钱。
四、这些结论成立的条件
NVFP4 KV cache 目前是 Blackwell GPU 专属。Tensor Core 对 NVFP4 格式的 native 支持是这套方案能以 FP8 精度做存储、以 FP8 速度做计算的硬件基础。H100/H200 不支持 NVFP4;如果推理集群还在 Hopper 上,这篇博客的数字暂时没有参考意义。
量化流程需要经过 NVIDIA TensorRT Model Optimizer 的 quantize API,支持 PTQ(训练后量化)和 QAT(量化感知训练)两条路径。PTQ 更快,但如果模型对量化敏感,QAT 可以进一步缩小精度差距。这一步需要单独的量化工作流,不是直接把模型部署到 vLLM 或 TRT-LLM 那么直接。
收益最明显的场景是:长 context(32K token 以上)+ 高并发(cache hit rate 可以起来)+ 存储瓶颈(显存被 KV cache 占满,导致 batch size 受限或 eviction 频繁)。短对话、低并发的负载,KV cache 本身不是主要瓶颈,NVFP4 的优先级就没那么高。
五、结论
NVFP4 KV cache 说明了一件事:在 Transformer 推理链路里,存储精度和计算精度是可以解耦的。量化边界放在 attention kernel 的入口和出口,计算本身不受影响,精度损失被限制在存储边界内。这个思路不局限于 KV cache,在权重缓存、激活值存储的量化设计里,同样的边界选择逻辑值得借鉴。
数字层面,4-bit KV cache 在 Blackwell 上做到了 < 1% 精度损失、内存减半、长上下文高并发场景 TTFT 最高改善 3x。这些已经足够让 Blackwell 用户认真评估部署路径。
还有一个开放的问题:< 1% 的精度损失是在 LiveCodeBench、MMLU-PRO、MBPP、Ruler 64K 等 benchmark 上测出来的,但生产 workload 的分布通常和 benchmark 不同。对于 reasoning-heavy 的任务——长链推理、多步 agent 循环——4-bit KV cache 对推理连贯性的影响目前缺乏系统性数据。在决定大规模上线之前,这是值得自测的一环。
参考资料
[1] Optimizing Inference for Long Context and Large Batch Sizes with NVFP4 KV Cache
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。