这篇 Snowflake AI Research 与 UVA 合作的论文,核心判断是一个”翻转”:MoE 推理里的专家并行(EP),不该按激活去路由专家,而应该把专家权重流到你计算所在的地方[1]。翻转的依据来自一个经常被忽略的工程事实——生产集群里 65.3% 的输入 token 属于 prefill-only 任务,这些任务没有 decode,只跑一次 forward,返回 logits 就结束。它们在吞吐、batch 规模和前缀共享三个维度上都跟传统生成式 serving 有本质区别,而现有 EP 方案——带着每层两次同步 AllToAll——是 decode 时代留下的惯性设计。
翻转操作本身不复杂,但让它成立的条件链才是这篇论文最值得认真看的部分:长 batch prefill 的逐层计算窗口足够宽,异步把下一层专家权重 Gather 过来,正好被当前层计算盖住;而计算窗口要稳定大于传输窗口,需要调度器按一个物理上限装填每个 GPU 的 batch。这个上限就是饱和阈值 T,也是前场(调度器)和后场(执行引擎)之间的协同接口。
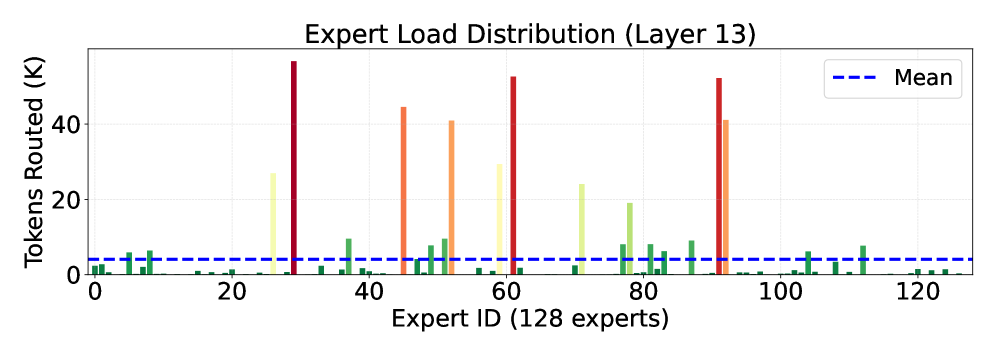
图 1:ZeRO-Prefill 的两层架构:前场将任务规范化为 prefill-only 形式并按饱和度调度;后场用纯 DP attention + 异步专家流式执行每个 batch。来源:论文 Figure 5。
一、65.3% 的 token 不需要 decode
论文开篇拿出了一个量化事实:在一个匿名生产集群的测量中,prefill-only 负载已经占全部输入 token 的 65.3%。这些负载包括分类、内容审核、推荐、事实核查——任务的共同特征是答案固定在一个小候选集里,一次 prefill 的 logits 就决定了输出。
作者把这类任务统一抽象为一种原子操作 prefill-as-a-service:输入上下文 c,给定候选 token 集 C,做一次 prefill,返回 argmax 后的 logit。没有迭代 decode,没有逐 token KV 更新。这个定义的价值不在于形式化本身,而在于它把表面上不同的任务(二分类、多选、推荐排序)归约到了同一套系统语义下,让调度、缓存和并行策略不再需要按任务类型分叉。
这也意味着三件事跟生成式 serving 方向不同。第一,吞吐优先,不是延迟优先,batch 可以很大。第二,每个 prefill 的 token 量巨大,前向传播是 compute-bound 而不是 memory-bandwidth-bound。第三,前缀复用概率高——共享的系统 prompt、用户画像、文档头在同 batch 和跨 batch 之间都大量重复。
这三个特性组合起来,就是 AsyncEP 能在工程上成立的底层土壤。论文没有在背景里泛泛介绍”LLM 推理的两种模式”,而是每一步都只讲了接下来设计用得上的特性,这种信息密度本身值得注意。
二、三重冗余来自同一个设计惯性
论文用 §4 一整节量化了现有 MoE 并行策略在 prefill-only 场景下的损失,写得像一张因果链:显存放不下 → 必须用分布式并行 → 分布式并行引入三种冗余 → 模型 FLOPs 利用率(MFU)被压到 16% 以下。
三种冗余对应论文标题里”Zero Redundancy”的三个靶心:
计算冗余来自两层割裂。模型层面,分布式执行把 token batch 拆散到每张 GPU,单卡的 GEMM 维度太小,Tensor Core 吃不饱。层内层面,MoE 的 top-k 路由天然不均衡——论文在 Qwen3-30B-A3B 上测量到跨 48 层 aggregated 的 max/min token count 比达到 16.15x,单层内部更严重。这导致两个结果:per-expert GEMM 又小又碎,利用率更低;EP barrier 下,负载最重的 GPU 成为 straggler,拖慢整层。
存储冗余来自三个竞争 HBM 的消费者——模型权重、KV cache、激活值。MoE 的总参数量扩张速度远超单卡 HBM 增长,235B 的模型在 FP8 下也要 235 GB,两张 H100 的 160 GB HBM 塞不下,≥4 GPU 纯粹是为了装下权重。同时 KV cache 随 B×S 线性增长,激活值还被 top-k 放大了 k 倍——三条线同时吃掉同一块 HBM。
通信冗余是 EP 最明显的代价:每层两次同步 AllToAll,流量跟 B×S×H 成正比,k 的 fan-out 还要再放大。论文在 Table 1 里把七种 attention-expert 并行组合的每设备每层通信量算了一遍——DP×EP 是高通信,TP×EP 更高。AsyncEP 那行写的是 ≈0。
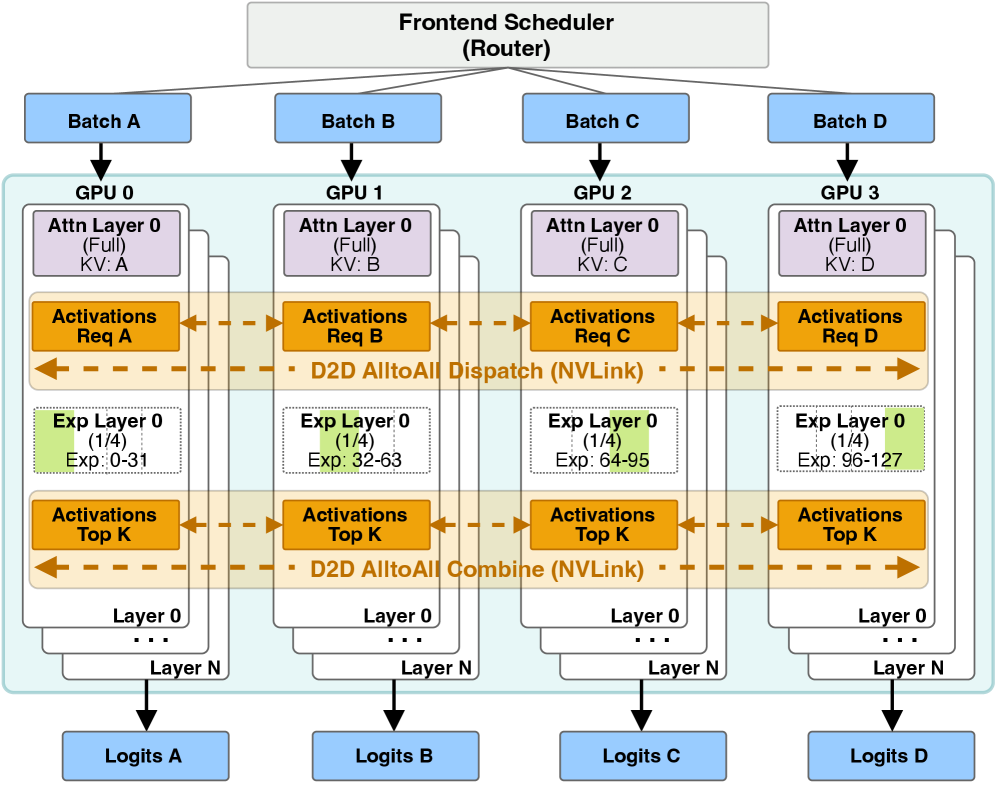
图 2:AsyncEP 的两种执行模式。(a) D2D only,每张 GPU 持有第一层完整 expert set,在当前层计算时通过 NVLink AllGather 下一层权重;(b) 加入 offloading 后,双通道流水线同时拉取近层(D2D)和远层(H2D PCIe)。来源:论文 Figure 7。
三、AsyncEP 的核心不是异步,是聚集对象从 activation 换成了 weight
名字里的”Async”容易让人以为这只是把通信异步化了——很多系统做过类似的 AllReduce/AllGather overlap。但论文真正的翻盘点不在异步,在于把 EP 的调度对象从 activation 换成了 weight。
在同步 DP+EP 下,每层要做两次 AllToAll:一次把 activation token dispatch 到持有对应 expert 的 GPU,计算完后再一次把结果 combine 回来。这是”activation 去哪,计算就去哪”的逻辑,Expert 在物理上固定位置,token 是流动的。
AsyncEP 的逻辑反过来:每个 GPU 持有完整的当前层 expert set,token dispatch 变成 local 操作,不产生任何跨卡通信。那 expert weight 怎么到这张 GPU 上?在当前层计算的时候,后台 D2D AllGather 把下一层的 expert 权重从分布在其他 GPU 上的 1/N 切片中收拢过来。到当前层算完,下一层的完整权重已经在本地了。
这一翻的好处不止是消除通信。因为 top-k dispatch 现在完全在卡内完成,expert routing imbalance 导致的 straggler 问题直接消失了——没有 barrier,就没有最慢的那张 GPU 拖累整层的概念。论文的”零冗余”里,C2(路径上无同步集体通信)和 C3(负载均衡不需要单独策略)是从这一翻同时解掉的。
四、饱和阈值是 co-design 的枢轴
AsyncEP 在概念上很干净,但要让它不在工程上崩盘,需要一个条件:D2D AllGather 的时间必须被当前层计算 100% 遮盖住。论文用饱和阈值 T 来刻画这个条件:
T = t_EP × F_GPU × γ
其中 t_EP 是每层最慢的 EP 数据传输时间(D2D AllGather,或者在 offloading 模式下变慢的那个通道),F_GPU 是 GPU 峰值 FLOPS,γ 是一个 ≥1 的 jitter 系数。T 的物理意义是:每张 GPU 必须装填足够多的 FLOPs 才能保证当前层计算时间 ≥ 传输时间。
T 不是调度器自己猜的,是后端在启动时根据硬件和模型配置一次性标定出来的。前端调度器的任务就是给每张 GPU 灌任务,直到每张 GPU 的累计 FLOPs ≥ T。论文的调度器同时做三件事:把同一前缀的请求聚到同一张 GPU(前缀感知路由),用扣除前缀复用后的真实 FLOPs 衡量负载(计算感知跟踪),以及用 T 作为停装信号(重叠感知平衡)。
这里有一个设计细节值得提一句。前缀复用不只是在调度器里做的 paper claim——它复用了 engine 已有的 block table,按 16 token 的 block 粒度做 hash 匹配,匹配成本从 O(P) token 级降到 O(P/B) block 级。in-batch 和内 batch 间复用走的是同一套最长 block 匹配规则,不需要额外的 batch assembly 机制。这也是 co-design 的另一个体现——调度器和引擎共享 KV 布局的单一真相源。
图 1 里的三层调度 pipeline 被作者在 §7 里拆成了三个更具体的约束:F1 决定请求去哪(前缀复用),F2 量度真实成本(扣除复用后),F3 决定什么时候停(饱和边界)。论文甚至给了一个例子说明现有调度器为什么会出错:10 个共享 4096 token 前缀的请求,按 token count 算会认为是 10×(4096+S_sfx) 的负载,调度器会主动把它们打散;按真实 FLOPs,只有一次 prefix pass + 10 次 suffix pass,调度器应该继续往同一张 GPU 上堆。这个对比直接把它跟前缀感知调度的另一个流行系统 Hydragen 做了区分。
五、实验数字有两点值得细看
论文在 8×A100 BF16、8×H100 BF16/FP8、8×H200 FP8 四组配置上,用 Qwen3-235B-A22B(128 experts, top-8 routing)跑了一个聚合了 6 个 benchmark、73.8K 请求、~37.9M token 的混合负载。端到端吞吐的结论很稳定:在所有硬件/精度/并行度组合下,ZeRO-Prefill 比最强 baseline 高出 1.35–1.37×。
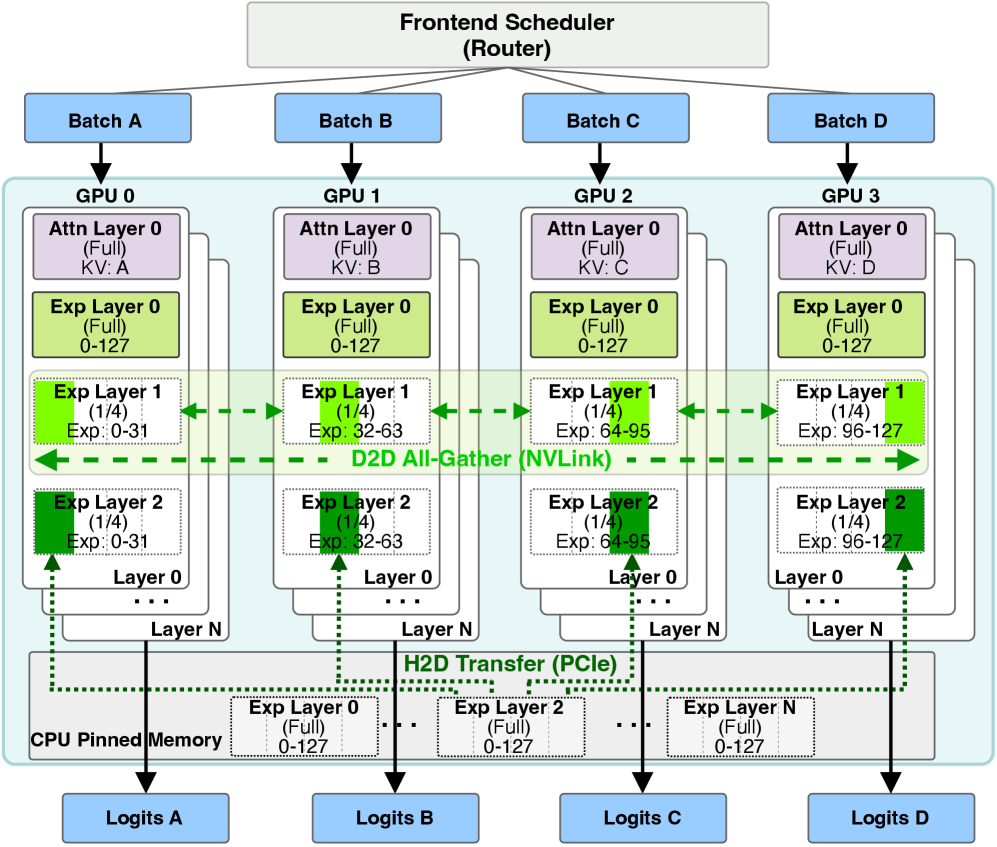
图 3:四组硬件/精度配置下的端到端吞吐。每张子图对应一组配置,柱子对比 5 种分布式 baseline 与 ZeRO-Prefill 在 1/2/4/8 GPU 下的表现。来源:论文 Figure 9。
但有两组数字我觉得比 headline gain 更有信息量。
第一组是前场贡献的拆解(Fig. 10)。纯 DP+AsyncEP(用 vLLM 默认调度器)已经拿到大部分收益,但加上论文的 co-design 前端后,8 GPU 下还能再提 16–18%。这个增益随并行度放大——GPU 少的时候随机调度也能撞上前缀命中,GPU 一多,默认调度器把同前缀请求打散到不同卡,reuse 就被稀释了。论文的前端用了最长的 block 匹配路由来对抗这个稀释,GPU 越多,贡献反而越大。
第二组是 MFU 数据(Fig. 12)。在无前缀复用的合成负载下,所有 baseline 从 4 GPU 到 8 GPU,MFU 单调下降——DP+EP 在短文本下直接掉 1.90×。ZeRO-Prefill 在任意上下文长度和 GPU 数量组合下都保持在 29.8–36.2% MFU,比 baselines 的最佳 8 GPU cell(TP+TP 在 128K,20.09%)还高出一大截。更值得关注的是 1-2 GPU 的数据点:只有 ZeRO-Prefill 能在这么窄的 HBM 上跑通 Qwen3-235B,而且 MFU 不减——因为此时 per-GPU batch 很大,PCIe H2D 传输同样被计算盖住。
这个 1-8 GPU envelope 的拓宽是工程上最有实际意义的结论之一。从”必须 4 GPU 起步”降到”单卡也能跑”,意味着同样的预算可以跑更多实例、不同规模的模型可以共用同一批机器、或者用 A100/L40S 这类成本更低的 GPU 替代 H100。
六、论文没有回答的问题
论文的边界的清晰的。它明确把适用场景限定在”吞吐导向的 batch-driven prefill-only serving,且模型必须是单卡 HBM 放不下的大型 MoE”。交互式 serving、burst 到 T 都稳不住的请求流、dense 模型,都不在 scope 内。
但我认为还有几个问题值得追问。
低带宽互联的退化。论文在 Discussion 里承认,当跨卡互联带宽不够时,t_EP 和 T 会同步变大,部分传输可能重新露出 critical path。论文在 NVLink-only 的 H100/A100 上验证了主路径,但实际部署中 PCIe-only 的机器仍然很常见。在这种硬件上 AsyncEP 的收益会衰减多少,以及能否通过调整 T 的 γ 系数来适配,数据点尚缺。
饱和阈值的动态性。T 在启动时标定一次,假设负载的特征稳定。论文说 prefill-only batch 能快速回填 T,但当请求的上下文长度在几轮内从平均 4K 跳到 128K 时(生产里确实会这样),GPU 的 load 会短暂掉到 T 以下,部分层的 transfer 就会重新暴露。论文的处理方式是”短时间内回到同步行为,prefill batch 会快速补回来”,但这等于承认在某些边界场景下 AsyncEP 会退化成同步 EP——一个更定量化的退化曲线会比文字描述更有说服力。
DP attention 的 scaling。论文选择把 attention 全部放在 DP 上,这是 AsyncEP 成立的前提之一(attention weight 全复制,没有 EP spillover)。但 attention KV cache 是 prefill 的主要 HBM 消费者之一,全 DP 意味着每张 GPU 的 KV 副本完全一样——这在 batch 量大的时候是浪费。未来如果 attention 也引入某种 prefix-aware 的分片(比如 SP),会不会跟 AsyncEP 的设计冲突?论文没有讨论这个方向。
与 disaggregation 的关系。ZeRO-Prefill 不碰 prefill/decode 分离这条线,但它的存在本身就为 disaggregated serving 提供了一个新的角色:如果你的 prefill 节点跑的是 AsyncEP,decode 节点就完全不用碰 EP 这套机制。论文没讨论这种组合,但我估计它跟现有的 Mooncake、Splitwise 这类 P/D disaggregation 方案会是互补而非竞争。
从系统设计的角度看,这篇工作的长期价值可能不止于 prefill-only 这个场景。论文的核心主张——expert weights 应该被当作可调度的资源而非静态参数,由执行时序驱动而非由数据结构固定——这个原则能否泛化到 speculative decoding 的 draft model 调用、long-context reasoning 的中间验证 pass,甚至训练中的 activation checkpointing 窗口,目前还是开放的。如果这个原则被证明有更宽的适用面,那这篇论文真正留下的就不是 1.35× 这个数字,而是对 MoE 系统设计底层假设的一次修正。
参考资料
[1] ZeRO-Prefill: Zero Redundancy Overheads in MoE Prefill Serving
[2] PrefillOnly: An Inference Engine for Prefill-Only Workloads in Large Language Model Applications
[3] Efficient Memory Management for Large Language Model Serving with PagedAttention
[4] SGLang: Efficient Execution of Structured Language Model Programs
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。