KV cache offload 过去经常被讲成“显存不够,所以把缓存搬到远端内存”。Beluga 这篇论文真正有意思的地方,是把问题往下一层压:如果远端内存仍然要走 RDMA 的网络语义,那么系统会被 bounce buffer、scatter-gather、RPC、cache locality 调度一起拖住;如果 CXL switch 能给 GPU 和 CPU 一个共享的大内存池,KV cache offload 的主矛盾就从“怎么把数据发过去”变成“怎么把远端内存当作可控的本地扩展来用”[1]。
论文给出的数字很直接。Kimi 场景里,50M tokens 的 KV cache 约需要 20TB DRAM 才能获得最大缓存命中率;Beluga 的 CXL memory pool 设计目标是让最多 16 台服务器访问一个 8TB 池,聚合带宽达到 1TB/s;在 vLLM 的 cache-hit 场景下,Beluga-KVCache 相比 RDMA-based MoonCake 把平均 TTFT 从 13.00s 降到 1.36s,把 QPS 从 1.54 提到 11.32[1]。这些数字背后,真正关键的是 CXL 的 load/store 语义:它让一整套 RDMA 时代的系统补丁变得次要。
一、RDMA 的问题在 KV cache 上被放大了
RDMA memory pool 在分布式推理里很自然:每台机器贡献 DRAM,通过 RDMA 读写远端内存,把 GPU HBM 从长上下文 KV cache 压力里解放出来。MoonCake、Dynamo、LMCache 这类系统都沿着这条路径推进。问题在于,KV cache 天生就不是一块规整的大数组。
论文用 Qwen-32B 的 GQA 布局说明了这个麻烦:一个 token 的 KV cache 会被拆成 128 个不连续片段,来源是 64 layers 乘以 key/value 两类张量;如果进一步做 sparse KV cache,一个 token 可能变成 1024 个 160B 小块。RDMA 的 scatter-gather list 可以合并多段内存,但 ConnectX-7 这类 NIC 的 sglists 数量有限,论文里提到约 30 entries 的硬件约束。换到 KV cache 语境里,系统很快从“发一个大请求”退化成“管理大量小请求”。
这里的工程直觉很简单:RDMA 擅长把一段明确的内存搬到另一端,KV cache offload 却经常要求在很多层、很多 head、很多 token 之间做细粒度 gather/scatter。每多一个碎片,就多一点请求准备、同步和调度开销。论文的 H20 microbenchmark 给了一个很有代表性的数字:16KB transfer 总耗时 10.55us,其中真实数据移动只有 2.68us,剩下接近 8us,约 75%,来自 kernel launch 或 completion waiting 这类同步开销[1]。
这也是为什么“远端 KV cache 命中”有时并不自动等价于系统更快。cache hit 省掉了 prefill recomputation,但如果加载缓存本身绕了一圈 GPU -> Host -> MemPool 或 MemPool -> Host -> GPU,收益会被控制路径吃掉。Beluga 的判断是,KV cache offload 首先是一个 memory access semantics 问题,其次才是网络吞吐问题。
二、Beluga 的主张:把 memory pool 拉回 load/store 语义
Beluga 基于 XConn XC50256 CXL 2.0 switch 构建内存池。每台服务器通过两个 PCIe 5.0 x16 PCIe/CXL adapter 接入 CXL switch,memory box 提供 32 个 256GB DDR5 设备,形成 8TB CXL MemPool。论文还提到 XConn switch 单芯片有 256 条 PCIe 5.0 lanes 和 2TB/s forwarding capacity,而系统级配置面向多 host 并发访问。
这套结构的关键不在容量本身。单纯扩容可以用更多主机 DRAM 或 RDMA pool 做到。Beluga 想证明的是:CXL.mem 暴露的是 memory-semantic interface,CPU 可以 load/store 或用 DSA,GPU 可以通过 P2P memcpy 和自定义 CUDA kernel 访问 CXL memory。换句话说,数据路径可以少经过一层 host bounce buffer,控制路径也可以更自然地进入 CUDA stream。
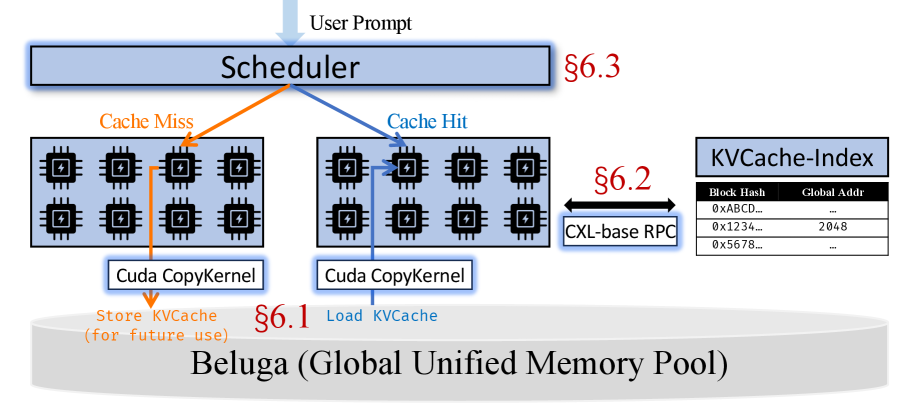
图 1:Beluga-KVCache 把共享 memory pool、global index 和 scheduler 放在同一套 CXL 访问语义下处理。图中的重点是 LLM instance、metadata server 与 memory pool 之间的主路径从 RDMA 式远端访问,转向更接近共享内存的访问方式。来源:arXiv HTML Figure 9。
在 KV cache 管理上,Beluga-KVCache 对应三件事。第一,把 KV cache 数据放进 CXL memory pool,用自定义 copy kernel 处理 gather write 和 scatter read。第二,用 CXL-based RPC 替换推理实例和 metadata service 之间的部分 RDMA/TCP RPC,把 request/reply slot 放到共享 CXL memory 里,通过状态位做 producer-consumer 通信。第三,调度器不再强依赖 KV cache locality,因为论文声称 CXL pool 的访问延迟接近 local buffer access,cache-aware routing 的必要性下降。
这里需要保持一点怀疑。CXL 2.0 多 host 环境没有天然跨 host CPU cache coherence,Beluga 仍然要用软件方法维护一致性,包括 ntstore、CLFLUSH、uncacheable memory、禁用 DDIO 等。它确实简化了 RDMA 的网络编程,但没有把一致性问题变没。Beluga 更像是把复杂性从 RDMA verbs、QP ordering 和 completion polling,迁移到 CXL 内存属性、cache flush 策略和设备拓扑优化上。
三、最关键的细节:KV cache 的碎片布局决定了 CXL 的优势
论文里最有说服力的一张图是 KV cache layout,而不是端到端性能表。它把 Qwen-32B 的一个 16-token KV cache block 画成了 128 个不连续的 20KB transfers。对 vLLM 这类系统来说,16-token block 是 HBM 管理的自然粒度;对 RDMA 来说,这个粒度又太小,需要把多个 block batching 成更大的 super block 才能摊薄控制开销。
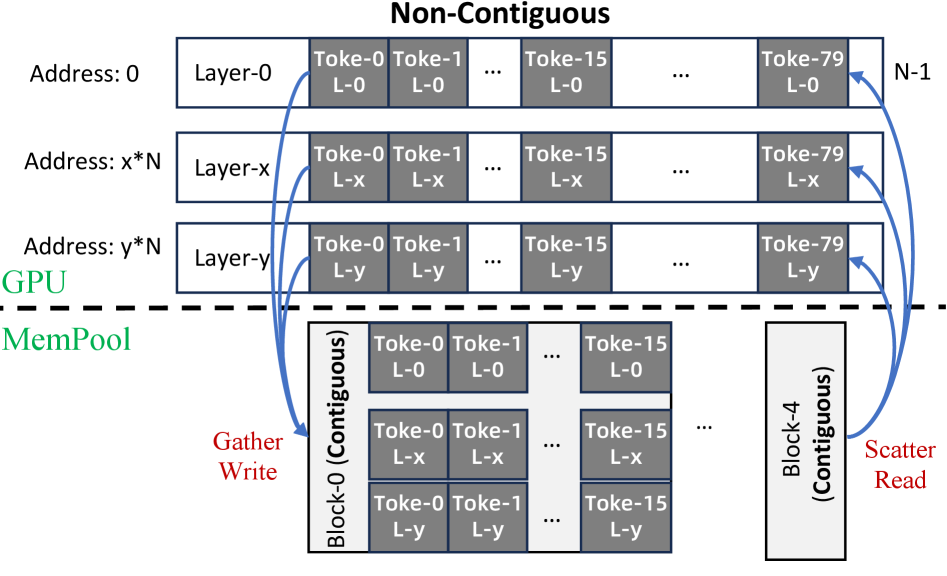
图 2:一个 16-token KV cache block 在 Qwen-32B GQA 中会展开成 128 个非连续 20KB 数据片段。Beluga 的论点建立在这个事实之上:KV cache transfer 的瓶颈集中在大量细粒度 gather/scatter,而不是单次大块拷贝。来源:arXiv HTML Figure 10。
这个细节解释了为什么 Beluga 对 vLLM native block size 更友好。论文报告,MoonCake 在 256-token block size 下 cache-hit TTFT 是 13.0s,但如果改成 vLLM 原生的 16-token block,TTFT 会升到 76.8s,甚至超过第一轮重算延迟。Beluga 可以在 16-token 粒度工作,因为它把细粒度传输放进 CXL memory pool 和 CUDA kernel 的组合里处理,不需要用大 block 去摊 RDMA 控制开销。
这对推理系统工程很有启发。很多 offload 系统的配置项看起来是上层策略,比如 block size、cache hit routing、prefix locality;但背后常常是底层互连的成本模型在逼迫上层妥协。RDMA 要 batching,block size 就容易变大;block size 变大,cache 命中和空间利用又会受影响。CXL 如果能稳定支持更小粒度访问,系统可以把 HBM 管理粒度和远端缓存管理粒度重新对齐。
四、端到端收益主要来自 cache-hit 场景
Beluga-KVCache 的端到端实验用的是未量化 Qwen-32B,主 workload 是 LV-Eval,输入都超过 15K tokens,并额外构造了 2K、4K、8K 变体。论文分了两个场景:first run 用来填充 KV cache,second run 则假设缓存已经预填充,考察 cache-hit 下的加载收益。
first run 下,Beluga 相比 MoonCake 把平均 TTFT 从 19.66s 降到 17.22s,QPS 从 1.02 提到 1.24。有收益,但差距还不够决定性。cache-hit 下差距突然拉开:MoonCake 平均 TTFT 13.00s,Beluga 1.36s;MoonCake QPS 1.54,Beluga 11.32;论文概括为平均 TTFT 降低 89.6%,QPS 提升 7.35x[1]。
这个实验的含义是:Beluga 最适合那些缓存复用足够高、上下文足够长、prefill 重算足够贵的负载。比如 RAG、长文档问答、多轮 agent、固定系统 prompt、大量共享前缀请求。对于短 prompt、低复用、cache miss 多的服务,Beluga 的收益会被 first-run 填充成本、CXL memory consistency 处理和硬件部署复杂度稀释。
论文也给了一个边界数字:实验配置里模型占 60.0GB,分配 92% 总显存后,剩下 28.3GB 给 GPU HBM 上的 KV cache,GPU 内 cache hit ratio 峰值只有 14.6%。这解释了为什么远端 KV pool 对长上下文 workload 会变得实际。HBM 太宝贵,本地缓存只能保住很小一部分热数据,剩下的系统要么重算,要么 offload。
五、CXL-RPC 是控制路径上的第二个支点
Beluga 不只优化 KV cache 数据搬运,也把 metadata RPC 放到了 CXL memory 上。实现方式很朴素:client 和 metadata server 预分配固定大小 request/reply slot;client 写 request 并设置 REQ_READY;server 轮询状态位,处理后写 reply,再设置 RESP_READY。配合 ntstore、CLFLUSH、mfence batching 和 cache-line alignment,RPC 留在用户态共享内存路径上。
论文的 ping-pong benchmark 每个 request 和 reply 都是 64B。QD=1 时,CXL-RPC round-trip latency 是 2.11us;RDMA-RC 是 8.39us,RDMA-UD 是 8.83us。QD=128 时,CXL-RPC 单线程吞吐达到 12.13 Mops,RDMA-RC 为 4.5 Mops,RDMA-UD 为 6.65 Mops[1]。
这个结果对 KV cache 系统很重要,因为 metadata lookup 处在 cache-hit critical path 上。前缀缓存、block location、global index、scheduler 都会频繁访问元数据;如果数据路径变快但 metadata RPC 还卡在网络协议和 completion polling 上,端到端 TTFT 仍然会被控制路径钉住。
但 CXL-RPC 也有清晰边界。论文自己承认,当前 CXL-RPC 的可靠性保证低于 RDMA transport protocol,需要上层机制补足。换成生产视角,这意味着它适合 rack-scale、故障域受控、追求极低延迟的内部路径;如果系统跨 rack、跨故障域,或者需要更强的连接语义,CXL-RPC 还不能简单替代 RDMA。
六、真正要记住的判断
Beluga 最值得记住的贡献,是把 KV cache offload 的讨论从“远端内存容量”推进到了“远端内存语义”。RDMA memory pool 已经证明大规模 KV cache 复用有价值,但 RDMA 的网络语义迫使系统在数据路径、控制路径和调度路径上做大量补偿。Beluga 说明,如果 CXL switch 能提供足够低延迟、足够高带宽、可被 GPU 有效访问的共享 memory pool,KV cache 系统可以更接近本地内存扩展的设计方式。
这篇论文的结论成立有几个前提。第一,负载必须有足够高的缓存复用,否则 cache-hit 优势体现不出来。第二,系统部署要落在 CXL switch 能覆盖的 rack-scale 场景里,跨 rack 仍然离不开网络。第三,CXL 2.0 多 host coherence 的软件处理不能被忽略,ntstore、uncacheable memory、CLFLUSH、DDIO 配置这些细节会直接决定正确性和尾延迟。
从 AI Infra 角度看,Beluga 比“替换 RDMA”的简单故事更有价值。它更像是下一代推理内存层的一个方向标:当上下文长度、agent 轮数和 prefix reuse 继续增长,KV cache 会从框架内部的优化结构,变成 rack-scale memory fabric 上的一等数据对象。CXL 的价值就在这里,它让这个对象第一次有机会脱离网络请求模型,回到内存访问模型。
参考资料
[1] Beluga: A CXL-Based Memory Architecture for Scalable and Efficient LLM KVCache Management
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。