Attention sink 过去常被当成一种“有用但奇怪”的现象:初始 token 拿走大量注意力,看起来语义上没什么道理,却又支撑了 StreamingLLM 这类长上下文推理技巧[2]。这篇 ICML 2026 论文真正推进了一步:它没有停在“sink 有什么功能”,而是问了一个更底层的问题,为什么 causal decoder 总是把第一个 token 变成结构锚点[1]。
我的判断是,这篇论文最值得记住的贡献,是把 attention sink 从一个经验现象改写成了一条可验证、可复制、可抑制的因果链。链条的起点很朴素:causal mask 下,第一个 token 只 attend 自己,后面的 token 会对越来越多 value 做加权平均,于是第一个 token 成了高方差离群点。麻烦在后面几层被逐级放大:输出投影保留方差差异,FFN 里的 super neuron 被选择性激活,稀疏的 down projection 把表示压进少数维度,下一层 QK 点积被迫对齐这个异常方向。
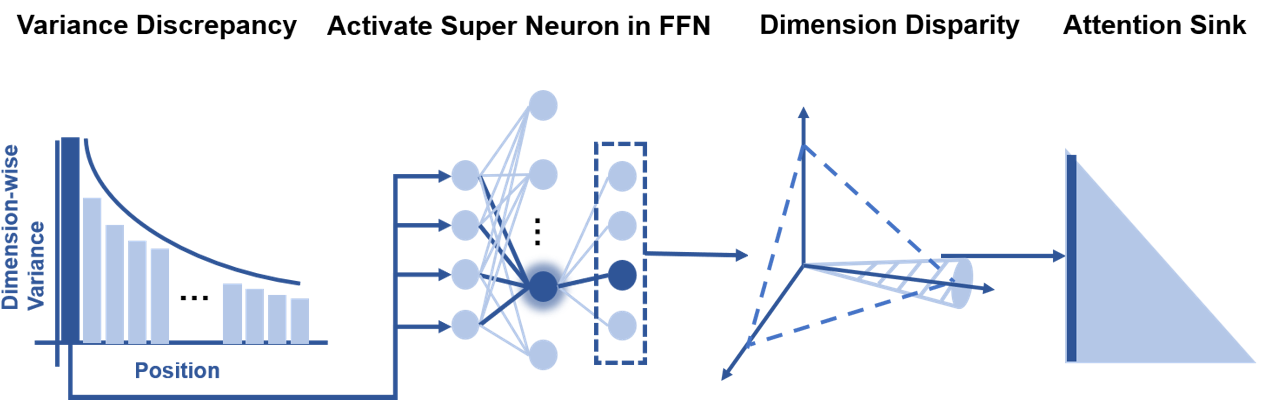
图 1:论文给出的机制链路:value aggregation 先制造位置间的方差差异,W_O 和 FFN super neuron 继续放大,最终形成 attention sink。来源:论文 Figure 1。
一、把 sink 归因给 Softmax 还不够
StreamingLLM 的解释很有工程直觉:Softmax 要把注意力概率归一到 1,如果当前 token 没有真正需要关注的历史内容,就需要一个位置承接“剩余注意力”[2]。这个说法解释了 sink 为什么有功能,也解释了为什么保留 sink token 能让窗口化推理更稳定。可它没有解释一个关键事实:为什么这个位置稳定地落在序列开头。
这篇论文的切入点更接近机制解释。作者先在 Llama-2-7B 上观察 sink 的层内出现时刻:第一 token 的平均 attention 在浅层保持较低,到第 2 层附近突然抬升;同一位置的表示范数也在同一层出现尖峰[1]。这组同步关系把问题从“注意力分数为什么偏向开头”推进到“进入这一层之前,第一个 token 的表示发生了什么”。
答案落在 value aggregation 上。对第 0 个 token 来说,causal mask 让它只能聚合自己;对第 i 个 token 来说,它聚合的是 0 到 i 的 value。只要这些 value 并非完全同向,聚合就会带来方差衰减。BOS 语义和 RoPE 都解释不了这种稳定差异,causal self-attention 的结构不对称才是更直接的来源。
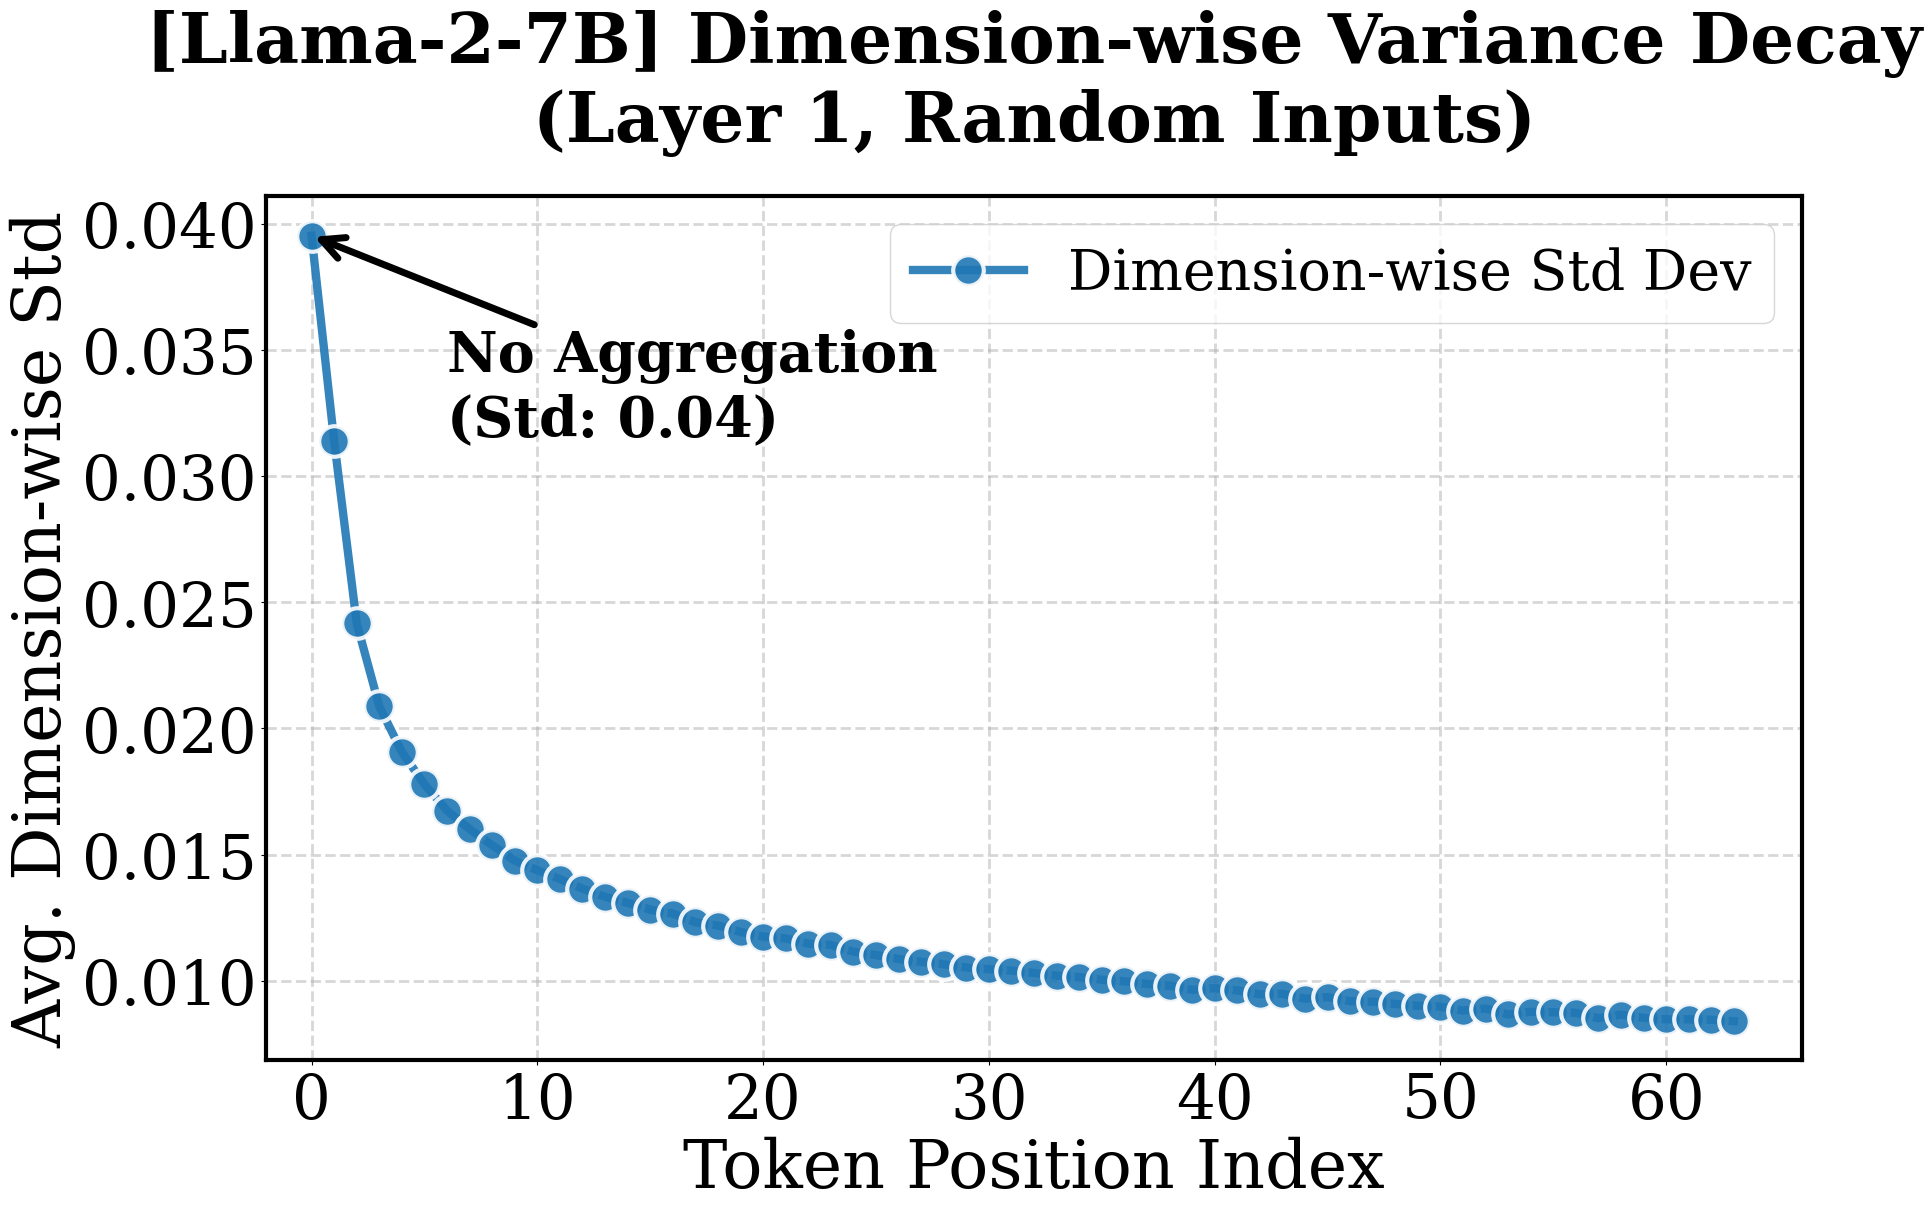
图 2:作者用随机 token 排除固定 BOS 偏置后,仍然看到 Layer 1 value aggregation 后第 0 个位置的维度方差显著高于后续位置。来源:论文 Figure 4。
这点对做推理系统的人尤其有价值。Attention sink 过去经常被当成 KV cache 策略里的“事实条件”:保留前几个 token,窗口滑动时别把它们丢掉。论文给出的视角更进一步,sink token 不是只能被经验保留的黑盒现象,它背后对应着模型内部统计量失衡。未来如果要做更激进的 KV cache pruning、sink token relocation 或 context compression,真正要问的是:某个位置有没有承担这种结构锚点,而不是它是不是恰好在序列开头。
二、因果证据比相关曲线更关键
论文最强的一组证据来自两个干预实验,而不是层间曲线。第一个实验修改 attention mask:把第 10 个 token 设成只能 attend 自己,模拟第一个 token 的“未聚合”状态;后续 token 的 attention 机制保持不变。结果很直接,第 10 个 token 立刻变成新的 sink[1]。
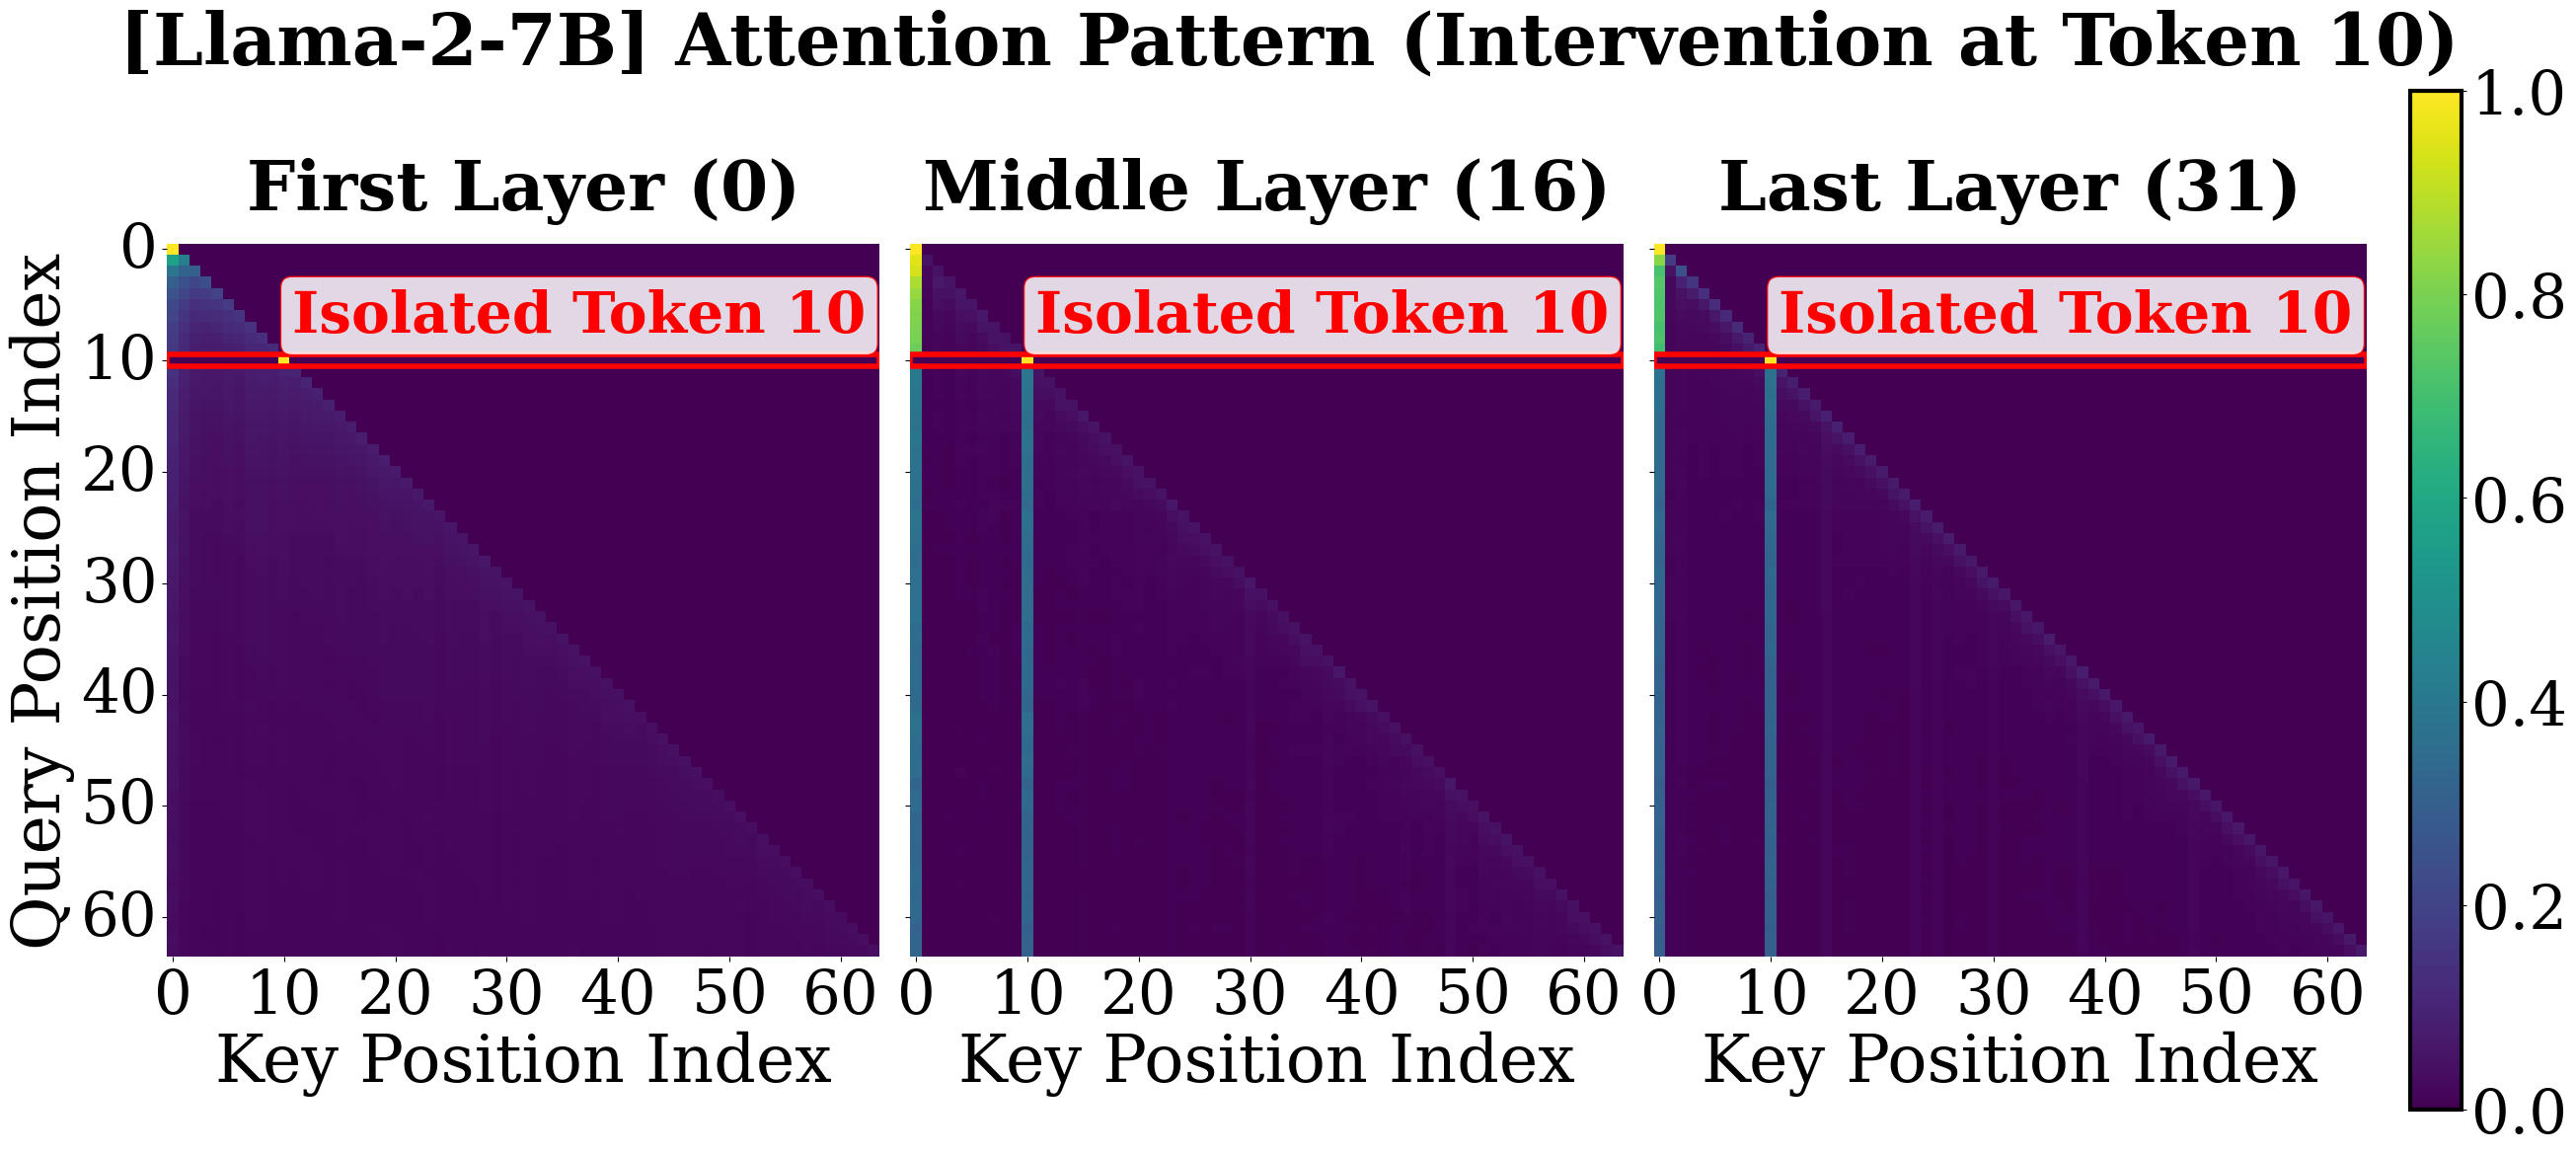
图 3:当第 10 个 token 被阻止聚合前文,它会获得类似第 0 个 token 的高方差状态,并在后续层成为新的 attention sink。来源:论文 Figure 5。
第二个实验更细。作者不改 mask,而是对任意位置的 aggregated output 做 mean-centered variance amplification:围绕全局均值放大该 token 的方差。随着放大系数增加,这个 token 收到的 attention 分数也上升。控制实验里,单纯把向量范数按同样系数放大,并不能复制 sink。这一点很重要,因为它排除了一个偷懒解释:sink 只是因为某个向量变大了。论文真正指向的是方差结构,而不是粗糙的 norm 尺度。
如果只看这两组实验,结论已经足够清晰:attention sink 可以被移动。绝对位置 0 没有天然特权;“没有经历聚合导致高方差”的位置会被后续结构选中。这个结论也解释了为什么重复 token 相关研究会观察到类似 massive activation:如果重复内容让聚合无法有效缩小方差,它就在统计上模拟了初始 token 的一部分状态[5]。
三、Super neuron 才是放大器
仅有 value aggregation 的方差差异,还不足以自然推出一个强 sink。差异需要穿过 transformer block,并在某个环节被放大到足以支配后续 QK。论文把这个放大器定位到 FFN,特别是 SwiGLU 结构里的 super neuron。
先看 attention output projection。作者计算 W_O 每个输出 neuron 的权重绝对值与第一个 token 输入方差之间的 Kendall rank correlation,分布明显右移,平均相关系数达到 0.32[1]。这说明 W_O 并没有消掉第一个 token 的高方差维度,反而在结构上倾向于把这些维度传进 residual stream。
接下来进入 FFN。论文追踪到一个具体的 super neuron,例如 Llama-2-7B 中 index 7890:第一个 token 的 normalized input 与这个 neuron 的 W_gate 列向量有高正余弦相似度,同时在 W_up 上产生巨大 raw activation。后续 token 没有这种对齐,因此不会同样触发。再往下看 W_down,对应行是重尾分布,大多数维度接近 0,少数维度权重很大。结果是,super neuron 的巨大激活被集中打进少数 outlier dimension。
这一步解释了 attention sink 和 massive activation 为什么经常缠在一起。IntactKV、量化 outlier 处理、sink-aware KV cache 策略看到的可能是同一个结构链条的不同截面[3]。从模型内部看,它是方差失衡和 FFN 放大;从推理系统看,它表现为少数 token 和少数 channel 不能随便丢、不能随便量化、不能按平均行为估算。
四、Dimension disparity 如何锁住 QK
FFN 放大之后,第一个 token 的表示被少数维度主导。论文用 dominance ratio,也就是最大绝对值与平均绝对值的比值,描述这种 dimension disparity;在 Llama-2 的浅层,这个比值会快速升高[1]。更极端的是,经过后续 RMSNorm 后,向量方向会近似收敛到某个 basis direction。RMSNorm 本来只管尺度,不会修正方向塌缩;当一个维度远大于其他维度时,归一化反而把这个方向固定得更干净。
到这里,attention sink 的最后一步就不神秘了。后续 token 的 query 经过 W_Q 投影后,如果在某些 head 上天然与这个 sink key 的主方向对齐,QK 点积会稳定偏大。论文用 head-wise SVD alignment 和 positive ratio 验证了这点:结构对齐高的 head,点积为正的比例接近 100%[1]。sink 更像模型参数和表示几何共同形成的固定通道,单次输入偶然触发解释不了这种稳定性。
这也是我觉得这篇论文比单纯“attention sink 可视化”更有意义的地方。它把一个输出层面的 pattern 拆回了三类工程上可观察的对象:value aggregation 后的方差、FFN 中的 super neuron、hidden state 的有效秩和维度支配度。对模型诊断来说,这比盯着 attention heatmap 更可操作。
五、Head-wise RMSNorm 是机制证明
作者最后提出 Head-wise RMSNorm:在 value aggregation 之后、W_O 之前,对每个 head 的 aggregated vector 做 RMSNorm,并使用共享的 learnable scaling vector。它试图同时解决两个失衡:位置上的方差差异,以及 head 之间由于 attention entropy 不同造成的输出尺度差异[1]。
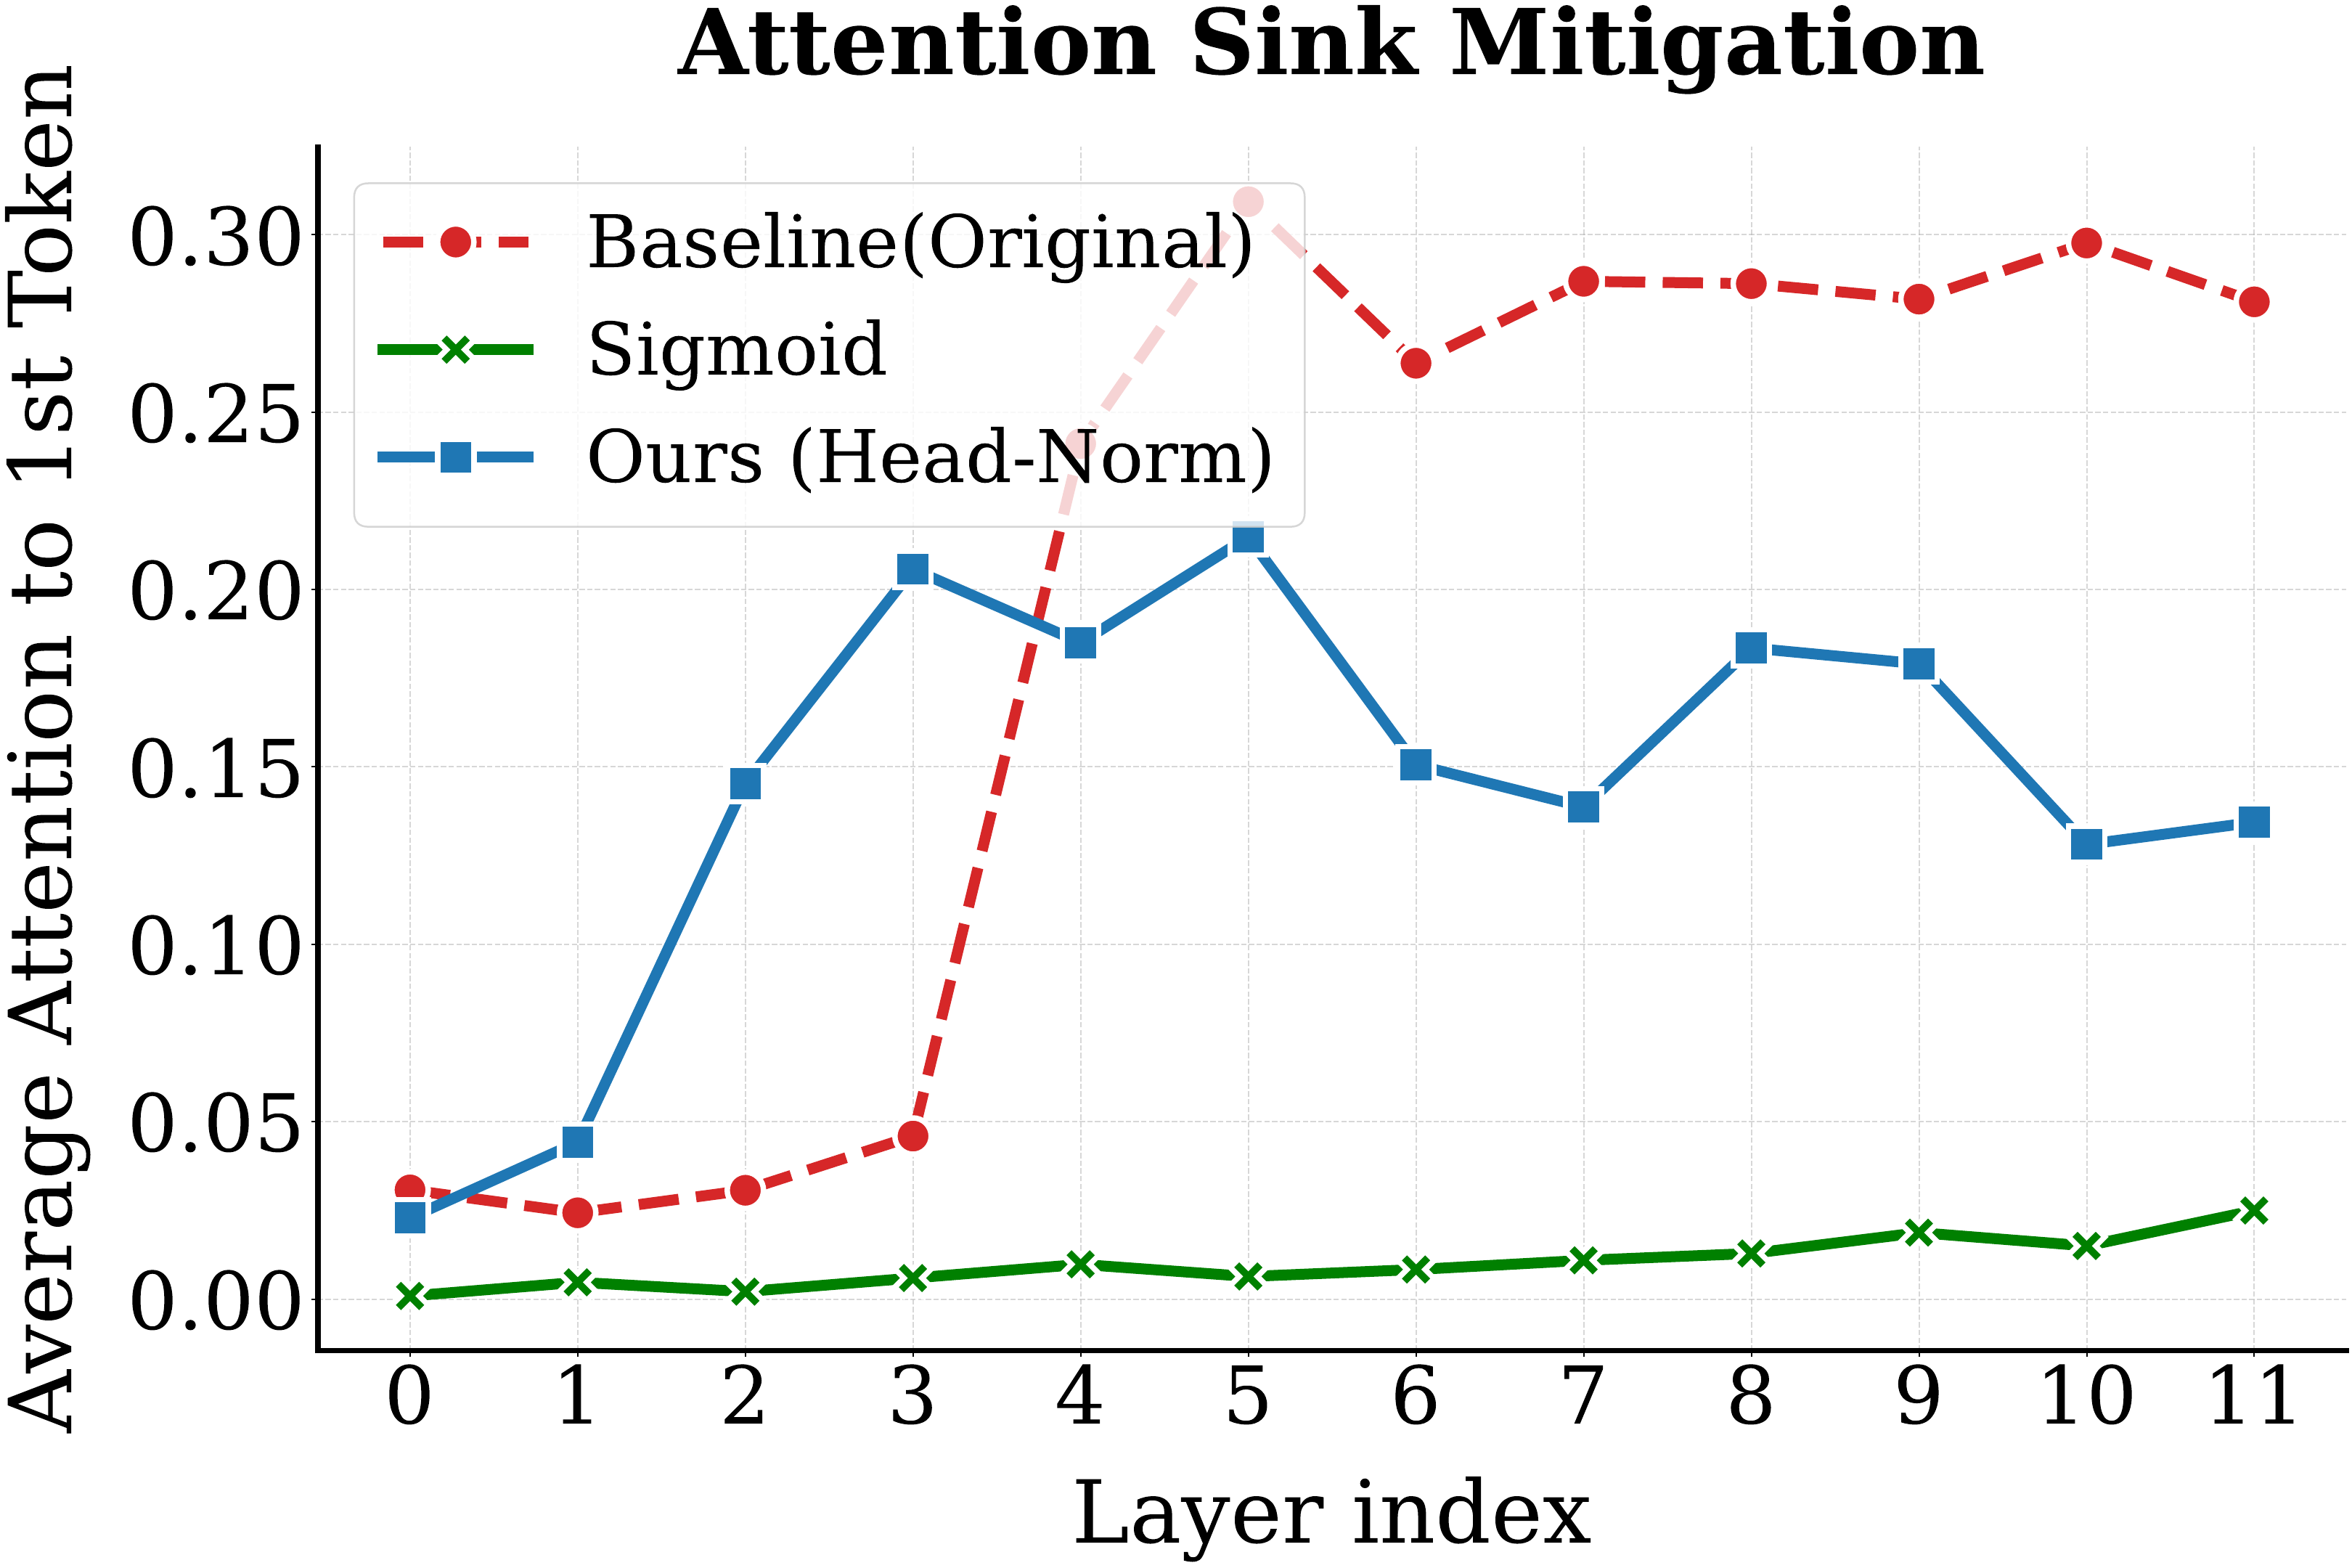
图 4:标准 Softmax baseline 从第 5 层开始出现明显 sink;Sigmoid attention 和 Head-wise RMSNorm 都能降低第一个 token 的平均 attention。来源:论文 Figure 2。
实验设定并不大:152M 参数模型,在 OpenWebText 上从头预训练 40,000 iterations,大约 20B tokens。四个随机种子的结果里,HeadNorm 的 train loss 从 baseline 的 2.7483 降到 2.7073,validation loss 从 2.7812 降到 2.7421;layer-wise mean effective rank 从 343.71 提到 445.96,dimension disparity 从 82.67 降到 33.74[1]。这些数字说明,抑制 sink 并没有破坏训练,反而改善了表示几何和收敛。
但这里必须把边界讲清楚。Head-wise RMSNorm 更像是对机制解释的 proof of concept,离主流 7B、70B 训练 recipe 里的成熟组件还有距离。论文自己也承认,干预效果主要在 152M 规模预训练上验证;Llama-2-7B、Llama-3-8B 被用来验证机制存在,尚未证明 HeadNorm 在十亿参数以上仍能稳定提升[1]。此外,它会改变 attention output 进入 residual stream 的尺度分布,和现有初始化、学习率、MoE routing、KV cache 量化策略都会有耦合。
Sigmoid attention 的对照也很有意思。去掉 Softmax sum-to-one 约束后,sink 确实缓解;但 unnormalized attention 的表示尺度会随序列长度变化,论文实验中收敛反而更慢。这和《Theory, Analysis, and Best Practices for Sigmoid Self-Attention》里对 Sigmoid self-attention 的训练条件讨论是同一类问题[4]:去掉归一化约束可以改变统计结构,但新的稳定性问题会从别处冒出来。
六、结论
这篇论文对 AI Infra 的启发不在于“以后都该用 Head-wise RMSNorm”。更有价值的判断是,attention sink 这类长期被推理系统利用的现象,背后可能有相当明确的结构成因。系统侧把 sink token 当作 KV cache 的特殊对象,模型侧则能追到 value aggregation、super neuron 和 dimension disparity。两边如果只各说各话,很容易把同一个现象拆成互不相干的优化技巧。
我会把这篇论文放在“解释推理系统经验规则的模型内部机制”这一类工作里。它还没有给出大规模训练 recipe,也没有直接回答 sink-aware KV cache 策略应该怎么改;但它给了一个更好的问题框架:当我们保留、移动、压缩或量化某些 token 时,token 语义位置只是表层线索,更关键的是它在模型几何里承担的结构锚点角色。这个问题一旦被问清楚,attention sink 就从 heatmap 上的一条亮线,变成可以被测量和干预的模型结构属性。
参考资料
[2] Efficient Streaming Language Models with Attention Sinks
[3] IntactKV: Improving Large Language Model Quantization by Keeping Pivot Tokens Intact
[4] Theory, Analysis, and Best Practices for Sigmoid Self-Attention
[5] Interpreting the Repeated Token Phenomenon in Large Language Models
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。