版本声明:本文分析基于 arXiv 论文《Not All Prefills Are Equal: PPD Disaggregation for Multi-turn LLM Serving》v2(2026-05-05)[1];除非特别说明,以下描述均基于该版本。
LLM 推理系统过去两年形成了一条很清晰的工程共识:prefill 和 decode 应该拆开。前者负责一次性处理输入 prompt,算力密集;后者负责逐 token 生成,显存带宽敏感。这个判断支撑了 Splitwise、Mooncake、vLLM / SGLang 分离式 serving 等一系列系统设计[2][3]。但这篇 PPD 论文提醒我们,真实聊天和 agent 场景里还有一个被低估的事实:到了第二轮以后,用户新增的 token 通常很少,长得多的是前几轮对话历史,而其中一大块 KV cache 已经躺在 decode 节点上。
这会把经典 PD 架构推到一个尴尬位置。传统设计里 KV transfer 基本是单向的,prefill 节点生产 KV,decode 节点消费 KV;decode 节点上刚刚生成的上一轮回答,下一轮却不能被 prefill 节点直接复用。于是 Turn 2+ 请求又要把完整上下文送回 prefill 节点重算,再把 KV 传回 decode 节点。论文的核心判断很尖锐:多轮服务里,prefill 已经不再是一种同质工作负载;full prefill 和 append-prefill 对 decode 的干扰差一个数量级,系统应该把它们分开调度[1]。
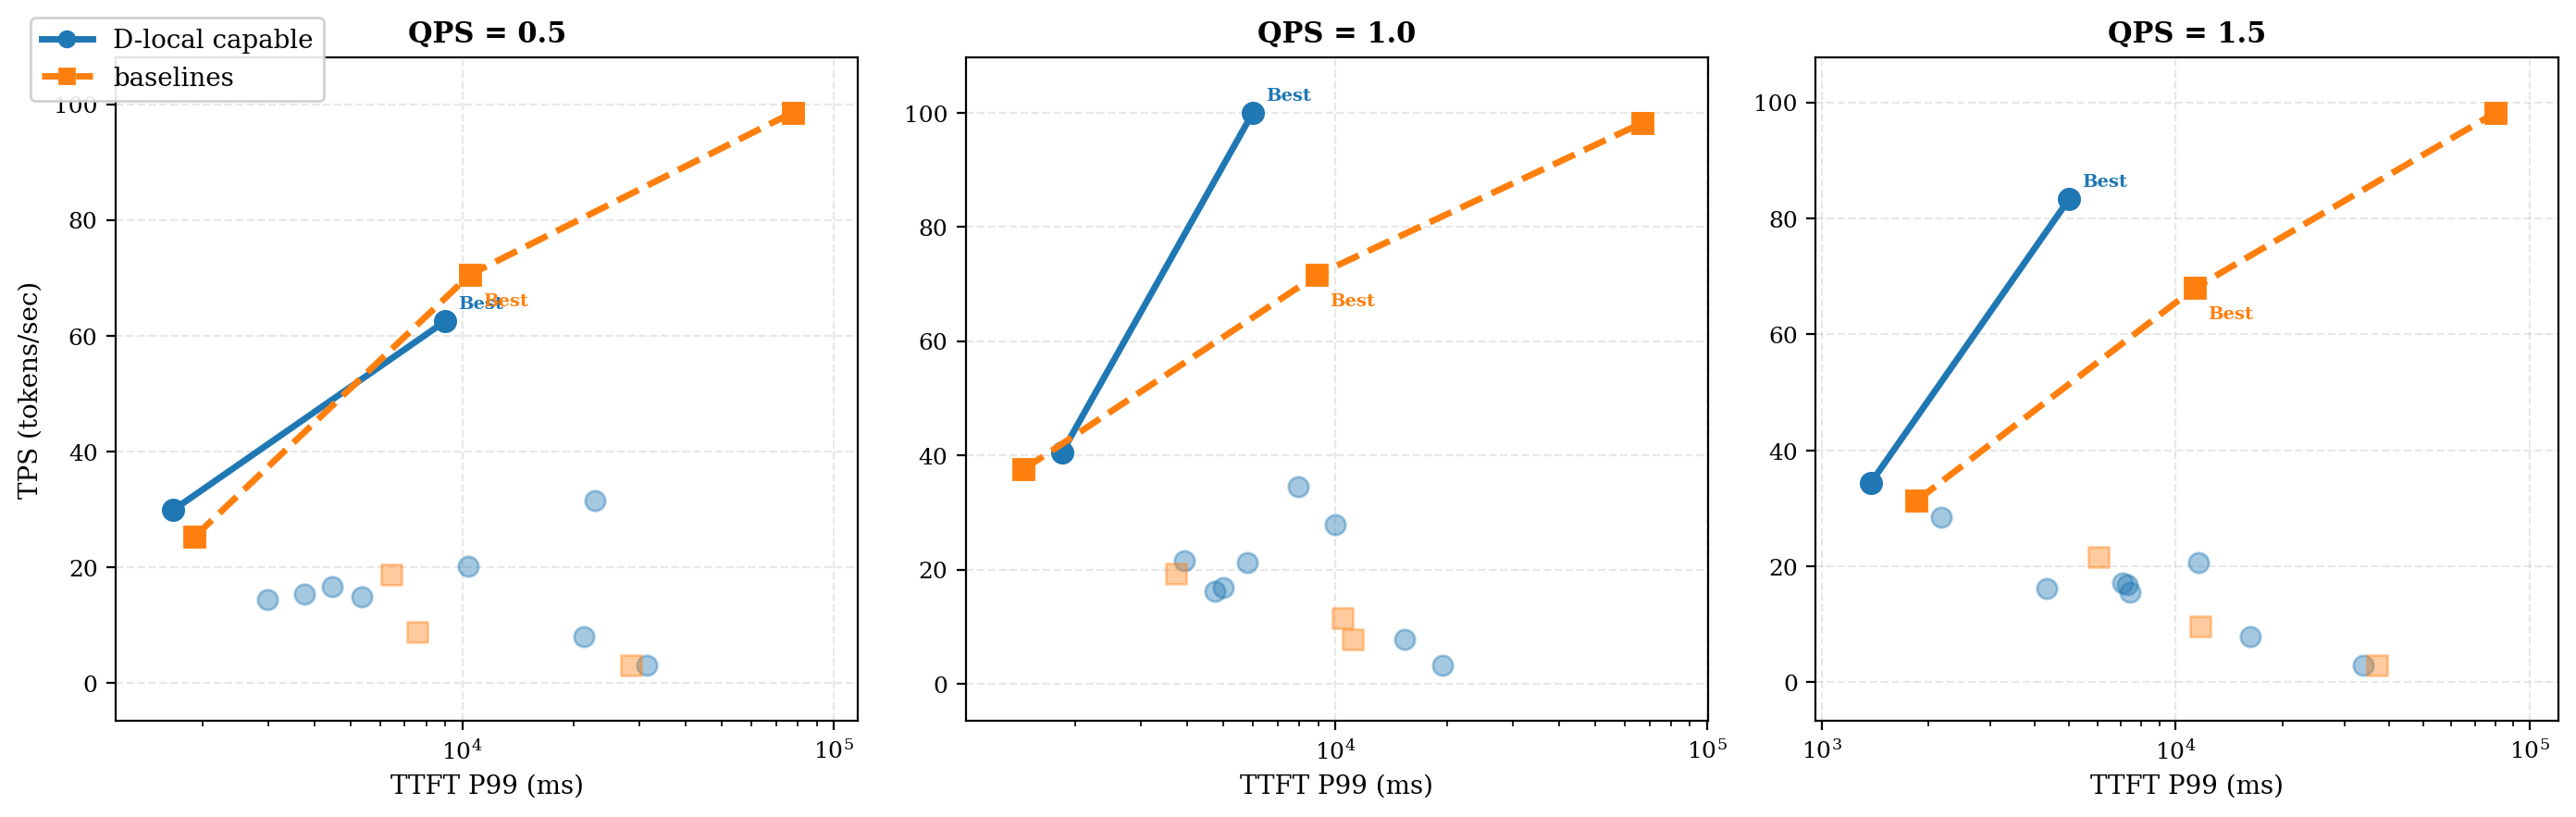
图 1:在长上下文、多轮负载下,允许 decode 节点本地处理 Turn 2+ append-prefill 的配置,形成了更靠近左上角的 TTFT / TPS Pareto 边界。图中的 “Best” 点来自 PPD 动态路由策略。来源:论文 Figure 1。
一、传统 PD 的盲点,是把第二轮请求当成第一轮处理
先用一个更朴素的比喻理解这件事。第一轮请求像是把一整本书交给模型读,prefill 节点读完后把笔记,也就是 KV cache,交给 decode 节点写回答。到了第二轮,用户可能只追问一句“那具体怎么部署?”此时 decode 节点手里其实已经有上一轮回答的 KV 状态。可传统 PD 的数据路径不允许它把这份状态反向交给 prefill 节点,系统只好重新把整段对话送去 prefill,再走一次 P→D 的 KV transfer。
这正是论文所说的 one-way KV transfer protocol。它在单轮请求下是合理的,因为 decode 端没有可复用历史;放到多轮对话里,就会制造两种浪费。第一,prefill 节点重算了大量历史 token,尤其是上一轮模型自己生成的回答。第二,每一轮都要传输完整 KV,网络带宽被反复占用。论文引用 CachedAttention 的观测说,在真实聊天负载中,这类重算最多可占多轮 prefill 成本的 99%[4]。
从 AI Infra 架构师视角看,这里真正暴露的是控制平面和数据平面的错位。控制平面把 Turn 2+ 请求当作一个普通新请求来路由;数据平面却知道,它并不普通,因为它有缓存、有会话亲和性、有上一轮 decode 结果留下的状态。如果调度器看不见这些差异,越是高频多轮对话,PD 分离越容易在 prefill 队列和 KV transfer 上放大成本。
二、Append-prefill 为什么能放到 decode 节点上
PPD 论文最有价值的实验,不是直接展示系统吞吐提升,而是先问了一个更底层的问题:如果把 Turn 2+ 的新增 token 放到 decode 节点本地处理,会不会严重拖慢正在生成的 token?
答案来自它对 full prefill 和 append-prefill 的拆分。Full prefill 是第一轮常见的情况:没有可用上下文缓存,需要对整段输入做 prefill。Append-prefill 则只处理新追加的 m 个 token,同时复用已有 n 个 token 的 KV;当 m 远小于 n 时,它的计算量大致变成 O(m(n+m)),比对 n+m 个 token 重新做 full prefill 轻很多[1]。
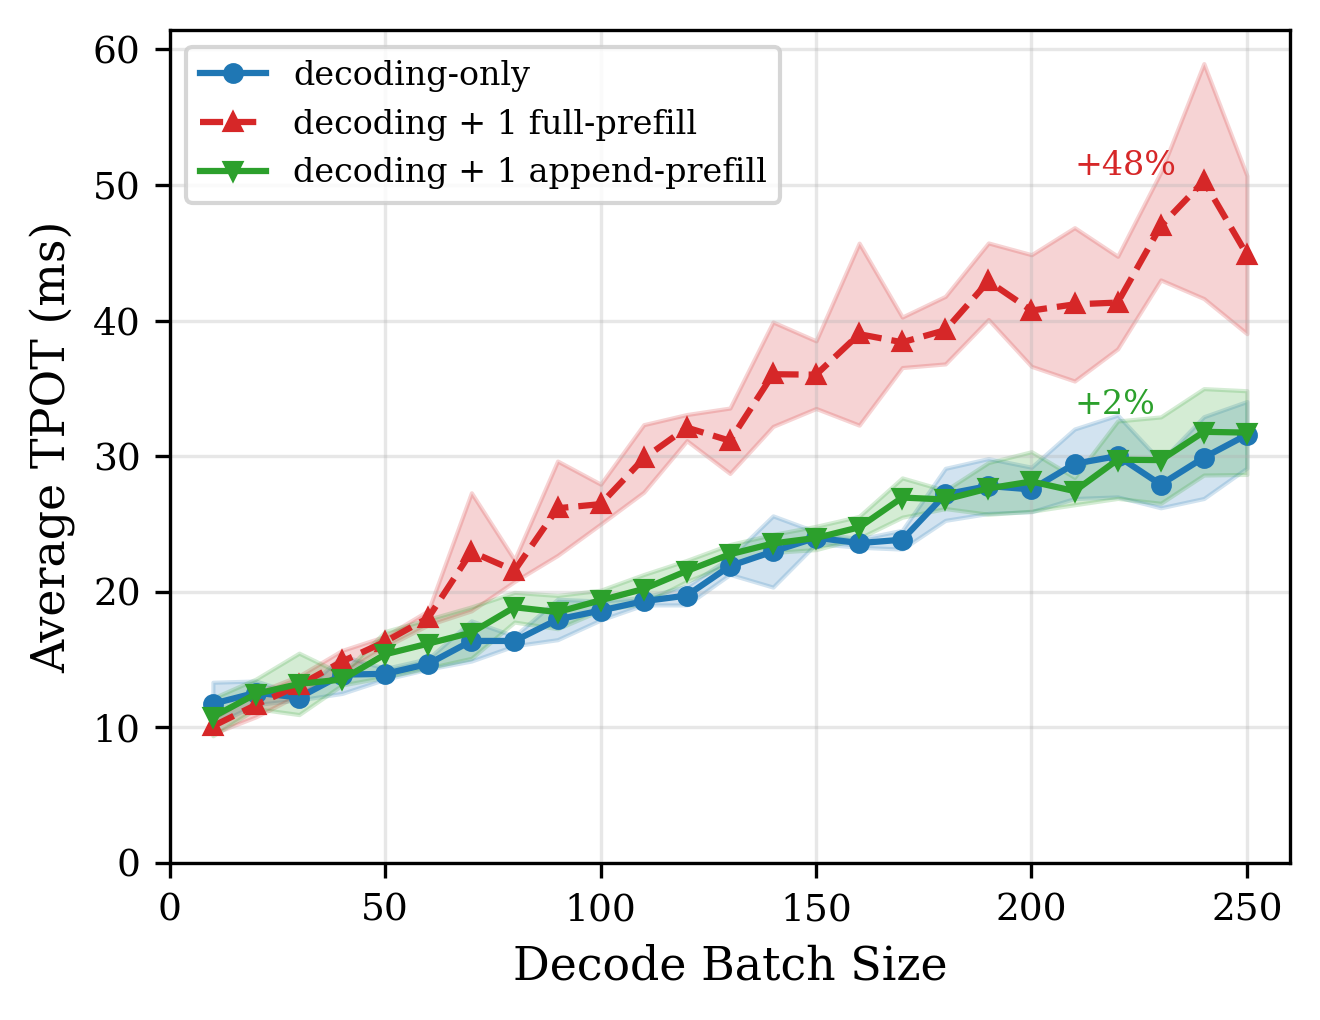
图 2:在同样处理 1024 token 的实验里,full prefill 会让 decode TPOT 明显恶化,而 append-prefill 基本贴近 baseline。论文报告在 batch size 200 下,full prefill 约带来 48% TPOT slowdown,append-prefill 只有约 2%。来源:论文 Figure 2。
这张图是全文的支点。传统 PD 的出发点是隔离 prefill 和 decode,因为 prefill 会干扰 decode;PPD 的补充判断是,append-prefill 的干扰强度小得多。论文在单张 H100、Llama-3.1-8B 上做 micro-benchmark,发现 batch size 200 时 full prefill 让 decode TPOT 变慢约 48%,append-prefill 只有约 2%;即便 4 个 prefill 并发,full prefill slowdown 约 57%,append-prefill 仍在 21% 左右[1]。
这给系统设计打开了一个新空间。decode 节点不适合承担重型 full prefill,但可以在很多 Turn 2+ 场景里承担轻型 append-prefill。换句话说,“prefill 节点”和“prefill 操作”不再一一绑定。一个 decode 节点只要已经握有会话 KV,就有机会在本地吃掉新增 prompt,省掉一次 P→D 往返和一次历史重算。
三、PPD 的关键,是按请求选择二轮路径
如果只看上一节,很容易得出一个过度简单的方案:Turn 2+ 全部在 decode 节点本地做 append-prefill。这确实是论文里的一个强 baseline,记作 x=1,也就是 Full AP-to-D。它对 TTFT 很友好,因为二轮请求绕过 prefill 节点和 KV transfer。实验显示,从传统 PD 的 x=0 切到 x=1,Turn 2 TTFT 可降低 48% 到 73%,在 prefill 节点稀缺、QPS 较高时收益最大[1]。
但生产 serving 很少只优化 TTFT。用户还会在意 TPOT,也就是后续 token 是否稳定输出;平台还在意吞吐和成功率。decode 节点如果承担太多 append-prefill,生成过程仍可能受到轻微干扰。论文扫了 3060 个配置点,结论是 92.2% 的 workload / QPS 组合里,Turn 2 TTFT 和平均 TPOT 的最优配置并不相同[1]。这句话对工程团队很重要:静态策略很难覆盖所有 SLO。
PPD 的名字是 Prefill Prefill-capable Decode。这个名字有点绕,意思却直接:保留传统 prefill 节点,同时让 decode 节点具备处理 append-prefill 的能力;每个 Turn 2+ 请求来了以后,路由器根据 workload、当前节点配置和用户设定的 SLO 权重,决定走传统 P→D 路径,还是在 decode 端本地处理。
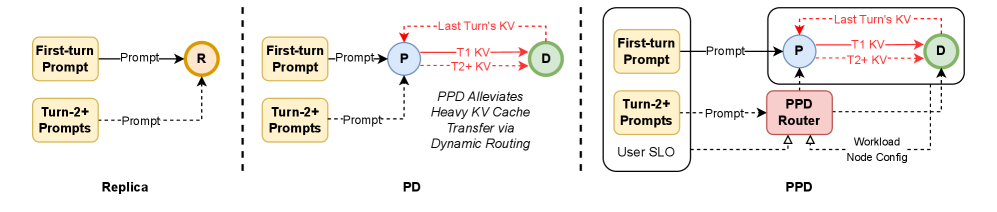
图 3:Replica、传统 PD 与 PPD 的核心差异。PPD 只在 Turn 1 强制走 prefill 节点;Turn 2+ 会根据 workload、节点配置和 SLO 权重,在 prefill 节点与 decode 本地路径之间动态选择。来源:论文 Figure 3。
论文把这个选择写成一个简单的打分函数:本地处理带来的 TTFT 改善乘以 TTFT 权重,再减去 TPOT 恶化乘以 TPOT 权重。分数大于 0,就把 append-prefill 放到 decode 端;否则走 prefill 节点。实现上,它没有在在线路径里跑复杂优化,而是离线构建查表:先在不同 workload 网格上测 x=0 和 x=1 的 TTFT / TPOT,再把结果压成一个 lookup table。在线时根据上下文长度、输入输出比例、系统 QPS 找最近网格,单请求决策开销低于 1ms[1]。
这个设计很克制。它没有试图用一个万能调度器实时求解全局最优,而是把问题拆成两个旋钮:P:D 资源比例主要服务 Turn 1 的 prefill capacity;PPD 权重负责 Turn 2+ 的 TTFT / TPOT 取舍。对线上平台来说,这比“改一次集群比例就同时影响所有指标”的传统调参方式更容易落地。
四、从实验结果看,PPD 解决的是稳定性问题
论文在 ShareGPT 和 WildChat 两个真实多轮数据集上做验证,覆盖 1P_3D、2P_2D、3P_1D 三种 P:D 配置,QPS 从 1 到 20。动态 PPD 使用平衡权重 wttft = wtpot = 1.0,指标包括 Turn 2+ TTFT、平均 query latency、throughput 和 success rate。这里最有信息量的结果,不只是延迟下降,而是传统 PD 在部分配置和负载下开始服务退化,而 PPD 的曲线保持完整。
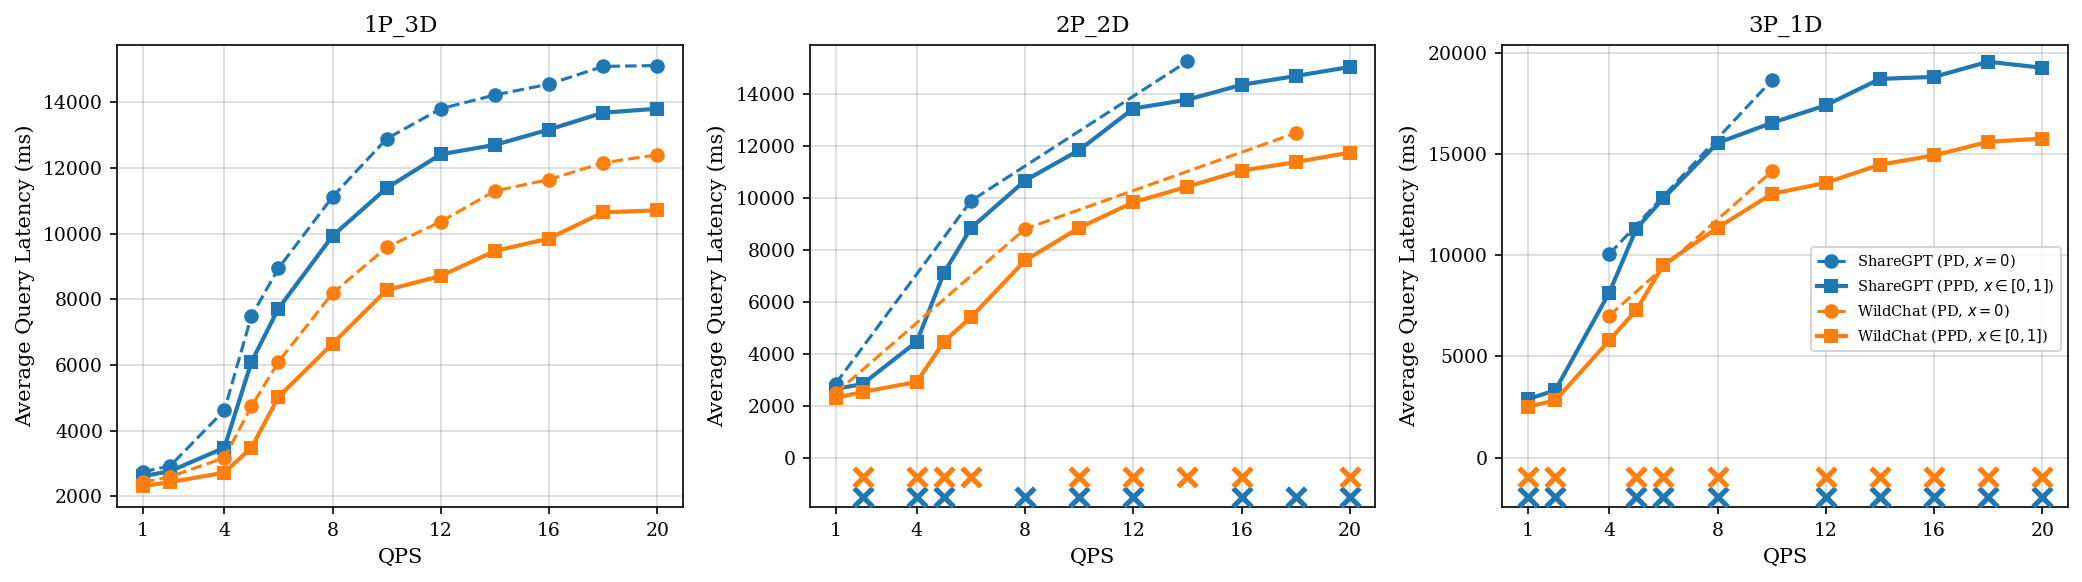
图 4:ShareGPT 与 WildChat 上,PPD 的平均 query latency 曲线整体低于传统 PD;叉号代表 success rate 低于 95% 的服务退化点。PPD 在所有测试 QPS 上保持 100% success rate。来源:论文 Figure 4。
论文给出的解释很清楚:传统 PD 每一轮都把 KV 从 P 传到 D,平均 3.1 轮对话会制造约 3 倍网络负载差异;PPD 把 Turn 2+ 中适合本地处理的请求留在 decode 端,可把 KV transfer load 削掉约 75%[1]。在这些测试里,传统 x=0 baseline 的退化主要来自请求排队和 timeout,而不是显存耗尽或硬件故障。也就是说,瓶颈是服务路径被压垮了,不是模型本身跑不动。
和最强静态 baseline x=1 相比,PPD 的意义更细。x=1 把所有 Turn 2+ 都留在 decode 端,端到端平均 latency 有时看起来接近 PPD;但分指标拆开以后,PPD 同时拿到了更多 TPOT 最优点和更多 TTFT 最优点。论文在 WildChat 的 27 个测试点上报告:PPD 的 TPOT best 是 12/27,高于 x=0 的 10/27;TTFT best 是 14/27,高于 x=1 的 13/27;success rate 则和 x=1 一样达到 27/27[1]。
这说明 PPD 追求的不是某个单点指标的极致,而是把系统带到一个更可控的 Pareto 面上。对工程团队而言,这往往比“某个配置在 benchmark 上赢一次”更重要。真实线上流量会变化,用户 SLO 会分层,节点配比也会受库存影响。一个能把 TTFT / TPOT 取舍显式暴露出来的路由器,比一个固定 x 的经验规则更容易接入上层 admission control、batch scheduler 和容量规划系统。
五、这篇论文对 AI Infra 架构的三点启示
第一,KV cache 的位置会成为多轮 serving 的一级调度信号。过去许多系统把 KV cache 看成某个请求的副产物,重点在传输和复用;PPD 把它进一步提升为路由依据。decode 节点是否持有某个会话的 warm KV,会直接影响下一轮请求应该去哪里。未来的 serving plane 很可能需要把 session affinity、prefix hit、KV residency 和网络拥塞一起纳入调度,而不只是看队列长度。
第二,PD 分离会从“相位隔离”走向“操作分型”。经典 PD 把 prefill 和 decode 当成两类相位,分别交给两类资源。PPD 的贡献在于继续细分 prefill:full prefill 仍适合 P 节点,append-prefill 在很多条件下适合 D 节点。这个思路可以扩展到更多操作,例如 speculative prefill、prefix extension、tool-call 后的短上下文补写、agent 轨迹中的局部重算。基础设施最终调度的可能不是“请求”,而是一串带状态依赖的小型推理操作。
第三,离线 profiling 加在线轻量决策仍然很有生命力。论文没有承诺完全闭环的在线优化,它承认 lookup table 在硬件或流量分布漂移时会次优,并在讨论里把 AMPD 这类实时队列状态方法视为互补方向[5]。这符合生产系统常识:高频在线路径需要简单、可解释、开销稳定;复杂探索可以放在离线 profiling、灰度校准和上层 SLO controller 里。
六、边界与开放问题
这篇论文的证据链很扎实,但还需要看清边界。首先,PPD 的原型基于 vLLM disaggregated serving 基础设施,核心结果来自 H100 单节点 NVLink 环境,以及对更慢网络的带宽注入模拟。论文也做了 NVLink、InfiniBand NDR / HDR、100GbE 的 sweep,显示网络越慢,PPD 相对传统 PD 的 Turn 2+ TTFT 优势越大;但真正跨机、跨机架、跨可用区部署时,还会遇到更复杂的 tail latency、拥塞控制和故障恢复问题[1]。
其次,PPD 依赖会话状态在 decode 端可复用。这对 chatbot 和 agent loop 很自然,对无会话 API、强随机路由、多租户严格隔离的场景则需要更多工程配套。比如会话迁移时怎么搬 KV,decode 节点故障后如何恢复 warm state,prefix cache 和 PPD 的本地 AP 策略如何共同管理显存,这些都不是一篇论文能完全回答的问题。
再次,PPD 的权重旋钮本质上是策略接口,还不是完整 SLO 系统。论文明确说它不直接强制 end-to-end SLO bound;要做到这一点,还需要闭环 admission control、batch scheduling 和 P99 指标反馈。换句话说,PPD 给了底层路由器一个可预测的执行面,上层控制器仍要决定什么时候偏 TTFT,什么时候偏 TPOT,什么时候牺牲部分吞吐换稳定性。
七、结论
PPD 这篇论文最值得被记住的地方,是它把多轮对话里的一个“系统常识”形式化了:第二轮以后的请求天然带着历史状态,继续沿用单轮请求的数据路径,会让 PD 分离在重算和 KV transfer 上付出额外成本。full prefill 和 append-prefill 的干扰差异,给了 decode 节点承担局部 prefill 的工程理由;动态路由则把这个理由转化成可调的系统接口。
站在 AI Infra 架构师角度,我会把 PPD 看作 KV-centric serving 的又一个信号:未来的推理系统不会只按模型副本、GPU 类型、batch size 来调度,还会按 KV cache 的生命周期和所在位置来调度。站在科普写作者角度,它也说明了一个简单道理:聊天系统的第二句话,和第一句话在计算上不是同一种请求。用户只是多问了一句,系统背后却要决定,是重新读完整本书,还是接着手里已有的笔记往下写。
如果 agentic workload 继续增长,多轮、多工具、多次短追问会成为常态。到那时,PPD 的具体 lookup table 未必是最终形态,但它提出的问题会长期存在:当模型服务已经记住了一部分上下文,我们还应该让下一轮请求从哪里开始算?
参考资料
[1] Not All Prefills Are Equal: PPD Disaggregation for Multi-turn LLM Serving
[2] Splitwise: Efficient Generative LLM Inference Using Phase Splitting
[3] Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving
[4] Cost-Efficient Large Language Model Serving for Multi-Turn Conversations with CachedAttention
[5] Efficient Multi-round LLM Inference over Disaggregated Serving
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。