HACK 这篇论文给 AI Infra 的一个关键信号是:KV cache 压缩的主战场正在从“少传多少字节”走向“压缩后的状态能否继续停留在执行路径上”。在分离式 LLM 推理里,prefill 和 decode 被放到不同 GPU 实例上,KV cache 从模型内部的临时状态变成了跨节点传输、远端缓存和 decode 访存共同争抢的系统资源。只做压缩当然能减少网络流量,但如果每个 decode step 都要把压缩 KV 还原成 FP16,省下来的带宽会很快被反量化和额外访存吃掉[1]。
HACK 的野心更大:它希望压缩后的 KV 直接参与 attention 里的两次矩阵乘法,用同态量化把“低比特存储”和“低比特计算”接起来。这个方向并不等价于又一个 KVQuant 变体,而是把 KV cache 当成 serving runtime 的一等执行对象来设计。对长上下文、跨节点 prefill/decode 分离、低带宽 GPU 池混部这几类场景来说,这个问题会越来越贴近生产瓶颈。
一、分离式推理把 KV cache 变成了跨节点瓶颈
分离式推理的基本思路很直接:prefill 偏计算密集,decode 偏显存和访存密集,所以可以把两类阶段放到不同实例上,便宜的 A10G、V100、T4、L4 做 prefill,显存更大的 A100/H100 做 decode。DistServe、SplitWise、Mooncake 这类系统都沿着这条路线推进,把 phase splitting、KV 传输和 KV 共享纳入 serving 架构[7][8][9]。
问题出在 KV 数据必须从 prefill 端送到 decode 端。论文的测量显示,在分离式推理中,KV 传输最多可以占到 Job Completion Time(JCT)的 42.2%;prefill 与 decode 自身也分别可能达到 45.6% 和 83.3%;decode 端峰值显存占用最高到 93.7%,加载 KV 的显存访问时间也能占到 33.1%[1]。这组数字说明,长 prompt 和长输出把 KV cache 同时推到了网络、内存容量和访存延迟的交叉点。
自然的第一反应是压缩 KV。CacheGen 和 KVQuant 已经证明,KV 数据可以被压到很低的比特宽度,同时保持接近基线的精度[3][4]。但论文在分离式推理基线上重放这类方法后发现,反量化本身会成为新的大头:CacheGen 和 KVQuant 的 KV dequantization 可以占到 JCT 的 17.2% 到 37.9%,并且长序列越明显。更麻烦的是,这些方法最终仍然把 attention 计算拉回 FP16,所以它们减少了传输和访存,却没有真正减少 attention 矩阵乘法的计算账。
二、HACK 的关键动作:让量化后的 KV 继续参与 attention
HACK 的系统路径可以概括成一句话:prefill 端生成 Q/K/V 后立即量化,其中 K/V 使用 2-bit 表示来压缩传输和缓存,Q 与 softmax 后的 P 使用 INT8 表示来保住计算精度;随后 attention 中的 QK^T 和 PV 两次矩阵乘法都在量化值上执行,再用少量校正项把结果近似回原始数值空间[1]。
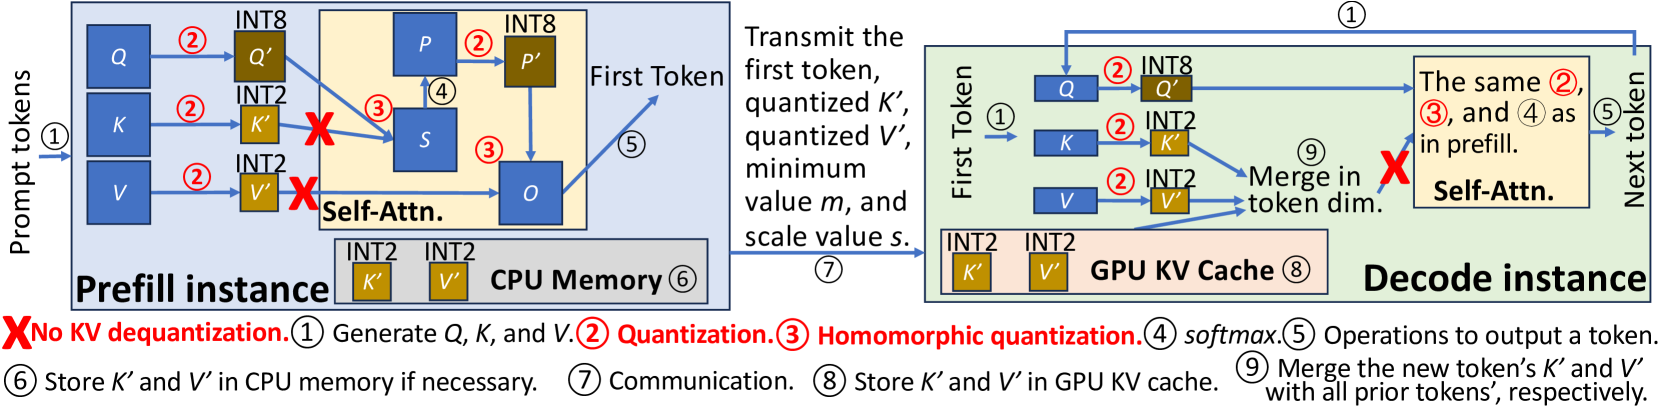
图 1:HACK 在 prefill 与 decode 两侧都把 K/V 存成 INT2,并在 self-attention 中直接对量化后的 Q/K/V 做同态量化矩阵乘法,从执行路径上移除 KV 反量化。来源:arXiv HTML figure[2]。
同态量化的数学直觉并不复杂。对一个矩阵元素 x,非对称量化可以写成 x 约等于 s q + m,其中 q 是低比特整数,s 是 scale,m 是 minimum。把 A 和 B 都替换成这种形式后,AB 的每个元素可以展开成四类项:量化矩阵 qA qB 的乘积、两边 minimum/scale 带来的线性校正项,以及 minimum 相乘的常数项。真正昂贵的大矩阵乘法落在低比特整数上,校正部分只承担近似恢复的工作[1]。
这就是 HACK 和普通“先压缩、用时解压”的差异。K/V 从 prefill 端传到 decode 端后,decode 不再把所有历史 token 的 KV 还原成 FP16;它把新 token 的 Q/K/V 也量化,然后把新 K’/V’ 和历史 K’/V’ 拼接,在量化域里完成 attention。通信量下降来自 INT2 KV,访存下降来自更小的 cache footprint,计算时间下降来自低比特矩阵乘法,反量化开销则被校正项取代。
当然,HACK 当前实现还受工具链约束。论文基于 vLLM 和 FlashAttention-2 改造 attention backend,用 Triton 实现 attn_prefill 和 attn_decode 两个 fused kernel[5][6]。由于 Triton 当时支持的最低计算精度是 INT8,HACK 需要先把 2-bit 数据在 GPU local memory 中转换成 INT8 再做矩阵乘法;作者也把直接 CUDA 化、支持 INT4 计算列为后续工作。这说明 HACK 的思想已经压到算子层,但工程形态仍有继续收敛的空间。
三、分区粒度决定误差,也决定系统账单
HACK 使用非对称 2-bit 随机量化,并把矩阵按 partition 切分。partition 越小,每段里的 min/max 更贴近局部分布,量化误差会下降;代价是 metadata、校正项和 kernel 组织开销上升。论文默认选择 partition size Π=64,这是一个在精度和 JCT 之间折中的点[1]。
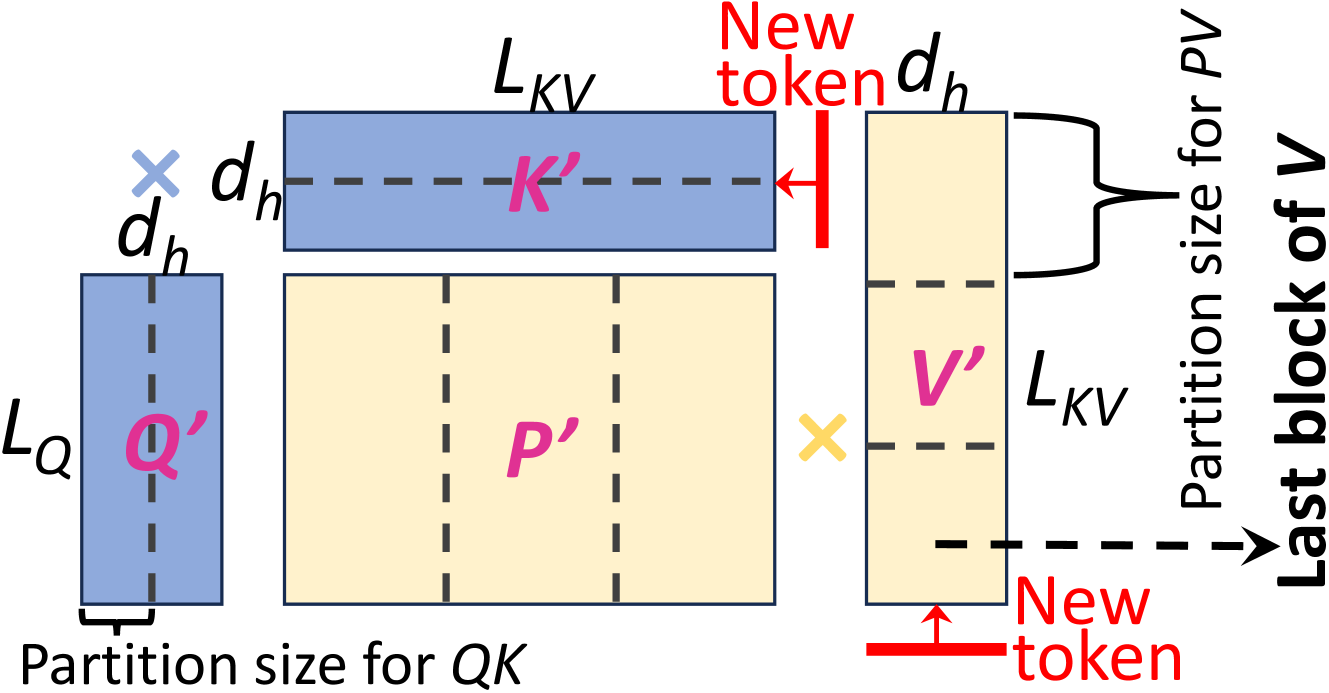
图 2:QK 的分区沿 head dimension 展开,PV 的分区沿 sequence dimension 展开;这让 V 的最后一个未满 partition 成为 decode 阶段需要单独处理的工程问题。来源:arXiv HTML figure[2]。
这个分区方式解释了 HACK 里两个容易被忽略的细节。第一,QK^T 的内维是 head dimension,通常较短且固定;PV 的内维是 sequence length,会随着 decode 不断增长。第二,V 的 partition 沿 sequence dimension 排布,所以每来一个新 token,最后一个 V block 都可能被新值打破原来的 min/max 范围。如果直接更新范围,就必须把这个 block 里旧 token 的 V 重新量化,既增加误差,也增加开销。
论文给出的方案是把最后一个未满的 V block 暂时以 FP16 存在单独 buffer 中,等它填满一个 partition 后再量化并写入量化 KV cache。这个做法把不稳定的尾部挡在量化 cache 外面,让大部分历史 V 继续保持低比特可计算状态。它只增加 0.24% 到 0.51% 的 GPU memory capacity,但避免了每个 decode step 对尾部反复 requantize[1]。
partition size 的权衡也很清晰。相对于 Π=128,Π=32 最多能带来 1.53% 的精度提升,但平均 JCT 最多上升 28%;Π=64 的精度提升较小,JCT 增幅约 5.1% 到 9.2%。作者最终把 Π=64 设为默认值,因为它在所有模型和数据集上比 CacheGen、KVQuant 平均高 0.16% 到 0.78% 的精度,同时仍然保留明显的端到端时间收益[1]。
四、真正省时间的地方,藏在两个小优化里
HACK 的同态矩阵乘法需要一些校正项,其中一类项包含对量化矩阵元素的求和。如果每个 decode iteration 都重新求历史 K/V 的 sum,长序列下这部分会变得很贵。论文的 summation elimination 做法是:在 KV cache 中额外存储每个 partition 的量化值 sum,后续 decode 直接复用。实验里这部分额外状态只占 2.2% 到 2.7% 的 GPU memory capacity[1]。
另一个优化就是前面提到的 V 最后一个 block 处理,论文称为 requantization elimination。它的意义不只在性能,也在精度。由于 decode 输出越长,尾部 V 被反复重新量化的次数越多,误差会持续累积;保留最后一个未满 block 的 FP16 形式,可以把这类累积误差挡住。
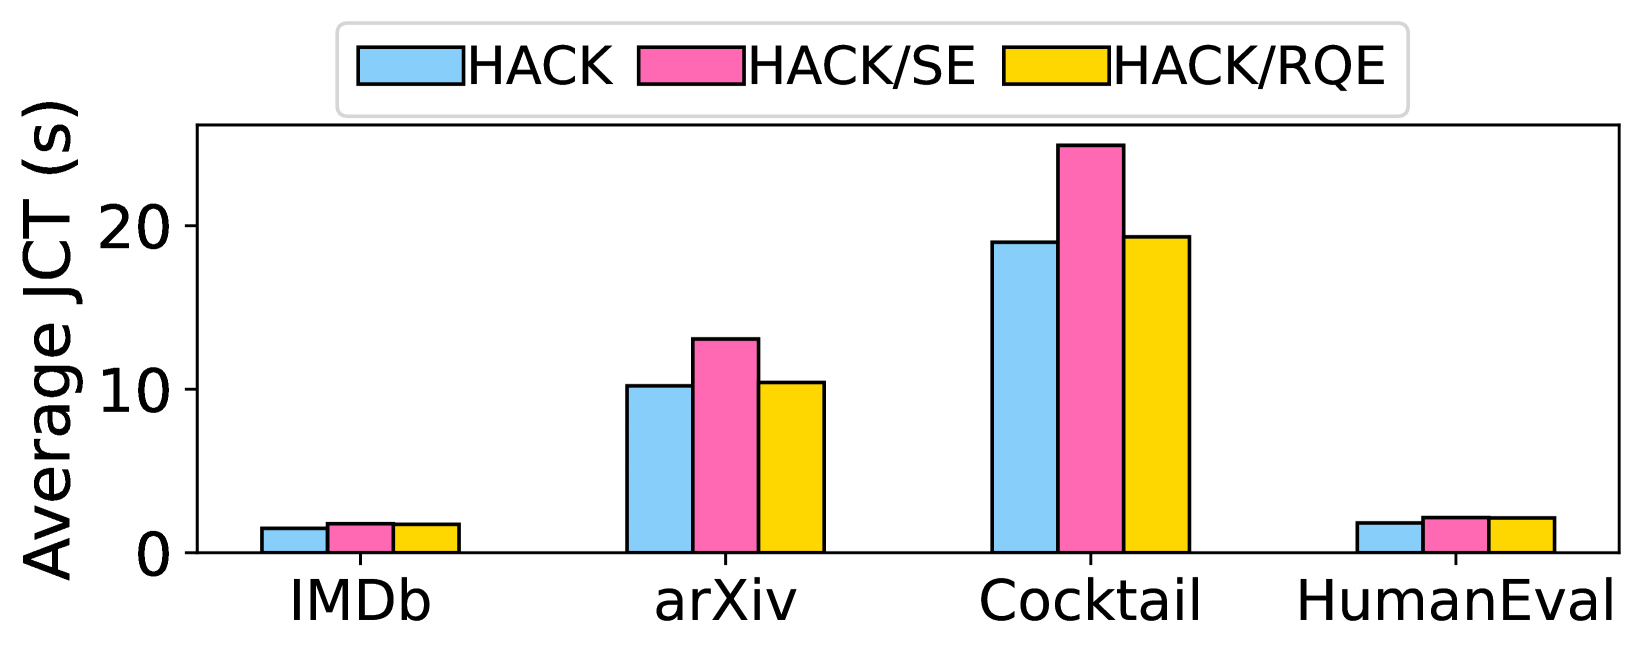
图 3:去掉 summation elimination 后,长序列 arXiv 与 Cocktail 的 JCT 增幅更明显;去掉 V 尾块的 requantization elimination,则短序列更吃亏,因为尾块在总序列中占比更高。来源:arXiv HTML figure[2]。
消融实验很能说明问题。没有 summation elimination 时,短序列数据集的平均 JCT 比完整 HACK 高 13.8% 到 15.3%,长序列 arXiv 和 Cocktail 则高 22.1% 到 25.9%。没有 requantization elimination 时,短序列 JCT 高 17.8% 到 21.7%;到了长序列,增幅下降到 0.09% 到 1.2%,因为最后一个 V block 在整体序列中的占比被稀释了。这个结果也提醒我们,HACK 的收益不只来自“2-bit KV”,还来自一组围绕 decode 循环精细安排的状态复用策略。
五、实验收益来自通信、计算和反量化三笔账一起下降
论文的实验基于 AWS GPU 实例,decode 默认使用 A100,prefill 则覆盖 A10G、V100、T4、L4 和 A100;系统基线是集成到 vLLM 上的分离式推理实现,并修改 DistServe、SplitWise 代码以支持 Ethernet 数据传输。模型覆盖 Mistral-v0.3 7B、Phi-3 14B、Yi 34B、Llama-3.1 70B 和 Falcon 180B,数据集覆盖 IMDb、arXiv summarization、Cocktail IR 和 HumanEval[1]。
在 Llama-3.1 70B、A10G prefill 的不同数据集上,HACK 相比 baseline 将平均 JCT 降低 38.6% 到 61.6%;相比 CacheGen 降低 19.2% 到 41.5%;相比 KVQuant 降低 21.2% 到 45.1%。长序列数据集 arXiv 和 Cocktail 的收益更高,因为它们把 KV 传输、decode 访存和历史 KV 反量化都放大了[1]。
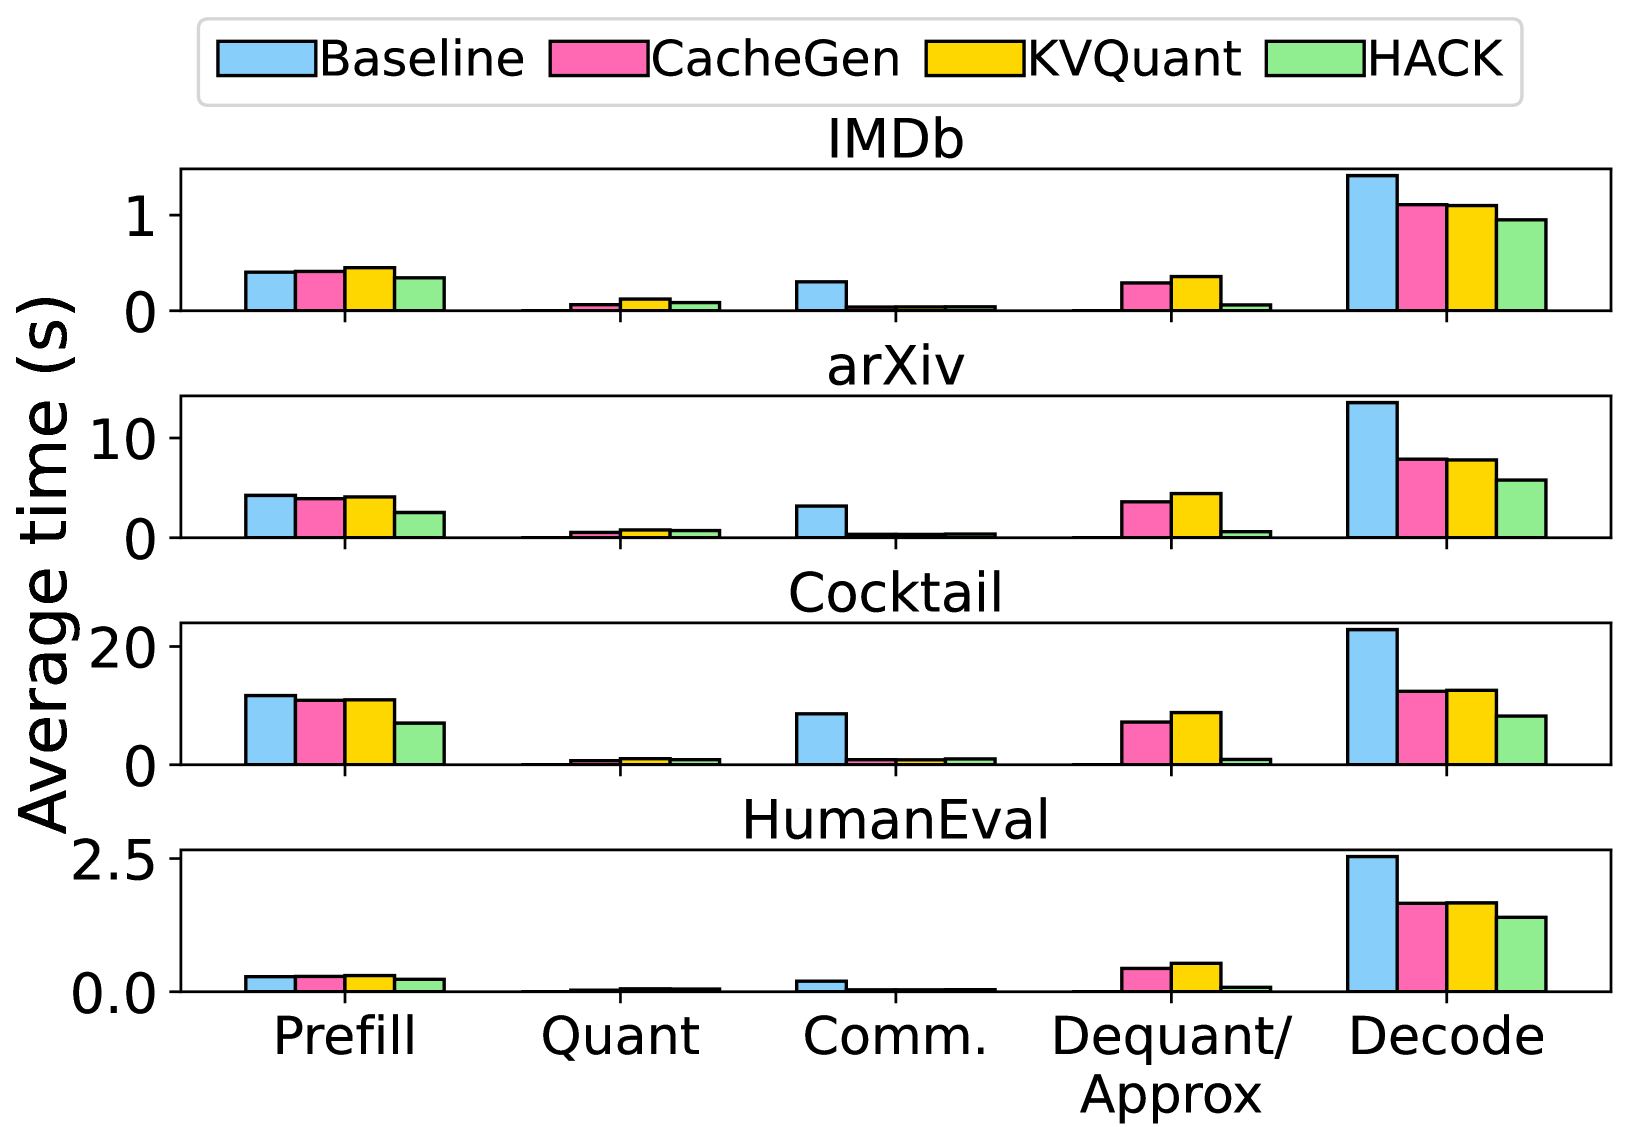
图 4:HACK 的收益并非单点优化,而是同时压低 prefill、communication、dequant/approx 和 decode 几个账项;其中反量化被小得多的 approximation overhead 替代。来源:arXiv HTML figure[2]。
JCT 分解更能看出机制。HACK、CacheGen 和 KVQuant 都把 KV 压到原始大小的大约 15%,因此相对于 baseline,KV 传输时间下降 80.6% 到 85.4%,通信只剩 JCT 的 1.31% 到 5.4%。但 HACK 额外把 CacheGen/KVQuant 中 17.2% 到 30.4% 的 dequantization 开销替换成 1.53% 到 3.18% 的 approximation overhead。同时,由于 attention 中的矩阵乘法开始受益于低比特整数路径,HACK 的 prefill 时间比其他方法低 14.6% 到 41.9%,decode 时间比 CacheGen/KVQuant 低 11.5% 到 33.7%[1]。
跨 GPU 结果也有信息量。在 Llama-3.1 70B + Cocktail 下,HACK 相比 baseline 在 V100 上最高降低 70.9% 的平均 JCT;相比 KVQuant,在 A100 prefill 上最高降低 52.3%。V100 对 CacheGen/KVQuant 的相对优势较小,因为 V100 tensor core 不支持 INT8 矩阵乘法,计算侧收益被削弱;但 V100 网络带宽最低,所以相对 baseline 的通信收益仍然最大[1]。这给部署判断提供了边界:HACK 最适合 KV 传输和长序列 decode 已经压住系统吞吐的场景;如果硬件已经有强 FP8/INT8 路径、网络也足够富裕,收益结构需要重新测。
精度方面,HACK(Π=64) 相比 baseline 的损失在 0.76% 到 1.56% 区间;CacheGen 和 KVQuant 分别是 1.44% 到 2.08%、1.46% 到 2.33%。换言之,HACK 没有用更差的精度换速度,而是通过更细粒度的非对称分区和尾块策略,把低比特执行的误差控制在同类压缩方法之内。它的显存占用比 CacheGen/KVQuant 略高 0.6% 到 2.9%,主要来自 sum values 和 V 尾块 FP16 buffer,但仍明显低于不压缩 KV 的 baseline[1]。
六、它对 serving runtime 的启发:KV cache 会越来越像可执行状态
HACK 最有价值的地方,是它把 KV cache 从“被保存的中间张量”推进成“可计算的低比特状态”。过去的 KV 压缩常沿着两个方向走:一种是保留哪些 token,例如 eviction、pruning、heavy hitter;另一种是每个 token 用多少 bit,例如 KVQuant、KIVI、CacheGen。HACK 补上了第三个问题:低比特 KV 是否能直接进入核心算子。如果答案成立,KV cache 的格式就不再只是存储布局,而会影响 kernel、metadata、调度策略和跨节点传输协议。
这个判断和当前 AI Infra 的几条趋势是同向的。vLLM 把 KV cache 做成 block/page 管理,Mooncake、MemServe、DéjàVu 这类系统把 KV 变成可跨请求、跨节点流动的资源,prompt caching 和 prefix caching 又让 KV 生命周期延伸到请求之外。HACK 进一步追问:这些被系统管理起来的 KV 状态,能否保持压缩形态完成后续 attention 计算。真正的挑战不只在算法误差,也在 runtime 是否愿意为这种格式重写 attention backend、KV cache layout 和传输 metadata。
边界同样要讲清楚。HACK 当前论文版本仍然是研究原型,代码链接是匿名仓库,Triton INT8 限制让 2-bit 到 INT8 的转换不可避免;2-bit 量化为了精度需要较小 partition,又会带来额外 JCT;作者也承认未来需要新的量化方案和 CUDA 实现来进一步降低开销[1]。此外,论文的核心收益建立在分离式推理、长上下文、KV 传输明显占比和特定 GPU/网络组合之上,把它直接外推到所有在线推理负载会过强。
七、结论
HACK 的核心贡献,可以理解为把 KV cache 压缩从数据搬运优化推进到了 attention 算子语义。它用 2-bit KV 降低跨节点传输和 decode 访存,用同态量化避免每轮反量化,用 partition、sum cache 和 V 尾块策略控制误差与额外开销。论文实验表明,在长序列分离式推理里,这条路径可以同时压低通信、计算和显存访问三个账项,而不只是把瓶颈从网络挪到 GPU kernel。
更长期看,HACK 指向的是一种 serving runtime 的设计方向:KV cache 的格式、生命周期和执行方式会越来越紧密地耦合。未来的推理系统如果继续走 prefill/decode 分离、KV 共享、远端 cache pool 和长上下文 agent workload,KV cache 很可能从“保存历史 token 的内存区域”演化为一组带有压缩格式、可执行语义和调度约束的系统状态。HACK 仍是这条路上的研究原型,但它把问题问到了足够底层的位置。
参考资料
[2] HACK arXiv HTML version with figures
[3] CacheGen: KV Cache Compression and Streaming for Fast Large Language Model Serving
[4] KVQuant: Towards 10 Million Context Length LLM Inference with KV Cache Quantization
[5] Efficient Memory Management for Large Language Model Serving with PagedAttention
[6] FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning
[7] DistServe: Disaggregating Prefill and Decoding for Goodput-optimized Large Language Model Serving
[8] Splitwise: Efficient Generative LLM Inference Using Phase Splitting
[9] Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。