Agent 是 LLM 推理里最极端的工作负载。一次普通的 chat 调用可能 2K token、单轮就结束;一次 Claude Code 任务可能跑 50 次模型调用,每次都背着 30K 以上的固定开销,工具结果还在不停地往里堆。把 prefill 当成一次性成本来想,agent 经济学根本走不通——除非每次调用真正进 GPU 的 token 远小于看起来的输入长度。
这件事在 2026 年已经不是研究问题,而是生产现实。Manus 团队公开的判断很直接:KV cache 命中率是生产级 agent 的”单一最重要指标”[1]。因为对 Claude Sonnet 而言,cache read 是 0.30 美元/MTok,未命中的输入是 3 美元/MTok,差 10 倍;缓存了的请求还不会占用速率限制配额。Anthropic 给出的另一组数字在同一个量级:Claude Code 用户日均消耗约 6 美元,90% 用户低于 12 美元——这种价格点完全是把绝大多数 token 都压进 cache read 才有可能维持的。
把这条主线拉直,整个栈分成四层:模型推理引擎层(vLLM / SGLang / Mooncake / LMCache)决定了 prefix 复用在硬件上能做到什么;Anthropic 的 prompt caching 与 context management API 把这个能力暴露成可控的接口;Claude Code 这类应用层 harness 围绕这套接口设计提示词、消息和工具结构;具体的 agent 行为在用户会话里组合这三层。任何一层的设计破坏了 prefix 字节级稳定性,下游就会被同样的代价惩罚。下面按从应用层一路往下到基础设施的顺序拆,再回到几个一线生产 agent(Claude Code、Manus、Cursor)的共同原则。
一、Agent 上下文的真实形态
理解 KV cache 工程之前要先理解 agent 上下文长什么样。和传统 chat 完全不同,agent 上下文有几个固有特征。
第一是输入输出极端不对称。Manus 公开的数据是平均 100:1 的输入/输出 token 比[1]。每一步只产生几十到几百个 decoding token,但读进去的可能是上一步累积下来的几万 token。这意味着 prefill 主导成本——而 prefill 恰好是 prefix caching 能短路的部分。
第二是 append-only 的本性。每一轮都把上一步的工具调用、工具结果、模型推理一起追加到尾部,回头修改前面的内容会让从修改点开始的所有 KV 失效。append-only 不是优雅的设计选择,而是缓存约束反向施加的结构性规定:你想要 cache 命中,就只能在尾部增长。
第三是工具结果的尺寸压力。一次 grep 拿回 200 行、一次浏览拿回 5K token 的网页,几轮之后这些原始结果就把 context 推到上限。但已经被模型读过的 grep 输出,对接下来的步骤几乎没有再读价值。这给”清理旧工具结果”提供了直接动机——也是 Anthropic 把 clear_tool_uses_20250919 设计成 server-side 默认策略的原因[2]。
第四是错误也是上下文。Manus 的经验是不要隐藏失败的工具调用和错误堆栈,因为它们是模型修正信念、避免重蹈覆辙的隐式证据。这条与”压缩 = 删除冗余”的直觉相反,提醒我们 context 不只是”信息检索池”,还是模型行为校准的载体。
固定开销也很可观。Claude Code 的每次调用前缀大约 30K token:11K 的系统提示词加 20K 的 40 多个工具 schema[3]。如果不缓存,每轮都按 3 美元/MTok 重新计费——按 50 轮一个任务算,仅前缀就要付 4.5 美元。一旦命中 cache read,同一段前缀的成本下降到 0.3 美元/MTok,整个 agent 经济才成立。
二、Anthropic 缓存接口:应用层必须围绕的硬约束
Claude Code 的所有缓存设计都建立在 Anthropic API 的 prompt caching 模型之上。这层接口的边界值得先讲清楚,因为它决定了上层能做什么、不能做什么[4]。
缓存匹配是 prefix 字节级的精确匹配——不是语义相似、不是前 N 个 token,是从请求开头到第一个 cache breakpoint 之间所有内容的 hash 完全一致。任何字符变动(空格、标点、JSON key 顺序)都会换一条 prefix。每个请求最多 4 个 breakpoint,向上回溯 20 个 block 寻找已缓存条目,这套机制让多轮对话的 cache 自动随会话推进。
缓存有最低长度门槛:Claude Sonnet 4.5/4 系列是 1024 token,Sonnet 4.6 升到 2048,Opus 4.5/4.6/4.7 和 Haiku 4.5 都是 4096,未达门槛会静默不缓存。TTL 有两档:默认 5 分钟,写入成本 1.25× 基础输入价;扩展 1 小时,写入成本 2× 基础输入价;两者读都是 0.1×。同一请求里 1 小时段必须排在 5 分钟段之前。两档共用时按三段计费边界——cache hit 段、1 小时写入段、5 分钟写入段——这种”混合 TTL 计费”是 Claude Code 实际生产里普遍使用的模式。
最重要的是失效的级联结构:tools → system → messages。修改一个工具定义会让系统提示词和所有消息的 cache 全部失效;修改系统提示词只让 messages 失效;修改最后一条 user 消息只让 messages 之间从修改点开始的部分失效。tool_choice 改变会失效到 system 那一层,图片增删会失效到 messages 那一层。这套层级是 Claude Code 七种优化模式(见第六节)里大多数决策的物理前提。
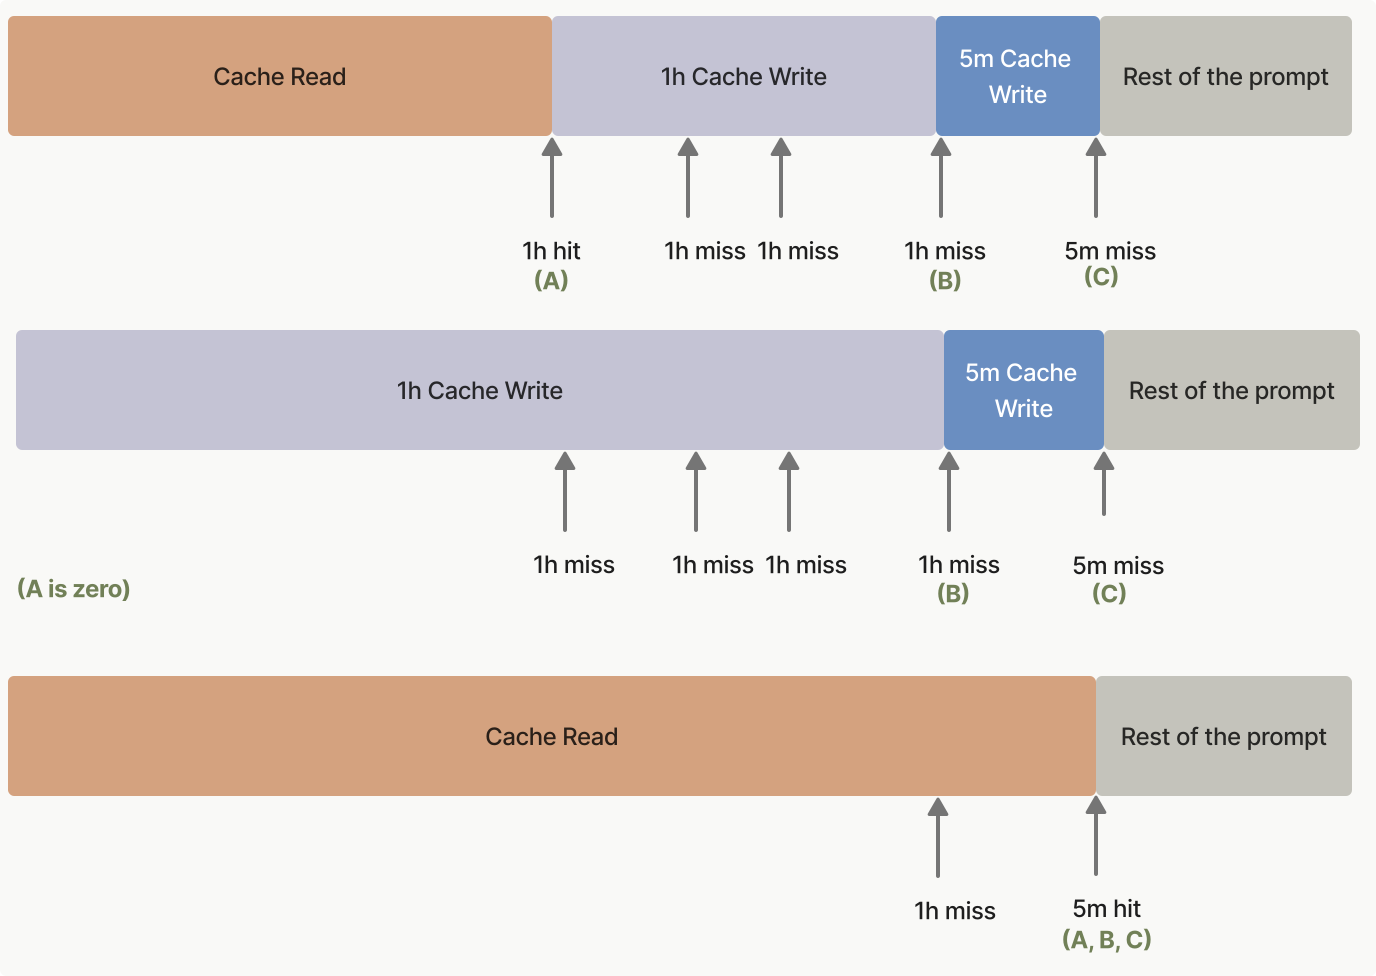
图 1:同一请求里同时使用 5 分钟与 1 小时 TTL 时的三段计费边界——A 之前是 cache read,A 到 B 是 1 小时 cache write,B 到 C 是 5 分钟 cache write。来源:Anthropic 官方文档。
2026 年 2 月 5 日,Anthropic 把缓存隔离粒度从 organization 降到 workspace。这意味着同一公司不同 workspace 之间不再共享 prefix——对 IDE/CLI 类大规模部署是显著的成本变化。同月还有一次外部观察到的事故:Anthropic 把 Claude Code 默认 1 小时 TTL 悄悄降到 5 分钟[5],部分长间隔会话的 cache hit 率从 99.8% 几乎归零,提醒所有依赖这层接口的 agent harness:服务端的策略变化也是 cache break 的风险源。
三、Claude Code 的分段架构与三路 split
理解了硬约束,再看 Claude Code 的提示词架构就能看出每个细节为什么这样写[6]。
系统提示词不是一个字符串,而是一组用 systemPromptSection(name, compute) 注册的段落。每段都通过工厂函数挂入注册表,结果记忆化到 STATE.systemPromptSectionCache,相同输入只计算一次,/clear 或 /compact 才会清空。需要每轮重算的段落必须用 DANGEROUS_uncachedSystemPromptSection(name, compute, reason) 显式声明,并在第三个参数里写下书面理由——目前生产代码里只有一个例外:mcp_instructions,理由是”MCP 服务器在轮次之间会连接/断开”。这种 API 摩擦设计让”打破 cache”的决策必须经过 code review,从工程文化层面阻挡随手破坏 prefix 的修改。
SYSTEM_PROMPT_DYNAMIC_BOUNDARY 是另一个关键约束:一个 in-band 标记把提示词劈成两半。边界之前的内容必须 100% 静态,分配 cacheScope: 'global',可以跨所有 Claude Code 用户共享;边界之后的内容是会话级动态,cacheScope: null 不缓存。原始文档原话:边界之前每多一个会话相关条件,Blake2b prefix hash 的变体数量就会以 2^N 增长,所以静态区严禁出现任何会话变量。
splitSysPromptPrefix() 函数是这套架构的实际编排者,提供三条路径。第一条是标准 first-party:最多产生 4 个块——attribution(不缓存)、prefix(不缓存)、static(global 缓存)、dynamic(不缓存),最大化跨用户复用。第二条是 MCP 降级:检测到任何 MCP 工具就自动设置 skipGlobalCacheForSystemPrompt=true,把 global 降到 org 级别,因为 MCP 工具列表是会话相关的,不能进 global 池。第三条是第三方 provider 兜底:单块、org 级别,不分边界,简化处理。
工具的 description 字段也是 prefix 组成部分,所以工具描述被设计成”micro-harness”,而不只是文档字符串。BashTool 的描述里直接写明哪些操作必须转给专用工具(避免 cat/head/tail,应该用 Read),FileEditTool 要求”必须先读后编辑”——这些行为约束同时出现在描述和运行时校验里,形成双重保护。SkillTool 把可用 skill 的列表硬限定在 context window 的 1%(200K 窗口下约 8000 字符,每条 skill 描述上限 250 字符),按”完整描述 → 截断描述 → 仅名称”三级降格,确保技能数量增长不会悄悄侵蚀 cache prefix 稳定性。
buildEffectiveSystemPrompt() 在更上层用五级优先级组合提示词:override(loop 模式)→ coordinator → agent(proactive 拼接 / 标准替换)→ custom(CLI --system-prompt)→ default(getSystemPrompt()),后面再统一追加一段 append。组合用三元链而不是 if/else 网,是为了让组合规则一行能看完。
四、自动压缩:167K 阈值、九段模板与断路器
当对话推到接近 context window 上限,自动压缩(autoCompact)启动。计算公式是 effectiveContextWindow - AUTOCOMPACT_BUFFER_TOKENS。对 200K 窗口的 Claude Sonnet 4.x,三层缓冲叠加得到[7]:
- 输出预留 20,000 token(压缩输出的 p99.99,封顶到模型的 max output)
- 安全缓冲 13,000 token(覆盖压缩触发到执行之间的工具调用、系统消息)
- 硬底线 3,000 token(最后一道紧急边界)
最终阈值 167,000 token、约 83.5% 利用率。三层缓冲的设计目的不是空间富裕,而是确保压缩请求本身不会因为太长再触发一次压缩——这是个听起来简单但设计不当就会引发级联崩溃的场景。
压缩使用九段模板:Primary Request & Intent / Key Technical Concepts / Files and Code Sections(要求”完整代码片段”而非 diff)/ Errors and Fixes / Problem Solving / All User Messages / Pending Tasks / Current Work / Optional Next Step。每段要求严格按时间顺序处理,分析过程包在 <analysis> 标签里(最终从结果剥除)。模板开头和结尾各有一句 “Do NOT call any tools”,重复不是冗余,而是单轮 API 调用容错很低时的故意强调——这次调用就是用来产出摘要的,模型若开始调用工具,整个压缩预算就白白耗尽。
当压缩请求自身超出输入限制(PTL,Prompt Too Long),走 3 次重试循环:每次按错误响应里的 token gap 截掉最早的若干 message group;如果 gap 解析失败,兜底以 ~20% 的步长削减。重试前必须剥掉 PTL_RETRY_MARKER,避免 zero-progress 死循环。
断路器机制来自一次真实生产事故:1,279 个会话出现连续 50 次以上压缩失败,最长一个会话连续失败 3,272 次,全网每天浪费约 25 万次 API 调用。结果是写死的硬性约束:连续 3 次失败就停止自动压缩,返回 { wasCompacted: false }。用户仍然可以手动 /compact,但自动路径关闭。这个数字不是理论最佳,是真实成本倒逼的工程决策。
querySource 排除递归是另一层保护:session_memory、compact、marble_origami 三类来源永远不触发压缩。Context Collapse 模式与 reactive compact 实验性 flag 也按优先级关闭自动压缩。环境变量 CLAUDE_CODE_AUTO_COMPACT_WINDOW、CLAUDE_AUTOCOMPACT_PCT_OVERRIDE、DISABLE_AUTO_COMPACT、DISABLE_COMPACT 提供运维侧覆盖,但都只能让压缩”更早触发”,永远不能放宽阈值。
压缩之前会拍 readFileState 缓存的完整快照然后清空。压缩之后调用 createPostCompactFileAttachments() 选择性恢复,预算严格——最多 5 个文件,单文件 5,000 token,总预算 50,000 token;skill 类似,单 skill 5,000 token、总预算 25,000 token。文件按最近访问时间排序取前 5,但要先经过多重过滤:plan 文件走独立通道;CLAUDE.md 通过 system prompt 注入,不重传;已经在保留消息尾部出现的文件跳过;剩下的才进入预算分配。文件是重新读盘的,不是从摘要里提取,确保内容准确。
sentSkillNames(已发送过完整描述的 skill 集合)压缩后不重置,是个刻意的”不恢复”决策。重新注入完整 skill 列表大约要 4,000 token,但实际价值低——已被调用过的 skill 在恢复阶段独立重建,skill 工具本身仍然在 schema 里。设计者选择接受”技能发现能力略微下降”换取每次压缩节省 4K token,这是 token 经济学进入恢复策略的具体例子。
五、微压缩与 Anthropic 服务端的 context_management API
自动压缩是大手术,大多数情况下需要的是小手术。Claude Code 实现了三种”微压缩”,核心理念是”最便宜的 token 是你从来不发送的那个”。
第一种是时间触发型:连续 60 分钟以上没有活动后,下一次请求只保留最近 5 个工具结果,其余替换为占位文本。理由直接——Anthropic 默认 5 分钟 TTL 早已冷却,重新发送旧工具结果毫无意义;既然 cache 已经凉了,重建成本既成事实,截断旧内容代价最低。
第二种是 cache_edits 精准删除,利用 Anthropic API 的 cache_edits 特性:本地消息数组完全不动,只让服务端从已缓存的 KV 序列里删除特定区间。本地不动意味着 cache key 计算基础不变,prefix 连续性得以保护;服务端做的是定向裁剪。这是活跃会话内最优雅的清理路径,但它也带来一个副作用——后续请求的 token usage 会显著下降,cache break 检测必须用 cacheDeletionsPending 标志位排除这种”预期下降”,免得误报。
第三种是 Anthropic 的服务端 context_management API。clear_tool_uses_20250919 是 server-side 策略,应用层只需声明[2]:
context_management: {
  edits: [{
    type: "clear_tool_uses_20250919",
    trigger: { type: "input_tokens", value: 30000 },
    keep: { type: "tool_uses", value: 3 },
    clear_at_least: { type: "input_tokens", value: 5000 },
    exclude_tools: ["web_search"]
  }]
}
含义是:当输入超过 30,000 token 时,按时间最旧到最新的顺序清除工具结果,至少清掉 5,000 token,但保留最近 3 次 tool use 不动;web_search 的结果永远不被清。可选 clear_tool_inputs: true 还会一并清除工具调用参数本身,只留下”调用过这个工具”的事实而不留参数。
clear_at_least 这个参数有特别的工程意味:清除会失效 cache prefix,必须一次清足够多 token,让重新写入的 cache 本身值得。每个模型类的 clear_thinking_20251015 默认值不同:Opus 4.5+ 和 Sonnet 4.6+ 默认保留所有 thinking block,更早版本默认只保留最后一轮。如果代码跨多模型类运行,必须显式设置 keep,不能依赖默认。
Anthropic 在 2026 年 1 月 12 日发布 server-side 的 compact_20260112 策略[8],把整套压缩逻辑搬到服务端:默认 150,000 token 触发(最低 50,000),生成的 summary 以 compaction block 形式返回,下次请求把它加到 messages 里,API 自动丢弃 compaction block 之前的所有消息。这套接口对应用层的好处是不需要再实现自己的压缩重试和断路器;坏处是失去对压缩模板和恢复策略的控制权——Claude Code 显然为了那 5 个文件、50K 预算的精细恢复策略,仍然保留自己的压缩路径。
三种微压缩之间有明确优先级:时间触发型最先检查,命中则短路其他两种,因为冷 cache 和热 cache 需要完全不同的处理策略。
六、Cache Break 检测与 90% 服务端归因
cache 失效难以完全避免,但可以被检测和归因。Claude Code 的 services/api/promptCacheBreakDetection.ts 有 728 行代码专门做这件事[9]。
系统分两阶段。Phase 1 是 recordPromptState(),请求前对系统提示词、工具 schema、模型设置、cache control 等拍照,与上次快照对比,记录 PendingChanges。Phase 2 是 checkResponseForCacheBreak(),响应后用 token 分析确认实际命中情况。
确认 cache break 必须同时满足两个条件:cache token 下降超过上一次基线的 5%(< prevCacheRead * 0.95),且绝对下降超过 2,000(MIN_CACHE_MISS_TOKENS)。双阈值过滤掉低基线和小波动的噪声。PreviousState 维护 15+ 个字段:systemHash、toolsHash、cacheControlHash、toolNames、perToolHashes(每个工具单独 hash)、systemCharCount、model、fastMode、globalCacheStrategy、betas、autoModeActive、isUsingOverage、cachedMCEnabled、effortValue、extraBodyHash、prevCacheReadTokens、callCount、cacheDeletionsPending。
getTrackingKey() 按 querySource 和 agent ID 隔离状态:repl_main_thread、sdk、agent:custom、agent:default、agent:builtin,子 agent 用 agentId 进一步区分。短命来源如 speculation 干脆不进入跟踪,避免污染。computeHash() 在 Bun 环境下用 Bun.hash,否则用 djb2,统一接口。
每次 break 会做归因:客户端变化(提示词/工具/模型/cache 策略变了)、TTL 过期(最后一条消息距今超过 5 分钟或 1 小时)、服务端因素(前两类都不成立)。这套系统得到了一个反直觉的统计结论:约 90% 的 cache break 来自服务端路由或驱逐,而不是客户端改动。这个数字根本性地改变了优化方向——如果 90% 的失效是客户端控制不了的,把精力穷尽在客户端可变量上几乎徒劳,应该集中在让可控变化保持稳定。
工具 schema 变化的统计同样有指导意义:77% 的 schema 变化是单工具修改。这就是为什么 perToolHashes 要做到工具粒度——粗粒度 hash 会把单个工具的修改放大成”整个工具集变了”。
观测端,每次检测到 break 都会发 tengu_prompt_cache_break 事件到 BigQuery,包含全部 boolean 变化标志、工具增删改、token 统计、TTL 时窗、时间戳和 request ID。多维事后分析正是 90%/77% 这类结论的来源——没有这层观测,整个优化方向都是猜的。Haiku 模型被排除在检测之外,因为其 cache 行为模式与 Sonnet/Opus 不同。
七、Latching 与七种优化模式:把可控变化锁死
90% 服务端、10% 客户端的结论意味着客户端这 10% 必须做到极致。Claude Code 的 latching 机制和七种优化模式正是这个策略的具体落地[10]。
latching 是核心稳定性模式,出现在四个地方。第一是 TTL eligibility latching(getPromptCache1hEligible())——会话开始时根据用户身份(Anthropic 员工 / Claude AI 订阅无超额 / Bedrock + 1h 环境变量)一次性决定能否使用 1 小时 TTL,结果存入全局 STATE,之后即使用户额度状态翻转,序列化的 cache_control 对象也保持不变。第二是 GrowthBook allowlist 缓存——feature flag 在会话内被冻结,避免远程配置翻转破坏 cache。第三是 Beta header 粘性开启:AFK Mode、Fast Mode、Cache Editing 三个 header 一旦在会话中开启,即使后续条件不再满足,本次会话内仍然保持激活——单向状态转换,只有 /clear 或 /compact 才能解锁。第四是 thinking clear latching,最近一次 API 完成超过 1 小时后才触发 thinking 块清理。
设计哲学一句话能讲清:会话中途的开关切换不能改变服务端 cache key、不能让 50–70K token 的缓存系统提示词作废。宁可让某个 header 在该关闭时仍然开着,也不接受破坏 prefix 的代价。
七种优化模式是 latching 之外的具体补丁:
日期记忆化:memoize(getLocalISODate) 在 constants/common.ts 里把日期固定到会话开始时刻。代价是过了午夜可能用一个旧一天的日期,节省的是约 11,000 token 的系统提示词在跨天时不需要重建——对全网用户而言,每天零点的 cache 雪崩远比”日期旧一天”难承受。
月度粒度:getLocalMonthYear() 在工具提示词里返回 “Month YYYY”,把变化频率从每日降到每月。背后是同一个原则——越靠请求前端的内容,变化频率必须越低。
Agent 列表附件化:把 dynamic agent listing 从 AgentTool 描述移到消息附件 agent_listing_delta。这一项就消除了全队 10.2% 的 cache_creation_tokens,是七种模式里单项效果最显著的。原因和层级结构有关——工具 schema 在 tools → system → messages 层级最顶端,任何变化向下传播;消息附件在末端,失效影响最小。
Skill 列表预算:硬性限定为 context window 的 1%(SKILL_BUDGET_CONTEXT_PERCENT = 0.01,200K 下约 8,000 字符),单 skill 描述上限 250 字符。技能数量增长被严格框死,不会悄悄推大 prefix。
$TMPDIR 占位符:把用户特定路径 /private/tmp/claude-{UID}/ 替换为 $TMPDIR,消除用户维度差异。这一改动直接把组织级缓存提升为全局缓存——同一段 BashTool 提示词从此可以在所有 Claude Code 用户之间共享。
条件段落策略:与其根据 feature flag 条件性地添加/删除段落,不如把静态内容固定保留在前缀里,动态部分推到边界之后或单独消息。这样 GrowthBook flag 翻转不会让前缀失效。
工具 schema 会话缓存:utils/toolSchemaCache.ts 用模块级 Map<string, CachedSchema> 锁定 schema,第一次渲染后整个会话不再重算,会话中途 GrowthBook 刷新不会破坏 ~11K token 的工具块。这里有个值得记住的真实 bug:StructuredOutput 的实例 name 相同但每个 workflow 的 schema 不同,原本只用 name 做 cache key 时错误率从 5.4% 飙到 51%。修复是把 key 改成复合:${tool.name}:${jsonStringify(tool.inputJSONSchema)}。clearToolSchemaCache() 故意放在叶子模块,避免 auth → config → bridgeEnabled 的循环依赖。
七种模式背后是同一个决策树:能不能把内容移到消息尾部?能就用附件。能不能消除用户维度差异?能就用占位符。能不能降低变化频率?能就记忆化或粗化精度。能不能限制变化幅度?能就加预算或省略。都不能,就标记成 scope: null 不缓存。
八、底层基础设施:vLLM、SGLang、Mooncake、LMCache
应用层把 prefix 设计得再稳,最终能省多少钱取决于推理引擎对 prefix 复用的支持程度。Anthropic 的 prompt caching 是封装好的服务,但开源生态里这层基础设施已经成熟,足以反过来理解 Anthropic 内部的工程权衡。
vLLM Automatic Prefix Caching (APC) 走 block-level 精确匹配:每个 KV block 按 token 序列哈希,新请求的 prefix 按相同分块策略哈希后查表命中。零配置、原生集成 PagedAttention,但要求 token 序列严格相同;批量推理里多请求共享 prefix 时效果好,多轮分支或部分重叠场景命中率有限。
SGLang RadixAttention 用 radix tree 组织 KV cache,支持部分重叠匹配。零配置、自动处理分支会话,对工具调用结果交错的 agent 类工作负载特别友好[11]。公开数据:少样本场景命中率 85–95%,多轮 chat 75–90%,agent 循环/多租户 SaaS/repo 问答场景 60–85%,相同 7K context 场景下比 vLLM 多约 10% 吞吐。在 1000 路客服会话/小时的负载下,这个差距会折算成显著的算力节省。
Mooncake 是 Moonshot AI 为 Kimi 服务自建的解耦架构,FAST’25 best paper[12]。核心是 KVCache-centric 的 prefill/decode 分离:prefill 节点接收原始输入、可复用的 prefix block ID 和新分配的 block ID,从全局 KVCache pool 拉取已计算的 KV,只对未命中部分做 prefill;decode 节点使用同一份 KVCache。下面是 CPU、DRAM、NVMe SSD 的三级存储,把 GPU 集群里被忽视的非加速器资源利用起来。生产数据是 A800 集群每天处理请求量提升 115%、H800 提升 107%,跨千节点每天处理超过 1000 亿 token——这是公开可见规模最大的 KV cache 复用部署之一。
LMCache 走另一条路:作为 vLLM 的 connector,把 prefix cache 持久化到 CPU 内存或 NVMe[13]。生产配置默认 20GB CPU 缓冲,支持继续往 NVMe 扩展。文档给出的端到端节省是 3–10× 延迟和 GPU 周期,多轮 QA 和 RAG 是主要受益场景。Google GKE Inference 已在使用,CoreWeave 和 Cohere 在 CoreWeave 基础设施上做过基准测试。在 128K–1M context 已经是生产工作负载的 2026 年,这种把 KV 推到 CPU/NVMe 的层级化缓存,是 GPU 内存碰到墙时的必然选择。
把这四层放在一起看:vLLM/SGLang 是请求级 prefix 匹配,Mooncake 是集群级 KVCache 池,LMCache 是 GPU 外的层级化扩展。Claude Code 的应用层稳定性最终会变成这些层里 cache pool 的命中率——稳定的 prefix 提供更高复用率,更高复用率让基础设施投资回报更好,回头让服务商有动力降低 cache read 价格,闭环才能成立。
九、跨系统对比:Manus、Cursor、Cline 的同一组约束
不是只有 Claude Code 在解这套问题。把同一组约束放到不同 agent harness 里,可以看到工程师独立收敛到非常相似的原则。
Manus 把 KV cache 命中率明确写成”单一最重要指标”[1]。具体做法包括:避免动态前缀(连秒级时间戳都禁止出现在系统提示词里),确保 JSON key 的顺序在序列化时确定(不稳定的序列化会无声破坏 cache),在系统提示词后显式放置 cache breakpoint。工具不动态删除,因为工具定义在 cache 层级最顶端,删除会让所有后续观察的 cache 失效——Manus 用 logit masking 来”屏蔽”工具:在 decoding 阶段约束响应前缀(Auto/Required/Specified 三种模式),工具名字带 browser_、shell_ 等前缀,使 logit mask 不需要 stateful processor。文件系统被当作”无限上下文的外部记忆”——网页、文档以路径形式保存,需要时再读,避免 128K 窗口被原始 RAW data 撑爆。todo.md 这种”复述”机制对抗 lost-in-the-middle:把目标重写到最近上下文里,让 50 步以上的任务序列保持目标对齐。错误状态保留——失败的工具调用和堆栈不删除,作为模型修正信念的隐式证据。
Cursor 和 Cline 的设计哲学不同。Cursor 在普通模式下大约 120K token 配额,MAX 模式开放完整窗口;Agent 默认每次只读文件前 250 行,搜索结果上限 100 行,明显是 token 预算和检索深度的权衡。Cline 把上下文用量直接显示在 chat pane 顶部,按真实 token 计费,不做预算压缩。两者都用项目级 rules 文件(Cursor 的 .cursor/rules/、Cline 的 .clinerules)做项目级行为约束——这相当于把”长尾用户偏好”从系统提示词推到磁盘,避免污染 global cache。Cursor 文档里的”代码文件保持在 500 行以内、关键函数在前 100 行”建议,本质是配合”前 250 行采样”的检索策略——这种文件级 prompting 是工程师对工具行为的反向适配。
放到一起看,所有生产 agent 在解决同一组问题:怎样在 prefix 稳定性约束下做长程任务、怎样在压缩或裁剪时不丢关键状态、怎样让工具变化不污染 cache 顶端、怎样让模型在长 context 里不失焦。手段不同,约束相同。
十、研究前沿:从启发式静态规则走向模型驱动管理
学术界已经把 agentic prompt caching 当成一个独立评测对象。Don't Break the Cache[14] 用 DeepResearch Bench 跑了 OpenAI、Anthropic、Google 三家 500 多个 agent session,10K token 系统提示词。结论很干脆:合理使用 prompt caching 削减 41–80% 成本、提升 13–31% TTFT;但天真的”全 context 缓存”反而会增加延迟。最有效的策略是把动态内容放到系统提示词末尾、避免传统 function calling 把动态参数注入 prefix、把动态工具结果排除在缓存范围之外——这套结论与 Claude Code 把 agent list 从工具描述移到附件、把日期记忆化到会话开始的实践完全吻合。
CodeComp[15] 把 agentic 编码场景的 KV cache 压缩做成结构化问题——按 AST 单元而非 token 窗口压缩,在 SWE-bench 类任务上保留语法完整性。
SideQuest[16] 走更激进的方向:训练模型自主管理自己的 KV cache。它在主推理线程之外起一个并行辅助线程,定期分析工具输出哪些”已经过期”,输出结构化删除指令,删除发生在共享 KVCache 上但 token 隔离在并行线程里。在 gpt-oss-20b 上微调(215 个高质量样本,1,274 条辅助轨迹)后:FRAMES(Wikipedia 检索 424 样本)峰值 token 减少 56–65%,准确率仅下降 ~2%;BrowseComp(500 样本)同等量级减少,准确率下降 ~5%;H100 单卡上吞吐提升 83.9%、KV cache 内存减少 53.9%、端到端运行时间减少 36.8%。
把这些研究和 Claude Code 的工程实践对照:今天的工业级方案是”启发式静态规则 + 严密观测”——日期记忆化、agent list 附件化、五段缓冲、断路器,全靠工程师猜对了哪些位置会变。SideQuest 这类工作的方向是把这部分决策交给模型自身——它知道自己已经看过哪些工具结果、哪些不再相关,自主清除。从 Anthropic 的 clear_thinking_20251015 强制按模型类区分默认行为这一点也能看出趋势:模型本身的”长上下文行为”已经成为产品设计参数,未来很可能进一步内化到模型权重里。
十一、结论
把 Claude Code 的提示词分段架构、自动压缩、cache break 检测、七种优化模式,加上 Anthropic 的 prompt caching 和 context_management API,再叠上 vLLM/SGLang/Mooncake/LMCache 这层基础设施,最后参照 Manus、Cursor 的同类决策,所有这些事情背后是同一条主线:在 prefix 字节级稳定的前提下,让最多的 token 走 cache read,让最少的 token 走全量计算。
这条主线展开成几个可迁移的设计原则。第一,提示词不是字符串,是有层级结构的工程组件——必须按变化频率分段,必须把高变化部分推到尾部,必须把”打破 cache”的操作设计成需要书面理由的高摩擦动作。第二,决策必须由可观测数据驱动,不是直觉——25 万次/天的废弃调用催生了断路器,10.2% 的 cache_creation_tokens 占比催生了 agent list 附件化,90% 服务端 break 的统计重新分配了优化资源;离开 BigQuery 这种事后分析能力,整套系统会很快退化。第三,多层缓冲防级联——三层 token 缓冲让压缩不会触发压缩,三类 querySource 排除让递归不会发生,断路器让连锁失败有上限。第四,把工程压力推到能承受的层——动态内容能放到附件就不放工具描述里,能交给服务端 clear_tool_uses 就不在客户端写裁剪,能交给模型自己做 garbage collection 就不写规则——这是从 Claude Code 到 Anthropic context API 再到 SideQuest 这种研究方向的连续光谱。
这套经验有适用边界。所有具体阈值——167K 压缩点、5/5K/50K 文件预算、4K skill 节省、1% skill budget、20K 输出预留——都是针对 200K context window 调出来的。Claude Sonnet 4.5、4.6 维度内复用没问题;当 1M context 进入主流推理路径,所有这些常数都需要重新校准,更长的 prefix 也意味着 cache break 一次的代价更大。Anthropic 在 2026 年 2 月把缓存隔离从 organization 降到 workspace,4 月一度把默认 1 小时 TTL 降到 5 分钟——服务端策略本身的变化也是 cache break 的来源,这是过去几个月已经发生的事。
最后一个开放问题:当模型本身能像 SideQuest 那样自主管理 KV cache,今天写在 Claude Code 里的这些静态规则有多少会被吸进模型权重?答案大概率不是”全部”,因为在生产部署里,可观测、可解释、可干预的工程层始终需要存在。但应用层和模型本身的边界会持续向上挪——今天写在 splitSysPromptPrefix() 里的逻辑,明年可能就是模型 instruction-following 的隐式行为。这是值得后续持续观察的地方。
参考资料
[1] Context Engineering for AI Agents: Lessons from Building Manus
[2] Anthropic Context Editing Documentation
[4] Anthropic Prompt Caching Documentation
[5] Anthropic quietly nerfed Claude Code’s 1-hour cache (XDA, April 2026)
[8] Anthropic Compaction (compact_20260112) Documentation
[11] When to Choose SGLang Over vLLM: Multi-Turn Conversations and KV Cache Reuse (Runpod)
[13] LMCache: An Efficient KV Cache Layer for Enterprise-Scale LLM Inference
[15] CodeComp: Structural KV Cache Compression for Agentic Coding (arXiv 2604.10235)
[16] SideQuest: Model-Driven KV Cache Management for Long-Horizon Agentic Reasoning (arXiv 2602.22603)
[17] Anthropic Engineering: Effective Context Engineering for AI Agents
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。