版本声明:本文分析基于 vLLM PR #40900 commit
0d5c2e0512e5868580bd77797c6a61b349d98d57(2026-05-05)与 Mooncake commit43ce0f8ff5305e48e8fc4b44372dd271f5140c2a(2026-05-07)。截至 2026-05-07,vLLM 侧 Mooncake Store 接入仍处于 open PR 阶段,接口和默认策略仍可能变化。
Agentic 推理正在把 KV cache 从单机优化推向集群级数据平面。vLLM x Mooncake Store 这篇博客给出的 3.8x throughput、46x P50 TTFT、8.6x 端到端延迟收益[1],表面上来自更高 cache hit rate;源码里更关键的变化,是 vLLM 开始把一段 prompt prefix 的 KV block 视为可以跨实例寻址、查询、搬运和复用的对象,而 Mooncake Store 负责把这些对象放进 RDMA 可达的分布式内存池。
这件事的工程含义很大。过去推理服务常把每个 vLLM replica 当成独立实例,最多依赖 sticky routing 或本地 CPU offload。Agentic workload 的多轮结构让这个假设变得脆弱:同一个会话会反复携带不断增长的历史上下文,调度器一旦把下一轮请求放到另一台机器,本地 cache 就变成了冷 cache。Mooncake Store 的定位,正是给这些 replica 增加一个共享 KV 层。
一、Agentic workload 的问题是跨轮状态复用
vLLM 博客基于 Codex 和 GPT-5.4 在 SWE-bench Pro 上的 610 条 trace 观察到,agentic 会话通常有长时间、多轮循环:模型读上下文、生成中间推理或工具调用,再把工具输出写回下一轮 prompt。到第 30 轮时,上下文长度约 80K token,最长可以超过 180K token;但每轮新增内容通常只有几百到几千 token,平均 input-to-output token ratio 约 131:1[1]。
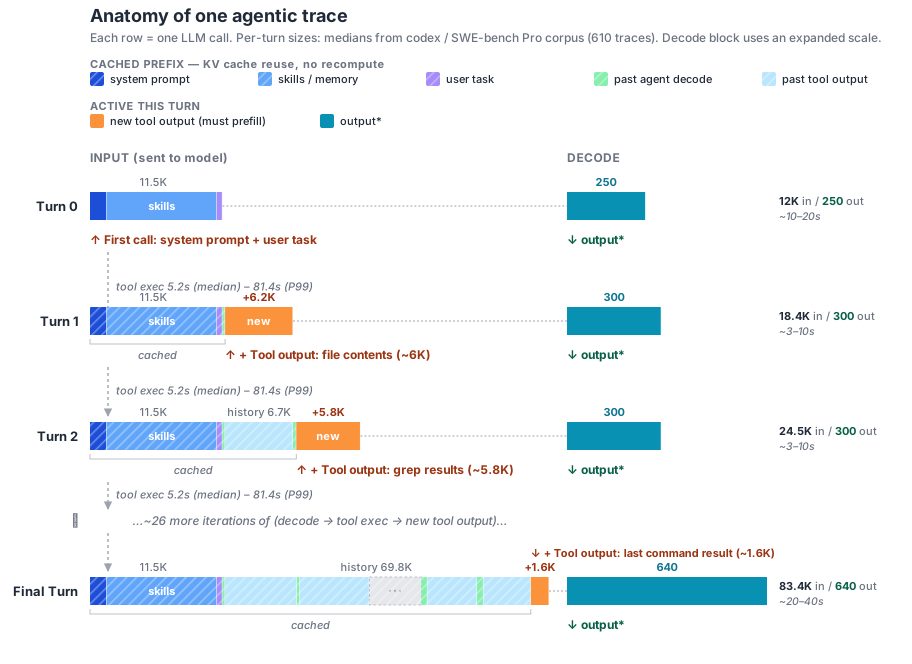
图 1:agentic trace 的关键结构是“历史前缀越来越大,新 token 增量相对很小”。只要共享前缀能跨 turn 命中,prefill 成本就会从重复计算转成读取 KV block。来源:vLLM 官方博客。
本地 prefix cache 能吃到一部分收益,但它有两个天然上限。第一是容量,博客给出的例子是 Kimi-2.5 的 100K token FP8 KV cache 大约占 3.8 GB;多个长会话堆在同一实例上,本地 DRAM 或 SSD 很快进入 eviction。第二是跨实例 miss,负载均衡或故障迁移会把后续 turn 放到另一台 vLLM,这台机器没有见过前面的 prefix,只能重新 prefill。
因此,Mooncake Store 的真正目标不是单纯把 KV cache “搬到 CPU”。更准确地说,它把 token block hash 变成分布式对象 key,让任意 vLLM 实例先询问集群里是否已有这段 KV;命中后再把对应 KV block 拉回本地 GPU cache。这个动作把 session affinity 的压力从 router 转移到共享 KV pool 上。
二、vLLM 接入点:KVConnector 让 Store 进入调度循环
vLLM PR #40900 新增 MooncakeStoreConnector,并在 KVConnectorFactory 中注册为一个标准 KV transfer connector[2]。它沿用 vLLM V1 的 KVConnector 抽象:scheduler 侧负责判断有多少 prefix token 已在外部 cache 中命中,worker 侧负责实际加载和保存 KV block。这个拆分让 Store 不必改写 model runner 的核心执行路径。
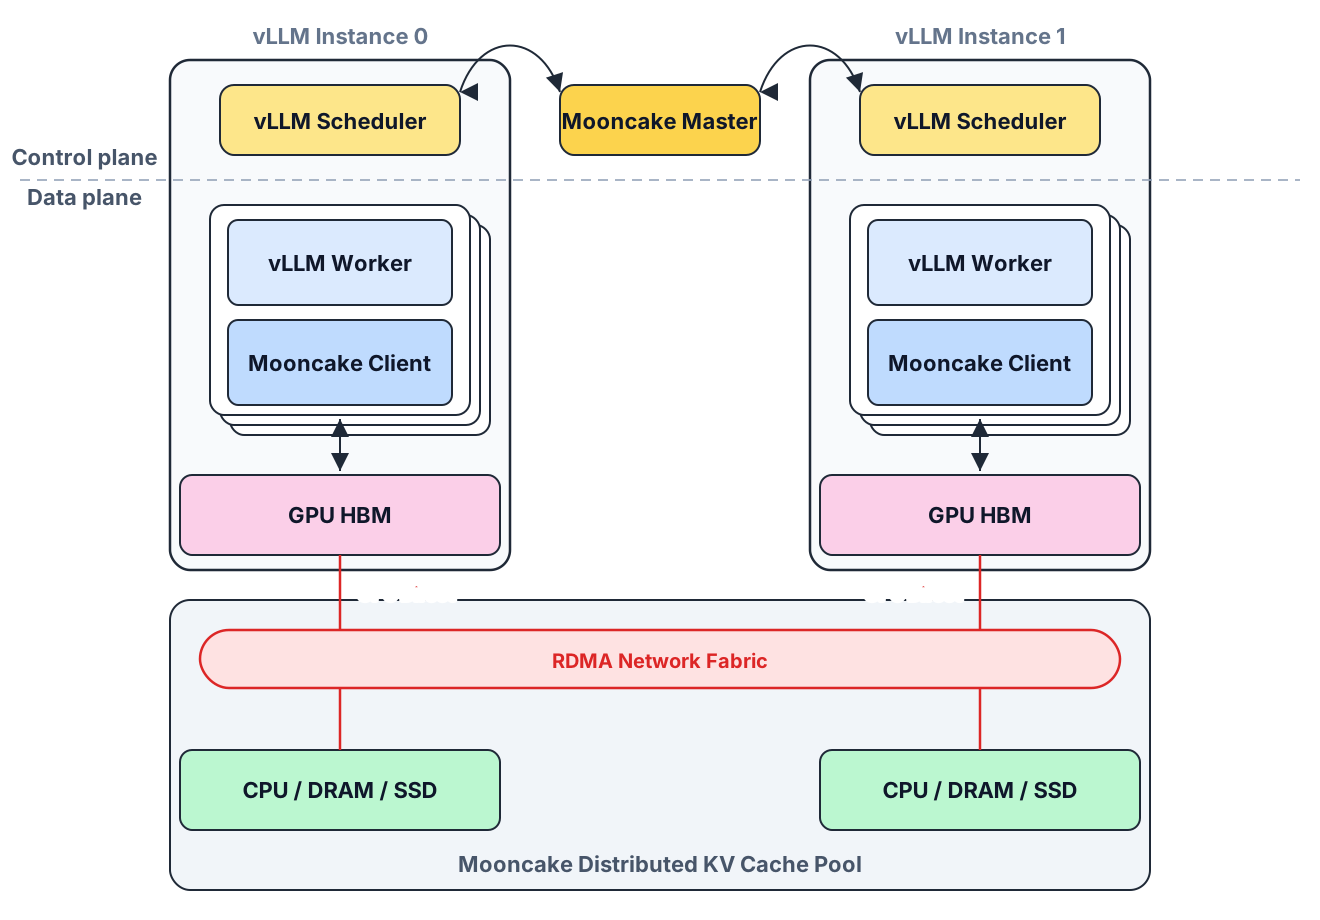
图 2:多个 vLLM 实例嵌入 Mooncake client,并共享一个由 master 管理元数据、worker 提供 DRAM/SSD 资源的 KV pool。vLLM scheduler 先查 prefix 命中,GPU worker 再通过 Mooncake client 搬运 KV block。来源:vLLM 官方博客。
源码里最能说明设计意图的是三段逻辑。第一,MooncakeStoreScheduler.get_num_new_matched_tokens() 会把请求的 token 长度按 block 对齐,使用 LookupKeyClient 通过 ZMQ IPC 向本 worker rank 0 的 LookupKeyServer 查询外部命中 token 数[3]。查询结果如果超过本地已计算 token,scheduler 就生成 LoadSpec,让后续 block allocation 为外部 KV 预留位置。
第二,Store 的 key 采用 PoolKey 拼出的结构化字符串,而非原始 prompt 文本:model_name、TP rank、PCP/DCP rank、PP rank,再加 block hash[4]。这个 key 设计有两个效果:相同 token block 在同一模型和并行切分下可以去重;同时 TP/PP 维度不会互相污染,因为不同 rank 的 KV 分片本来就不是同一份数据。
第三,lookup 不是只查当前 rank 的 key。MooncakeStoreWorker.lookup() 会扩展出所有相关 TP rank 和 PP rank 的 key,调用 batch_is_exist(),然后找到第一段不完整的 block,把“连续可用 prefix”返回给 scheduler[5]。这和普通 KV object store 的随机命中不同,vLLM 需要的是从 token 0 开始连续命中的前缀,否则 attention 不能直接跳过中间缺口。
三、worker 数据路径:后台线程把 KV block 当作 RDMA buffer 搬运
MooncakeStoreWorker 初始化时从 MOONCAKE_CONFIG_PATH 读取 metadata server、master 地址、global segment size、local buffer size、protocol 和 RDMA device,然后创建 MooncakeDistributedStore 并执行 setup()[6]。使用方式上,单机扩容可以设 kv_role=kv_both;PD 分离场景下则通过 MultiConnector 同时挂载原有 MooncakeConnector 和新的 MooncakeStoreConnector。
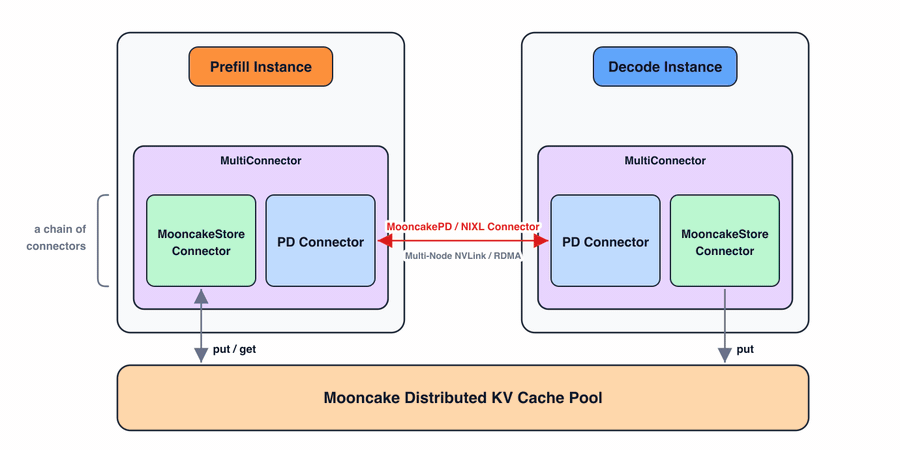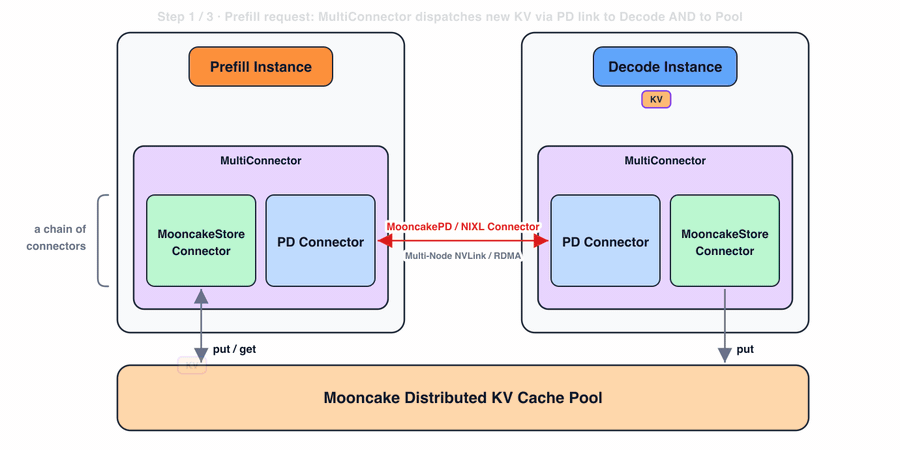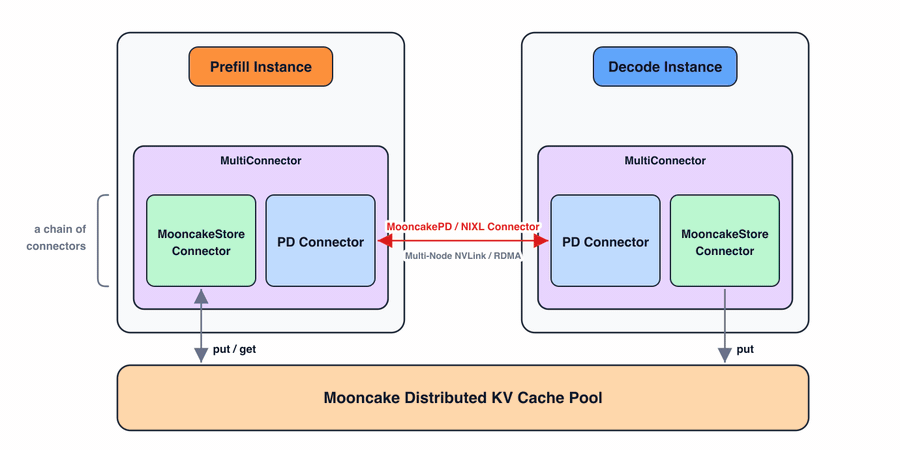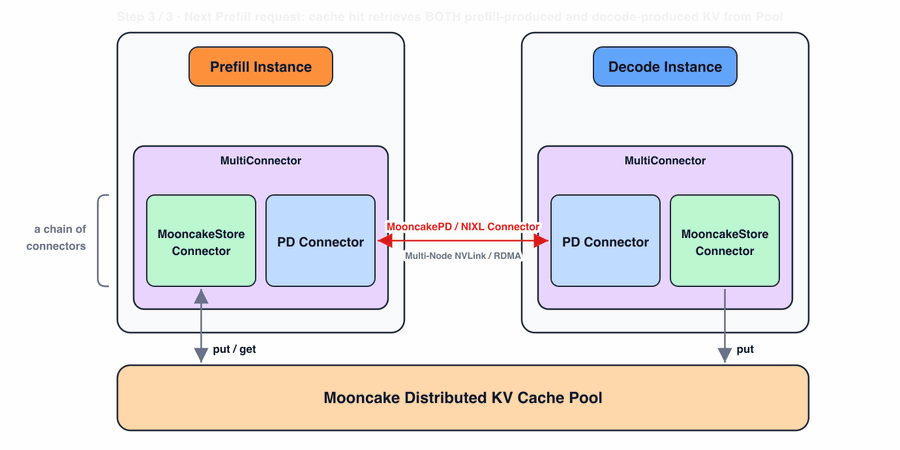
图 3:MultiConnector 让 PD 的点对点 KV 传输和 Store 的共享 prefix cache 并行存在。当前路径中,prefill 侧负责从 Store 读取命中 prefix,再通过 PD connector 把 KV 交给 decode。来源:vLLM 官方博客。
这里有一个容易被博客图简化掉的细节:Store connector 并没有在每层 attention 后同步做 I/O。start_load_kv() 和 wait_for_save() 都是 no-op,真正的 I/O 在 get_finished() 中排队。源码注释明确写着,所有 load/store 都在模型 compute 已经发射到 compute stream 之后发出,以增加 compute 与 I/O overlap[5]。保存路径还会记录一个 CUDA event,后台发送线程在 put 前同步这个 event,避免读到尚未完成写入的 GPU KV。
KV cache 注册也很工程化。vLLM 不同 attention backend 的 KV layout 不同:FlashAttention/ROCm 常见 K/V 维度在外层,FlashInfer/MLA 常见 block 在外层。register_kv_caches() 用 stride 推断 page size 和外层 segment,把每个 layer 的 KV storage 注册给 Mooncake,并把每个 block 的 base address 与 size 写入 ChunkedTokenDatabase[5]。后续 prepare_value() 只需要知道 token range 和 block id,就能算出要交给 Mooncake 的地址列表。
保存线程 KVCacheStoreSendingThread 会先按 block hash 生成 key,再按 TP rank 做 striding,避免每个 TP rank 都写同一批对象。写之前调用 batch_is_exist() 做去重,只把 missing block 送进 batch_put_from_multi_buffers()。加载线程则按 key 列表调用 batch_get_into_multi_buffers(),直接把 Store 中的 KV block 写入本地 GPU cache 对应地址[5]。
这解释了博客强调的 “SM-free / zero-copy” 路径。vLLM 侧提供的是已经注册过的 GPU KV cache address,Mooncake 侧用 RDMA/GPUDirect 能力搬运这些 buffer;CPU 负责发起 descriptor 和查询元数据,GPU SM 不需要执行 copy kernel。换言之,prefill/decode compute 不必为 KV offload 让出 SM 时间。
四、Mooncake Store:对象语义包住 Transfer Engine
Mooncake Store 对 vLLM 暴露的是 Python binding,但底层仍是 C++ RealClient。store_py.cpp 把 register_buffer、batch_is_exist、batch_put_from_multi_buffers、batch_get_into_multi_buffers 这些接口绑定到 Python,并在调用时释放 GIL[7]。这正好对应 vLLM worker 的后台线程模型:Python 线程负责排队和调度,重 I/O 落在 C++ 客户端。
RealClient.register_buffer() 最终调用 transfer engine 的 RegisterLocalMemory(),并在本地记录已注册 buffer 的范围;batch_get_into_multi_buffers_internal() 会先 BatchQuery() 对象元数据,拿到 replica 描述,再把目标 GPU buffer 切成 slices,交给 BatchGet();batch_put_from_multi_buffers_internal() 则把多个 buffer slice 组装后交给 BatchPut()[8]。
master 侧负责的是对象生命周期。PutStart() 会检查 key 是否已存在,按 ReplicateConfig 分配 replica,并把 metadata 插入 shard;GetReplicaList 会给对象授予 lease,防止客户端读取期间被删除或驱逐[9]。这让 KV block 在 Store 中具备了传统分布式对象存储的几项能力:元数据查询、replica 描述、lease 保护、容量压力下的 eviction。
更底层的 Transfer Engine 通过 MultiTransport 把 transfer request 按协议选择到 RDMA、TCP、NVMe-oF、CXL、NVLink 等 transport;常规 RDMA 路径会安装 RdmaTransport,批量请求则以 batch id 组织,再异步查询 batch status[10]。博客中提到的 multi-NIC pooling 和 topology-aware path selection,就属于这一层的能力,而不是 vLLM connector 自己实现的网络调度。
当前 vLLM PR 的配置面主要把 Store 当作 CPU/DRAM pool 来用:global_segment_size 表示每 GPU 贡献给分布式池的内存,local_buffer_size 是本地操作 buffer,protocol 可以选 rdma 或 tcp。Mooncake 主仓已有 disk replica、local disk、offload-on-evict 等代码路径,但 vLLM 博客把 distributed disk offloading 放在后续计划中[1]。因此,读这组 benchmark 时应把它理解为“分布式 DRAM/RDMA KV pool 的结果”,不要提前外推到 NVMe 分层后的表现。
五、性能收益来自 hit rate,也来自调度假设改变
博客的核心实验使用 Kimi-2.5 NVFP4 模型和 GB200 节点,PD 配置为 prefill TP4、decode DP8 + EP。在真实 Codex agentic traces 上,1P1D 共 12 张 GB200 GPU 的部署中,分布式 KV cache pool 把 cache hit rate 从 1.7% 提升到 92.2%,吞吐提升 3.8x,P50 TTFT 降低 46x,端到端延迟降低 8.6x[1]。
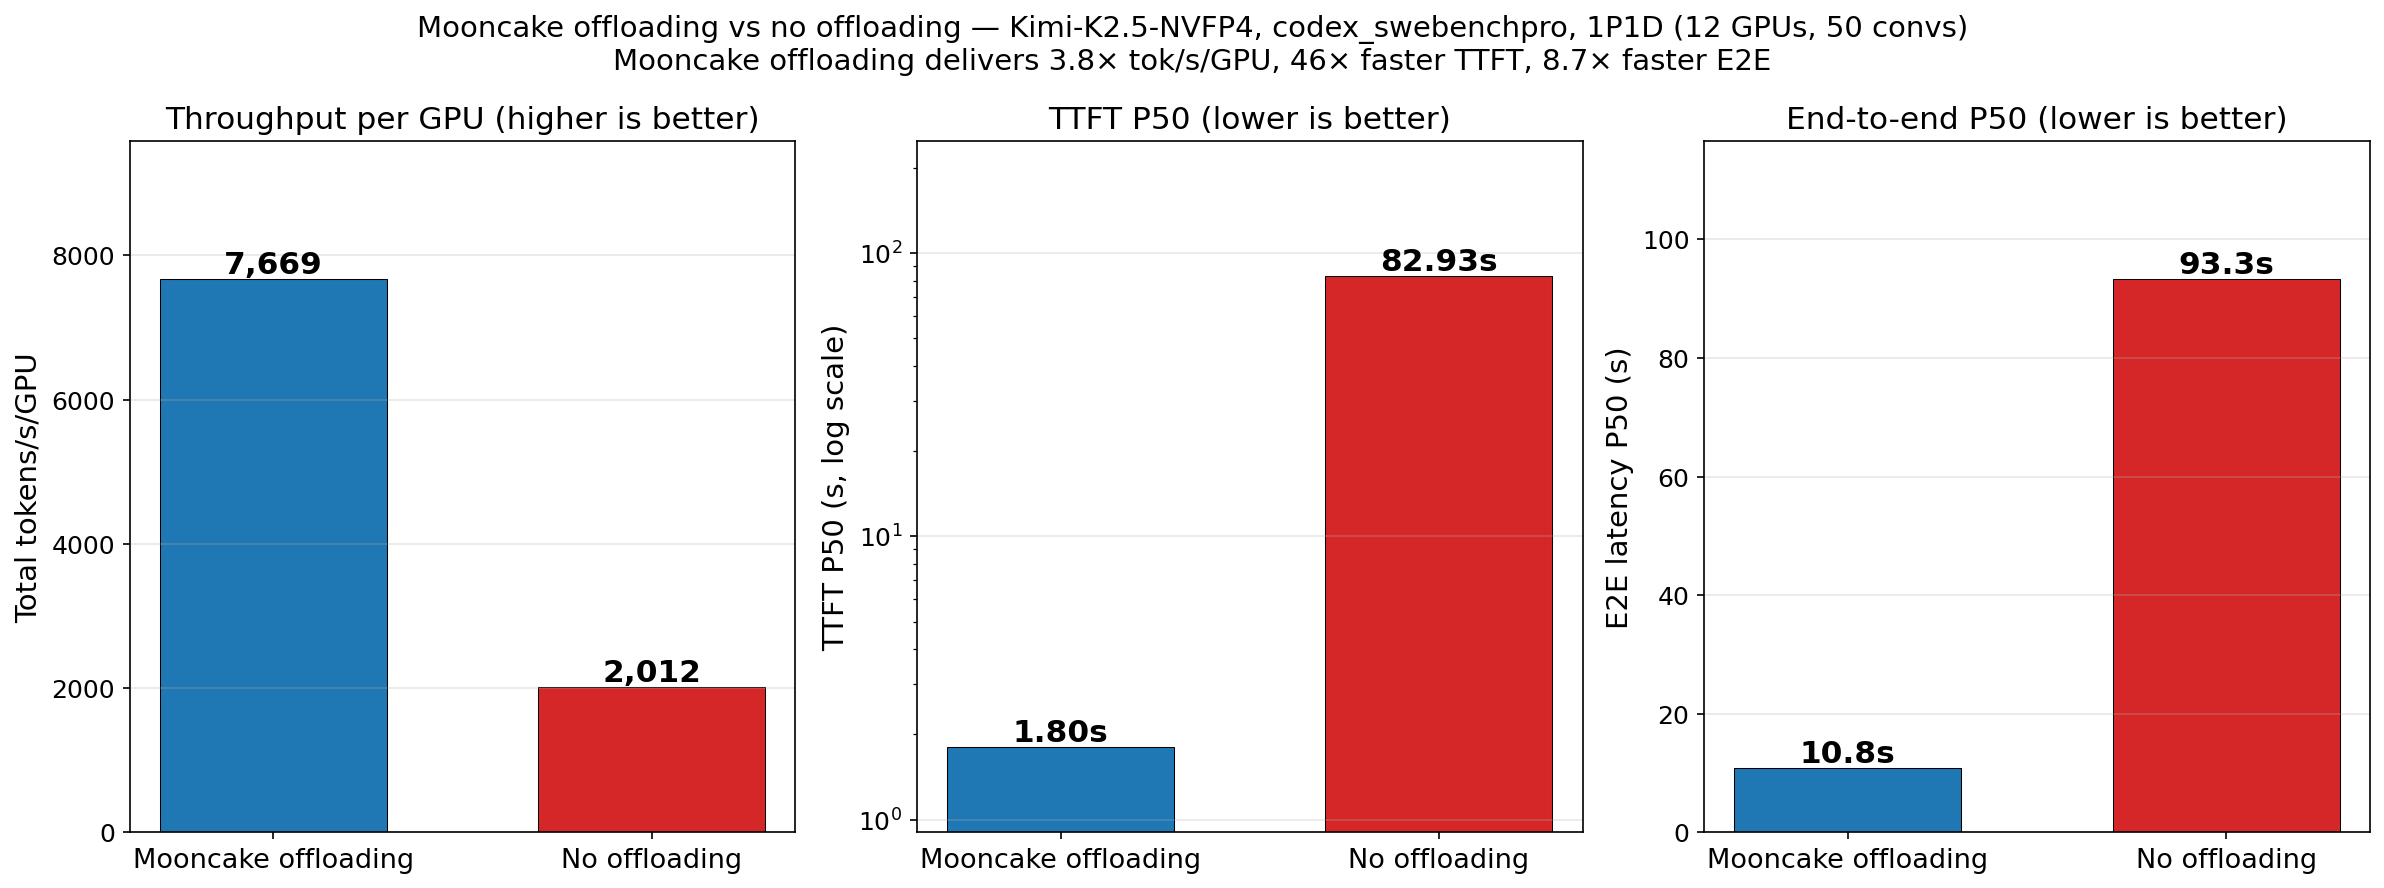
图 4:这组实验的关键是几乎整个历史 prefix 都能跨实例命中;单次 RDMA copy 速度只是其中一环。命中率从 1.7% 到 92.2%,才会放大成 46x P50 TTFT 改善。来源:vLLM 官方博客。
这个结果有一个清晰的因果链。Agentic 请求的绝大部分输入 token 属于历史前缀,scheduler 能在执行前知道哪些 block hash 已在 Store 中,worker 能把这些 block 直接拉进本地 KV cache,于是 prefill 只需要处理新增 delta。TTFT 对 prefill 成本极其敏感,所以命中率提升会直接变成 TTFT 改善;吞吐和端到端延迟的收益则来自 GPU 少做重复 prefill,以及 round-robin 或迁移时不再全量 miss。
扩展实验更能说明 Store 的价值边界。博客使用从 Codex workload 派生的合成数据,把 12 GPU 扩到 60 GPU,并故意使用 round-robin routing 施加跨节点访问压力;Mooncake Store 在所有规模下保持 95% 以上 hit rate,并近似线性扩展[1]。这组数字说明共享 KV pool 正在替代“尽量把同一 session 粘在同一实例”的隐性要求。
但源码也暴露了几个边界。第一,MultiConnector 当前只从第一个声明有命中的 connector 加载 KV,但会向所有 connector 保存;PD 场景里 decode 当前并不直接从分布式池读取,而是由 prefill 侧加载后再通过 PD connector 交给 decode[11]。第二,MooncakeStoreWorker.get_finished() 里直接 assert load_async 为 true,这条路径默认依赖异步重叠。第三,Store 保存线程在 Mooncake 返回 NO_AVAILABLE_HANDLE 时会进入压力保护,跳过后续 store batch,说明容量和 handle 管理仍会影响 hit rate 稳定性。
这些边界不削弱这项工作的价值,反而说明它仍处在一个很典型的工程落地阶段:先把共享 prefix cache 接入 vLLM 主路径,证明真实 agentic traces 上收益巨大;再继续做多路径加载、cache-aware routing、磁盘分层和 hybrid model 支持。博客最后列出的 next steps 与源码里已经存在但尚未完全暴露到 vLLM 配置面的 Store 能力,基本对应同一条路线。
六、结论
vLLM x Mooncake Store 的关键判断,是 agentic serving 不能继续把 KV cache 当成单个 replica 的内部状态。只要请求会跨 turn、跨实例、跨节点迁移,prefix cache 就需要从“本地命中技巧”升级为“集群可寻址的数据层”。vLLM 侧的 MooncakeStoreConnector 解决调度接入、block hash key 和 worker I/O 编排;Mooncake 侧的 master、RealClient 与 Transfer Engine 则提供元数据、lease、replica 和 RDMA 数据搬运。
这条路线最适合长上下文、多轮、共享前缀极高的 agentic workload。短 prompt、高 decode 占比、prefix 重用低的在线聊天,不会自然得到同等收益;Mooncake Store 还会引入额外的元数据查询、内存注册、后台线程和容量管理复杂度。真正需要追的开放问题,是 router、scheduler 和 KV pool 能否协同:优先命中本地 cache,必要时走分布式池,最后再重新 prefill。这个分层策略成熟之后,KV cache 才会从推理框架内部结构,真正变成 AI serving 的共享基础设施。
参考资料
[1] Serving Agentic Workloads at Scale with vLLM x Mooncake
[2] vLLM PR #40900: Add MooncakeStoreConnector for KV cache offloading via Mooncake distributed store
[3] vLLM MooncakeStoreScheduler source, commit 0d5c2e0
[4] vLLM Mooncake Store data structures source, commit 0d5c2e0
[5] vLLM MooncakeStoreWorker source, commit 0d5c2e0
[6] vLLM MooncakeStoreConnector usage guide, commit 0d5c2e0
[7] Mooncake Python Store binding source, commit 43ce0f8
[8] Mooncake RealClient source, commit 43ce0f8
[9] Mooncake MasterService source, commit 43ce0f8
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。