版本声明:本文调研截至 2026 年 4 月 21 日,基于各仓库最新 open PR 和 merged commit;社区进展较快,具体数字以各框架官方实测为准。
TurboQuant 论文(ICLR 2026)在 2025 年 4 月发布时,Google 团队给出了一个漂亮的实验结果:KV Cache 压到 3.5 bit 时质量几乎中立,2.5 bit 时仅有轻微下降,needle-in-a-haystack 任务达到接近完美的下游准确率,同时把内存压缩 6 倍,在 H100 上 attention logits 计算最高提速 8 倍[1]。这篇论文之所以值得认真看,不是因为它提出了一套新的量化技巧,而是它从理论上证明了:高维向量压缩的 distortion rate 可以接近信息论下界——这个结论对整个 LLM 推理基础设施都有深远影响。
然而,把论文里的算法做成生产级实现,要解决的问题远比理论证明复杂得多。KV Cache 量化不同于普通权重量化,它发生在推理的每个 token、每一层 attention 计算的 hot path 上,任何解压缩开销都会直接拖慢生成吞吐量。更麻烦的是,不同推理框架在 attention 后端、内存布局、kernel 调度上选择了完全不同的技术路线,导致同样的 TurboQuant 算法在每个框架里实际上变成了不同的「重新实现」。本文的目的就是梳理这三个主流框架目前各自走到了哪里,以及背后的工程判断。
一、TurboQuant 的核心设计:为什么它能在极低 bit 下保持质量
理解各框架的工程路线之前,需要先把 TurboQuant 的算法思路理清楚,否则后续的技术决策讨论会失去依据。
TurboQuant 解决的是「高维向量量化后内积估计会偏移」这个问题[2]。传统向量量化(比如常见的 product quantization 或 per-tensor scaling)对每个维度独立做标量量化,然后用 codebook 查表重建。问题在于,这种方案在低 bit 时会引入系统性偏差(bias)——压缩后的向量内积,不再是原始向量内积的无偏估计。这个偏差在高维 attention 计算里会逐层累积,最终导致模型行为偏离。
TurboQuant 的解法是两段式结构。第一步,先对向量做随机旋转(Walsh-Hadamard Transform,WHT),把数据映射到一个统计性质更可控的空间;旋转后每个坐标近似独立且服从集中分布,此时用最优标量量化器对每个坐标独立压缩,可以抓住向量的主体信息。第二步,针对第一步残差(reconstruction error)里的内积偏差,用 QJL(Quantized Johnson-Lindenstrauss)算法专门处理——QJL 只用 1 bit 存储残差,但它保证了压缩后的内积估计是无偏的[3]。
换句话说,TurboQuant 把「信息主体压缩」和「残差偏差修正」分开处理:主体信息用极低 bit 的高质量标量量化,残差再用 1 bit 的 QJL 专门消除 bias。这套两段式设计是 Google 论文的理论核心,也是各框架在工程实现时最难复现的部分——因为 WHT 旋转需要在每个 token 生成时实时应用,而 QJL 的无偏性保证依赖随机映射的正确实现,两者缺一不可。
还有一个值得注意的点:TurboQuant 是完全 data-oblivious 的,不需要对特定数据集做 calibration 或 fine-tuning。这对于生产环境极其重要,因为线上推理的输入分布五花八门,任何依赖预设分布的量化方案都可能失效。
二、KV Cache 量化方案全景:谁在做什么
在进入各框架的具体实现之前,有必要先把当前主流的几种 KV Cache 压缩方案做一个横向对比,因为后续讨论的技术路线差异,本质上都源于对不同压缩方案的选择。
2.1 FP8 / FP4 KV Cache:硬件原生的捷径
FP8 和 FP4 KV Cache 是最容易理解的方案——直接用 NVIDIA Hopper 或 Blackwell 硬件支持的原生浮点格式存储 K 和 V。FP8(e4m3fn)在 8 bit 精度下提供接近 BF16 的质量,压缩比 4x;FP4(nvfp4)更进一步压到 4 bit 但需要特殊的容器格式和量化参数管理。
TRT-LLM 是这条路线走得最深的框架。他们在 PR #12544 中引入了 NVFP4 KV Cache 支持,container_dim 设计为 head_dim / 2(每两个元素打包成一个 byte),另外单独存储 float8_e4m3fn 的 per-16 元素 scale[4]。这套方案的优点是实现相对简单、硬件原生支持、反量化开销极低;缺点是 4 bit 对 KV Cache 来说仍然比较粗糙,而且在 MLA(Multi-head Latent Attention)架构下还需要额外的 BF16 fallback 池来处理残差精度问题(PR #13068 正在处理这个)[5]。
2.2 KIVI:2 bit 量化 + 细粒度 scale 的工程实践
KIVI(K-Level Inline Vector Quantization)是最早被大规模采用的 KV Cache 量化方案之一,也因此成为 Google 论文里的主要对比基线[6]。KIVI 的核心思路是对 K 和 V 分开处理:K 保留较多 bit(通常 2 bit)用于精确的位置匹配,V 则用更激进的 2 bit 存储。关键工程贡献在于它引入了细粒度的 per-token-head scale,避免了全局 scale 带来的过度量化。
KIVI 的主要局限是它仍然依赖显式的反量化步骤——读取压缩数据后需要先解压缩再参与 attention 计算,这个反量化开销在 decode 阶段会成为一个不可忽视的瓶颈。
2.3 TurboQuant:理论最优的压缩框架
TurboQuant 在 3.5 bit 配置下可以实现「质量无损失真」,这意味着在相同的压缩率下它比 KIVI 和 FP8 方案效果更好;或者说,在相同的质量水平下它可以压得更狠。Google 的实验数据显示,在 LongBench 的聚合评测中,TurboQuant 的 dot product distortion 和 recall 均优于 KIVI 基线[1]。
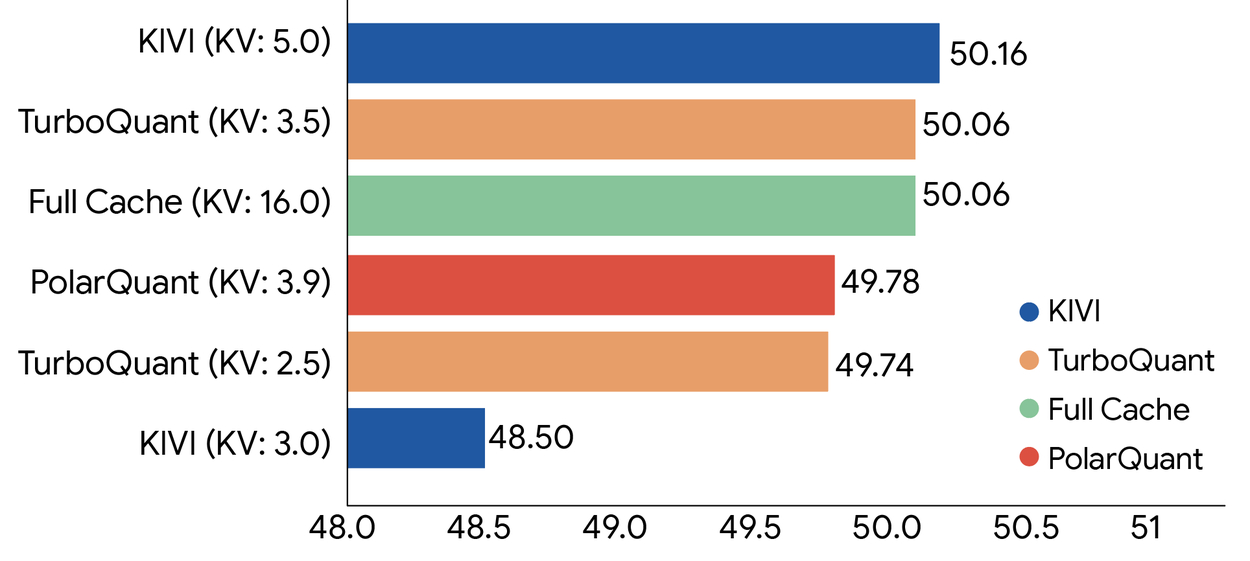
图 1:TurboQuant 在 LongBench 基准测试中相对于 KIVI 等基线的表现。配置为 Llama-3.1-8B-Instruct,bit-width 标注在方法名后。来源:Google Research Blog。
然而这个理论优势是有代价的:TurboQuant 的压缩流程包含 WHT 旋转 + 标量量化 + QJL 残差处理,比简单的浮点格式转换复杂得多。如果解压缩开销控制不好,省下来的内存带宽收益可能被额外的计算抵消。这正是三个框架在实现时最花功夫的地方。
三、vLLM:两条腿走路,CUDA 和 ROCm 分头优化
vLLM 的 TurboQuant 实现走的是一条务实的路线:不追求一步到位,而是在 CUDA 和 ROCm 两条线上分别推进,同时通过环境变量控制 kernel 分发,保持向后兼容。
3.1 v1 decode kernel:稳定的基线
vLLM 当前的 v1 TurboQuant decode kernel 已经在 ROCm(AMD MI300X)上完成集成并通过了 48 个 accuracy 测试用例[7]。v1 的核心设计遵循了 vLLM 一贯的 attention backend 架构,将 TurboQuant 作为一种可插拔的 KVCacheDtype 对接进 FlashAttention 后端。kernel 本身采用 Triton 实现,主要挑战在于:
WHT 旋转与 quantize 的融合。v1 把 WHT 旋转融合进了量化 kernel,这样在写入 KV Cache 之前只需要一次 kernel launch 就能完成旋转和量化,而不是分开调用旋转 kernel 再调用量化 kernel。这是控制 overhead 的关键。
CUDA Graph 兼容性。decode 阶段是 batched 推理的性能热点,vLLM 需要用 CUDA Graph 捕获计算图来减少 kernel launch overhead。v1 在设计时已经确保了所有 tensor shape 和 grid 维度在 CUDA Graph 捕获时是固定的,不会出现 replay 时的 shape mismatch。
3.2 v2 decode kernel:FLUTE 风格优化,面向带宽瓶颈
v2 的出现是因为 v1 的设计出发点是「正确性」,而 v2 要解决的是「性能」[7]。v2 的核心优化有三:
分组 Q head(Grouped Q heads)。把多个 Q head 打包在一起处理,提高 vectorization 程度,减少指令发射 overhead。
向量化的 pair LUT(Vectorized pair LUTs)。TurboQuant 的解量化需要查表操作(codebook lookup),v2 用向量化的方式访问 LUT,相比 v1 的标量查表可以更好地利用 memory coalescing。
exp2 缩放。用 2 的幂次缩放替代原有的浮点乘除,降低了计算复杂度和硬件实现门槛。
但 v2 的 PR 也暴露了一个典型的工程困境:v2 最初用了 occupancy heuristic 来动态决定 NUM_KV_SPLITS(KV split 的数量),导致 grid size 在不同输入长度下不固定——这在 vLLM 的 CUDA Graph 捕获流程里是不允许的。reviewer 明确指出「vLLM’s V1 attention backend requires fixed grid dimensions for CUDA graph capture and replay」,要求 v2 必须改用固定 grid 尺寸或接受预分配的 buffer。这条 review 评论实际上揭示了一个 vLLM 内部的长期矛盾:想要极致的性能优化(动态调度)和想要 CUDA Graph 兼容(静态调度)之间存在根本冲突,而 v2 最后选择了后者。
3.3 平台差异的深层处理
v2 在被 reviewer 指出 torch.cuda.get_device_capability() 调用缺少 current_platform.is_cuda_alike() 保护后,添加了 ROCm 平台的 guard,并在 num_stages 参数上做了平台差异化处理(ROCm 用 num_stages=1,CUDA 默认用 2)——这是 AMD ROCm 在 vLLM 生态里长期被当二等公民对待后逐渐完善的痕迹。对于国内使用 AMD GPU 推理的团队来说,这条 ROCm 线实际上是一个值得关注的生产路径。
四、SGLang:Triton fusion 优先,极致压缩但 prefill 代价明显
SGLang 是三个框架里 TurboQuant 实现最具进攻性的一个。PR #23135 的描述本身就很有冲击力:在 H200 单卡上,TurboQuant 4-bit uniform(tq4u)模式下 KV Cache 内存从 131,072 bytes/token 压到 33,792 bytes/token,压缩比 3.88x,decode 阶段(32→1024 tokens)吞吐量达到 bf16 基线的 105%[8]。
4.1 融合 Triton kernel:消除反量化 overhead
SGLang 的核心工程决策和 vLLM 一样指向了 fusion——但 SGLang 走得比 vLLM 更彻底。Decode 阶段用的是 fused turboquant_decode_attention kernel,它直接从压缩后的 packed 4-bit KV pool 读取数据,在 kernel 内部完成解量化 + split dot product,完全跳过了「把压缩数据先解压到临时 buffer 再参与 attention」这个在 vLLM v1 里仍然存在的中间步骤。
Extend(prefill)阶段同理,turboquant_extend_attention 也是 fused kernel。SGLang 声称这两个 kernel 都支持完整的 CUDA Graph——这和 vLLM v2 遇到的 grid 固定化问题形成了有趣的对比,说明 SGLang 在 kernel 设计时从一开始就考虑了 CUDA Graph 的限制。
4.2 WHT 旋转的融合策略:weight absorption
WHT 旋转的时机选择是 TurboQuant 实现里最微妙的设计决策之一。正向旋转发生在写入 KV Cache 之前,逆向旋转(即把旋转的影响从 attention output 中消除)可以有两个时机:读取 KV Cache 时做实时逆旋转,或者在模型权重里 baked-in 逆旋转。
SGLang 选择了后者——W_O weight absorption:在初始化时把逆 WHT 旋转融合进 o_proj 权重,这样在 inference 时就完全省去了逆旋转的开销,只需要在 KV 写入时做一次正向旋转 + 量化即可。这个选择节省了大量的运行时计算,但需要修改模型权重初始化流程,在 vLLM 看来这可能是一个破坏性更大的改动。
reviewer 在 PR 里也发现了一个 sign vector 顺序错误:正向旋转是 D2 @ H @ D1 @ Q,逆旋转融合进 o_proj 时必须应用 D1 @ H @ D2,而原代码用了 signs1 然后 signs2——对应的是正向旋转而非逆旋转。这个 bug 会导致 attention 输出错误,好在 reviewer 在代码审查里发现了这个问题。
4.3 两种解量化模式:codebook vs. uniform
SGLang PR 里提到了两种解量化路径:
Codebook 模式(tq4):用 Lloyd-Max 最优 codebook 做解量化,需要 15 次 tl.where 查表。这个方案理论质量更高,但每次解量化都需要多次条件分支。
Uniform 模式(tq4u):用线性等距的 centroids,解量化只需要 1 次 FMA(idx * step + c0),完全消除了 codebook 查表的分支开销。结果是 decode 阶段 tq4u 比 tq4 快约 15%——这对 decode 阶段至关重要。
从 accuracy 数据看,两种模式在 GSM8K 和 MMLU 上几乎没有差距:bf16 79.2%,tq4 78.6%,tq4u 79.3%[8]。这说明在 4-bit 这个精度下,uniform 量化带来的质损几乎可以忽略,但性能收益是实在的。
4.4 当前瓶颈:prefill 性能仍是短板
SGLang 的数字最能说明问题——D3(纯 decode,32→1024)时 tq4u 可以达到 bf16 的 105%,但 P5(纯 prefill,4096→1)时只剩下 bf16 的 64%。prefill 性能低主要是因为 WHT 旋转 + 量化的 kernel 开销在长序列上成为了主要瓶颈,而 prefill 阶段本身就是 memory-bandwidth bound 的,额外一次旋转/量化操作会直接拉高访存延迟。
更尴尬的是,FA3(FlashAttention-3)是 Hopper 架构上 prefill 性能最优的后端,但 TQ 的 fused kernel 目前只能路由到 Triton——FA3 的 extend 路径会尝试读取 bf16 KV buffer,导致 NotImplementedError。PR 里的 reviewer 也指出了 Triton kernel 里存在 NaN 传播风险(当一行全是 masked token 时 softmax 局部最大值为 -inf 导致后续 exp 计算出错)和潜在的除零问题(当 split 内没有有效 token 时 e_sum=0 导致除零)[8]。
这意味着 SGLang 的 TurboQuant 在当前的 workload 分布下(decode-heavy 场景,比如 chat)收益明确,但在一个 prefill-heavy 的场景(比如长文档 summarization)里,性能反而可能低于 bf16。
4.5 不对称 K/V 位宽:一个新的自由度
PR 里还提到了一个在论文里没有强调的实验方向:K 用 4 bit,V 用 2 bit 的不对称量化(turboquant_k4v2)。这个组合在理论上是有依据的——K 主要用于路由匹配,对精度更敏感;V 主要用于值的加权平均,一定程度的信息损失对最终输出的影响更小。如果这个不对称配置能够保持质量不崩溃,就意味着可以把压缩率再往上推一层。
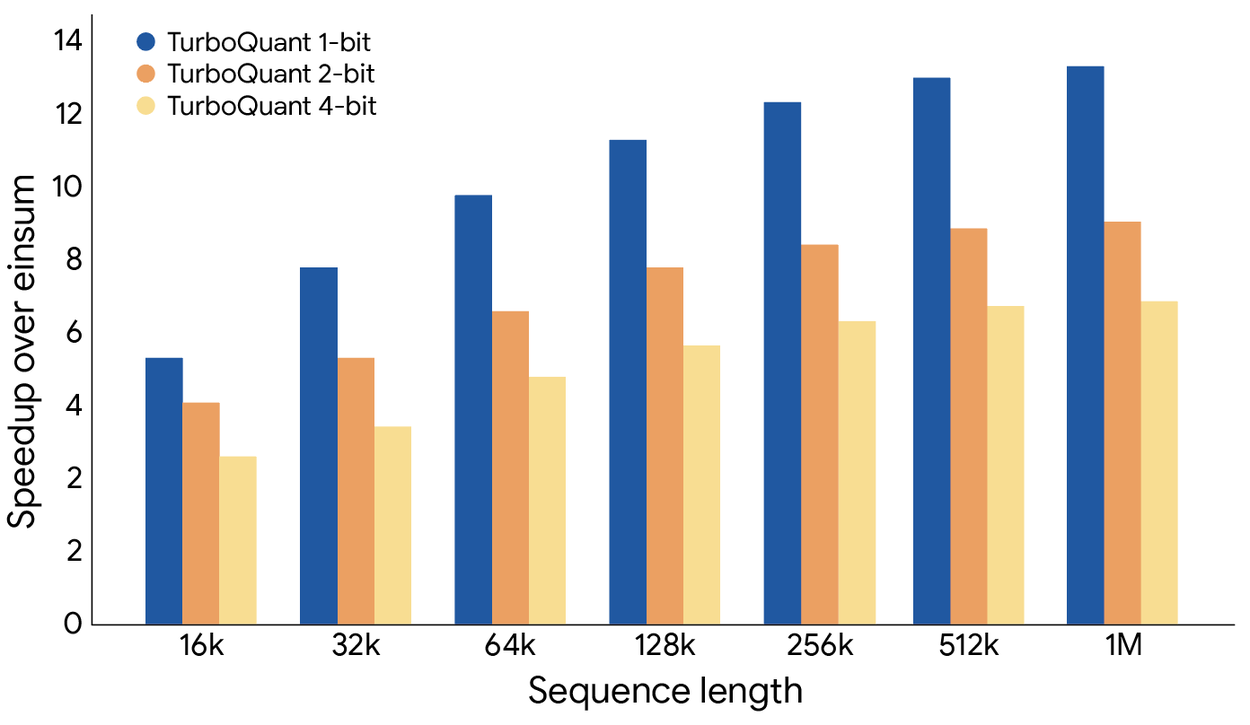
图 2:TurboQuant 在 H100 GPU 上相对于 JAX baseline 的 attention logits 计算加速比。4-bit TurboQuant 最高达到 8x 加速。来源:Google Research Blog。
五、TRT-LLM:硬件层面的原生支持,但 TurboQuant 本身尚未出现
TRT-LLM 的 KV Cache 压缩策略和前两个框架有一个根本区别:它目前走的是 FP8/FP4 原生浮点格式,而不是 TurboQuant 的 WHT+标量量化路线。NVFP4 KV Cache 支持(PR #12544)和 dual-pool SWA 架构(PR #12813)是 TRT-LLM 近期最活跃的两条 KV 相关 PR 线[4][5]。
5.1 NVFP4 的设计选择
FP4 在存储侧每两个元素打包成一个 byte,scale 单独用 float8e4m3fn 存储在另一个 pool 里。这个 design 和 SGLang 的 uniform 4-bit 量化思路相近——都用线性量化器而非 codebook,差异在于 TRT-LLM 直接用了 NVIDIA 的硬件原生格式而不是自己定义量化方案。
TRT-LLM 在 PR #13181 里修了一个有意思的 bug:KV cache quantization config 会错误泄漏到 vision encoder(多模态模型里)。当 disable_quantization=True 时,vision encoder 应该得到一个空的 QuantConfig() 而不是继承 LLM 的 KV cache 量化设置。这说明 TRT-LLM 的 quantization 配置系统需要管理多模态架构里不同模块的量化策略差异——这对 vLLM 和 SGLang 来说暂时还不是问题,因为它们的多模态支持更有限。
5.2 DeepSeek MLA + FP4 的特殊处理
PR #13068 提出了一个针对 DeepSeek-V3 架构的特殊问题:DeepSeek 用的是 Multi-head Latent Attention(MLA),其 KV cache 构造和标准 MHA 不同。在 FP4 量化下,残差精度损失会影响 MLA 的kv norm 计算,所以这个 PR 提议为 MLA FP4 模型单独分配一个 BF16 的 KV pool 来存储最近几个 token 的全精度表示,作为 FP4 的「高精度残差补救」[5]。
这个 design 和 TurboQuant 的 QJL 残差修正思路在精神上是一致的,但实现方式完全不同——TurboQuant 用 1-bit QJL 做无偏估计修正,而 TRT-LLM 选择了「直接保留一小部分 BF16 全精度数据」。哪种方案在工程上更简单、在理论上更严格,是后续值得持续关注的问题。
5.3 为何 TRT-LLM 暂时没有 TurboQuant
从 PR 列表看,TRT-LLM 近期没有 TurboQuant 的明确实现计划,这背后有一个合理的原因:TurboQuant 的 WHT 旋转需要在线计算,而 TRT-LLM 的核心是 pre-compiled TRT engine——所有计算图结构在 build 时就已经确定。如果 TurboQuant 的量化参数(比如 WHT sign pattern)需要在运行时动态生成,就会和 TRT 的 static graph 假设产生冲突。这不是说 TRT-LLM 永远无法支持 TurboQuant,而是它可能需要等待 Google 论文里的量化方案更成熟、sign pattern 可以被固定下来之后再考虑。
六、三个框架的路线图对比与本质矛盾
6.1 技术路线的分叉点
| 维度 | vLLM | SGLang | TRT-LLM |
|---|---|---|---|
| 核心 kernel 技术 | Triton(CUDA/ROCm 双线) | Triton fusion(Triton-only) | C++/CUDA 原生 |
| 量化方案 | TurboQuant(WHT+标量+QJL) | TurboQuant(相同方案,更激进的 fusion) | FP8/FP4 原生浮点格式 |
| Prefill 策略 | 跟随 FA3 后端 | 路由到 Triton,不支持 FA3 | 编译期优化 |
| CUDA Graph | v2 修复中(v1 稳定) | 声称完整支持 | 成熟(TRT 本身就是 static graph) |
| 多模态支持 | 基础 | 基础 | 正在修 quantization 泄漏问题 |
| AMD ROCm | 积极推进(v1+v2) | 未见明确 ROCm 线 | 未知 |
6.2 fusion 的边界在哪里
三个框架都在追求「更 fusion」的方向,但 fusion 本身是一把双刃剑。把 WHT 旋转融合进量化 kernel 省了一次内存访问,但如果 kernel 变得太大,注册压力上升,反而可能降低 occupancy 导致更差的并行度。SGLang 自己在 PR 里也承认了 BLOCK_N=16 这个 tuning 参数是在「寄存器压力」和「并行度」之间做权衡的结果。
更深层的矛盾在于「通用性」和「极致性能」的冲突。SGLang 的 fused Triton kernel 在 H200 上跑出了漂亮的数字,但它是专门针对 H200 的 SM 架构参数调的,换到 A100 或其他 GPU 可能表现完全不同。vLLM 走得更保守一些,但这意味着它在特定硬件上可能永远跑不过 SGLang 的激进方案。
6.3 理论最优 vs. 工程可行
TurboQuant 的论文贡献本质上是一个理论结果:near-optimal distortion rate within a constant factor (~2.7) of the theoretical lower bound。[2] 这个结论告诉我们在信息论层面这件事的上限在哪里,但工程实现的关注点是这个上限在特定硬件、特定 latency/throughput 权衡下能不能接近。
Google 的 8x attention logits 加速数字是在「JAX baseline」的对照下测出来的,而 JAX 本身是一个高度优化的框架,这个加速比能不能迁移到 vLLM/SGLang/TRT-LLM 的实际推理场景里,目前还没有公开的端到端数据来确认。
七、开放问题与值得跟踪的方向
问题一:prefill 性能短板何时能被解决。 SGLang 的 TQ 在 decode 场景下已经可以做到 105% 的 bf16 吞吐量,但 prefill 性能仍然只有 bf16 的 64%。这对于「prefill-heavy + long context」场景是个明显的障碍。一个可能的路径是把 WHT 旋转的 fusion 层级再往上推——让 WHT rotation 完全融合进 attention kernel 的 first stage,甚至把旋转 baked 进模型权重(类似 SGLang 的 o_proj absorption 思路)。
问题二:vLLM v2 的 cudagraph 修复能不能在保持性能的同时完成。 v2 的 FLUTE 风格优化(grouped Q heads、vectorized LUT、exp2 scaling)在 MI300X 上拿到了很好的数字,但 reviewer 指出的「动态 grid size 破坏 cudagraph」问题如果不解决,v2 就无法在 NVIDIA 主流 GPU 上作为 production default 使用。v2 团队声称已经在最新 commit 里加了 pre-allocated buffer 复用,但这个 fix 的实际效果还需要等待完整的 CI 和实测验证。
问题三:TRT-LLM 对 TurboQuant 的态度。 静态计算图和动态 sign pattern 之间的矛盾是根本性的,但如果 Google 论文的方案最终演变成「sign pattern 固定、可以在 build 时确定」的版本,TRT-LLM 的整合难度会大幅下降。NVIDIA 内部的 roadmap 讨论(见 GitHub discussion #7834)值得持续关注。
问题四:不对称 K/V 位宽的实际质量边界在哪里。 SGLang 的 K=4bit V=2bit 实验目前只是 PR 里的 capability 描述,还没有详细的 accuracy 数据。如果这个配置在主流模型上能够保持质量不崩溃,它将成为目前已知最激进的生产可用 KV Cache 压缩配置——理论上可以把单 token 的 KV 内存再压低约 25%。
TurboQuant 从论文到生产环境的路还没走完,但它已经展示了 KV Cache 量化这个方向的上限在哪里。三个框架的工程路线虽然各有取舍,但它们的共同结论是清楚的:在 decode 阶段,极低 bit 的 KV Cache 压缩已经接近可以实用化的质量门槛,而真正限制它的是 prefill 开销和 CUDA Graph 兼容性这些工程问题——不是算法本身的限制。
参考资料
[1] Google Research Blog. TurboQuant: Redefining AI efficiency with extreme compression. 2026-03-24. https://research.google/blog/turboquant-redefining-ai-efficiency-with-extreme-compression/
[2] Amir Zandieh, Majid Daliri, Majid Hadian, Vahab Mirrokni. TurboQuant: Online Vector Quantization with Near-optimal Distortion Rate. arXiv:2504.19874, ICLR 2026. https://arxiv.org/abs/2504.19874
[3] Amir Zandieh, Majid Daliri, Insu Han, Vahab Mirrokni. Quantized Johnson-Lindenstrauss and Approximate Near Neighbors. arXiv:2406.03482, AAAI 2025. https://arxiv.org/abs/2406.03482
[4] NVIDIA/TensorRT-LLM PR #12544. Enable NVFP4 KV cache support in trtllm-gen attention. 2026-03-25. https://github.com/NVIDIA/TensorRT-LLM/pull/12544
[5] NVIDIA/TensorRT-LLM PR #13068. Add high-precision BF16 KV pool for MLA FP4 models. 2026-04-15. https://github.com/NVIDIA/TensorRT-LLM/pull/13068
[6] Y. Liu et al. KIVI: A 2-bit KV Cache Quantization Method for LLM. AAAI 2025. https://dl.acm.org/doi/10.5555/3692070.3693381
[7] vLLM PR #40396. Feat/tq rocm decode v2. 2026-04-20. https://github.com/vllm-project/vllm/pull/40396
[8] SGLang PR #23135. [KVCache] TurboQuant: fused Triton KV cache compression (3.88x, 93-105% decode throughput). 2026-04-18. https://github.com/sgl-project/sglang/pull/23135
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。