长上下文大模型的支持窗口已经从 128K 扩展到 10M token,但评测方式还停留在单次请求。微软团队在 SCBench 中指出了一个关键问题:真实应用里 KV cache 会被跨请求复用——多轮对话、工具调用、共享前缀——而现有 benchmark 全部忽略了这一层。这篇论文的核心判断是:长上下文方法的真正考验不在单次长输入,而在 KV cache 的完整生命周期里。
一、为什么单请求评测漏掉了最重要的场景
Transformer 推理过程中,KV cache 保存历史 token 的 key/value 表示,避免每步重复计算。现有 benchmark 几乎都只测单次输入下的准确率,但这不符合真实系统负载。
实际应用里,KV cache 复用(又称 prefix caching)已经是 vLLM、SGLang 等推理框架的标配,也被 OpenAI、Microsoft、Google、Anthropic 等提供商广泛使用。多轮对话中,同一个系统提示可能被调用数十次;代码助手里,同一个代码库的 KV 表示会跨 session 复用。这意味着:一种长上下文优化方法是否真的好,不只看它第一次处理长文本的效果,更要看它在 cache 被复用时会不会出问题。
SCBench 第一次把这个维度系统化地引入了评测。
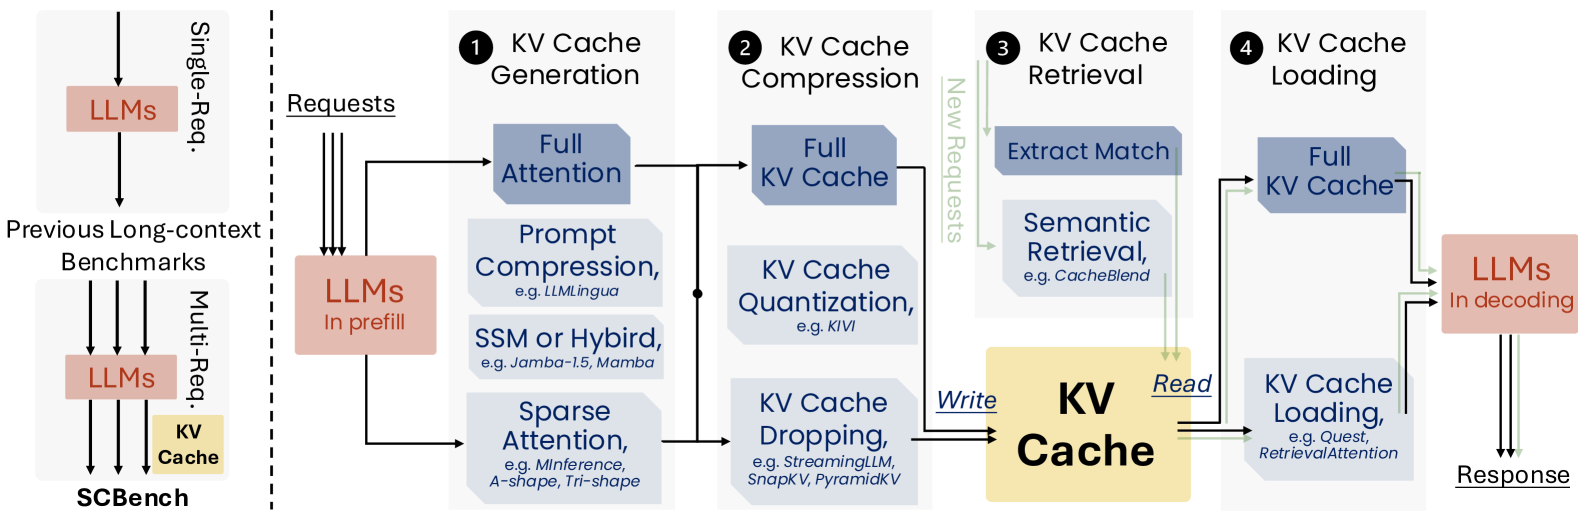
图 1:SCBench 的核心框架——把长上下文方法拆成 KV cache 四个阶段:generation(生成)、compression(压缩)、retrieval(检索)、loading(加载),并覆盖 shared context 多轮复用场景。
二、SCBench 的评测结构:两条共享模式,四个能力维度
SCBench 设计了 12 个任务,分为两种共享上下文模式(Fig 2a):
Multi-turn Mode:同一 session 内缓存上下文,多轮对话场景。Multi-request Mode:跨 session 缓存上下文,多个请求共享同一前缀。
每个任务包含共享上下文 + 多个后续查询,考察模型在 cache 被复用时的表现。
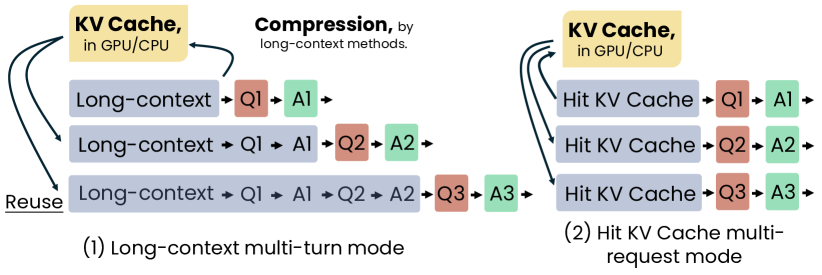
图 2:SCBench 覆盖的两种 shared context 模式,对应真实系统中多轮 agent 和跨请求 prefix caching 的实际场景。
四个能力维度和对应任务:
| 能力维度 | 任务 |
|---|---|
| String Retrieval | Key-value 检索、前缀-后缀检索、多跳检索 |
| Semantic Retrieval | RepoQA、长文本问答(中英文、多选题) |
| Global Information | Many-shot ICL、摘要、长数组统计 |
| Multi-tasking | RepoQA+NIAH、摘要+KV 检索 |
评测在 6 个模型上进行:Llama-3.1-8B/70B、Qwen2.5-72B/32B、Llama-3-8B-262K、GLM-4-9B-1M,以及 Mamba 系列和 Jamba-1.5-mini 两种混合架构。
三、核心发现一:sub-O(n) 内存方法在多轮场景下系统性退化
这是 SCBench 最重要的一条结论。
KV cache dropping 方法(如 StreamingLLM、SnapKV)在单请求上效果不错,因为它们在解码时维持固定大小的 KV cache(sub-O(n) 内存),成本极低。但问题在于:这些方法的压缩策略是 query-conditioned 的——根据当前查询决定保留哪些 KV,对第一个查询的最优选择,不见得适合后续查询。
结果是:随着请求数增加,这些方法的性能持续下滑(Fig 3a)。第一轮表现优秀,第三轮、第五轮就开始显著退化。在多轮 agent 场景里,这是致命的——用户不会只问一个问题就结束。
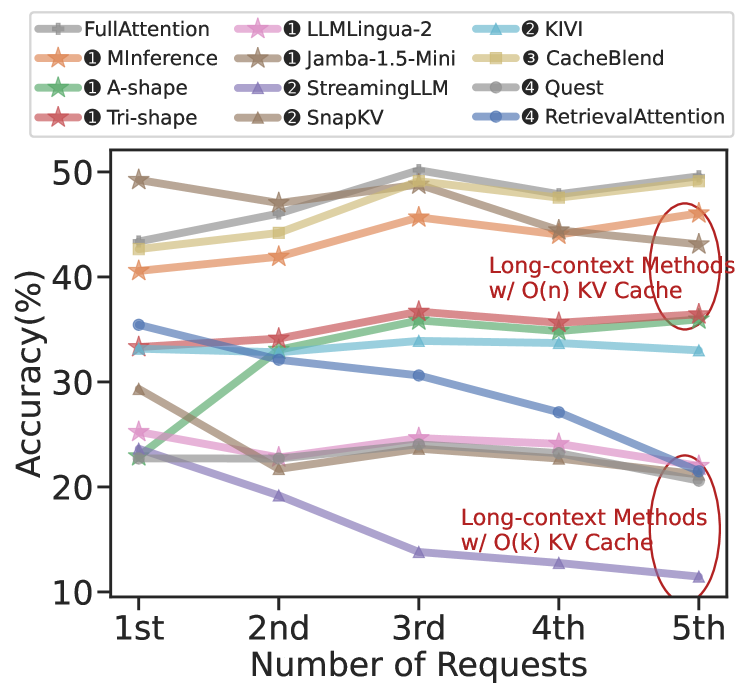
图 3:横轴是请求数,纵轴是性能。StreamingLLM 等 sub-O(n) 内存方法(橙色线)性能随请求数增加而下降,而稀疏注意力等 O(n) 内存方法(蓝色系)反而上升,体现了 KV cache 复用对不同方法的差异化影响。
对比来看,稀疏注意力方法虽然解码时需要 O(n) 内存,但在多轮场景下表现稳健,甚至随请求数增加性能略微提升。这说明:以固定预填充计算换动态适应能力,在多轮场景里是划算的。
四、核心发现二:动态稀疏性优于静态稀疏性
SCBench 还评测了 Tri-shape——作者提出的一种无训练稀疏注意力方法创新,核心是在不同注意力头使用不同的稀疏pattern(局部、线性、全局),比静态稀疏(如固定窗口)更灵活。
结果验证了这一点:动态稀疏产生的 KV cache 表达能力更强,压缩到相同比率时准确率更高。换句话说,稀疏策略必须跟着注意力模式走,而不是一刀切地全局应用同一规则。
在混合架构(如 Jamba-1.5-mini)上,layer-level 稀疏性进一步降低了内存占用,同时保持了较强性能。这对实际系统设计的启示是:不同层可以采用不同策略,不必统一压缩比率。
五、核心发现三:长生成场景存在 attention distribution shift
SCBench 还发现了一个值得关注的问题:随着生成长度增加,attention 分布会发生漂移。具体表现是,模型对 KV cache 早期内容的关注度逐渐下降,导致后续生成的内容与早期上下文的一致性变差。
这个问题在长 CoT 推理和长代码生成场景下尤其突出,因为这些场景需要模型在很长的生成序列里持续引用初始问题定义或早期中间结果。
六、八类方法的完整评测图景
| 方法类别 | 代表工作 | 内存级别 | 多轮稳健性 | 代表结论 |
|---|---|---|---|---|
| Gated Linear RNN | Codestal-Mamba | O(n) | 中等 | 压缩能力强但多轮适应性有限 |
| Mamba-Attention 混合 | Jamba-1.5-mini | O(n) | 较强 | Layer-level 稀疏是 memory-perf tradeoff 的关键 |
| 稀疏注意力 | A-shape, Tri-shape, MInference | O(n²) prefill, O(n) decode | 强 | 固定预填充成本换取动态适应能力 |
| KV Dropping | StreamingLLM, SnapKV | sub-O(n) | 弱(多轮退化) | Query-conditioned 压缩是多轮场景的核心瓶颈 |
| KV 量化 | KIVI | sub-O(n) | 较强 | 3-4bit 量化精度损失可接受 |
| KV 检索 | CacheBlend | 动态 | 较强 | 语义检索+缓存的组合策略有效 |
| KV 加载 | Quest, RetrievalAttention | sub-O(n) | 中等 | 部分加载策略在长序列下有瓶颈 |
| Prompt 压缩 | LLMLingua-2 | 取决于压缩率 | 取决于压缩质量 | 压缩率过高会破坏需要召回的细粒度信息 |
七、对系统设计的启示
从 KV cache 生命周期视角看,SCBench 的结论对实际系统设计有明确指向:
第一,sub-O(n) 解码成本不是唯一目标。 如果系统需要处理多轮请求,StreamingLLM 式的 KV dropping 策略会随着轮数增加而积累误差,宁可维持 O(n) 内存也要保证每轮解码质量。
第二,稀疏注意力是目前多轮场景下最稳健的 O(n) 方案。 固定预填充成本换来动态适应能力,在多轮复用场景里优势明显。
第三,混合架构的分层稀疏是工程落地的好方向。 Jamba-1.5 的实验表明不同层可以用不同压缩策略,系统可以根据层级重要性分配不同的 KV budget。
第四,attention distribution shift 是长生成任务里被低估的问题。 如果系统需要生成长代码或长 CoT,需要显式引入 KV state refresh 或重激活机制,防止模型在长生成链里丢失对早期关键信息的注意力。
八、结论
SCBench 的价值不只是提供了 12 个新任务,而是把长上下文方法评测从「单请求准确率」这个静态视角,拉到了「KV cache 完整生命周期」这个动态视角。在真实系统里,KV cache 会被复用、压缩、检索、加载——一个不理解这个循环的评测体系,即使在单请求上分数再高,也不能说明方法在生产环境里真正可用。
对 agent 系统研发者来说,这条结论格外实际:agent 的开销很少来自单次长文本,而是来自反复复用、持续追加与多轮回流。选长上下文方法,不能只看第一轮效果,要看第十轮的表现——SCBench 提供了第一批系统性的证据。
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。