如果只把 attention 机制当成一串名词表来背,很容易把 Self-Attention、FlashAttention、GQA、MLA 混成同一层概念。可它们实际改写的并不是同一个问题。我的判断是,过去几年 attention 的演化主线一直围绕两条正交的轴展开:第一条轴回答“谁能看谁”,也就是信息路由规则;第二条轴回答“怎么把算力、显存和 KV cache 成本压下来”,也就是执行效率策略。把这两条轴分开,主流 attention 算法的脉络就会清楚得多。
参考 Turing Post 那篇整理,本文不再把所有机制平铺成一张清单,而是按这两条轴重新组织:先讲 Self / Cross / Causal 这组路由规则,再讲 Scaled Dot-Product + MHA 这个 dense baseline,随后展开稀疏 attention、线性 attention,以及以 FlashAttention、MQA、GQA、MLA 为代表的系统与 KV 优化路径。换句话说,attention 的历史并不是不断推翻旧公式,而是在不同成本约束下,反复重写同一件事:信息该如何聚合,代价又该由谁承担[11]。
一、先把 attention 的分类讲清楚
最常见的误解,是把所有 attention 机制都放在同一层表格里比较。其实它们至少分成两类。
第一类是路由规则类。这类机制不一定改变 attention 的数学形式,而是先规定可见性边界。Self-Attention 处理同一序列内部的依赖,Cross-Attention 负责把一条序列或一种模态的信息引到另一条序列里,Causal Attention 则通过 mask 保证自回归生成时只能看见过去。它们解决的是“信息从哪来、能流到哪去”。
第二类是效率策略类。这类机制承认 dense softmax attention 的表达力很强,但试图用结构化稀疏、线性近似、IO 重排、KV 共享或 KV 压缩等手段,把它的成本从 O(n^2)、高 HBM 访存和高 KV cache 占用往下压。Sliding Window、Longformer / BigBird、Performer、Kimi Linear、FlashAttention、MQA、GQA、MLA 都属于这一层。
这个分类的重要性在于,它直接影响选型。你如果想做 encoder-decoder 翻译或多模态融合,首先要关心的是有没有 Cross-Attention;你如果想做 128K 以上长上下文,首先要关心的是 sparse、linear 还是 KV 压缩更合算;你如果已经决定保留 exact attention,只是训练和推理太慢,那优先级通常是 FlashAttention 而不是重训一个全新的线性模型。
二、按大类看 attention 算子的共性
路由规则类 attention 的共性,是先定义依赖图,再在这个图上做加权汇聚。它们通常不以“降低复杂度”为第一目标,而是以“让模型在正确的地方交换信息”为第一目标。因此,这一类机制决定的是架构范式:BERT 为什么能做双向理解,GPT 为什么适合续写,T5 为什么能做 seq2seq,本质上都先由这层规则决定。
稀疏 attention 的共性,是用结构先验换成本。它默认大多数 token 对并不需要显式两两交互,于是先把注意力图裁成局部窗口、全局 token、随机块或分层块,再在剩下的边上做 exact computation。它的好处是把复杂度压到线性或近线性,代价是全局建模能力不再“天然存在”,而要靠设计的稀疏图去补。
线性 attention 的共性,是不再显式构造完整的 QK^T 矩阵,而是把 softmax attention 改写为可结合的核形式或有限状态更新。它的优点是长序列成本更平滑,尤其适合百万级上下文;难点则是表达力、训练稳定性和与现有 Transformer 生态的兼容性。也因此,纯线性 attention 很长时间都停留在“理论上漂亮、工程上难替换”的状态,直到近两年 hybrid 设计才重新抬头。
系统与 KV 优化类 attention 的共性,是把瓶颈从“公式”转回“数据搬运”。FlashAttention 主要优化的是 HBM 和 SRAM 之间的 IO;MQA / GQA / MLA 主要优化的是 decode 阶段的 KV cache 容量和内存带宽。它们未必改变 attention 的基本任务,但非常贴合今天大模型训练和部署的真实成本中心,所以落地速度往往比纯算法创新更快。
三、路由规则类 attention:先决定信息怎么流
3.1 Self-Attention
Transformer 论文把 self-attention 定义为:
“relating different positions of a single sequence”[1]
它要解决的问题,是 RNN 和 CNN 在长距离依赖与并行计算之间很难兼得。RNN 的依赖路径长,CNN 需要堆很多层才能跨很远的位置,而 self-attention 让每个 token 都能直接对同一序列中的其他 token 计算相关性,再把值向量做加权求和。对 encoder 来说,这意味着模型能够在一个层内聚合全局上下文;对 decoder 来说,这意味着历史上下文可以被统一编码成一套可学习的依赖图。
它真正的创新点,不是“加权求和”本身,而是把这种全局可达的交互做成了标准层结构。Transformer 论文里给出的一个关键比较是:self-attention 单层的最大路径长度是 O(1),而 recurrence 是 O(n)[1]。这也是为什么 BERT、ViT、GPT 这一整条路线都以 self-attention 为骨架。适用场景很清楚:只要任务主要是同一序列内部的关系建模,self-attention 依然是默认起点。
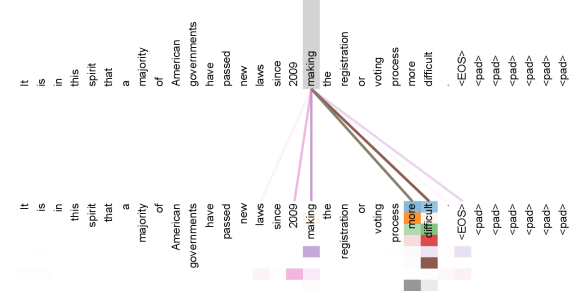
图 1:Transformer 用这张图展示 encoder self-attention 如何直接跨越长距离依赖,把 “making … more difficult” 这样的远距关系连起来。它说明 self-attention 最核心的收益不是局部加权,而是全局可达。来源:Attention Is All You Need Figure 3。
3.2 Cross-Attention
Transformer 对 encoder-decoder attention 的描述是:
“queries come from the previous decoder layer”[1]
它解决的问题,不是序列内部依赖,而是两套表示之间如何对齐。最经典的例子当然是机器翻译:decoder 在生成目标词时,应该去输入句子的哪些位置取信息。后来这条路径扩展到了摘要、ASR、多模态生成乃至扩散模型里的文本条件注入,本质都一样:查询来自当前生成端,键和值来自另一份上下文记忆。
Cross-attention 的创新点,在于把“读外部记忆”做成了标准化接口。它没有改变 attention 的基本算式,但把单塔 Transformer 扩展成了双塔或多塔系统。实践里,T5、BART 这类 encoder-decoder 模型都依赖它完成条件生成;多模态模型也广泛用它把图像、语音或检索结果接到语言层里。它不一定更便宜,但在需要信息融合的任务里,几乎没有别的机制能如此直接地替代。
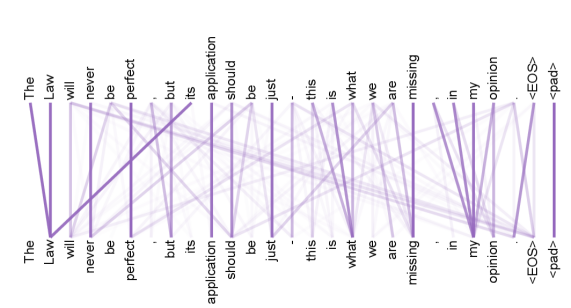
图 2:Transformer 架构右侧 decoder 中部的 multi-head attention 负责读取 encoder 输出,这就是后来所谓 cross-attention 的标准形态。它把“外部上下文读取”变成了一层明确的结构接口。来源:Attention Is All You Need Figure 1。
3.3 Causal Attention
Transformer 对 decoder mask 的原话是:
“prevent positions from attending to subsequent positions”[1]
Causal attention 要解决的问题很简单,但决定性极强:做自回归生成时,当前位置绝不能偷看未来 token,否则训练目标和推理目标会发生泄漏。它的核心创新不是新公式,而是把上三角 mask 内置进 attention 流程,让第 i 个位置只能依赖 <= i 的 token。
这类机制的实现效果不该用“提速多少”来衡量,而该用“是否保持生成因果性”来衡量。今天几乎所有 decoder-only 大模型,包括 GPT、Llama、Qwen、DeepSeek 这类路线,骨子里都建立在 causal self-attention 之上。它最适合的场景当然是 next-token prediction,也就是今天主流聊天、代码和 agent 模型的基本范式。
图 3:同一张 Transformer 架构图里,decoder 底部的 masked multi-head attention 给出了 causal attention 最标准的实现方式。关键不是换了一个 attention 公式,而是先用 mask 把未来 token 从可见图里删掉。来源:Attention Is All You Need Figure 1。
四、dense baseline:Scaled Dot-Product 与 Multi-Head Attention
如果说上面三种机制决定的是依赖图,那么真正定义现代 Transformer baseline 的,是 Scaled Dot-Product Attention 与 Multi-Head Attention。
Scaled dot-product attention 要解决的问题,是 dot-product attention 在维度变大时,点积数值容易过大,从而把 softmax 推进梯度极小区间。Transformer 的做法是在 QK^T 之后除以 sqrt(d_k),再做 softmax 归一化。这个看似朴素的缩放,把 dot-product attention 从“可用”变成了“可稳定扩展”,也让矩阵乘法成为整个算子的主计算单元。论文报告,基于这一套机制的 Transformer 在 WMT14 英德翻译上做到 28.4 BLEU,在英法翻译上做到 41.8 BLEU,并且训练成本显著低于当时最佳系统[2]。
Multi-head attention 解决的则是单个 attention map 容易把不同关系平均在一起的问题。Transformer 的做法是把 Q/K/V 投影到多个子空间,各自独立算 attention,再把结果拼回去。这样同一层里可以同时学习语法对齐、指代关系、局部搭配和更高层语义模式。它的创新点并不在复杂度,因为总计算量与单头全维度 attention 同阶;它真正换来的是表示多样性。这也是为什么直到今天,大部分模型即使在做 MQA、GQA 或 MLA 优化时,也仍然保留了“多查询头”的基本框架。
在选型上,Scaled Dot-Product + MHA 依然是默认基线。只要上下文长度和 KV 成本还在可接受区间,这套 exact dense attention 仍是表达力、兼容性和工程成熟度最均衡的方案。后面的几乎所有创新,本质上都是围绕它的三个痛点展开:O(n^2) 复杂度、显存/IO 压力,以及 decode 阶段的 KV cache。
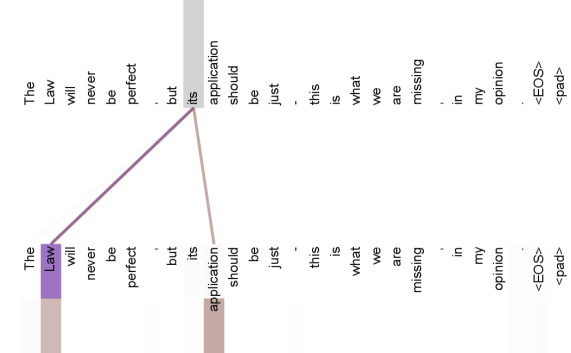
图 4:Transformer 论文把 scaled dot-product attention 和 multi-head attention 画成同一张核心结构图。左边解释单头 attention 的缩放与归一化,右边解释多头并行后再 concat 的表示增益。来源:Attention Is All You Need Figure 2。
五、稀疏长上下文类:先裁注意力图,再保留关键全局边
5.1 Sliding Window Attention
Longformer 论文把自己的核心机制概括为:
“combines a local windowed attention”[3]
Sliding Window Attention 要解决的问题,是 full attention 在长文档上 O(n^2) 的计算和显存爆炸。它的想法很直接:大多数 token 其实只需要看附近若干个位置,于是每个位置只和固定窗口内的 token 建边,把复杂度压成 O(nw)。随着层数加深,信息仍可以逐层向外传播,等价地扩大感受野。
这类机制的创新点,是把“局部性”当成结构先验显式编码进 attention 图。Longformer 证明它可以线性扩展到几千甚至更长的 token,并在长文档任务上优于 RoBERTa,WikiHop 和 TriviaQA 上达到新的 SOTA[3]。更重要的是,到了 LLM 时代,Sliding Window Attention 不再只是长文档 encoder 的专属技巧。Mistral 7B 直接把 SWA + GQA 写进架构摘要中,用它降低长序列推理成本[9]。
适用场景也很明确:文档、代码、对话这类局部连续性很强的序列,通常都能从 sliding window 中受益。它的边界则同样明显。如果任务需要频繁做远距离、跨段的精确跳转,只靠局部窗口往往不够。
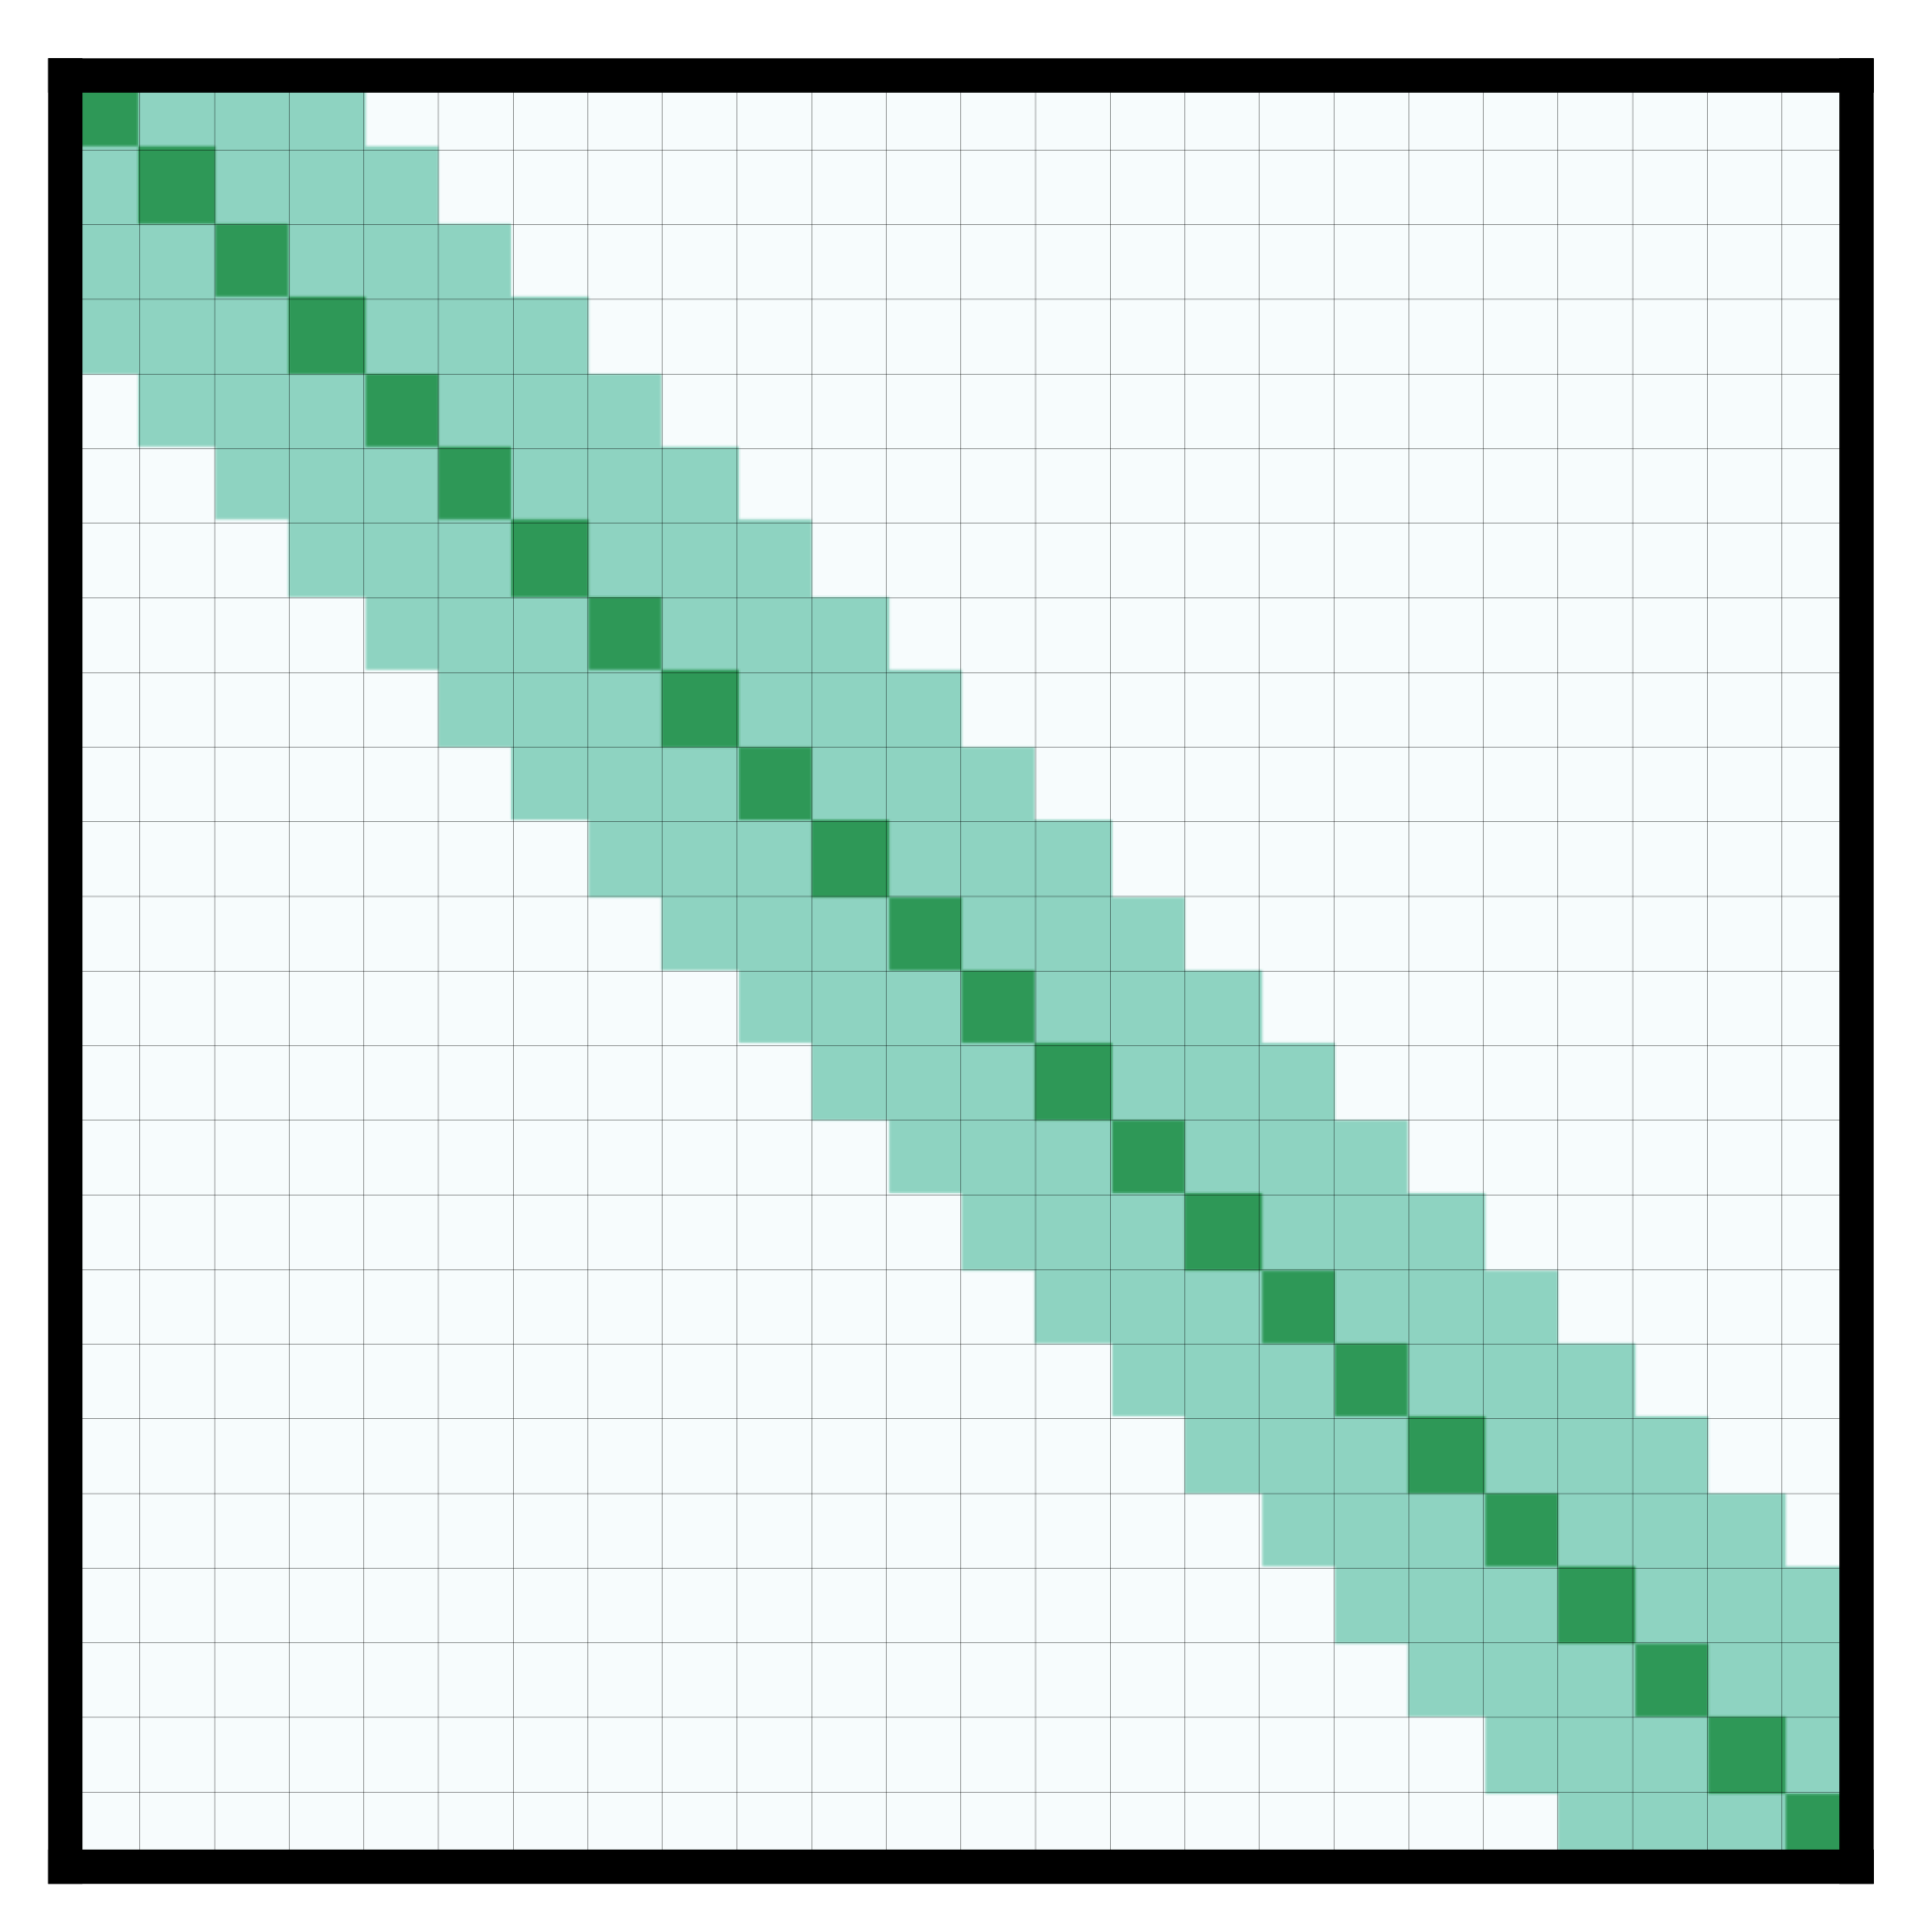
图 5:Longformer 用固定宽度的对角带来表示局部窗口,每个 token 只和附近一段上下文建边。这张图把 sliding window 的成本来源讲得很直接:先限制可见域,再让感受野靠堆层扩散。来源:Longformer Figure 1。
5.2 Global Sparse Attention
Longformer 的后半句话是:
“task motivated global attention”[3]
这恰好点出了 sparse attention 的第二个关键问题。纯局部窗口虽然便宜,但会削弱全局聚合能力,于是很多模型会额外指定少量全局 token,或者在局部块之外再加入随机/全局连接。BigBird 的抽象更彻底,它把 sparse attention 组织成局部、全局和随机三类边,并强调这条路线可以:
“reduce this quadratic dependency to linear”[4]
这类算法解决的问题,是如何在不恢复 full attention 成本的前提下,尽量保住全局信息流。它们的创新点是注意力图设计,而不是 kernel 本身。效果上,Longformer 更偏任务化长文档建模,BigBird 则进一步补上了理论可表达性与更通用的 sparse 图设计。适用场景是长文档理解、长输入摘要、检索增强编码等。它们已经在一批长上下文 encoder 和 hybrid decoder 中落地,但从公开主流 LLM 看,真正大规模进入基础模型主路径的,更多是 sliding window 这类更简单、工程上更稳定的 sparse 设计。
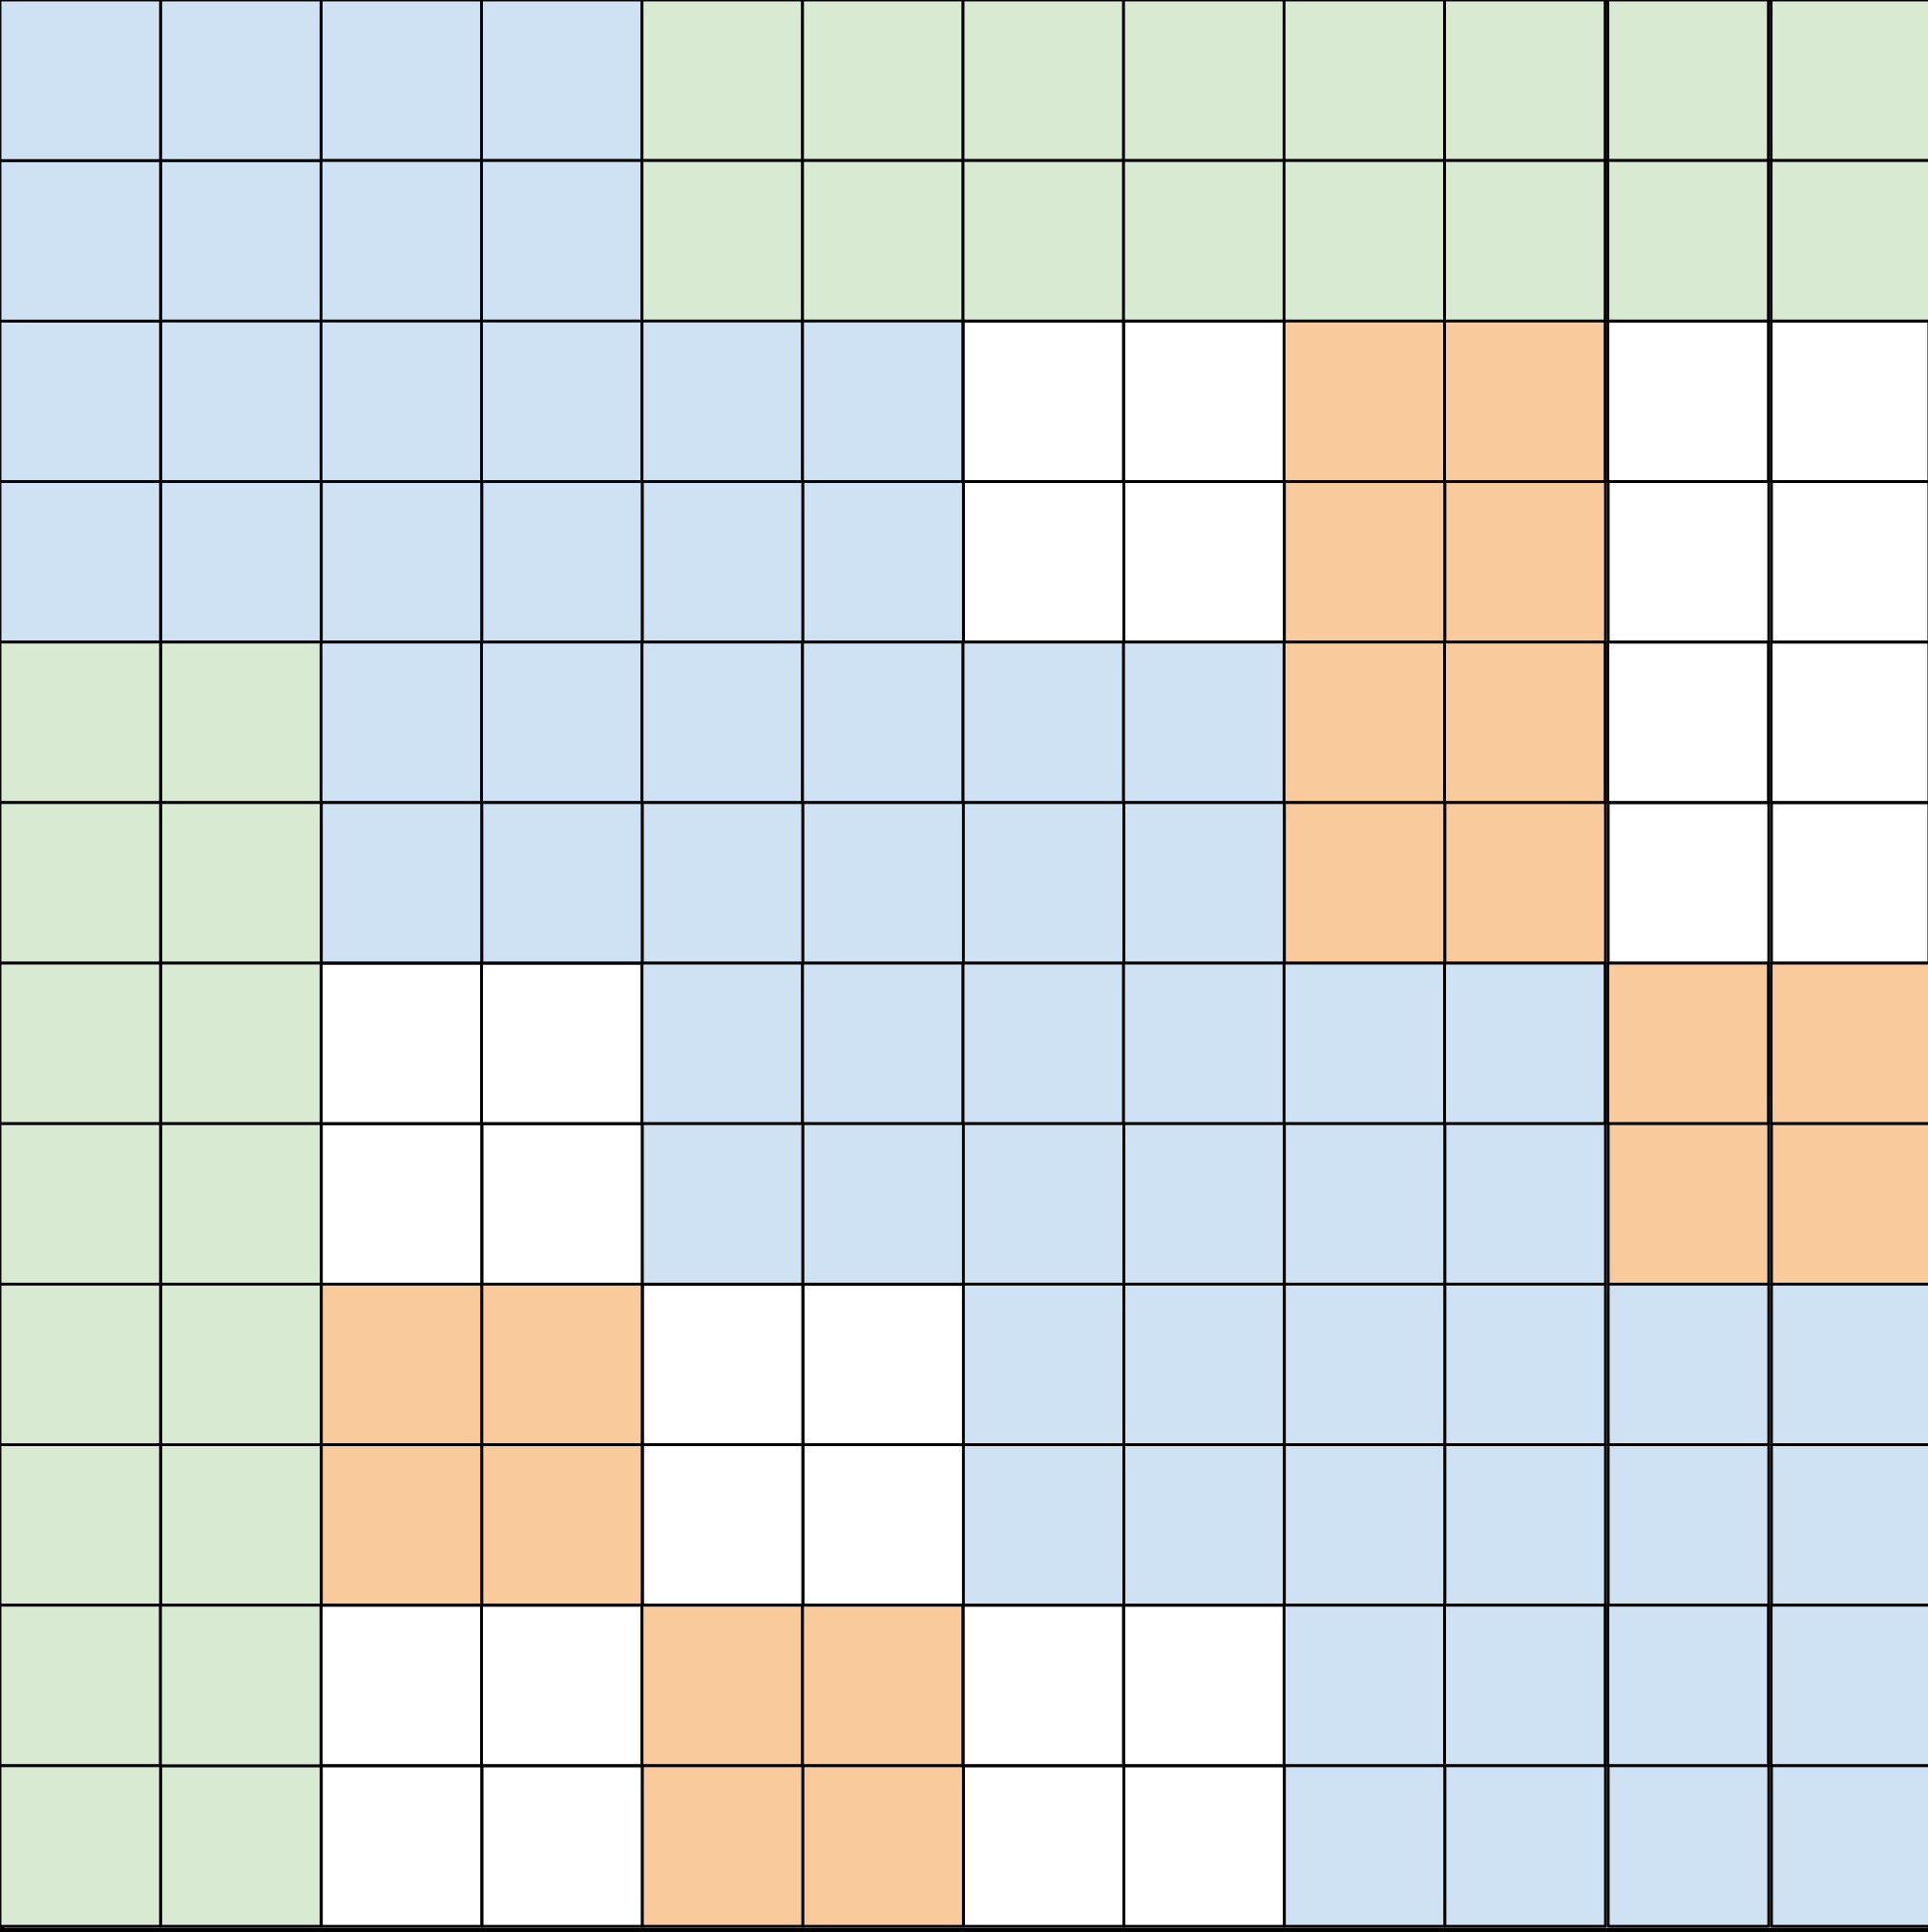
图 6:BigBird 把注意力图拆成局部块、全局块和随机块三类边。和纯 sliding window 相比,它的重点不是更窄,而是用少量额外的全局/随机连接把长程信息流重新接回去。来源:BigBird 论文配图。
六、线性近似类:Performer 到 Kimi Linear
6.1 Performer
Performer 对自己的主张非常明确:
“linear (as opposed to quadratic) space and time complexity”[5]
它要解决的问题和稀疏 attention 相同,都是 dense attention 的平方复杂度;不同之处在于,Performer 不先裁剪注意力图,而是通过 FAVOR+ 把 softmax kernel 近似成可分解的随机特征映射,使 attention 计算改写成线性形式。换句话说,稀疏 attention 是先删边,线性 attention 是先改算式。
Performer 的创新点,在于它既给了近似方法,也给了理论保证。论文强调它对常规 softmax full attention 给出无偏或近无偏估计,并在文本、像素、蛋白序列等任务上取得有竞争力的结果[5]。这让线性 attention 不再只是“快但说不清为什么能用”的技巧,而成为一条严肃的替代路线。
但它的落地边界同样值得讲清。纯 Performer 并没有像 GQA 或 FlashAttention 那样迅速进入今天的大多数主流基础模型。我的判断是,原因不在于它不够聪明,而在于基础模型已经围绕 dense attention 形成了一整套训练、并行和 kernel 生态,任何近似路线都必须证明自己在质量、稳定性和工程迁移上同时划算。
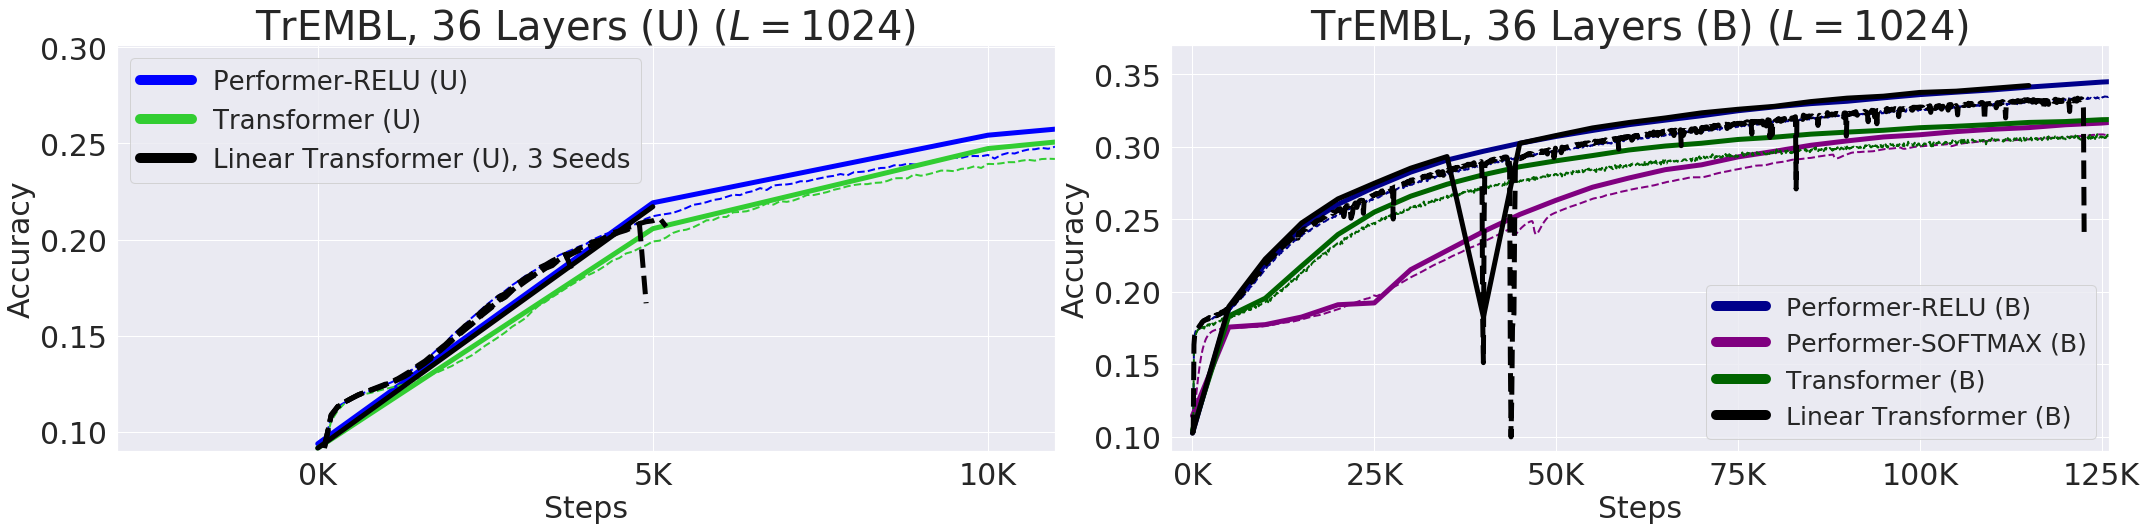
图 7:Performer 论文给出的代表性结果之一,是在线性复杂度约束下把性能拉到与标准 Transformer 相近甚至更优。对这条路线而言,关键不是图像本身,而是它证明“近似 attention”可以不只是理论上的省复杂度。来源:Rethinking Attention with Performers 实验图。
6.2 Kimi Linear
Kimi Linear 的论文把这个长期悬而未决的问题直接挑明了:
“outperforms full attention”[10]
它要解决的,正是早期线性 attention 最难跨过去的那道坎:长上下文更省,但短上下文和常规训练任务并不一定更强。Kimi Linear 采用 hybrid 结构,在 full attention 之外引入更有表达力的 KDA 模块,并把线性注意力从“便宜的替代品”推向“在若干任务上可能更优的主路径”。论文声称,在 short-context、long-context 和 RL scaling 三类场景下,它都能在公平对比下超过 full attention[10]。
这类工作的意义,不只是给线性 attention 争回了性能面子,更重要的是改变了部署判断。如果线性模块真的能够在不明显掉点的前提下承担更多层,那么长上下文模型的 KV cache 和 decode 带宽压力就会系统性下降。这也是为什么近一年 attention 讨论重新回到 hybrid 路线:不是要把 dense attention 一刀切掉,而是开始认真讨论“哪些层必须 dense,哪些层可以线性化”。
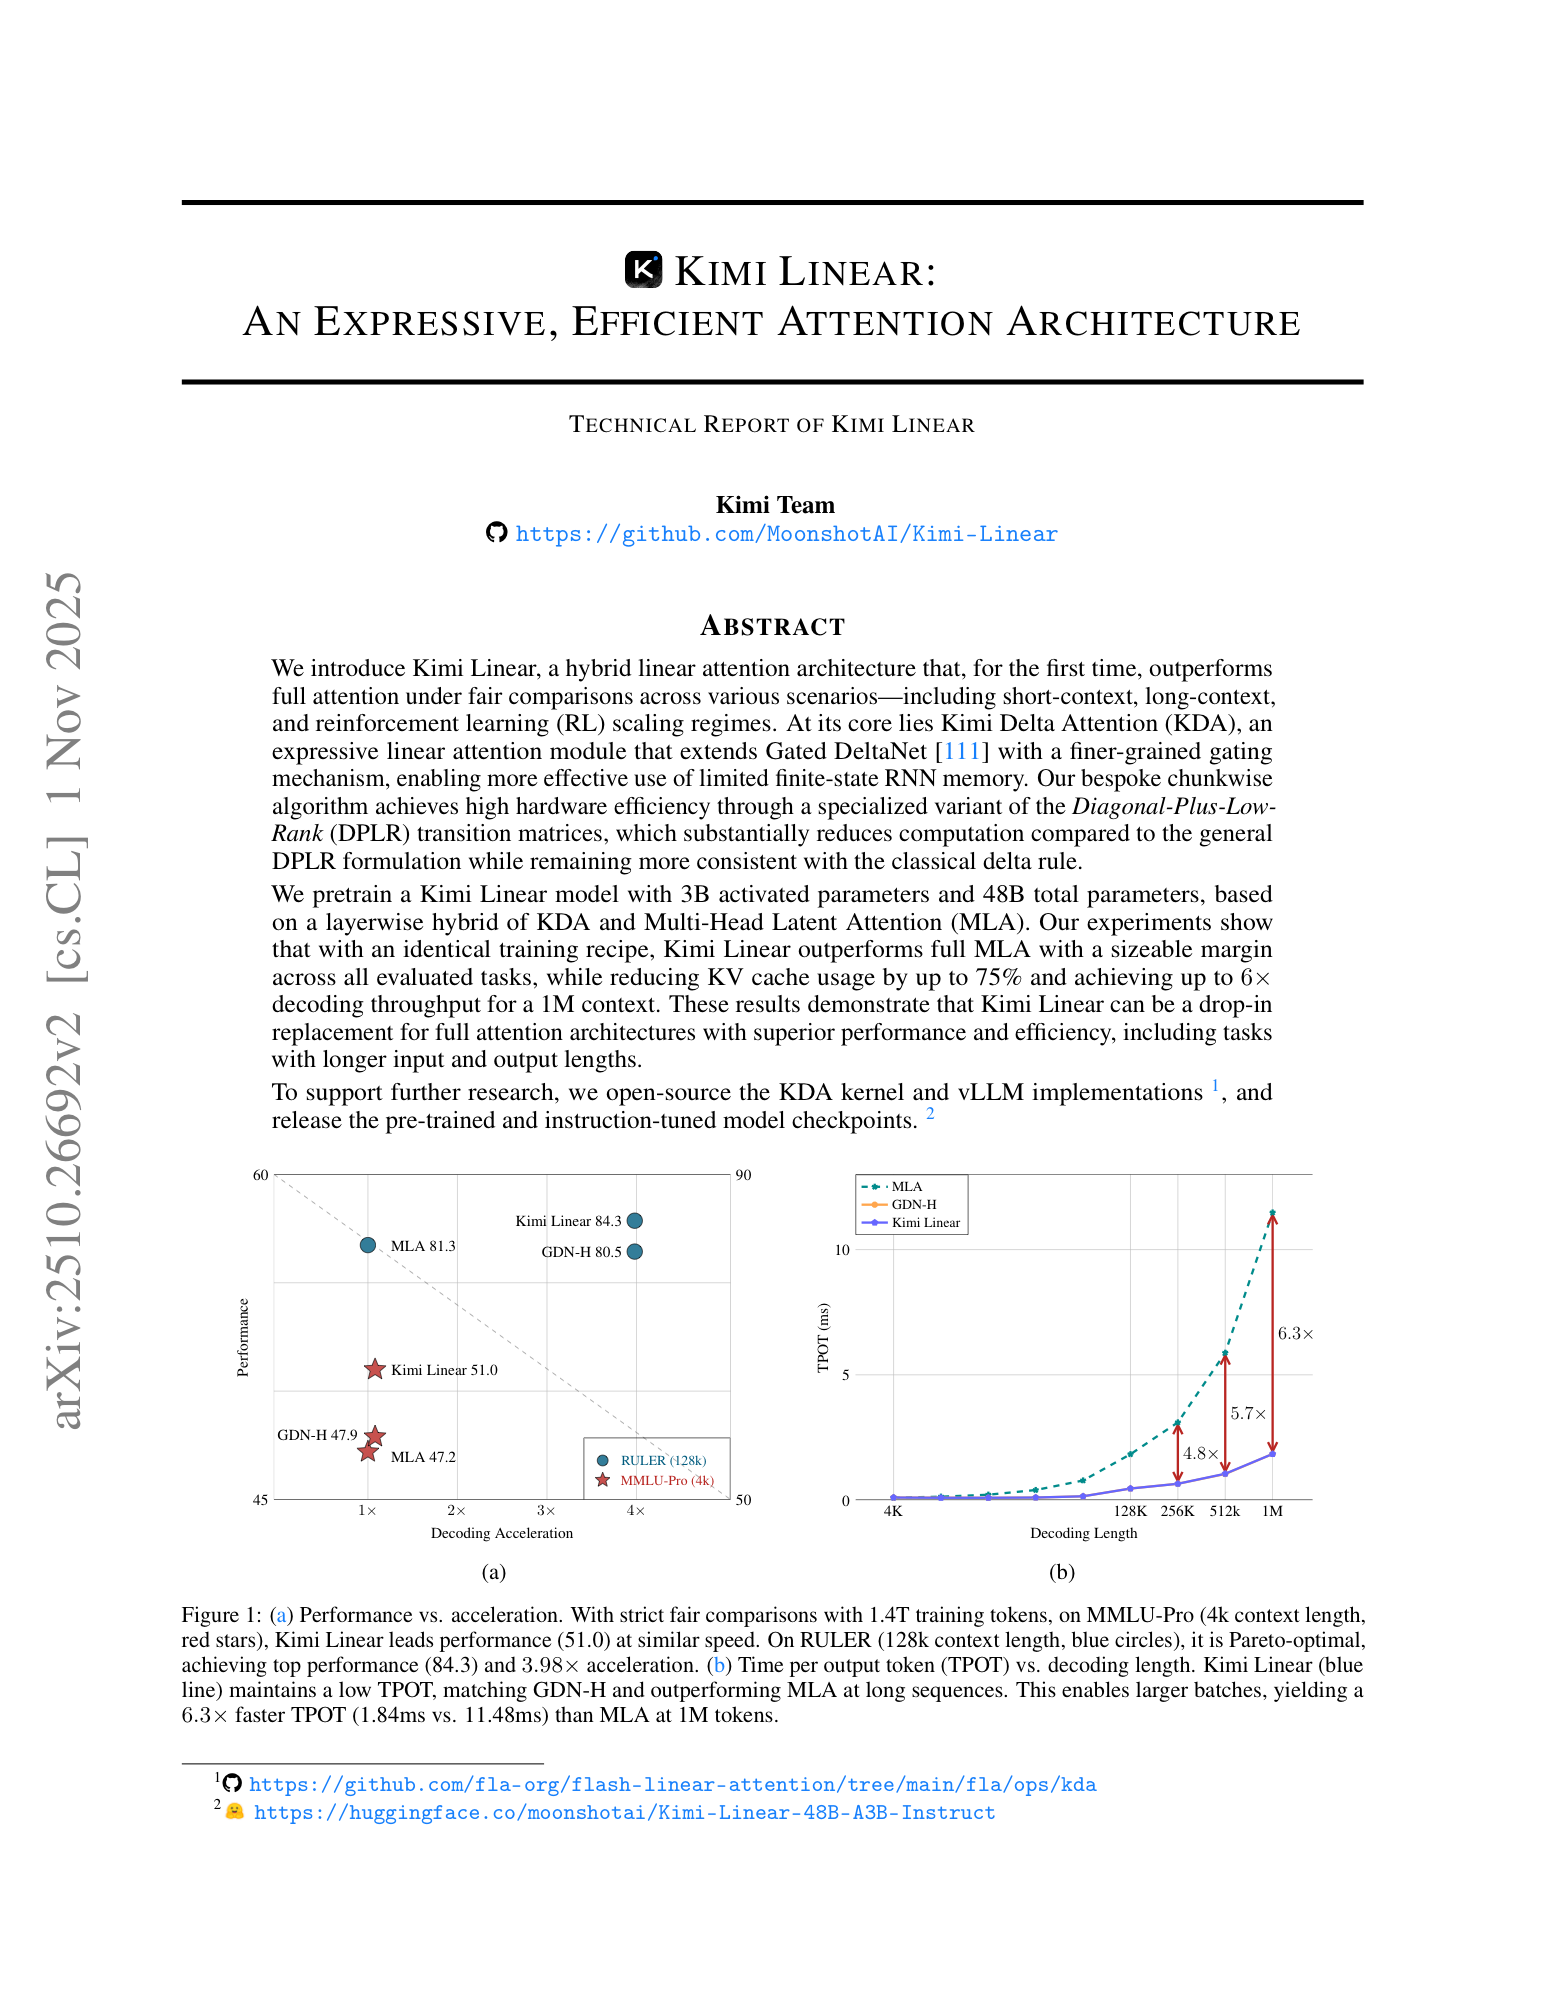
图 8:Kimi Linear 把“性能-加速”与“长上下文 TPOT”放在第一页对照,主张它不是单纯牺牲质量换线性复杂度,而是在公平训练下同时拿到更高性能和更低长序列开销。来源:Kimi Linear Figure 1。
七、系统优化类:今天最实际的战场在 IO 和 KV cache
7.1 FlashAttention
FlashAttention 的关键词不是 sparse 或 linear,而是:
“IO-aware exact attention algorithm”[6]
它要解决的问题,是标准 exact attention 在 GPU 上常常不是算力受限,而是内存访存受限。传统实现会显式写出或反复读取巨大的中间 attention matrix,导致 HBM 与片上 SRAM 之间的来回搬运成为瓶颈。FlashAttention 的创新点,是用 tiling、online softmax 和更精细的块级调度,把中间结果尽量留在片上内存里,从而减少昂贵的 HBM 读写。
它最重要的意义,是在不改变 attention 语义的前提下把 exact attention 做快。这让很多团队不必为了效率立刻换掉模型架构,只需要更换 kernel,就能在训练和推理中拿到显著的速度与显存收益[6]。适用场景几乎覆盖所有还在使用 dense attention 的 GPU 路线。也正因为如此,它的落地单位往往不是某个具体模型,而是整个训练/推理栈。
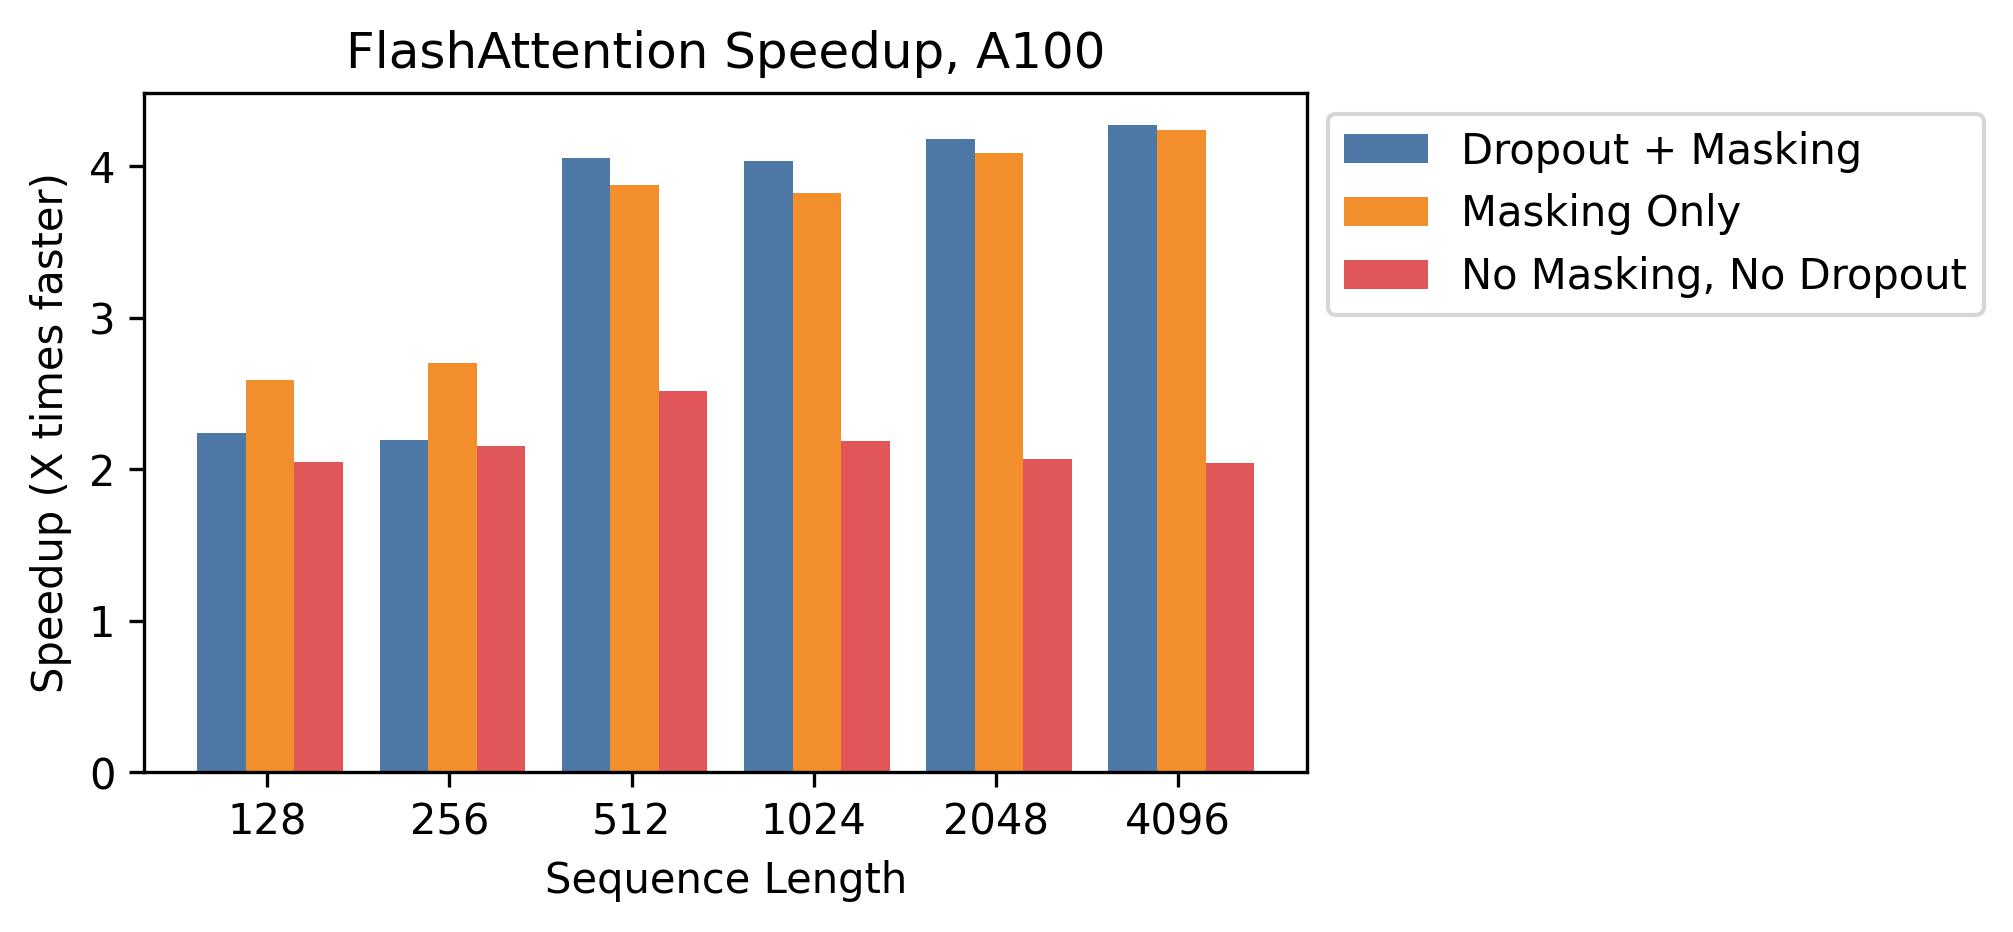
图 9:FlashAttention 最有说服力的并不是一个新结构图,而是这种随序列长度上升仍能持续拉开差距的 speedup 曲线。它说明 IO-aware 重排命中的正是 dense attention 在 GPU 上最贵的那部分成本。来源:FlashAttention 实验图。
7.2 Multi-Query Attention(MQA)
MQA 论文的标题已经把意图说透了:
“One Write-Head is All You Need”[7]
它要解决的问题,是 decoder incremental inference 时重复加载多组 K/V 带来的带宽压力。标准 MHA 中,每个 query head 都有各自的 key 和 value 头;MQA 则让所有 query heads 共享同一组 K/V。这样一来,训练端的主结构变化不大,但 decode 时 KV cache 的体积会明显下降,访存压力也随之降低。
MQA 的创新点是把优化焦点从 Q 转向 K/V。论文报告,它能显著加快解码,同时只带来较小的质量退化[7]。它非常适合对吞吐和延迟高度敏感的 decoder-only 推理服务。边界也同样清楚:如果所有 query heads 都共享一份 K/V,表达分辨率会下降,因此它更像一条极致压缩路线,而不是通用最优点。
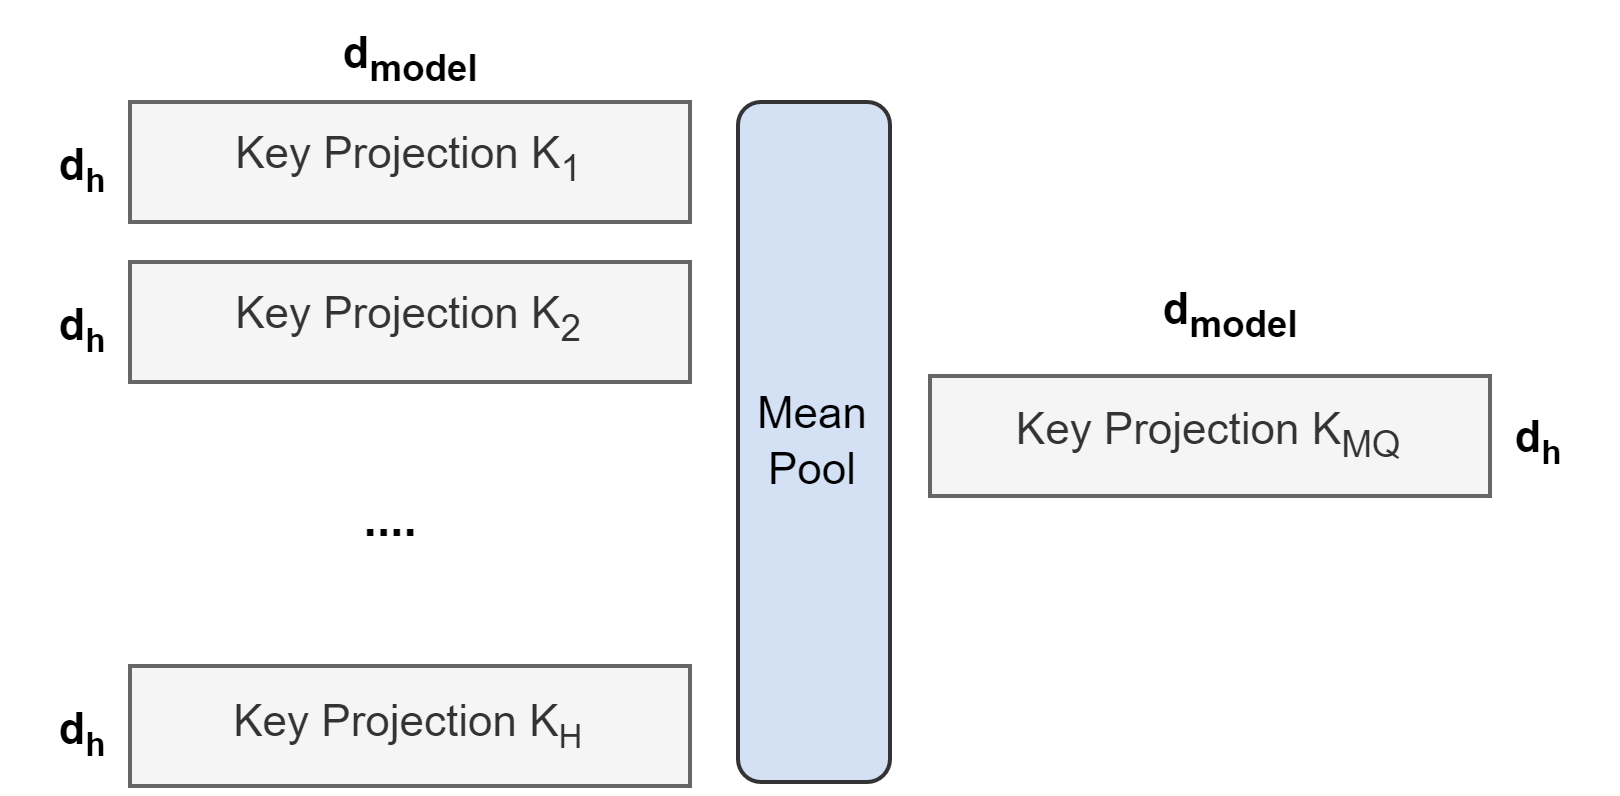
图 10:这张图展示了把多头 K/V 合并成单组共享 K/V 的直觉来源。虽然图出自后续 GQA 论文,但它把 MQA 最关键的结构收缩过程画得非常清楚:查询头仍然保留多路,写入端的 K/V 则被压到单组。来源:GQA 论文中对 MQA 的结构示意。
7.3 Grouped-Query Attention(GQA)
GQA 的论文给出的是一个折中判断:
“quality close to multi-head attention”[8]
它解决的问题,正是 MQA 那个过于极端的共享策略。既然单一 K/V 头会损失质量,那就让若干个 query heads 组成一组,共享一组 K/V,在 MHA 与 MQA 之间找一个中间点。论文把它描述为 MQA 的一般化形式,并强调其推理速度接近 MQA,而效果更接近 MHA[8]。
这条路线为什么会成为主流,原因很现实:它给出的不是“理论上更优”,而是“工程上更稳的速度-质量折中”。Mistral 7B 直接把 GQA 写进架构摘要,Llama 2 之后的大量开源模型、Qwen 系列等也沿用了这一路线。对于今天的大多数长上下文 decoder-only 模型来说,GQA 基本已经从“可选优化”变成了默认配置。
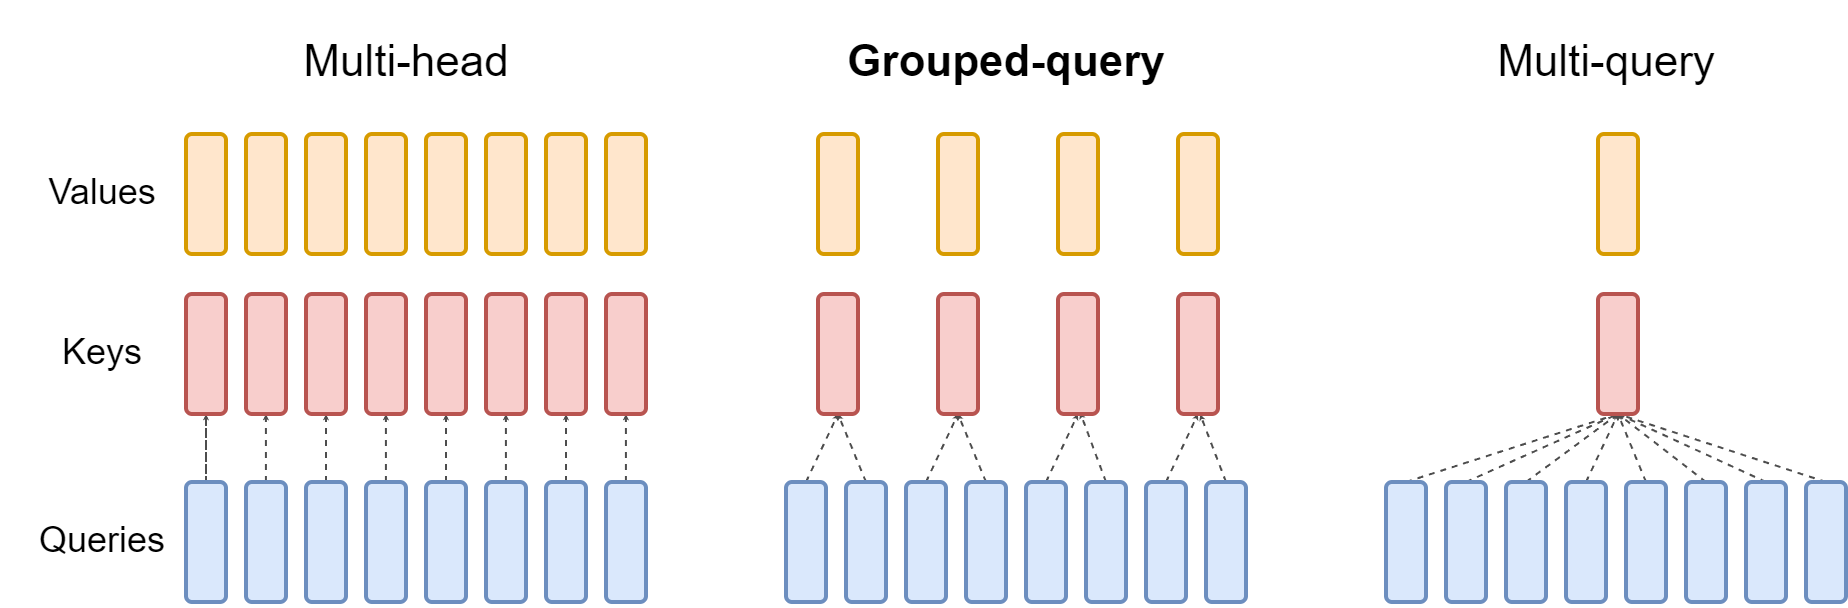
图 11:GQA 的价值恰好体现在这张并排对比图里。它既不像 MHA 那样为每个查询头保留独立 K/V,也不像 MQA 那样把所有 K/V 压成一组,而是在两者之间找到一个可控折中。来源:GQA Figure 2。
7.4 Multi-Head Latent Attention(MLA)
DeepSeek-V2 对 MLA 的描述是:
“compressing the Key-Value (KV) cache into a latent vector”[12]
MLA 要解决的问题,比 GQA 更进一步。GQA 仍然在“减少 KV 头数”这个维度压成本,而 MLA 直接把 KV cache 压到一个更低维的潜在空间里,再在需要时重建或参与注意力计算。这样做的目标不是小修小补,而是把 decode 阶段最贵的那块状态成本整体改写掉。
它的创新点,是从“共享几份 KV”迈向“把 KV 本身重新参数化”。DeepSeek-V2 论文给出的效果也非常激进:相较 DeepSeek 67B,MLA 让模型在更强性能的同时,把 KV cache 降低 93.3%,并把最大生成吞吐提升到 5.76 倍[12]。这使 MLA 成为近年来 attention 设计里最有产业冲击力的一条路线之一。适用场景尤其明确:超长上下文、超大批量服务,以及任何 decode 带宽比算力更先撞墙的推理系统。
如果说 FlashAttention 主要是在不改模型的前提下优化 IO,GQA 是在少改模型的前提下压 KV,那么 MLA 则是在重写模型状态表示。这也是它和前两者真正的分水岭。
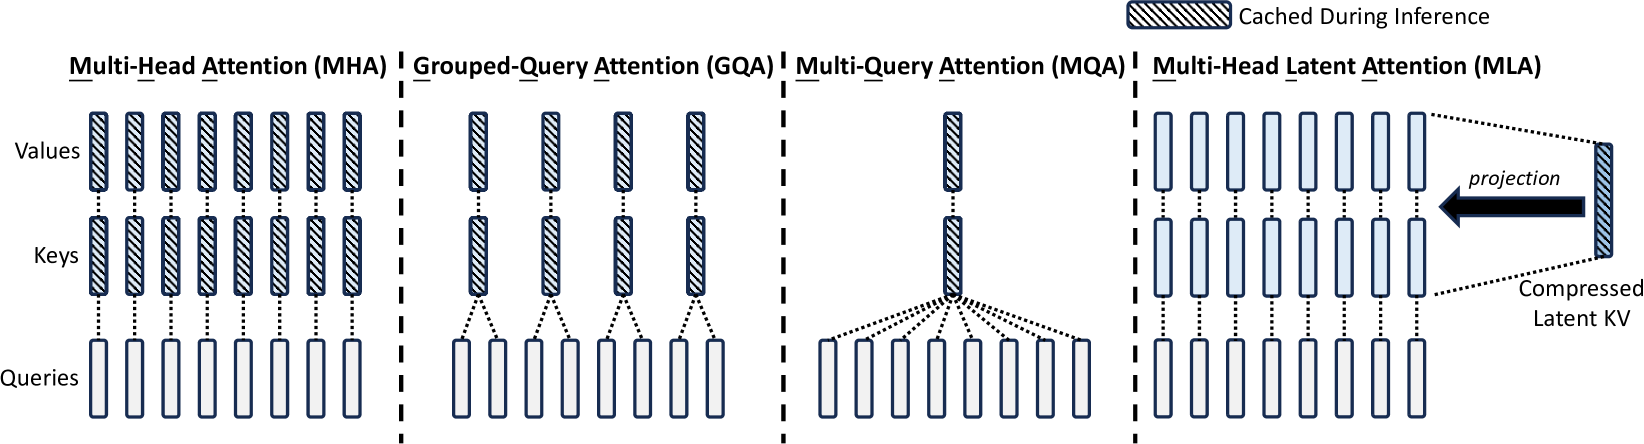
图 12:DeepSeek-V2 论文把 MHA、GQA、MQA 和 MLA 放到同一张图里比较,最直观地展示了 MLA 的核心贡献并不是减少头数,而是把 KV cache 先压进 latent space,再按需投影回注意力计算。来源:DeepSeek-V2 Figure 3。
八、怎么理解这条演化主线
把这些算法放在一起看,attention 的演化其实没有那么神秘。第一阶段,Transformer 用 Scaled Dot-Product + MHA 确立了 exact dense attention 的主干;第二阶段,Longformer、BigBird、Performer 试图解决长序列下的平方复杂度;第三阶段,FlashAttention 把大家拉回现实,证明很多时候真正的瓶颈是 IO;第四阶段,MQA、GQA、MLA 则把战场进一步推到 KV cache,因为大模型一旦进入 decode 主导的服务阶段,状态比计算更贵。
这条线索也解释了为什么今天不存在一个“绝对最先进”的 attention。若你的目标是最高表达力和最成熟生态,dense MHA 仍是默认答案;若你要做长文档理解,稀疏 attention 往往更直接;若你要追求百万级上下文或状态更小的长序列建模,linear 或 hybrid linear 开始变得有吸引力;若你真正的成本中心在 GPU 带宽和在线服务,那么 FlashAttention、GQA、MLA 的优先级通常会高于继续打磨理论复杂度。
真正值得记住的不是每个缩写,而是一个更通用的判断:attention 的创新越来越少是在重新定义“相关性”,越来越多是在重新定义“相关性该以什么成本被计算和存储”。 从研究到部署,几乎所有主流路线都在朝这个方向收敛。
九、主流 attention 算法对比表
| 机制 | 主要改动对象 | 典型复杂度 | KV cache 压力 | 是否 exact | 主要优点 | 主要代价/边界 | 代表落地 |
|---|---|---|---|---|---|---|---|
| Self-Attention | 同序列内部可见性 | 通常为 O(n^2) |
高 | 是 | 全局建模、并行性强 | 长上下文成本高 | BERT、ViT、GPT 等 |
| Cross-Attention | 跨序列/跨模态路由 | 通常为 O(nm) |
取决于外部记忆长度 | 是 | 条件生成与信息融合直接 | 外部记忆越大越贵 | T5、BART、Flamingo、扩散模型文本条件层 |
| Causal Attention | 自回归可见性约束 | 通常为 O(n^2) |
高 | 是 | 保证 next-token 训练/推理一致 | 无法双向看全上下文 | GPT、Llama、Qwen、DeepSeek |
| Scaled Dot-Product + MHA | dense baseline | O(n^2) |
很高 | 是 | 表达力强、生态最成熟 | 长序列和 decode 昂贵 | 几乎所有 Transformer 基线 |
| Sliding Window Attention | 局部稀疏图 | O(nw) |
中等,可配 rolling cache | 是 | 长上下文更便宜,局部模式强 | 远距离交互要靠堆层传播 | Longformer、Mistral、部分 Gemma/Qwen 长上下文变体 |
| Global Sparse / BigBird | 局部 + 全局/随机边 | 近线性 | 中等 | 是 | 保留少量全局汇聚能力 | 图设计更复杂,工程实现更难 | Longformer-LED、BigBird 系列 |
| Performer / 线性 attention | 算式改写为核近似 | O(n) |
低到中等 | 否,通常为近似 | 超长序列成本平滑 | 质量和稳定性依赖设计 | Performer 系列、若干长序列专项模型 |
| Kimi Linear | hybrid linear 主路径 | 近线性 | 低 | 通常为近似/混合 | 试图同时守住质量与长上下文效率 | 训练和实现复杂度更高 | Kimi Linear 路线 |
| FlashAttention | GPU IO 路径 | 数学上仍是 O(n^2) |
不改 KV 规模,但显著降 IO | 是 | 不改语义就能加速 exact attention | 主要解决 kernel,不解决状态规模 | 主流 GPU 训练与推理栈 |
| MQA | 共享单组 K/V |
计算同阶,decode 更省 | 很低 | 是 | 大幅降低 decode 带宽与 KV cache | 质量可能下降 | 高频吞吐型 decoder 服务 |
| GQA | 分组共享 K/V |
计算同阶,decode 更省 | 低 | 是 | 速度与质量折中最好 | 仍有一定表达损失 | Mistral、Llama 2 之后大量开源 LLM、Qwen |
| MLA | KV latent 压缩 | 计算依实现而定,状态显著更小 | 很低 | 通常为重参数化 exact/近 exact 路线 | 长上下文和大批量服务收益大 | 需要模型级改造 | DeepSeek-V2/V3 系列 |
参考资料
[1] Attention Is All You Need. https://papers.nips.cc/paper/2017/file/3f5ee243547dee91fbd053c1c4a845aa-Paper.pdf
[2] Attention Is All You Need. https://arxiv.org/abs/1706.03762
[3] Longformer: The Long-Document Transformer. https://arxiv.org/abs/2004.05150
[4] Big Bird: Transformers for Longer Sequences. https://arxiv.org/abs/2007.14062
[5] Rethinking Attention with Performers. https://arxiv.org/abs/2009.14794
[6] FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness. https://arxiv.org/abs/2205.14135
[7] Fast Transformer Decoding: One Write-Head is All You Need. https://arxiv.org/abs/1911.02150
[8] GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints. https://arxiv.org/abs/2305.13245
[9] Mistral 7B. https://arxiv.org/abs/2310.06825
[10] Kimi Linear: An Expressive, Efficient Attention Architecture. https://arxiv.org/abs/2510.26692
[11] 13+ Attention Mechanisms You Should Know. https://www.turingpost.com/p/attention-types
[12] DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model. https://arxiv.org/abs/2405.04434
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。