分布式系统过去几十年有一条很朴素的规律:只要状态太大,它就不会被轻易搬来搬去。数据库如此,搜索索引如此,LLM 推理里的 KVCache 也是如此。也正因为这样,prefill-decode disaggregation 虽然已经成了主流部署范式,真实的部署边界却始终停在单个数据中心里。你可以把 prefill 和 decode 分开,但很难把它们分到两个松耦合的网络域里去。
这篇论文《Prefill-as-a-Service: KVCache of Next-Generation Models Could Go Cross-Datacenter》真正有意思的地方,在于它提出了一个更大的判断:下一代模型如果继续沿着 hybrid attention 的方向演化,LLM serving 的系统边界就会从“同一个 RDMA 岛内做相位分离”,转向“跨集群、跨数据中心地把 prefill 作为远程服务来提供”。 这不是单靠网络优化得来的结果,也不是单靠模型压缩就自然发生的事。我的理解是,论文讲清楚了一个产业规律:模型先把 KVCache 这块“状态成本”压下来,系统设计才有资格重新谈异构部署和跨域调度[1]。
不过,先把边界讲在前面。这篇论文的证据强在“方向判断”和“量级测算”,弱在“公开可复现实装”。它给出了相当完整的系统设计、建模和案例研究,但结果主要来自实测 profile 加吞吐模型求解,而不是一个公开可运行的生产系统。因此,这篇文章最适合被读成一张路线图,而不是已经尘埃落定的行业标准。
一、单数据中心这堵墙,到底是怎么形成的
Prefill-decode disaggregation 之所以流行,并不复杂。prefill 更像算力问题,decode 更像显存带宽问题,把两者拆开,资源利用率会更高,系统也更容易单独扩容[2]。Mooncake 这类 KVCache-centric 系统,已经把这件事推进到了大规模生产环境[2]。但过去大家默认的前提是:prefill 产出的 KVCache 仍要在一个足够快的网络里转移给 decode,所以它们虽然逻辑上分离,物理上还是紧紧绑在同一个数据中心的高带宽互联里。
问题的根子不在“分开”这件事,而在“分开以后要搬多少状态”。论文把这个量定义成 KV throughput,也就是单个实例在单位时间内产出多少待传输的 KVCache[1]。这个指标一旦高到一定程度,系统结构其实没什么选择余地。以文中举的 MiniMax-M2.5 为例,在 8 张 H200 上,32K 输入长度时单实例的 KV throughput 大约已经到 60 Gbps;到 64K 时还会继续升到 61 Gbps 左右[1]。这不是一个普通的网络数字。它意味着一台机器光把自己 prefill 生成的状态往外送,就快把常见跨数据中心以太网链路吃满了。
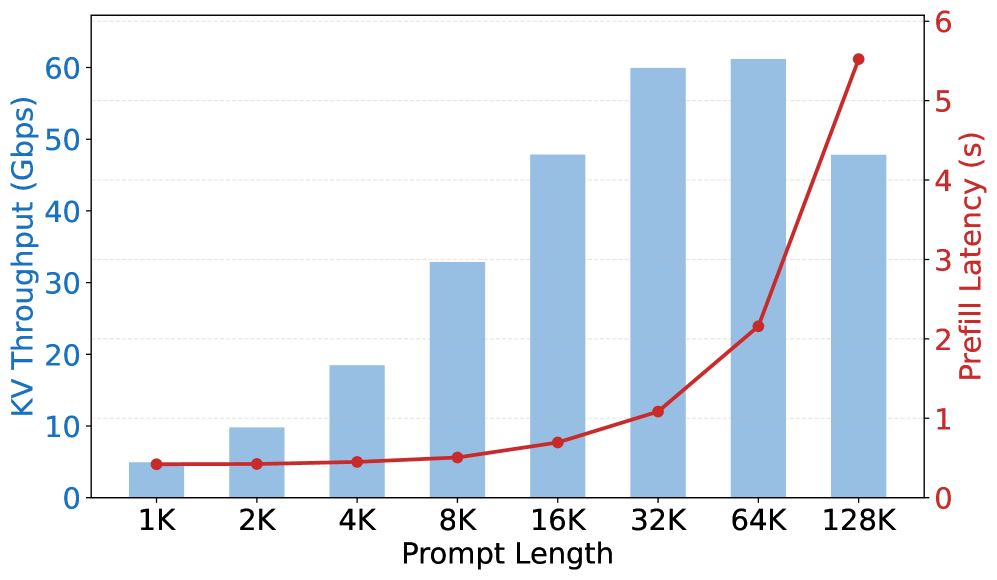
图 1:MiniMax-M2.5 在长上下文下的 KV throughput 随输入长度迅速上升,32K 请求已接近 60 Gbps。这张图说明,传统 dense attention 模型不是不能做 PD 分离,而是很难把 PD 分离推到跨数据中心。来源:论文 Figure 2。
再把视角拉到集群级,结论就更直白了。论文估算,一个由 512 张 H200 组成的 prefill 集群,如果运行 MiniMax-M2.5,大约需要 3.8 Tbps 的总出口带宽;即便是 Qwen3-235B,也还要 2.1 Tbps[1]。这种量级几乎等于宣布:如果模型还是传统 dense attention,异构 serving 想做也只能在同一个 RDMA 域里“硬塞”进去。于是系统被迫接受两个后果。第一,不同芯片必须尽量共址部署,这在现实里往往做不到。第二,prefill 和 decode 的硬件比例一旦定死,就很难随着流量结构变化而动态调整。
从工程史看,这很像早期数据库时代的 shared-nothing 系统。不是大家不知道分布式更灵活,而是状态移动太贵,架构自然会朝“把状态锁在本地”收敛。LLM 推理到 2025 年之前,基本也处在这个阶段。
二、真正把问题改写的,不是调度器,而是 hybrid attention
论文最有价值的一点,在于它没有把问题归咎于“今天的调度器还不够聪明”。作者的论证路径很克制:如果模型本身仍然维持高 KV throughput,那么再好的调度器也只能在局部做微调;只有模型先把 KVCache 变小,系统才会进入一个新的可行域[1]。
这正是 hybrid attention 出场的地方。过去一年里,Kimi Linear、MiMo-V2-Flash、Qwen3.5-397B、Ring-2.5-1T 这些模型都在做同一件事:用线性注意力、滑动窗口注意力,或者更小比例的 full attention,把需要完整 KVCache 的层数压缩下去[3][1]。这件事在模型论文里常被表述为“更长上下文、更低显存占用”,但在 serving 系统里,它真正改变的是网络预算。
文中的 Table 3 很有说服力。32K 输入长度下,Kimi Linear 的 KV throughput 是 3.87 Gbps,MiMo-V2-Flash 是 4.66 Gbps,Qwen3.5-397B 是 8.25 Gbps,Ring-2.5-1T 甚至只有 2.59 Gbps;而 dense 模型 MiniMax-M2.5 和 Qwen3-235B 分别是 59.93 Gbps 和 33.35 Gbps[1]。量级差距已经不是 10% 或 20%,而是一个数量级。Kimi Linear 自己的技术报告也给出相近方向的数据:它通过 KDA 和 MLA 的混合结构,把 KV cache 使用量最高压低到 75%,在 1M 上下文下的 decode throughput 最高做到 6 倍[3]。
这里最关键的判断是,hybrid attention 并没有自动解决跨数据中心 serving,它只是把“不可能”改写成了“有条件地可能”。 论文对此非常诚实。作者明确说,单靠更小的 KVCache 仍然不够,因为真实线上负载有 burst,有长短请求分布偏斜,有 prefix cache 命中不均,也有跨集群带宽波动[1]。换句话说,模型负责把门推开一道缝,系统负责决定怎么穿过去。
三、PrfaaS 真正做的,是把远程 prefill 变成一条“有选择”的路径
如果把这篇论文浓缩成一句话,那就是:不要把所有 prefill 都外包出去,只把那些足够长、足够值得、而且当前网络也扛得住的 prefill 送到远端。 这就是 Prefill-as-a-Service 的本质。
论文设计的 PrfaaS-PD 架构很清楚。请求先进入统一的 router,长请求且未命中足够 prefix cache 的那部分,才会被送往独立的 PrfaaS cluster 做 prefill;短请求则仍然留在本地的 PD cluster 中完成 prefill 和 decode[1]。前者用高算力、计算密度更高的加速器,后者用更适合 decode 的高带宽硬件。于是原来“必须把异构芯片塞进同一个 RDMA 域”的问题,被改写成“让不同集群通过 commodity Ethernet 交换一部分 KVCache”。
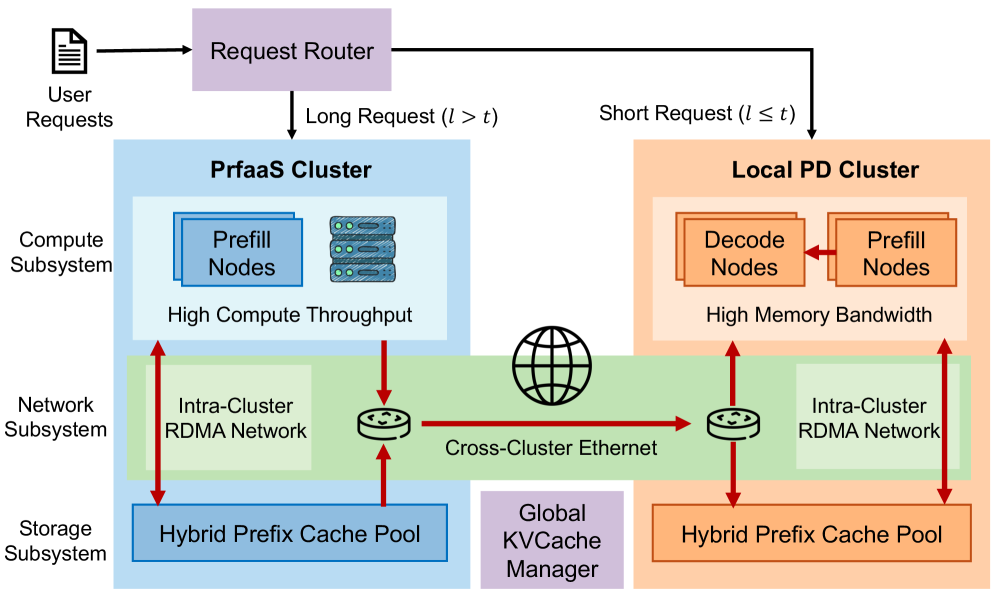
图 2:PrfaaS 把长请求导向独立 prefill 集群,把短请求留在本地 PD 集群,并通过跨集群以太网转移 KVCache。这张图说明,论文真正重新定义的不是某个算子,而是 prefill 和 decode 的物理部署边界。来源:论文 Figure 3。
如果事情只停在“按长度分流”,这篇论文的价值其实有限。它更值得讲的是缓存层的设计。Hybrid model 的状态并不统一:线性注意力或 SWA 的 recurrent state 更像 request-level state,需要完整匹配;full attention 层的 KVCache 则是 block-level state,可以做部分 prefix 复用[1]。因此,传统把所有层都当成同一种 KV block 来管理的做法不再成立。
作者在这里提出了一个 hybrid prefix cache pool。它把线性 attention 的状态和 full attention 的 KV blocks 分成不同 group,但底层又共用一个统一的 block pool;更细一点看,cache block 还被分成可复用的 prefix-cache block 和一次性跨集群传输后即丢弃的 transfer-cache block[1]。这听起来像实现细节,其实非常关键。因为一旦系统要在“本地复用”和“远程转移”之间同时优化,缓存对象的生命周期就不再一样。
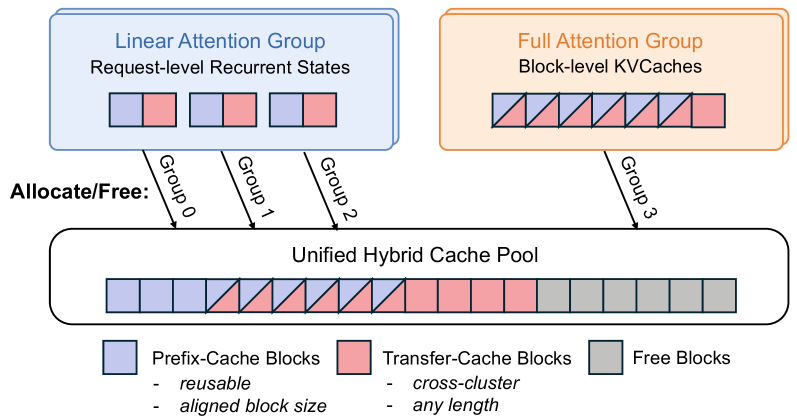
图 3:线性 attention 的 recurrent state 和 full attention 的 KVCache 被分组管理,但共享同一个混合缓存池;其中 prefix-cache block 和 transfer-cache block 的生命周期不同。这张图点出了论文最有工程味的一层:跨集群传输不是简单把原有 KVCache manager 搬远一点。来源:论文 Figure 4。
真正把这套架构串起来的,是调度策略。论文把短期和长期调度拆开来处理。短期里,系统盯的是 egress 带宽利用率和队列深度,一旦接近拥塞,就调高路由阈值,把更多中短请求留在本地;长期里,再根据流量和缓存分布重新优化 PrfaaS 集群和本地 PD 集群的资源分配[1]。从方法论上说,这一步其实很像互联网里常见的 admission control 和 traffic engineering:你不能只看平均值,还要看拥塞会在哪一瞬间突然出现。
四、这组结果为什么有说服力,又为什么还不能被夸大
论文的 case study 使用的是一个内部 1T 参数 hybrid 模型,结构遵循 Kimi Linear 的 KDA:MLA 3:1 设计;两端集群通过大约 100 Gbps 的 VPC 网络连接,远端 PrfaaS cluster 用 32 张 H200,本地 PD cluster 用 64 张 H20,请求平均输入长度约 27K,输出固定为 1024 token,SLO 设为 40 token/s[1]。就一个论文实验来说,这个设定已经相当具体。
最重要的数字有四个。第一,最优路由阈值大约是 19.4K token,此时 49.6% 的请求会被送到 PrfaaS 集群[1]。第二,跨集群总 egress 负载大约只有 13 Gbps,只占 100 Gbps 链路的 13%[1]。第三,整体吞吐达到 3.24 req/s,相比 96 张 H20 组成的 homogeneous PD baseline 的 2.11 req/s,提高了 54%;和 naive heterogeneous baseline 的 2.45 req/s 相比,也高出约 32%[1]。第四,P90 TTFT 从 homogeneous baseline 的 9.73 秒降到 3.51 秒,降幅 64%;均值也从 4.44 秒降到 2.22 秒[1]。
这些数字说明了一件很重要的事:PrfaaS 的优势不是“远端 H200 比本地 H20 快”,而是只把真正值得外包的那一半请求送出去,然后把本地集群腾出来做 decode 和短请求。如果没有这个选择过程,异构本身并不会自动变好。论文里的 naive heterogeneous baseline 就是证据。它把所有 prefill 都压到 H200 上,mean TTFT 甚至比 PrfaaS 还低一些,但系统吞吐只有 2.45 req/s[1]。这很像一辆短跑速度很快、但配重失衡的赛车。局部指标漂亮,不代表整套流水线最优。
不过,也正是在这里,我们应该把论文的边界看清。第一,结果主要来自 measured profiling data 加 throughput model 的求解,并非公开环境下长时间运行的端到端生产实验[1]。这类证据足以说明“设计在量级上说得通”,但还不能完全替代线上复杂抖动、故障恢复和多租户干扰下的实证。第二,作者虽然用的是“cross-datacenter”这个表述,实验链路实际上是 VPC 网络。它很能代表松耦合集群,却未必等同于跨城、跨区域甚至跨运营商的长距离 WAN。第三,论文使用的是内部 1T hybrid model,且实现没有开源,因此其他团队是否能在不同模型、不同 cache hit rate、不同地域网络条件下复现这些收益,还要继续观察。
换句话说,这篇论文最值得相信的,不是“54% 提升”这个单点数字会在任何环境里照搬,而是它揭示的那个拐点:当 KV throughput 从几十 Gbps 降到几 Gbps 时,系统设计的自由度会突然变大。
五、结论
我对这篇论文的判断是这样的:它真正提出的不是一个新的 serving trick,而是一条新的基础设施分工路线。过去我们默认 prefill 和 decode 的关系,类似同一工厂里两个相邻车间,中间靠极快的内部传送带连接;而 PrfaaS 想做的,是把 prefill 变成一个可远程调用、可独立扩容、甚至可部署在另一座数据中心里的专用产线。之所以现在开始有讨论价值,不是因为网络突然快了很多,而是因为下一代模型把需要搬运的“半成品”变小了。
这条路线能否成立,今后要看三件事是否同步发生。第一,hybrid attention 或其他 KV-friendly 架构继续成为主流;第二,KVCache 的压缩、复用和跨请求管理继续成熟;第三,硬件世界进一步走向 phase specialization,也就是 prefill 芯片和 decode 芯片越来越像两类不同机器[1]。如果这三件事同时发生,那么未来的大规模 LLM serving 很可能会像云计算早期那样,出现一次新的分层:算力留在最适合算力的地方,带宽留在最适合带宽的地方,而 KVCache 则成为贯穿两者的数据平面。
到那时,再回头看这篇论文,它的意义也许不在于某个具体阈值是 19.4K,或者某个实验里吞吐提升了 54%。更重要的是,它第一次比较完整地说明了,为什么“跨数据中心的 KVCache”不再只是一个听上去很激进的想法,而开始变成可以拿公式、流量分布和缓存命中率认真计算的工程问题。
参考资料
[1] Prefill-as-a-Service: KVCache of Next-Generation Models Could Go Cross-Datacenter. https://arxiv.org/abs/2604.15039
[2] Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving. https://arxiv.org/abs/2407.00079
[3] Kimi Linear: An Expressive, Efficient Attention Architecture. https://arxiv.org/abs/2510.26692
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。