版本声明:本文基于 Google Research 博客《TurboQuant: Redefining AI efficiency with extreme compression》与其文中引用的三篇论文:TurboQuant[1]、QJL[2]、PolarQuant[3]。
最近一年,大模型推理优化的重点已经越来越明确:真正卡住长上下文和高并发部署的,很多时候不是算力,而是内存和带宽。
尤其是 KV Cache。上下文一长、并发一高,显存压力会迅速膨胀。也正因如此,KV Cache 压缩成了推理系统里最值得下注的一条线。
Google 最新发布的 TurboQuant,就是冲着这个问题来的。它最抓人的地方有三个:一是把 KV Cache 压到 3 bit 级别;二是在多个长上下文 benchmark 上几乎无损;三是不需要训练或微调,直接面向线上推理场景[4]。
更重要的是,TurboQuant 不只是一个“大模型量化小技巧”,它其实在回答一个更底层的问题:高维向量,怎么才能压得足够狠,同时又不破坏后续计算质量? 这件事不仅影响大模型推理,也直接影响向量检索、语义搜索和 embedding 基础设施。
一、TurboQuant 到底在解决什么问题?
Google 在原文里反复强调一个核心概念:高维向量压缩。因为今天 AI 系统里大量关键对象,本质上都是向量:LLM 里的 key / value 是向量,embedding 检索里的索引是向量,图像、文本、多模态特征也是向量。
这些向量一旦规模变大,就会迅速吞掉大量内存。在 LLM 场景里,这个问题尤其直接:上下文越长,KV Cache 越大;batch 越大,并发越高,显存压力越大;memory bandwidth 很快会变成系统瓶颈。
所以,问题不是“能不能压缩”,而是:压缩之后,还能不能继续把 attention、相似度、检索质量保住。 这就是 TurboQuant 的目标。
二、传统量化为什么还不够?
Google 在博客里点出一个很关键但常被忽视的问题:传统向量量化虽然可以压缩数值,但经常需要额外存储 scale、归一化常数、codebook 等辅助信息。这些东西就是典型的 memory overhead[4]。
问题在于,很多方案纸面上看是 2 bit、3 bit、4 bit,实际一算上这些附加元数据,真实压缩率就被明显侵蚀了。Google 的说法很直接:这些额外开销可能会为每个数再增加 1 到 2 bit。这意味着你辛辛苦苦压下来的空间,可能又被“辅助信息”吃掉了一大截。
TurboQuant 真正想优化的,不只是低 bit 本身,而是:在极限压缩时,把隐藏的附加开销也一起压下去。
三、TurboQuant 的核心思路:两段式压缩
TurboQuant 不是一个单点技巧,而是一个组合式框架。它的核心设计可以概括成两步。
第一步,是用高质量量化完成主体压缩。Google 博客把这一阶段概括为 “PolarQuant method”,而论文里的核心思想则是:先对向量做随机旋转,把数据映射到一个统计性质更可控的空间;再在这个空间里做接近最优的标量量化,从而用绝大多数 bit budget 抓住向量的主语义和主强度[1]。
第二步,是专门拿出 1 bit 左右的预算处理残差误差。这里用到的是 QJL(Quantized Johnson-Lindenstrauss)。它不是重新编码全部信息,而是专门消除第一阶段残差带来的偏差,让最终的 attention score 或内积估计更可靠[2]。
TurboQuant 最聪明的地方,就在于它没有简单把位宽一路堆高,而是把主体信息和残差偏差分开管理:主体用高质量量化压下来,残差再用极低成本的 QJL 去修正。
四、QJL 和 PolarQuant,分别厉害在哪?
1. QJL:零额外开销的无偏 1-bit 技巧
QJL 基于 Johnson-Lindenstrauss 变换的思路,用随机映射把高维向量压到更低维,再把每个坐标进一步压成只保留符号位,也就是 +1 / −1。它听起来非常激进,但它的目标不是精确重建原向量,而是尽量保住下游计算最关心的东西——尤其是内积估计的无偏性[2]。
QJL 的优势在于三点:一是只保留 sign bit,存储极轻;二是几乎没有传统量化那样的额外元数据开销;三是它特别适合拿来处理 MSE 量化留下来的残差偏差。
2. PolarQuant:从坐标表达方式本身消除 overhead
相比之下,PolarQuant 更像这组工作里最有“新方法味道”的部分。它的核心思路不是继续在笛卡尔坐标里做小修小补,而是直接改变向量的表达方式:把向量转成类似极坐标的表示,拆成 半径(radius) 和 角度(angle),再递归处理半径部分[3]。
Google 给出的直觉是:角度的分布更集中、边界更可预测,因此量化器可以工作在一个更稳定的“圆形网格”上,而不必像传统方法那样反复依赖 normalization 和额外边界参数。说白了就是:如果你换一种更贴合数据结构的坐标表达,量化器就不必一直带着一堆辅助说明书。
五、效果到底有多强?
Google 给出的实验结果,至少在纸面上非常亮眼。
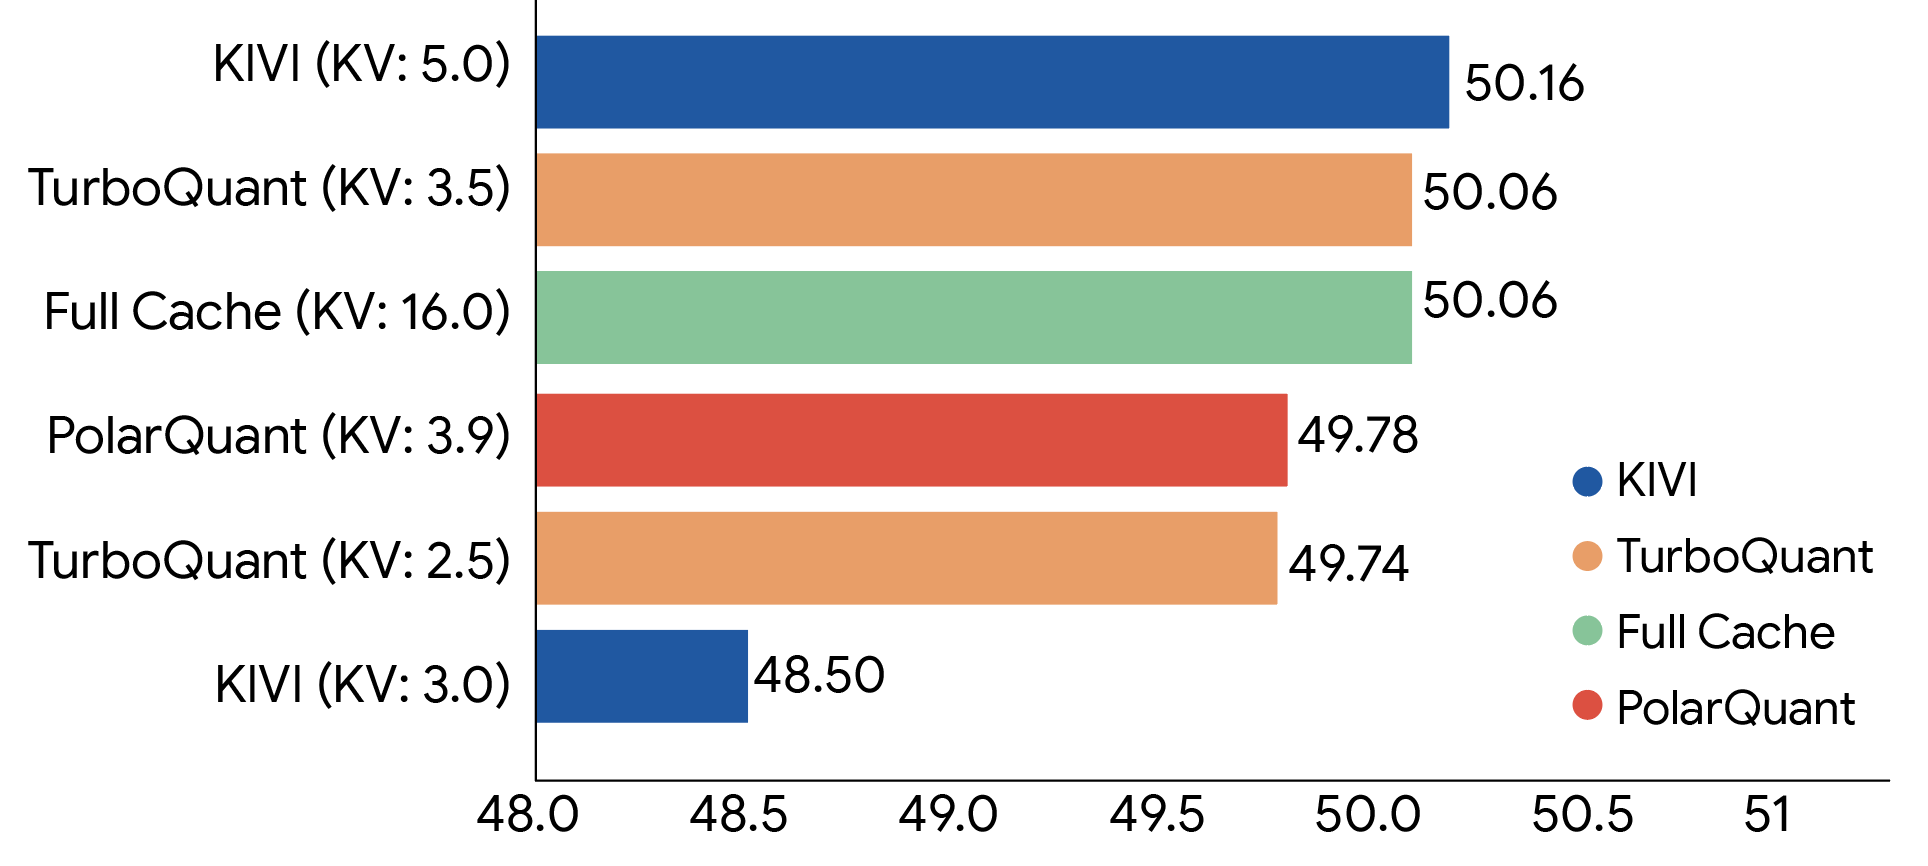
首先是在 KV Cache 压缩上。Google 明确表示,TurboQuant 能将 KV Cache 压缩到极低位宽,而且:不需要训练、不需要微调、模型效果几乎不受影响[4]。论文里的更细节表述是:在 3.5 bit 配置下,质量几乎完全中立;在 2.5 bit 配置下,也只带来轻微下降。Google 博客将这一结果概括为“压到 3 bit”,本质上是对 2.5/3.5 bit 档位的传播性表述[1]。
其次是在长上下文任务上。Google 测了 LongBench、Needle In A Haystack、ZeroSCROLLS、RULER、L-Eval 等多组 benchmark,覆盖问答、总结、代码生成、长文本定位等任务。结论是:TurboQuant 在 dot product distortion 和 recall 上表现最优,并且在 needle-in-a-haystack 这类任务中达到接近完美的 downstream results,同时把 KV memory size 至少压低 6 倍[4]。
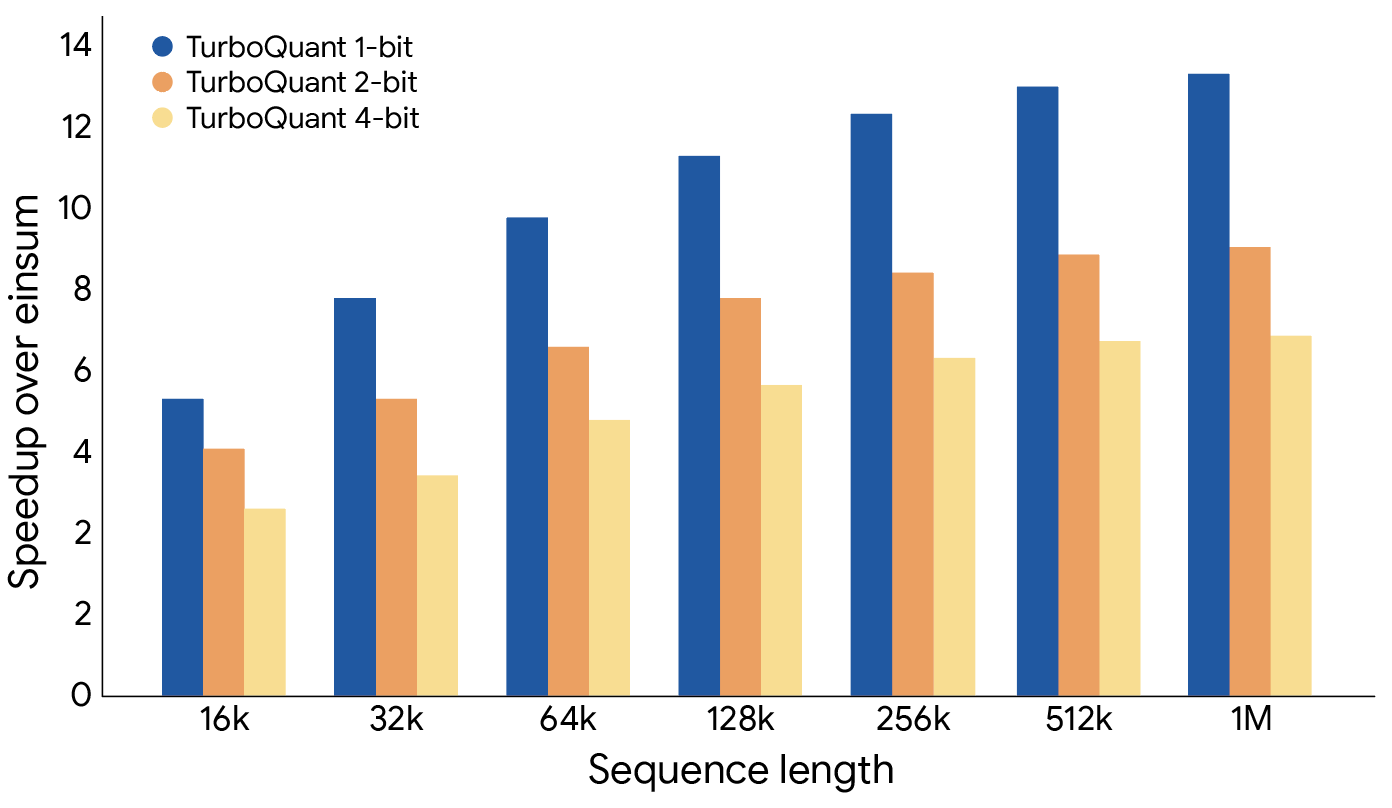
第三个亮点是速度。量化不一定天然更快,很多方案会把收益消耗在解码、反量化和访存转换上。但 Google 给出的结果是:在 H100 上,4-bit TurboQuant 相比 32-bit 未量化 key,attention logits 计算最高可提速 8 倍[4]。如果这类收益能在更多系统实现中复现,它就不仅是“省内存”,而是真正可能改写推理系统吞吐与成本结构的技术。
六、为什么它不只影响大模型,还会影响向量搜索?
Google 在文章里反复强调,TurboQuant 不只是给 LLM 用的,它同样适合 vector search。原因很简单:向量检索系统本质上也是在管理海量高维向量,构建索引和查询时同样受内存和带宽约束。
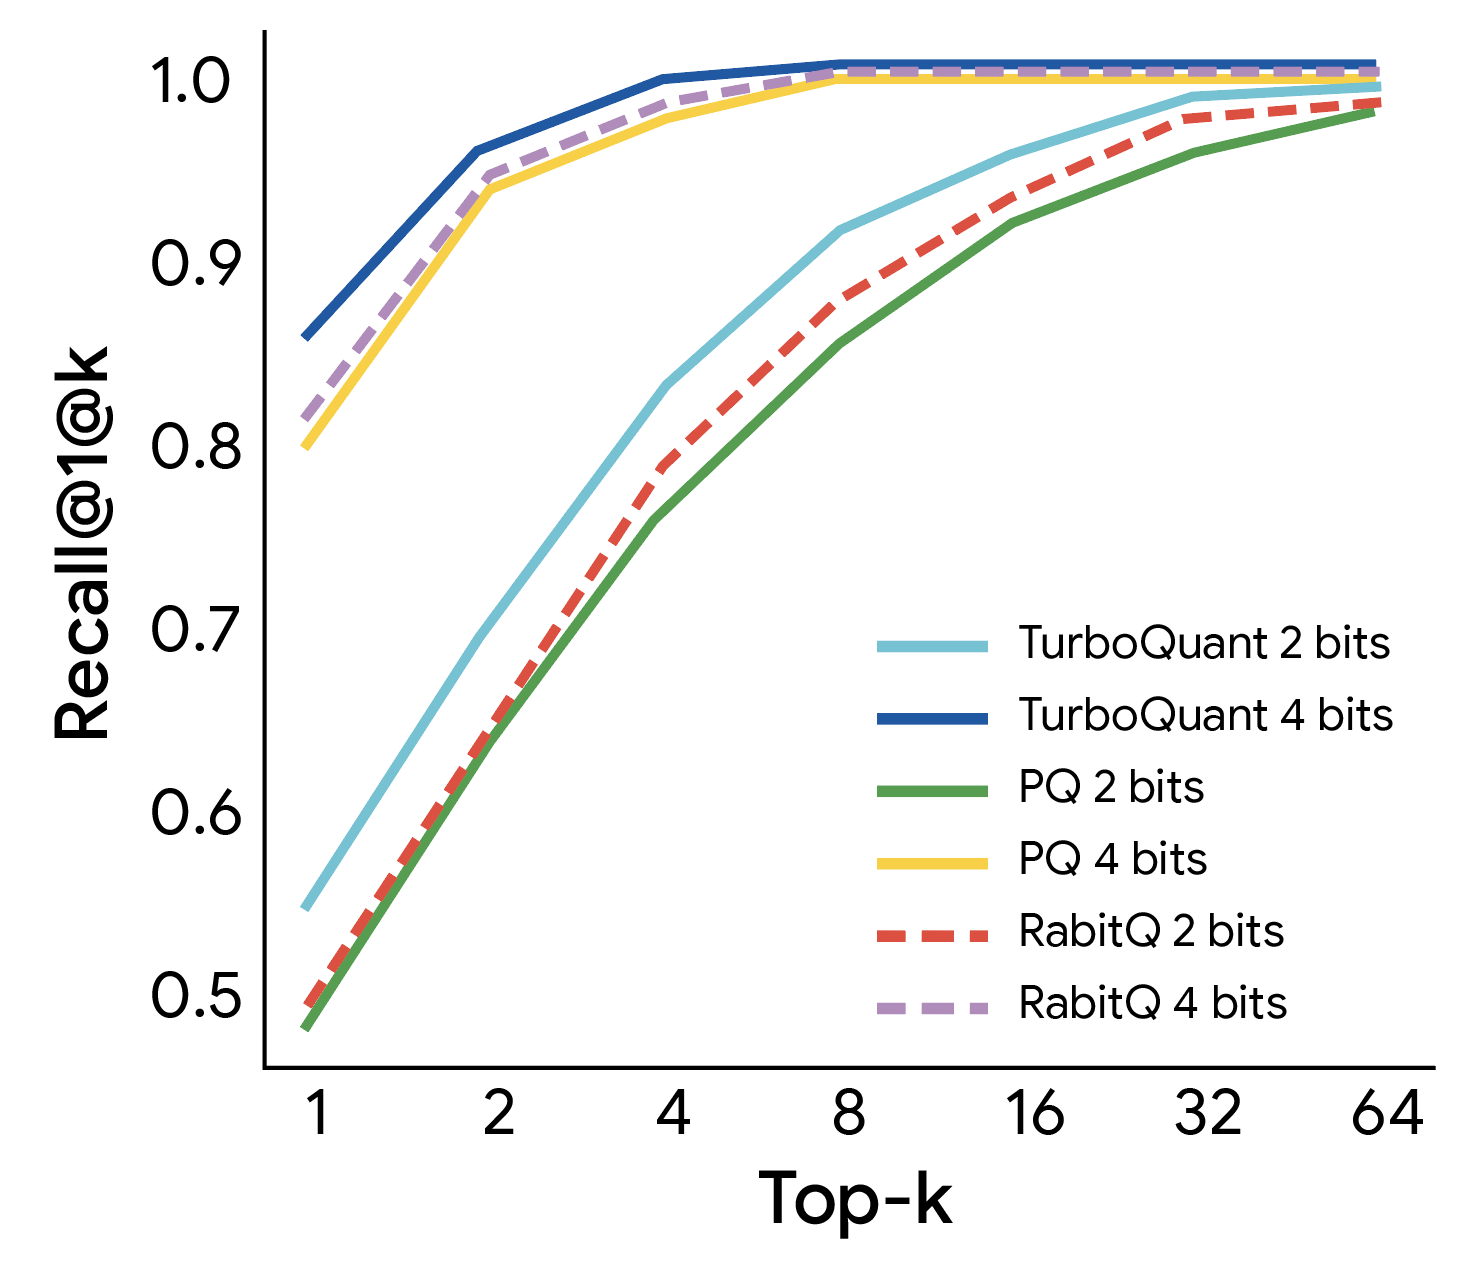
Google 把 TurboQuant 和 PQ、RabbiQ 等方法做了比较,用的是 1@k recall ratio 指标。结论是:TurboQuant 在 recall 上持续优于这些基线,而且不依赖大 codebook,也不靠 dataset-specific tuning[4]。这说明它不仅适合大模型 KV Cache,也可能成为语义搜索、向量数据库和 embedding 检索的一块底层基础设施。
换句话说,TurboQuant 要解决的不是一个模型问题,而是一类 AI 系统问题。
七、这项工作的真正意义是什么?
如果只用一句话概括,我会这么说:TurboQuant 不是在回答“怎么把模型压小一点”,而是在回答“怎么让 AI 系统用极低内存继续保持高质量计算”。
它真正值得关注的地方有三点。第一,它抓住了推理时代最贵的资源:显存、带宽、吞吐和成本。第二,它把“低 bit 压缩”从一个部署技巧,推进成了更像系统级能力的东西。第三,它让 LLM 推理优化和向量检索优化共享了一套更统一的底层方法论。
Google 在文章最后特别强调,这三项工作不只是工程技巧,而是有强理论证明支撑的基础算法贡献,且接近理论 lower bounds[4]。如果这些结果后续能在更广泛的模型和系统里继续成立,那么它的影响不会只停留在论文里,而会进入大模型推理引擎、长上下文基础设施、向量数据库和语义搜索系统的底层设计中。
对所有在做 LLM infra、检索系统、推理优化的人来说,这篇工作都值得认真看。因为它回答的是一个越来越关键的问题:在 AI 进入基础设施时代之后,我们还能把高质量计算的成本压到多低?
参考文献
[1] Amir Zandieh, Vahab Mirrokni, et al. TurboQuant. arXiv, 2025. https://arxiv.org/abs/2504.19874
[2] Amir Zandieh, Majid Daliri, Insu Han, Vahab Mirrokni. Quantized Johnson-Lindenstrauss and Approximate Near Neighbors. arXiv, 2024. https://arxiv.org/abs/2406.03482
[3] Amir Zandieh, Praneeth Kacham, Majid Hadian, Insu Han, Vahab Mirrokni. PolarQuant: Quantizing While Learning the Geometry of Data. arXiv, 2025. https://arxiv.org/abs/2502.02617
[4] Google Research Blog. TurboQuant: Redefining AI efficiency with extreme compression. 2026-03-24. https://research.google/blog/turboquant-redefining-ai-efficiency-with-extreme-compression/
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。