版本历史
版本 日期 说明 v1.0 2026-03-14 初稿,基于 SGLang commit 0de0d74(2026-03-05),覆盖 RadixAttention、prefix caching 生命周期、cache-aware 调度与 HiCachev1.1 2026-05-09 修订更新:纳入 HiCache 生产数据(Novita AI / Ant Group,2025-09)、HiCache 3FS/DSA 后端扩展(2026-04)、SLRU 淘汰策略、adaptive prefill delayer(2026-05);新增第八节 HiSparse 与 ShadowRadix 涉及源码的描述以 v1.0 对齐的
0de0d74为基准,v1.1 新增内容均注明时间或版本。
很多系统在讨论 KVCache 时,默认会把问题定义成”如何管理一块不断膨胀的显存资源”:怎么分页、怎么回收、怎么复用、怎么避免碎片。这套问题定义当然成立,但直接套到 SGLang 上往往会漏掉它最关键的一层。SGLang 把共享前缀本身放到系统的中心位置,这个起点决定了它和大多数推理框架的本质差异。
这也是本文要回答的核心问题:SGLang 到底如何理解和管理 KVCache? 最准确的说法是:它把共享前缀组织成 runtime 的第一抽象,再让底层 page/KV 存储、调度与分层缓存围绕这层抽象展开。SGLang 优先暴露给系统上层的,是”哪些前缀可以共享、它们现在在哪一层、怎样继续被命中和保护”;per-request 的页面分配是次级关注点。
一、共享前缀,才是问题的真正起点
SGLang 最早切入的问题,就不是单请求推理,而是复杂 LLM workload 里的共享前缀。LMSYS 在早期文章里列出的 few-shot、多轮对话、self-consistency 和 tree-of-thought 等场景,本质上都在反复复用同一段 prompt 骨架;如果系统每次都从头做 prefill,那么大量计算其实是在重复消费已经出现过的上下文[1]。
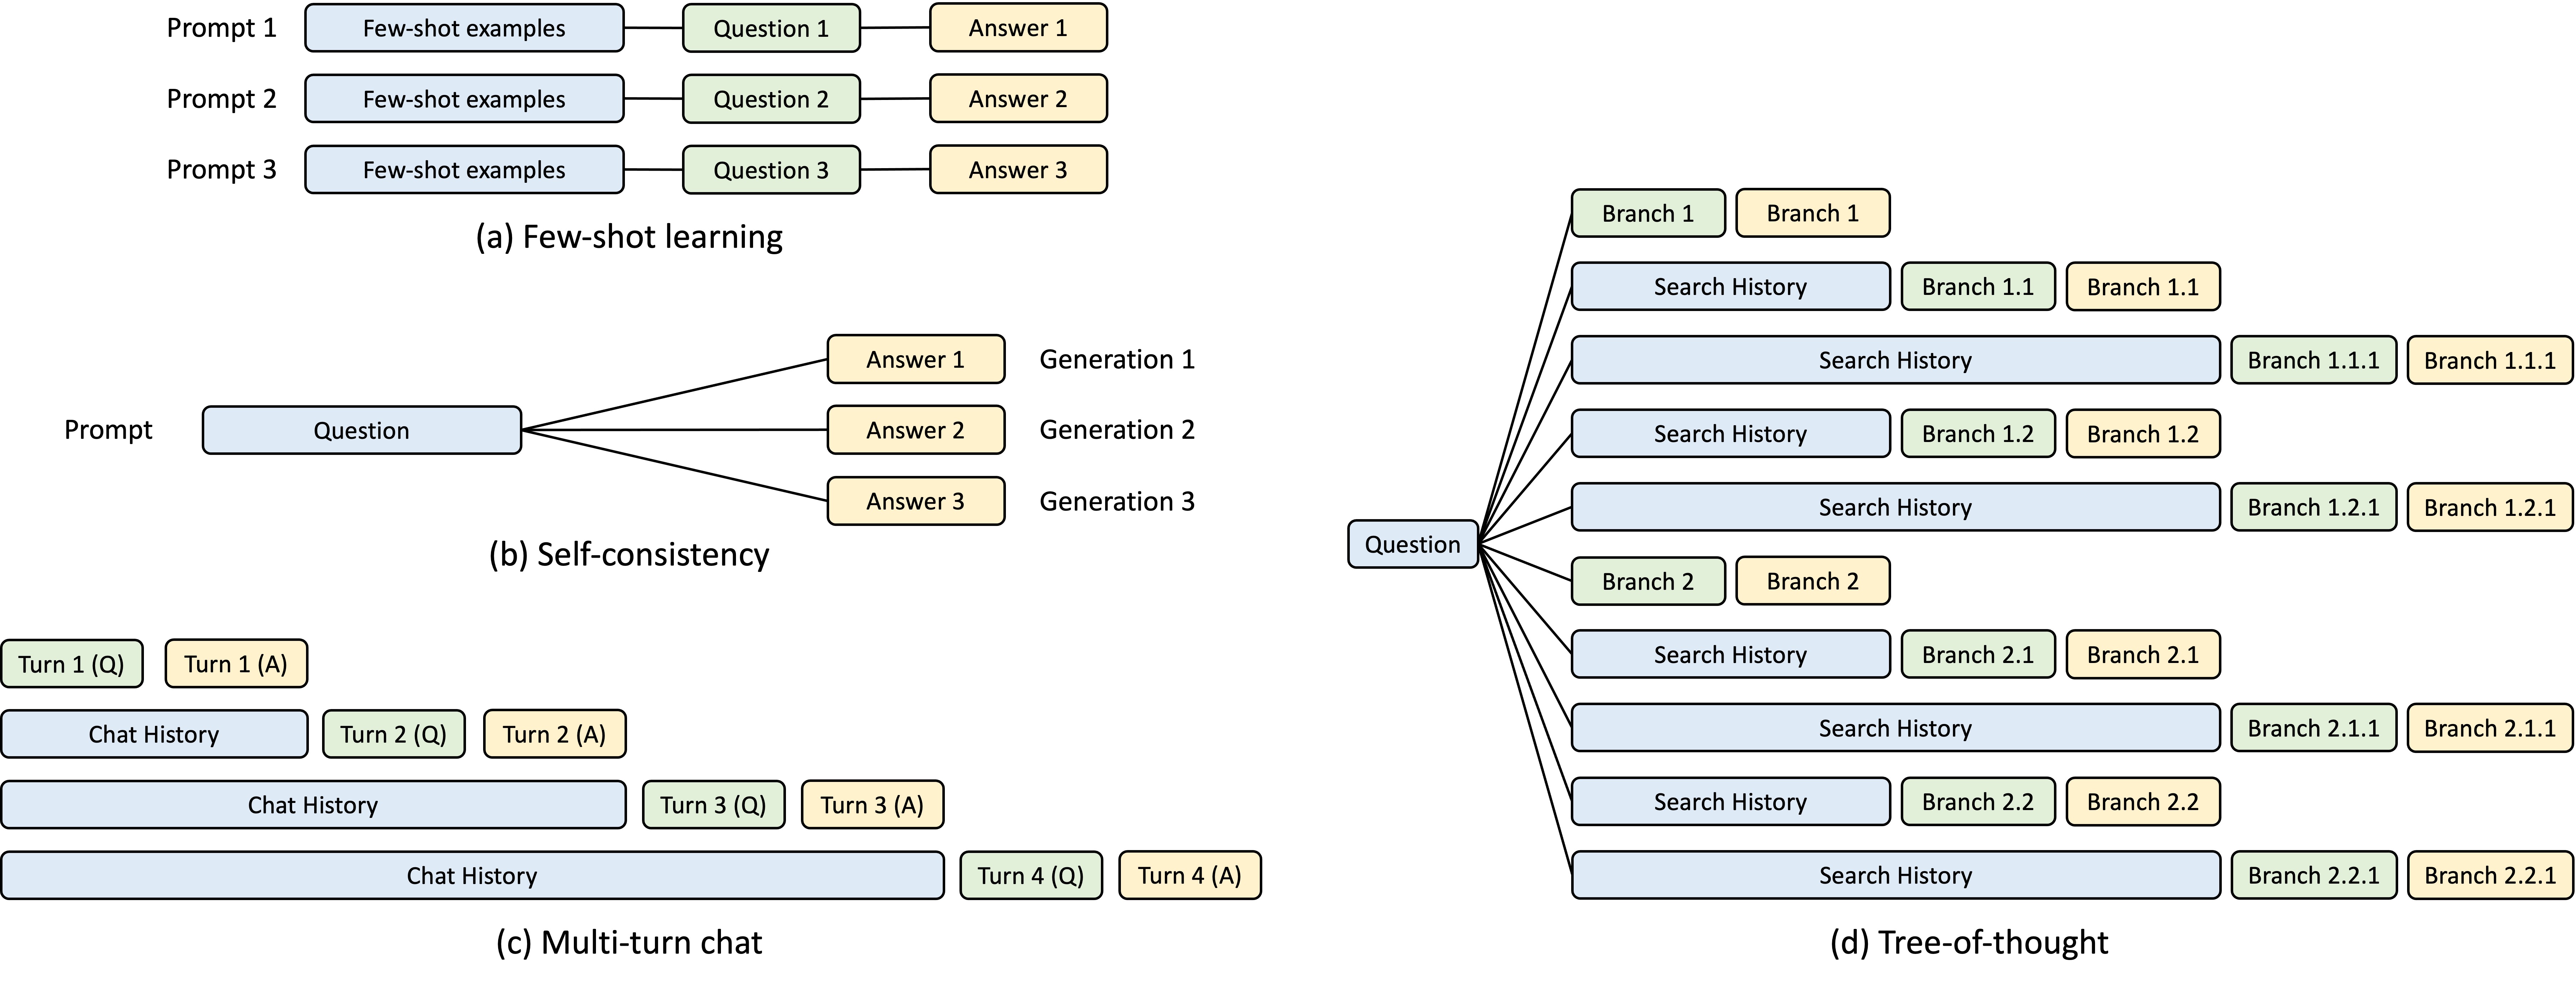
图 1:LMSYS 早期 blog 中的共享前缀 workload 示例。重点不是”某些请求刚好相似”,而是很多典型 LLM workload 天然具有可共享的前缀骨架[1]。
这一步很重要,因为它决定了系统抽象的起点。把 KV 先看成 per-request buffer,自然会优先围绕 page、block、slot 组织运行时;把问题先定义成”哪些历史前缀值得长期保留,并在后续请求里再次命中”,系统首先要组织的就是请求之间共享的前缀关系。SGLang 的 KVCache 主线,正是从这里分叉出去的。
二、RadixAttention:为什么共享前缀会成为第一抽象
SGLang 对这个问题给出的第一个系统性答案,是 RadixAttention。LMSYS 最早对它的描述,并不是”一个更快的 attention kernel”,而是一种围绕共享前缀组织缓存与复用的机制[1]。这一点和当前源码的文件级定位是对得上的:radix_cache.py 的开头直接把 radix tree 定义为“用于管理 KV cache 的数据结构”[2]。这个表述说明 radix tree 在 SGLang 中的角色不是辅助索引,而是 KV cache 管理的核心结构之一。
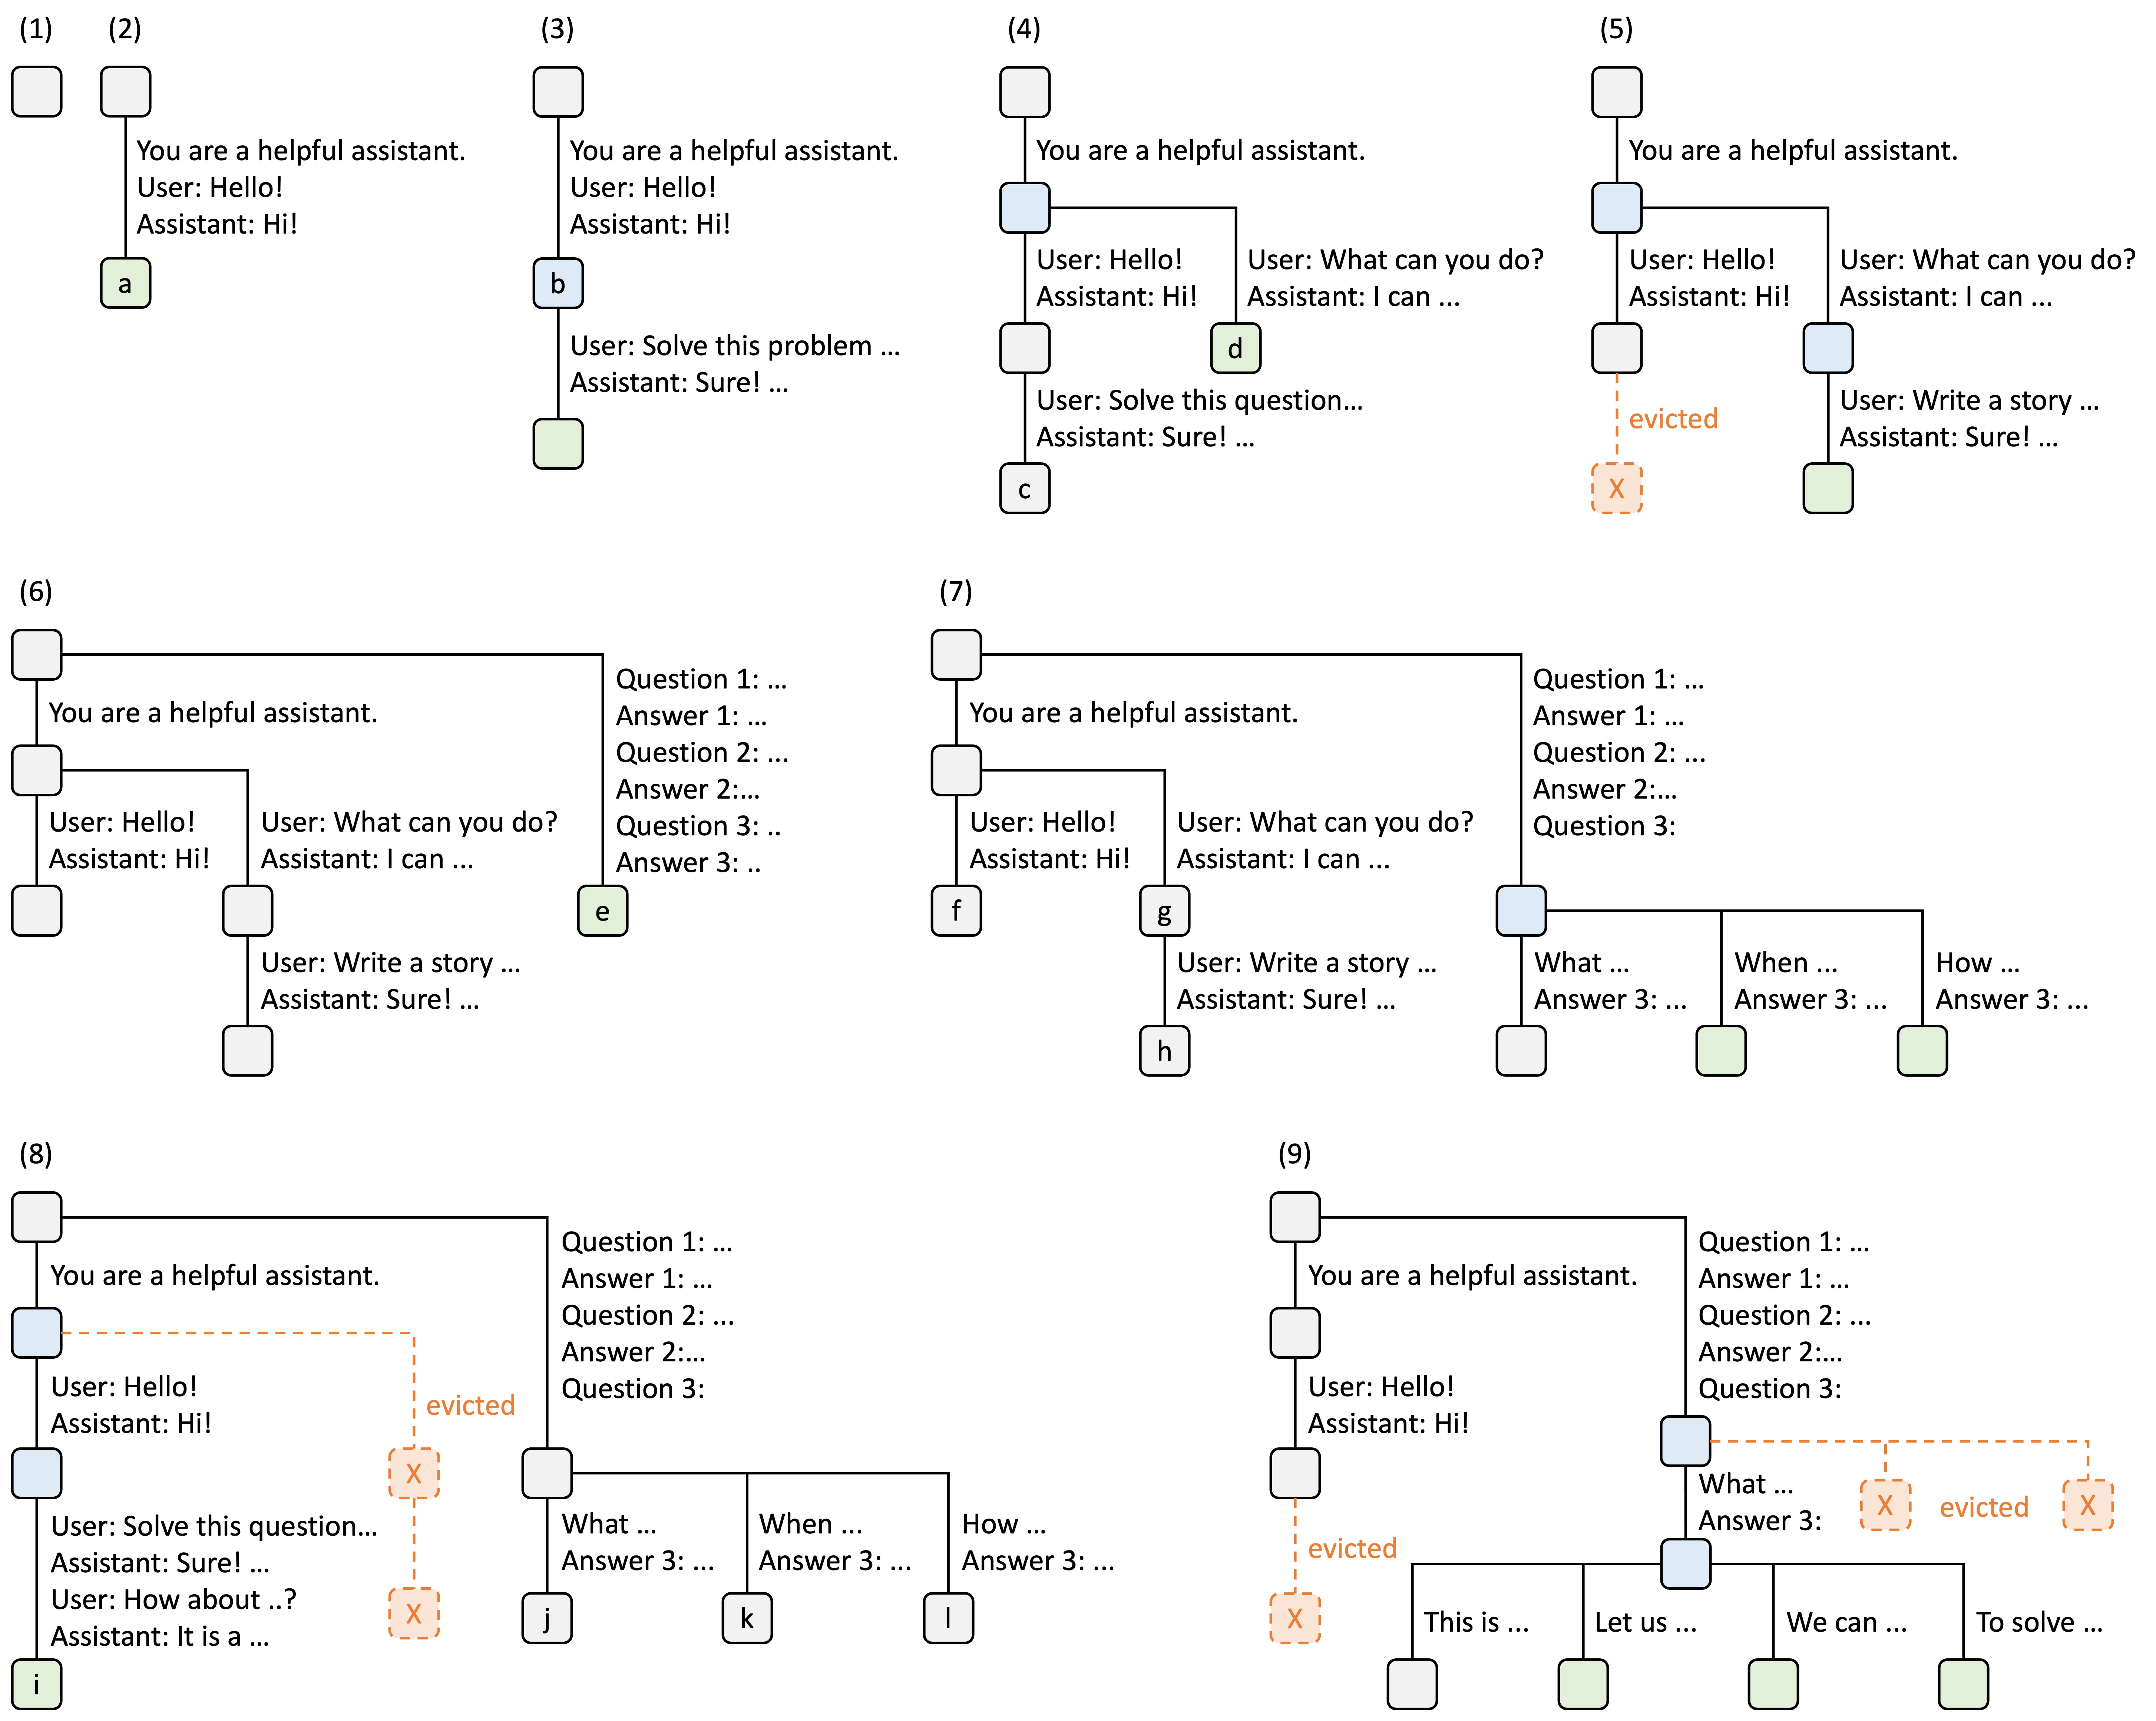
图 2:RadixAttention 的关键不是”树形结构好看”,而是它把共享前缀变成了可搜索、可插入、可淘汰、可保护的运行时对象[1]。
1. RadixKey:前缀不是裸 token 序列,而是带命名空间的匹配键
从实现看,SGLang 并不是直接把 token 列表塞进树里,而是先封装成 RadixKey。这个对象除了 token_ids 外,还有两个重要字段:extra_key 和 is_bigram[2]。extra_key 表示匹配命名空间,用来隔离不同 LoRA、不同 cache salt 或其他不应共享状态的请求;is_bigram 则用于 EAGLE 场景下的 bigram key 变换。
SGLang 的 prefix reuse 是带命名空间边界的复用——系统先确认两个请求可以共享同一条缓存生命周期,才会让它们进入同一棵树,而不是”只要 token 前缀相同就共享”的无条件复用。从工程角度看,这个边界很重要:防止不同 LoRA adapter 或不同租户之间的缓存串扰。
2. page 对齐压在底层
RadixAttention 虽然强调 prefix tree,但并不意味着它忽略底层 page 粒度。page_align_keys()、_key_match_paged(...) 和 match_prefix() 里的 page 对齐逻辑都表明:当 page_size > 1 时,key 会先被截断到 page 对齐长度,后续匹配也不是逐 token 进行,而是按 page 粒度比较[2]。
page 在 SGLang 中的位置:它被压在 prefix tree 的底层实现里,服务于上层的 prefix-first 组织方式。SGLang 的 prefix cache 有 page 对齐的边界限制,并非任意 token 粒度的命中。
3. TreeNode:树节点已经是缓存生命周期对象,而非纯逻辑前缀
TreeNode 的字段很能说明问题。它不只维护 children、parent、key、value,还维护 lock_ref、last_access_time、creation_time、hit_count、host_ref_counter、host_value、hash_value、priority 及 pin 相关状态[2]。
这组字段意味着,树节点承载的不是”某段文本前缀”的纯逻辑语义,而是 prefix 对应 KV 的实际生命周期状态:当前有没有 device value、是否有 host 备份、是否被请求锁住、最近是否被访问、eviction 里优先级如何、是否已按 page 计算 hash。TreeNode 已经是 prefix 语义与缓存生命周期的统一对象。
4. match_prefix() 并不是纯读操作,它会主动精化树结构
match_prefix() 的实现和注释都很值得细读。它不仅返回最长缓存前缀,还明确说明:如果匹配结束在某个已存储 segment 的中间,系统会通过 _split_node() 把精确边界切出来,从而提高后续匹配效率[2]。prefix match 在 SGLang 中不只是”查一查有没有命中”,它还会驱动树结构的进一步显式化。
_split_node() 的逻辑很直接:创建一个新的 new_node,把 child 被命中的前缀部分切出来归给 new_node,让 child 保留剩余 suffix,同时把 hash_value 也按 split_len 和 page_size 一起拆开[2]。SGLang 并不是把整条请求路径原封不动地挂在树上,而是会在共享边界出现时,把”共享前缀”提炼成显式节点。
5. insert():系统沿共享路径合并,只为新的 suffix 建增量节点
_insert_helper() 的行为和普通”把 key 插入树里”的直觉不完全一样。它会沿已有路径不断前进,更新访问时间和 priority;如果中途只部分匹配,也会先 split;只有剩余 suffix 才会真正新建节点[2]。插入过程的逻辑是”先最大化复用已有共享前缀,再把新的增量部分挂上去”,每个请求独占一条新路径的假设在这里不成立。
从 RadixAttention 的实现视角看,SGLang 管理的并不是一组彼此独立的 request-local buffers,而是一棵会不断显式化共享边界、并用节点生命周期表达复用关系的 prefix tree。
三、Prefix caching 不是旁路功能,而是请求生命周期和调度器的一部分
仅仅把 prefix 存进树里还不够,真正关键的是:prefix caching 如何进入 request lifecycle 与 scheduler。 这一点在 BasePrefixCache 和调度相关实现里体现得很清楚。
1. BasePrefixCache:prefix caching 被定义成 runtime 接口,而不是 feature API
BasePrefixCache 对外暴露的抽象包括:match_prefix、cache_finished_req、cache_unfinished_req、evict、inc_lock_ref / dec_lock_ref、init_load_back、ready_to_load_host_cache、check_hicache_events[3]。
前四项代表 prefix cache 已经参与普通请求生命周期;后三项说明它从一开始就为 host load-back 与 HiCache 活动预留了扩展位。这组接口表明,prefix cache 在 SGLang 里是可扩展到分层缓存的 runtime 接口,而非后补功能。
2. cache_finished_req() / cache_unfinished_req():请求会持续把自身状态提交回 prefix tree
cache_finished_req() 的流程是:从 request 中取出已提交的 KV 长度和对应 KV indices,对 token 做 bigram 转换和 page 对齐,构造 RadixKey,执行 insert(),然后把已经在树里存在的重复 KV 释放掉,并最终对 req.last_node 执行 dec_lock_ref()[2]。
cache_unfinished_req() 更能体现它与请求生命周期的耦合:它会对当前 fill_ids 对应的 KV 先做 insert,再重新调用 match_prefix() 拿回新的 device_indices 与 last_node,回写到 req_to_token_pool,更新 req.cache_protected_len、req.prefix_indices 和 req.last_node,同时完成旧锁释放与新锁获取[2]。
SGLang 的 request 不只是在使用 prefix cache,它也在持续把自身执行结果提交回 prefix cache,再反过来复用更新后的树结构。 prefix cache 不是请求结束后再做的”归档缓存”,而是请求进行中就会持续回流并改写 request 自己的 KV 视图。
3. evict() / lock_ref:prefix tree 直接承担缓存保护与淘汰语义
evict() 会从 evictable_leaves 中取叶子,基于 LRU / LFU / FIFO / MRU / FILO / Priority / SLRU 等策略构建堆,free 掉对应 value 后删除叶子,并可能把父节点继续加入可淘汰集合[2]。其中 SLRU(Segmented LRU)是后续加入的第七种策略:它把缓存分成”受保护段”和”试用段”,命中会晋升、未命中进入试用,在高复用率场景下比纯 LRU 的冷启动性能更好。
inc_lock_ref() / dec_lock_ref() 则会沿路径向上更新节点的 lock_ref,并同步维护 evictable_size_ 与 protected_size_[2]。prefix tree 不只是记录”哪些前缀能命中”,它还直接决定哪些缓存当前可淘汰、哪些被请求保护。树结构本身就是 eviction bookkeeping 的核心载体。
四、Prefix 命中如何进入 scheduler:SGLang 的调度器会显式感知 tree cache
SchedulePolicy 的实现表明,SGLang 并不把 prefix hit 当作一个与调度器无关的底层细节。代码里明确区分了 CacheAwarePolicy 和 CacheAgnosticPolicy 两类策略;其中前者包括 LPM 和 DFS_WEIGHT,即”最长前缀命中优先”和”基于树权重的深度优先”[4]。
_compute_prefix_matches() 的流程尤其关键。对于等待队列中的每个请求,系统会把 origin_input_ids + output_ids 拼成 prefix_ids,再用 tree_cache.match_prefix() 计算匹配结果,并把 prefix_indices、last_node、last_host_node、host_hit_length 这些信息回写到请求对象[4]。prefix 命中结果并不是局部临时变量,而是调度器显式维护的 request state。
之后,不同的 cache-aware policy 会直接利用这些信息改变等待队列顺序:
- LPM:优先调度拥有更长已命中前缀的请求[4];
- DFS_WEIGHT:先按
last_node对请求聚类,再沿 prefix tree 计算权重并做深度优先排序,优先跑共享路径收益更大的那簇请求[4]。
代码里还专门维护了一个 waiting_queue_radix_tree = RadixCache.create_simulated(),用来做 in-batch prefix caching:即便某个请求对已有 cache 命中不长,只要它和 waiting queue 里的其他请求共享前缀,系统也会倾向于先调度一部分请求,以便后续在批内形成更高的前缀复用收益[4]。
(v1.1 更新) 2026 年 5 月,调度器引入了 adaptive queue-based prefill delayer trigger:在 prefix cache 命中率较低、等待队列积累了大量可复用请求的情况下,调度器会主动推迟 prefill 启动,让更多共享前缀的请求先进入队列再批量处理,在整批维度提高 cache 命中收益。这是 cache-aware scheduling 从”被动利用命中结果”迈向”主动塑造队列构成”的一步延伸。
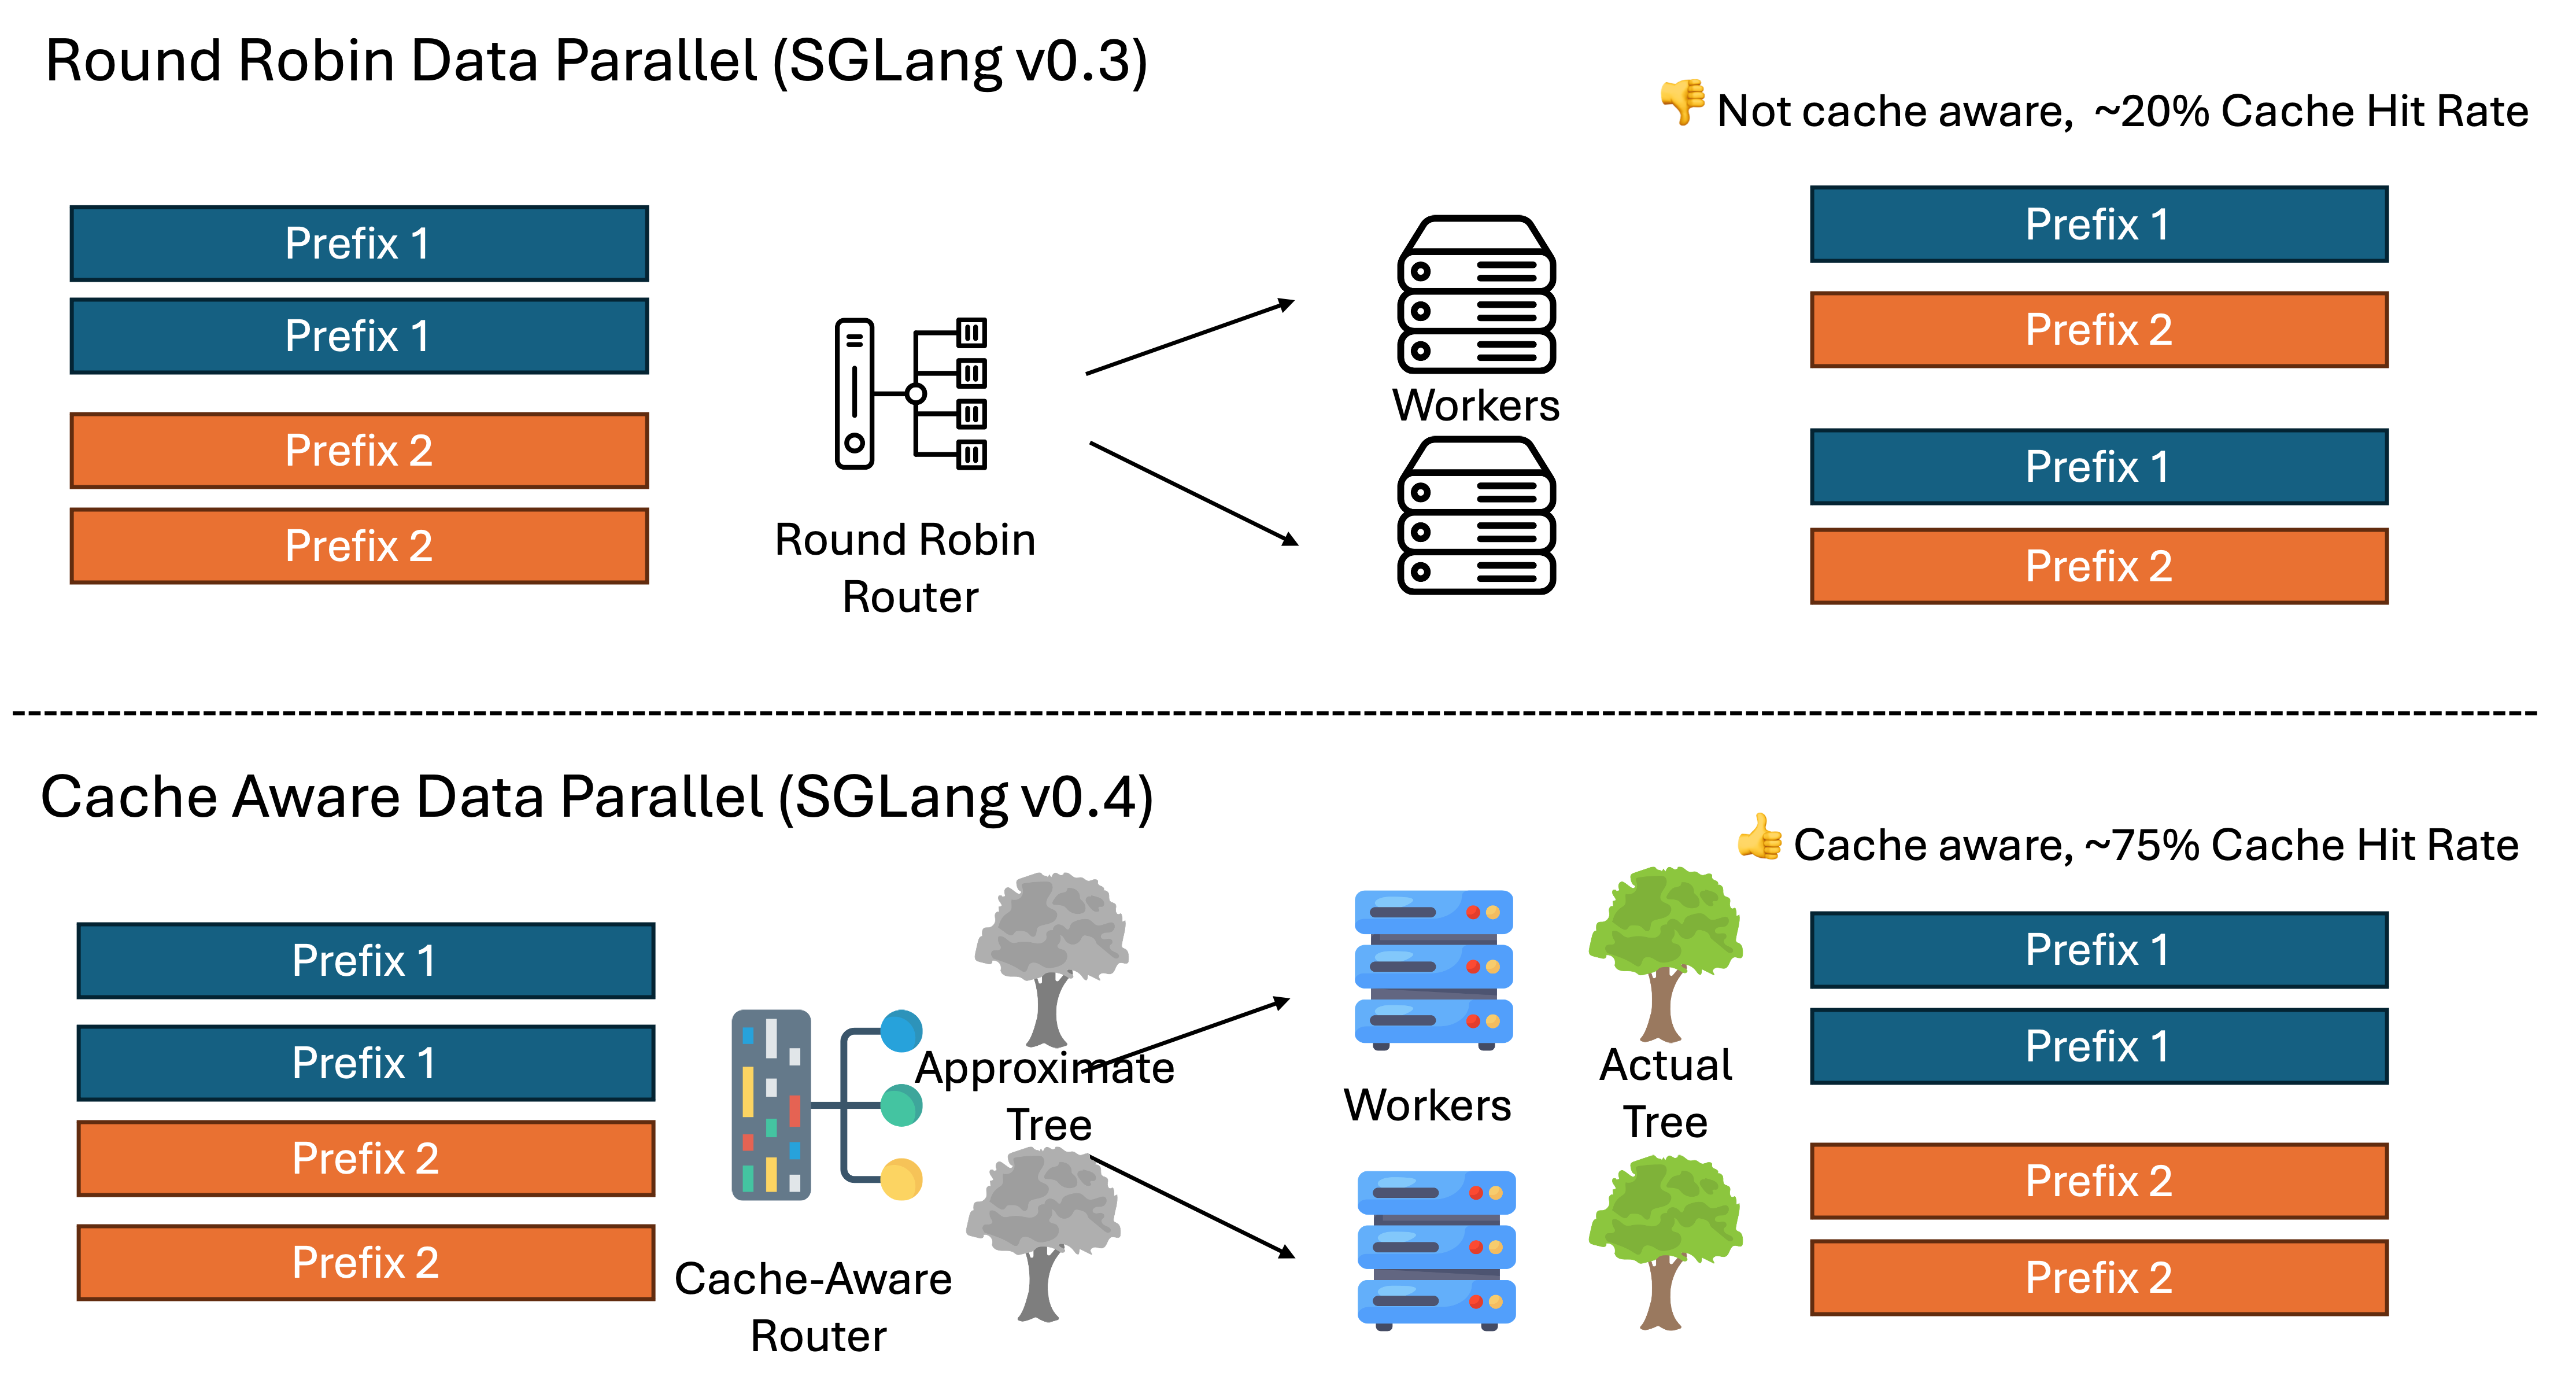
图 3:cache-aware load balancer 可以看作同一条 prefix-first 逻辑在多实例路由层的外推:请求不再只按平均负载分发,而要尽量落到最可能命中已有前缀的 worker 上[5]。
这也解释了为什么 LMSYS 在 v0.4 文章里会进一步把 cache-aware 思路扩展到 load balancer:一旦承认”共享前缀是系统资产”,那么从单机 scheduler 到多 worker 路由,最自然的延伸就是继续围绕”哪里最可能命中已有前缀”来组织请求流[5]。
五、底层 page / KV 存储:支撑层而非主抽象
到这里需要非常克制地说清楚一点:把 SGLang 概括为 prefix-first runtime,并不等于它没有 paged KV、没有 memory pool、没有底层 layout。恰恰相反,当前实现里 page 粒度非常明确:match_prefix() 会先做 page 对齐截断,HiCache 文档也专门讨论了 --page-size、layer_first、page_first 与 page_first_direct 的差异[2][6]。
但这些细节在 SGLang 中的角色,更像是在支撑上层的 prefix-first 组织方式。HiCache design 文档给出的叙事顺序很能说明这一点:它先定义的是 HiRadixTree,说明每个节点对应一段连续 token span 的 KV,并记录这段 KV 位于 GPU、CPU 还是 L3;然后才继续讨论 local match、prefetch、write-back、page-size 和 layout 等工程实现细节[6]。
两者都依赖底层 page/block 粒度,但 vLLM 更直接地把 block/page 暴露为运行时主抽象;SGLang 则更倾向于先组织共享前缀,再让 page 粒度与内存布局去支撑这层组织。
六、HiCache:从 RadixCache 到 HiRadixCache 的分层扩展
如果前面的判断成立,那么 HiCache 的位置就很清楚。HiCache design 文档开头直接把它定义为 RadixAttention 思路的延伸:RadixAttention 用空闲 GPU memory 缓存和复用共享 prefix KV,而 HiCache 则把这套思路扩展到 host memory 和 distributed storage,形成类似 CPU 三层缓存的 L1/L2/L3 结构[6]。
1. HiRadixTree:节点不仅表示前缀,还表示”这段前缀现在在哪一层”
design doc 对 HiRadixTree 的定义很关键:每个节点仍然表示一段连续 token span 的 KV cache,但在原有 device-only prefix tree 基础上扩展了层级感知能力——每个节点除了记录 device 侧信息,还记录这段 KV 当前位于 GPU、CPU、L3 或其中多层;对本地层保留精确地址元数据,对 L3 则按需向 backend 查询而不是持续同步所有元数据[6]。
2. HiRadixCache(RadixCache):源码直接给出了继承关系
从源码的继承关系就能看出定位:HiRadixCache 是 RadixCache 的子类[7],在 prefix-first 主线之上接入了 host pool、storage backend 和异步数据流控制器。它的初始化流程大致是:
- 读取
page_size与 device 侧kv_cache; - 根据 MHA / NSA / MLA 类型构造 host 侧 KV pool;
- 解析 storage backend 配置与 prefetch 阈值/超时参数;
- 创建
HiCacheController; - 维护一组异步状态:
ongoing_write_through、ongoing_load_back、ongoing_prefetch、ongoing_backup; - 最后再调用
super().__init__(params),把普通 RadixCache 的逻辑接进来[7]。
3. match 的结果从”命中 device 前缀”升级为”命中本地多层前缀”
BasePrefixCache.MatchResult 在 HiCache 场景下除了 device_indices 外,还包含 last_host_node 和 host_hit_length[3]。进入 HiCache 后,match 的语义就不再只是”device 上命中了多少 KV”,而是”在本地 L1/L2 上连续命中了多少前缀,其中哪一段还需要 load-back 或继续 prefetch”。
对应地,design doc 里的 workflow 也分成了三步:
- local match:先在 L1/L2 的 HiRadixTree 里找连续前缀;
- prefetch from L3:对本地未命中的连续部分再查 L3,并根据 threshold 与 stop policy 决定是否拉回;
- write-back:prefill 完成后再把新生成的高价值 prefix 逐层写回更低层[6]。
4. 三种核心动作,以及生产环境里的实际效果
HiCache 的核心动作可以压缩为三类:
- load-back:本地 host 已有的 KV 如何重新进入 GPU;这也是为什么
BasePrefixCache里需要init_load_back()与ready_to_load_host_cache()[3]。 - prefetch:L3 已有的数据如何在真正计算前提前拉近,设计文档中对应
best_effort、wait_complete和timeout三种 stop policy[6]。 - write-back:新产生的 prefix KV 何时、以何种策略向 L2/L3 写回,文档中对应
write_through、write_through_selective和write_back三类模式[6]。
三类动作组合在一起之后,HiCache 管理的就不再只是”当前有没有命中 cache”,而是一整套 prefix KV 在多层之间迁移、复用、沉淀与回收的生命周期。
(v1.1 更新) 2025 年 9 月,LMSYS 发布了 HiCache 的专项博客[8],其中包含来自生产部署的实测数据。Novita AI 在服务 Qwen3-Coder-480B 时,TTFT 平均降低 56%,吞吐量提升 2×,缓存命中率从 40% 提升到 80%;Ant Group 在 DeepSeek-R1-671B 上相比全量重新计算的基线,TTFT 降低 84%。这两组数字说明的,不只是”分层缓存有收益”,而是 HiCache 在实际 serving 里能把共享前缀的复用收益从 GPU 显存边界向外推了至少一个数量级。
存储后端方面,HiCache 原生支持 Mooncake、3FS 和 NIXL,并对外暴露三函数接口(get、put、contains)允许自定义接入。2026 年 4 月,3FS 后端完成了对 DSA(DeepSeek Sparse Attention)和 Mamba 模型的支持扩展——在混合注意力架构下,不同 attention head 对应不同的 KV pool,HiCache 现在能分别处理各 pool 的 host 备份与 L3 写回。
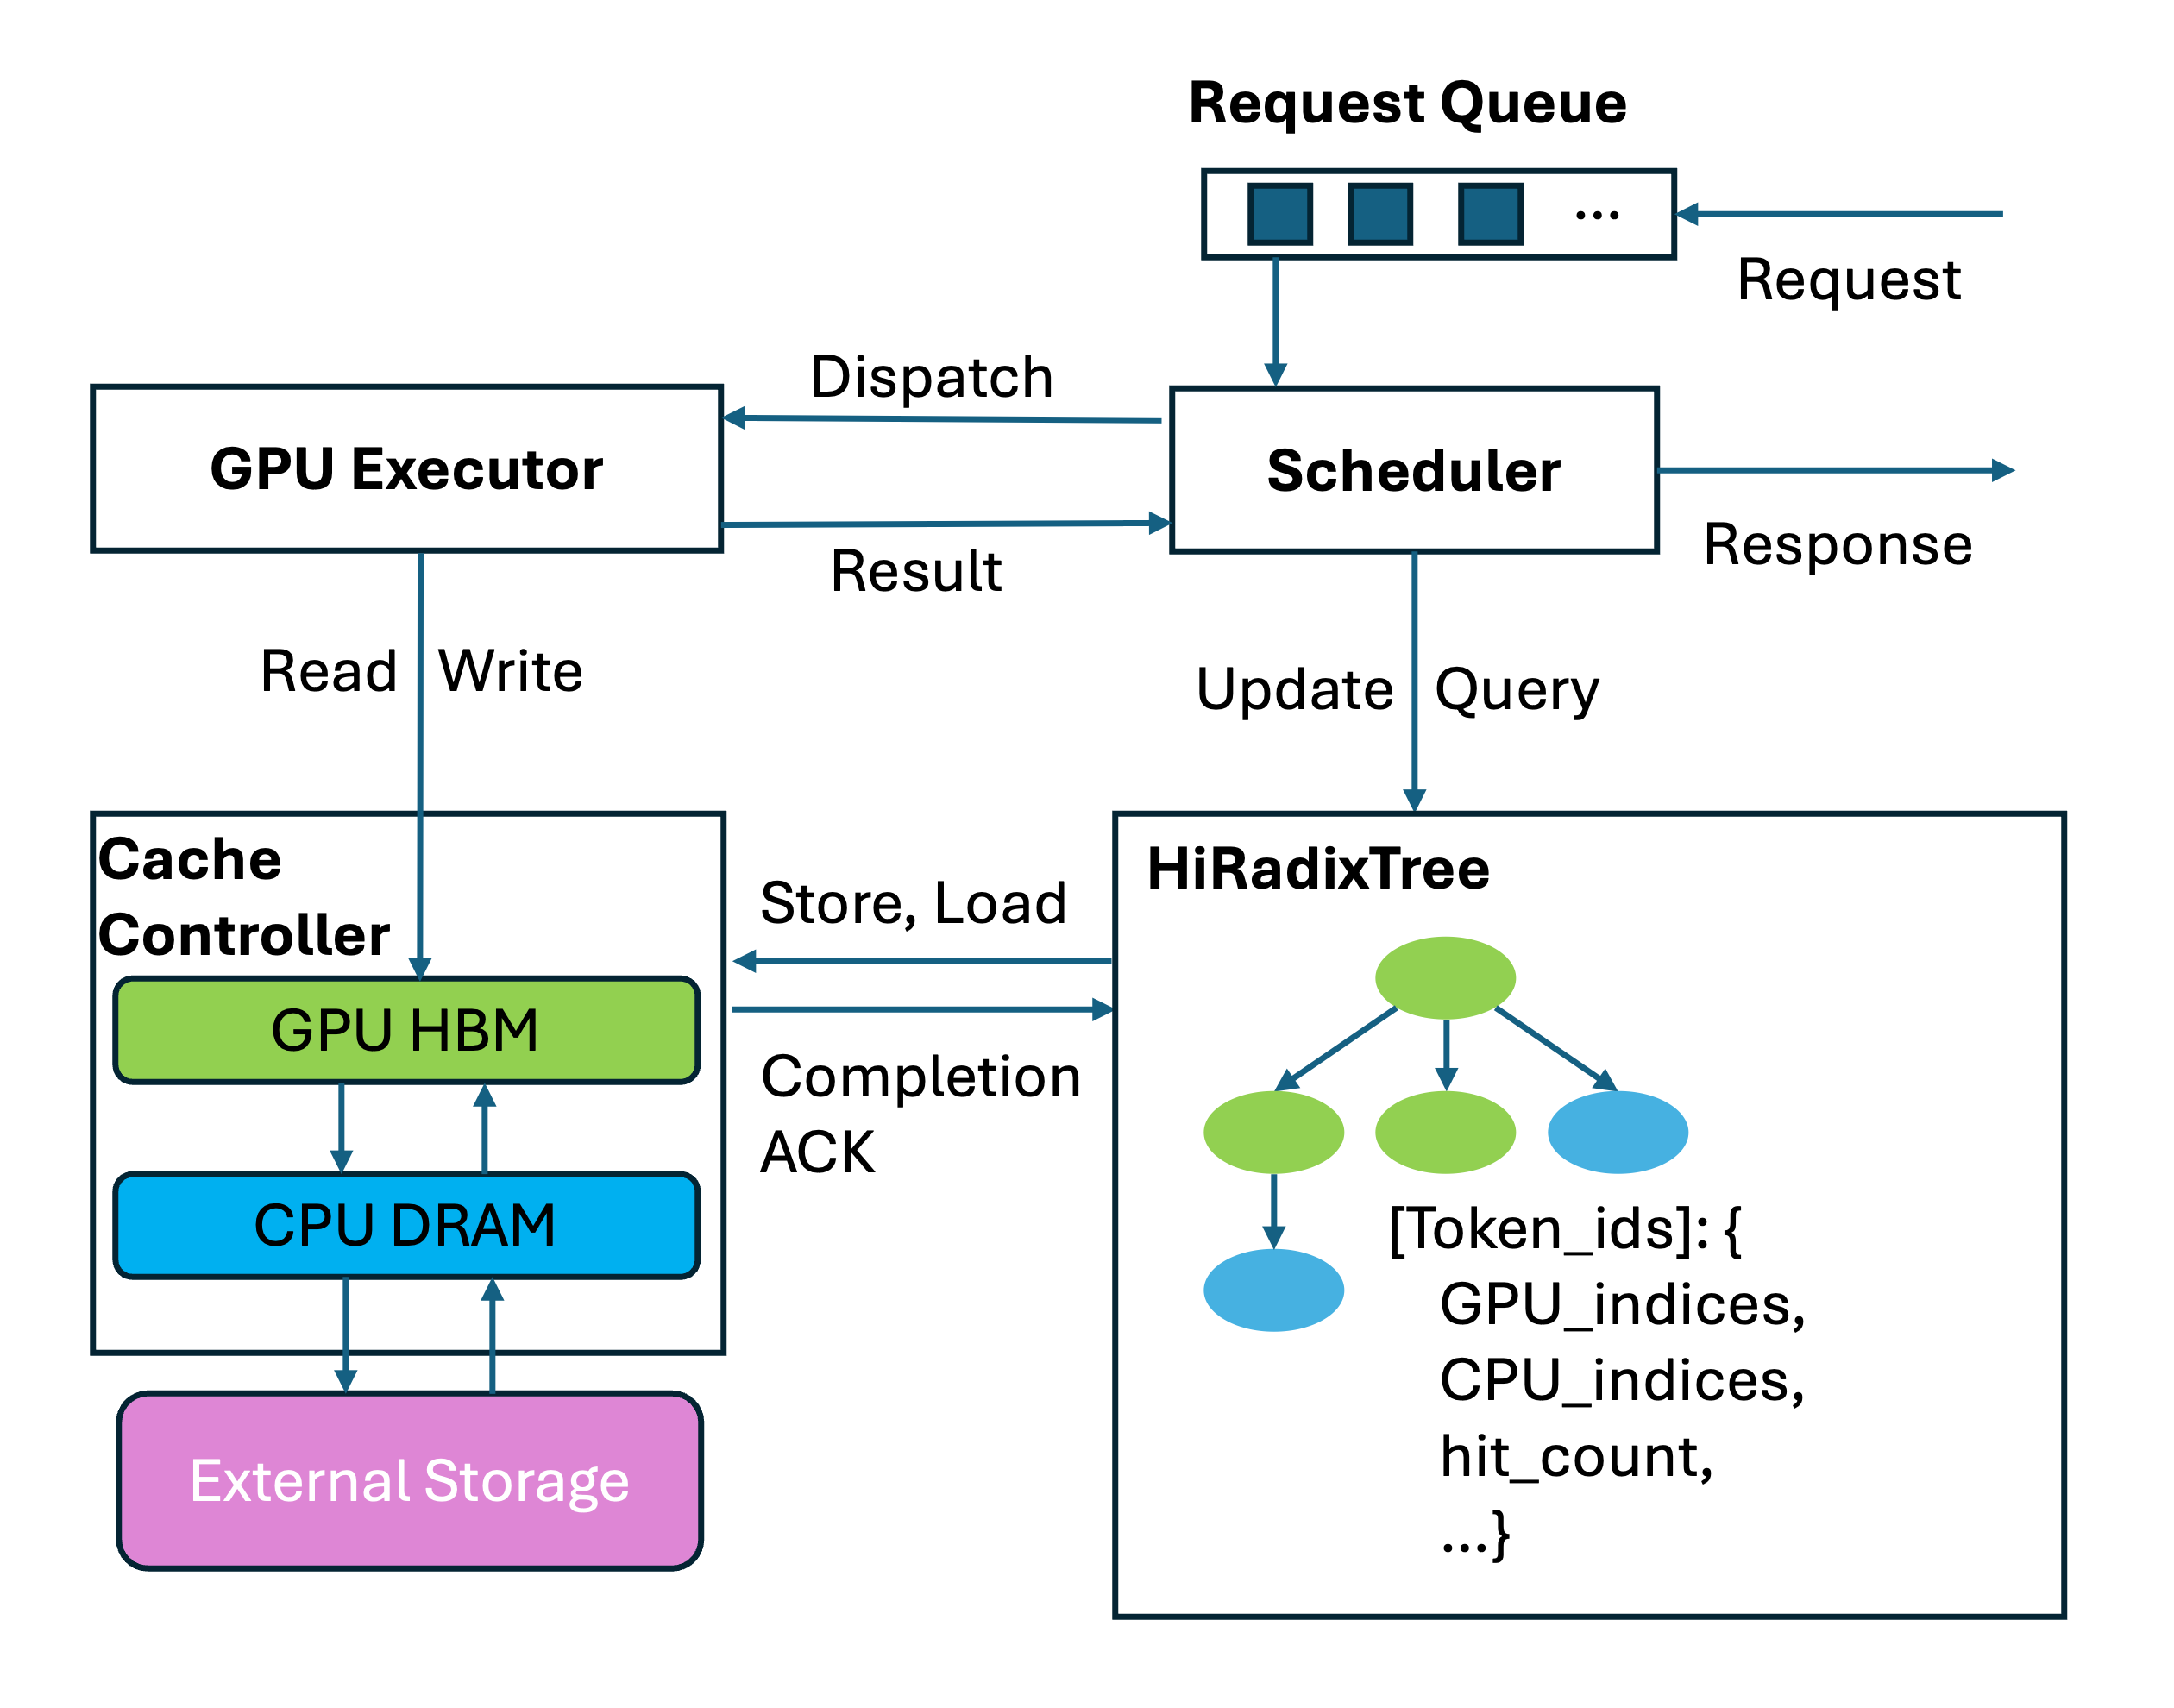
图 4:HiCache 的关键不是多了几层存储,而是它仍然沿着”先匹配共享前缀,再决定从哪一层取回和写回数据”的主线在扩展[6]。
七、为什么 HiCache 要显式讨论 page size、layout 和 I/O 优化
HiCache 最容易被低估的地方,是很多人会把它理解成”把 GPU cache 搬去 CPU/L3”。但从 design doc 看,它做的远不止数据分层,还重新设计了跨层数据组织与传输路径[6]。
1. page_size 直接决定命中粒度与 I/O 粒度的权衡
文档明确指出:较大的 page size 可以减少 metadata 开销、提高 I/O 效率,但会降低部分前缀匹配时的命中细粒度;较小的 page size 则相反[6]。page 在 HiCache 中既不是纯执行细节,也不是单纯调参项,而是连接”命中语义”与”传输效率”的底层粒度选择。
2. layer_first / page_first / page_first_direct
文档还专门解释了为什么需要三种 memory layout:GPU 计算天然偏 layer_first,而 L3/host I/O 又更适合 page_first;page_first_direct 则试图在两者之间做折中[6]。HiCache 为跨层数据移动重新设计了内存组织方式,GPU 端维持 layer_first 不变,传输到 host/L3 时切换到 page_first。实测中,这一切换带来了约 2× 的 host I/O 吞吐提升[8]。
3. zero-copy、batch-oriented organization、compute-transfer overlap
HiCache 还显式强调:使用 zero-copy transfer 减少不必要的中间复制;以 page 为单位做 batch-oriented data organization;在 prefill 阶段让 CPU→GPU 的 KV 加载与 layer 计算 overlap;使用 GPU-assisted I/O kernels 加速 CPU/GPU 之间的 KV 搬运,实测比标准 cudaMemcpyAsync 提升 3×[8]。
HiCache 的本质不只是”多一层存储”,而是在 prefix-first cache 主线下,进一步把跨层数据移动本身做成优化对象。
八、HiSparse 与 ShadowRadix:前缀优先哲学在稀疏注意力与混合架构上的延伸
(v1.1 新增) 2026 年 4 月,LMSYS 发布了两项密切相关的新技术:HiSparse 和 ShadowRadix[9][10]。表面上看,两者解决的是不同的问题——一个针对稀疏注意力模型(DeepSeek-V3.2、GLM-5.1),一个针对 DeepSeek-V4 的混合注意力架构;但在系统架构层面,它们都是同一条前缀优先主线在更复杂模型架构上的推进。
1. HiSparse:用 LRU 卸载管理稀疏注意力的非活跃 KV
传统密集注意力里,每个 token 对应的 KV 在 decode 阶段都会参与计算;稀疏注意力(如 DSA)则只对部分 token 做精确计算,大量历史 token 的 KV 实际上处于不活跃状态。HiSparse 的核心做法是主动把非活跃 KV 卸载到 host memory,在 GPU 端维护一个热点 buffer,再配合一个专用 CUDA kernel 同时完成三件事:识别 top-k cache miss、选出 LRU eviction 候选、更新 page table 并触发 host→device 搬运[9]。
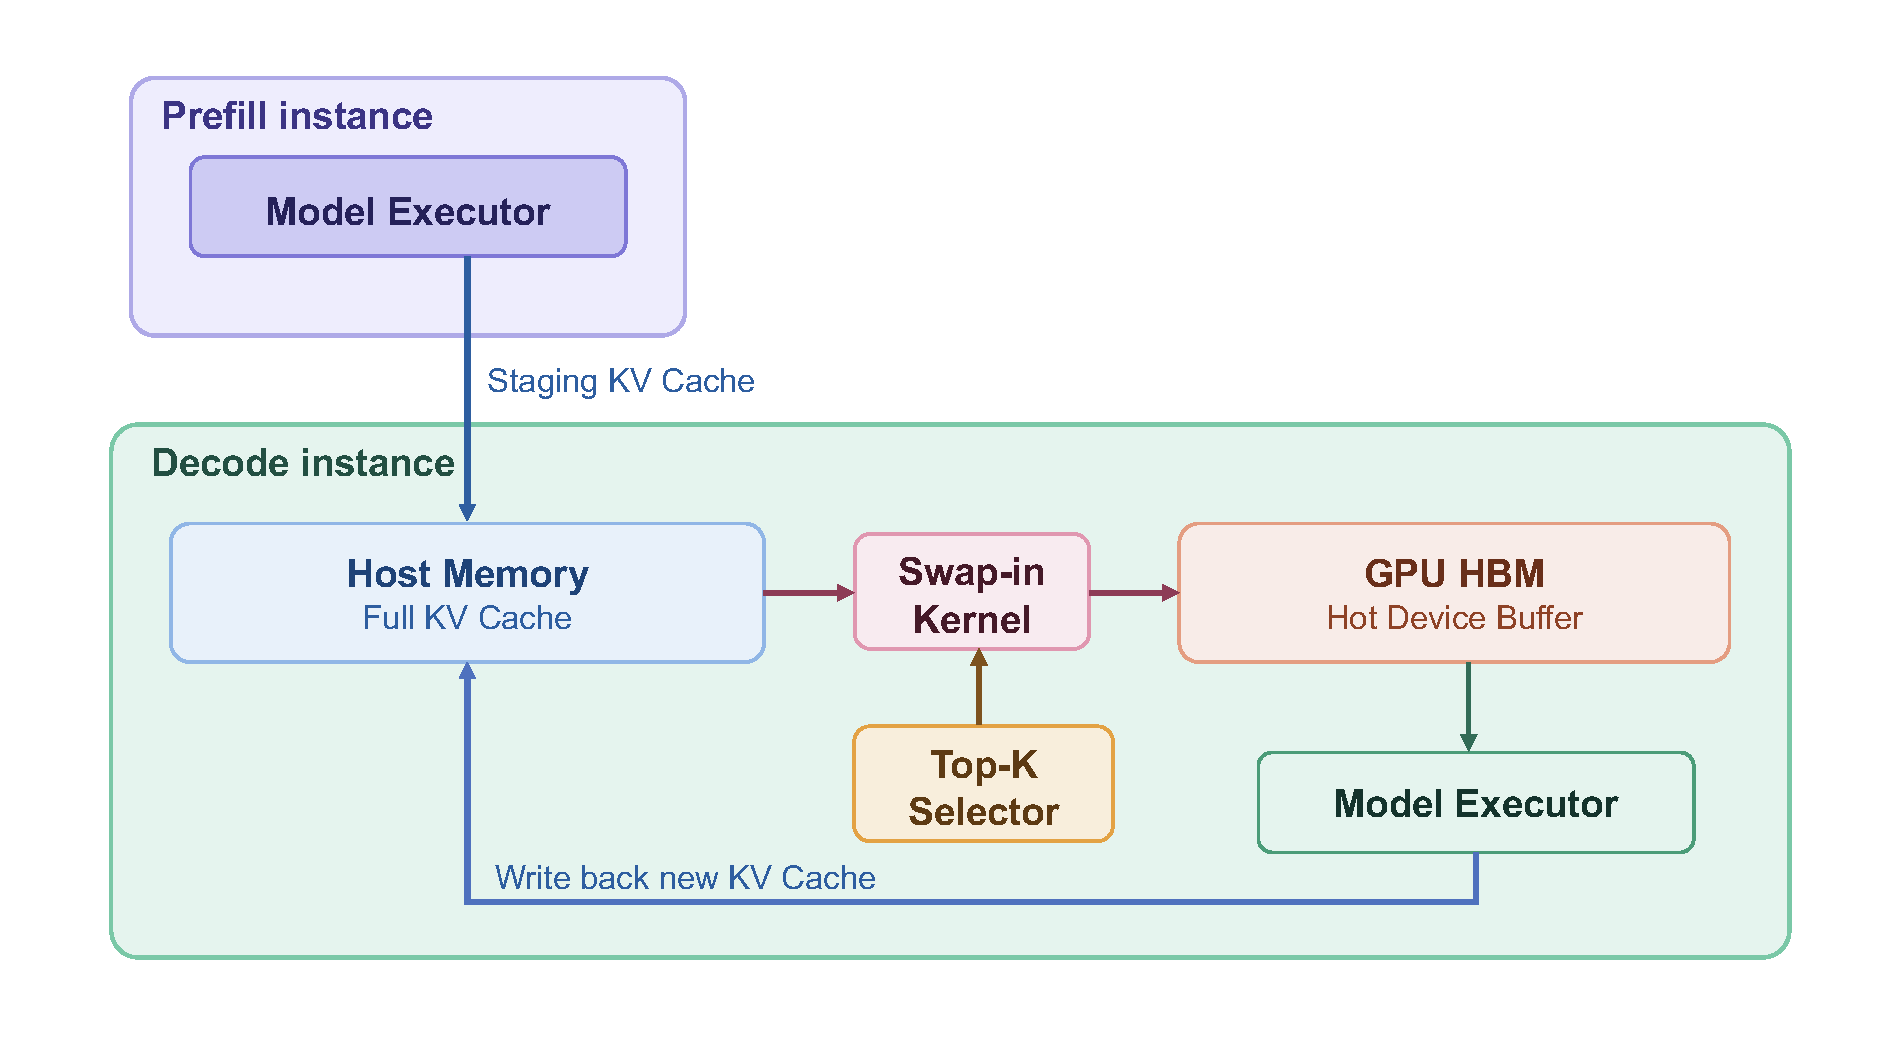
图 5:HiSparse 用主动卸载替代静态分配——GPU 端只保留热点 KV buffer,非活跃条目按 LRU 推到 host memory,在 256 并发请求场景下吞吐量提升 3–5×[9]。
在 256 并发请求的场景下,GLM-5.1-FP8 的吞吐量提升了 3–5×,且随并发数近线性扩展。这个性能图形有一个值得关注的前提:低并发时 GPU 端的 miss 代价可以被掩盖,I/O overhead 反而显现;高并发时非活跃 KV 对显存的压力达到临界点,HiSparse 的主动卸载才真正发挥作用。HiSparse 的适用窗口主要在高并发的长上下文场景,而不是所有稀疏注意力 workload。
2. ShadowRadix:为混合注意力的多 KV pool 独立管理生命周期
DeepSeek-V4 的注意力架构比稀疏注意力更复杂:每个 token 同时对应三条不同计算路径的 KV——SWA(滑动窗口,保留最近 128 个原始 token)、C4(4:1 压缩后的稀疏 top-512 检索)和 C128(128:1 压缩后的全局密集注意力)。三条路径对显存的压力不同,对共享前缀的可复用窗口也不同;混在同一个 radix tree 里,任何一条路径的淘汰都会连带影响其他两条。
ShadowRadix 的解法是让 radix tree 以虚拟全 token slot 为坐标轴索引,再用”shadow”映射把虚拟坐标投影到三个独立的物理 KV pool 上[10]。每个 pool 有独立的生命周期,一个两计数器锁(two-counter lock)保证淘汰操作不会跨 pool 相互干扰。
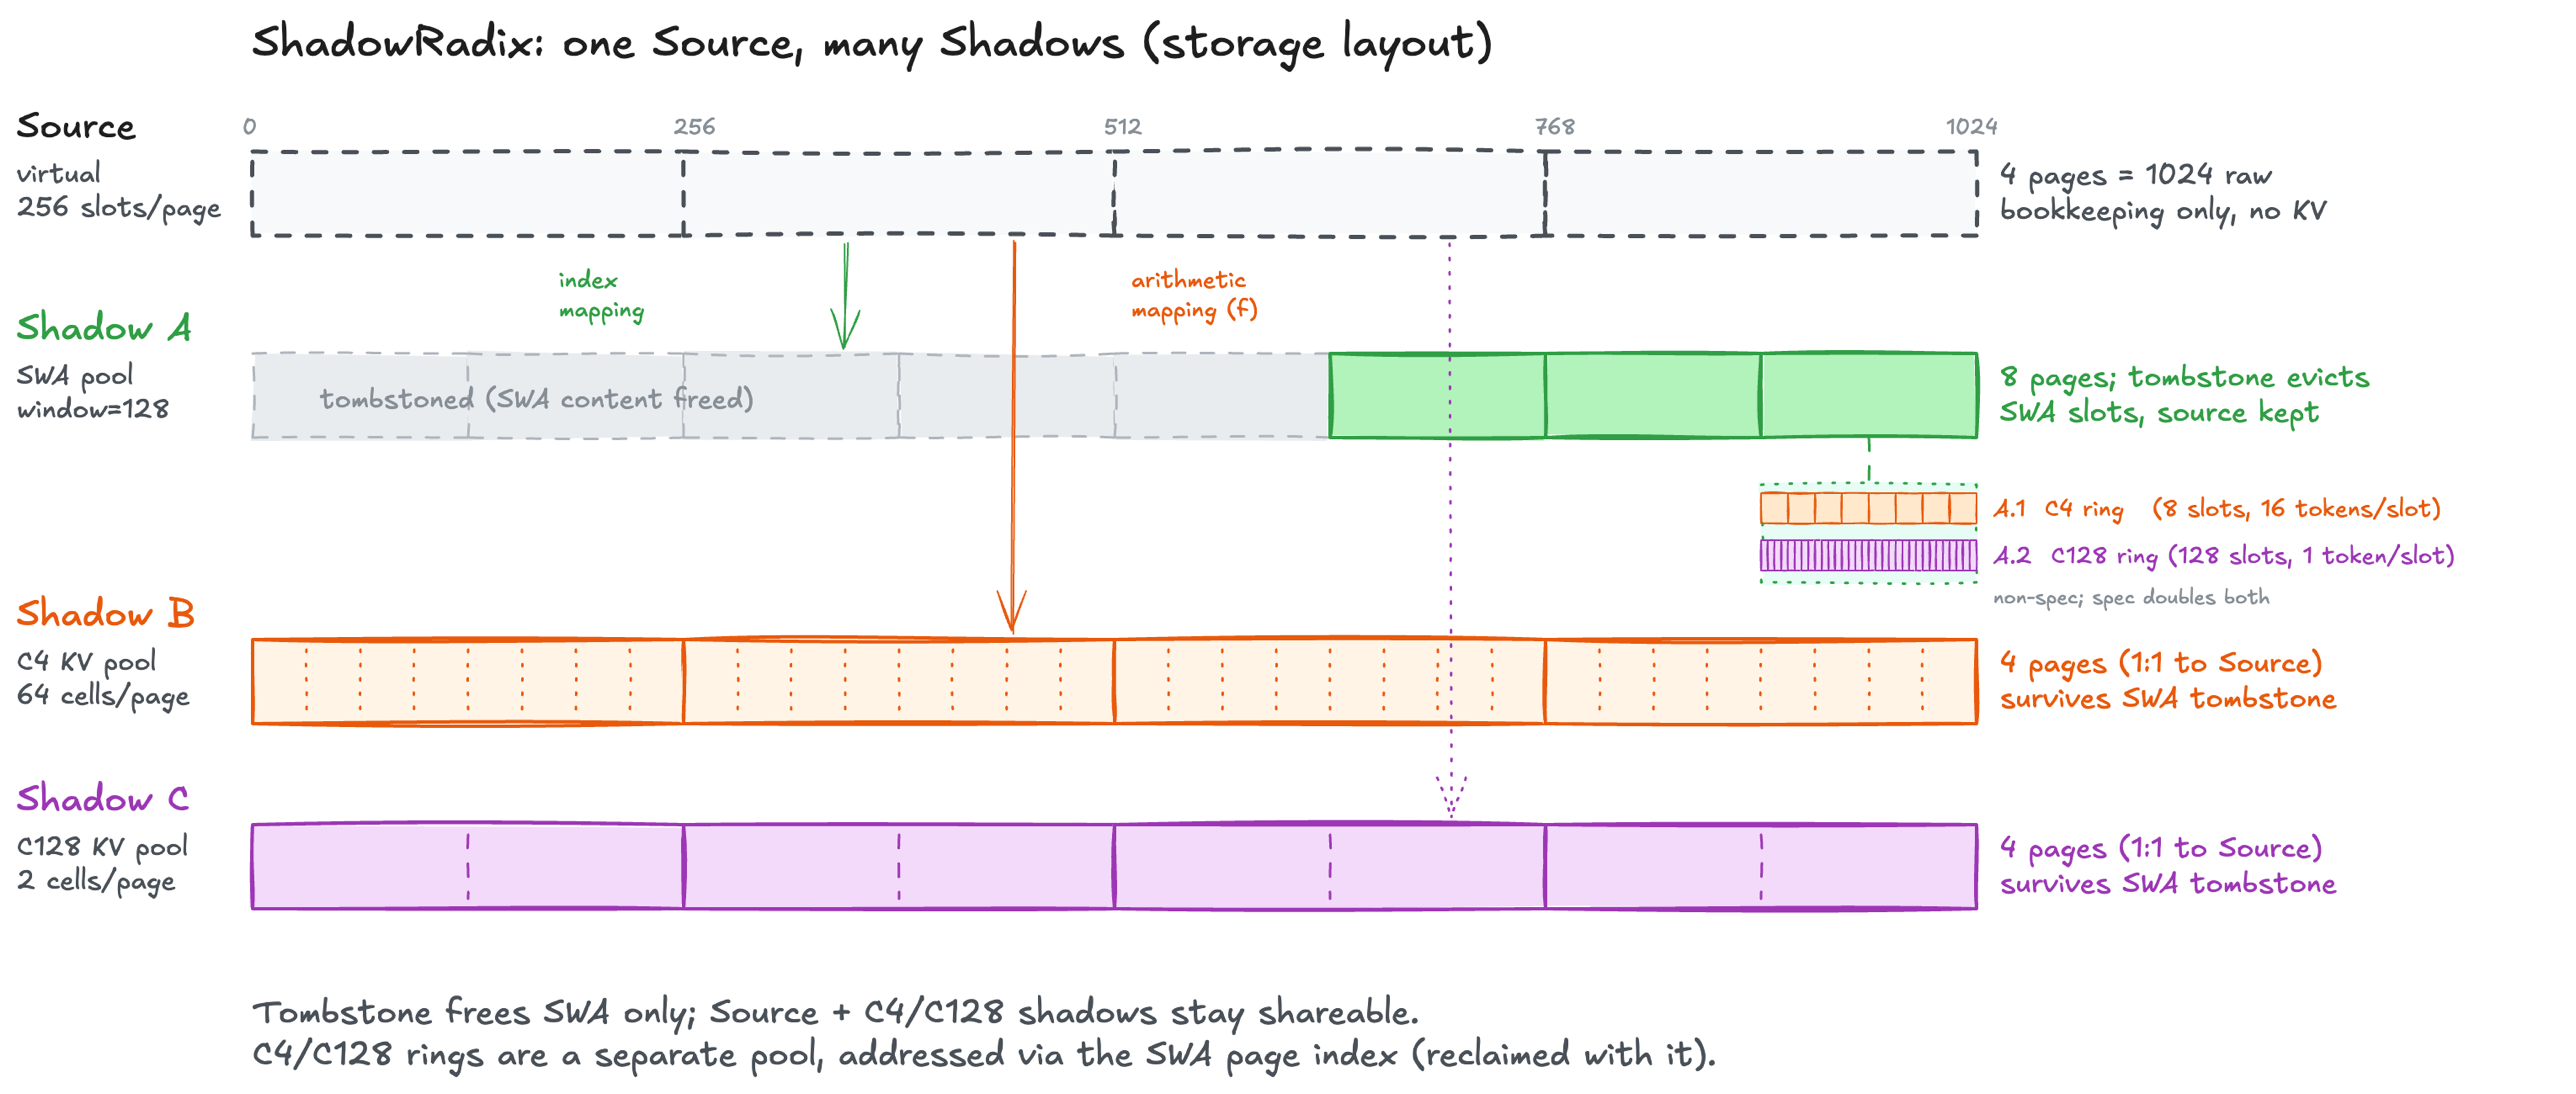
图 6:ShadowRadix 的核心不是引入新的树结构,而是用虚拟坐标轴把三个 KV pool 的独立生命周期统一接进同一棵 radix tree 里[10]。
结果很能说明这个设计的价值:从 4K 到 900K 的上下文长度,H200 的 decode 吞吐量仅从 266 tokens/s 降到 240 tokens/s,下降不到 10%[10]。在 dense attention 下几乎不可能做到的事情,在 ShadowRadix + 混合注意力的组合下变成了日常 serving 的默认行为。
HiSparse 在 DeepSeek-V4 中同样参与了 C4 KV pool 的 CPU 卸载,进一步把稀疏路径的容量边界推向 host memory。HiSparse 和 ShadowRadix 在架构里协同工作:ShadowRadix 负责索引与生命周期隔离,HiSparse 负责非活跃 KV 的跨层卸载。
从更高的视角看,HiSparse 和 ShadowRadix 的出现打破了一个此前的隐含假设:RadixAttention 的 prefix-first 组织方式最初是围绕密集注意力设计的,每个 token 只对应一个 KV;进入混合注意力架构之后,这个假设打破了。SGLang 的应对路径是:在现有 prefix-first 抽象上扩展坐标轴(虚拟全 token slot)和生命周期管理(per-pool 独立锁),让前缀优先的逻辑延伸到多 KV pool 的场景,而不是为混合注意力重新设计一套缓存系统。
结语:SGLang 的关键在于先定义”共享前缀”,再组织整个 KV runtime
如果只从功能列表看,SGLang 当然也有 page、也有 memory pool、也有 eviction、也有 host/storage 分层;它并不是生活在另一个世界里的特殊系统。但它真正值得单独拿出来讲的地方,在于最早被提升到系统主链路的,是共享前缀,而这个起点让后续的每一步设计都具有了内在的连贯性。
从 RadixAttention 到 HiCache,再到 HiSparse 与 ShadowRadix,这条演进线的内在逻辑一以贯之:每一步都在回答同一个问题——当共享前缀作为第一资产时,新的模型架构或部署约束要求系统做出怎样的调整?
- RadixAttention:把共享前缀变成可搜索、可插入、可淘汰、可保护的树节点;
- HiCache:把这层树从 GPU 推向 host 与 L3,让共享前缀在多层存储里保持可访问,生产部署中实现 56–84% 的 TTFT 降低;
- HiSparse:针对稀疏注意力的非活跃 KV,用主动卸载把有效 KV 容量推出 GPU 边界,高并发下 3–5× 吞吐提升;
- ShadowRadix:针对混合注意力的多 pool 语义,用虚拟坐标轴保持树索引的统一,同时独立管理各 pool 的生命周期,900K 上下文下吞吐仅衰减 10%。
目前仍然开放的问题,是 UnifiedRadixTree 在 HiCache 下对 DeepSeek-V4 的完整支持(issue #23639 在本文 v1.1 更新时尚处于活跃开发中),以及 MemCacheV2 的系统级重构——它试图把上述所有特性组合成一套正交可叠加的配置,而不是像现在一样各自维护不同的代码路径。这个重构完成的时间节点,大概率是 SGLang KVCache 主线下一个阶段的真正起点。
参考资料
[1] Fast and Expressive LLM Inference with RadixAttention and SGLang
[2] radix_cache.py — SGLang 源码
[3] base_prefix_cache.py — SGLang 源码
[4] schedule_policy.py — SGLang 源码
[5] SGLang v0.4: Cache-Aware Load Balancing and Efficient Structured Outputs
[6] HiCache: Fast Hierarchical KV Caching — SGLang 官方文档
[7] hiradix_cache.py — SGLang 源码
[8] SGLang HiCache: Fast Hierarchical KV Caching with Your Favorite Storage Backends
[9] HiSparse: Turbocharging Sparse Attention with Hierarchical Memory
[10] DeepSeek-V4 on Day 0: From Fast Inference to Verified RL with SGLang and Miles
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。