版本历史
版本 日期 说明 v1.0 2026-03-12 初稿,基于 vLLM commit 48e376a007173910330a8c83f53474b21e4279c0(2026-03-05),梳理本地 Block Pool、KVCacheManager、调度器和 worker metadatav1.1 2026-05-09 修订更新:纳入 vLLM x Mooncake Store、LMCache 多租户隔离与 Mooncake Transfer Engine / Store 的生产化进展
很多人第一次理解 vLLM,都会先记住一个关键词:PagedAttention。这个入口没错,vLLM 之所以能在大模型推理系统里建立辨识度,一个重要原因正是它没有沿用“每个请求持有一段连续 KV cache”的传统内存布局,转而把 KV 存储拆成按 block/page 管理的资源。但只停在 attention 访存优化这一层,会错过当前主线里更关键的变化:KV cache 已经进入 scheduler、KV manager、block pool 和 worker metadata 共同维护的运行时资源层。
(v1.1 更新) 2026 年 5 月之后,这个判断变得更明显了。vLLM 官方发布的 Mooncake Store 集成把远端 KV 从“connector 接口上的可能性”推进到面向 agentic workload 的跨实例缓存池:在 610 条 Codex / SWE-bench Pro traces 上,官方报告缓存命中率从 1.7% 提升到 92.2%,吞吐提升 3.8 倍,P50 TTFT 降低 46 倍[23]。这组数字把问题讲得很直接:KV cache 的作用已经越过单个 engine 内部的热路径优化,成为多实例 serving 系统承接长上下文、多轮 agent 请求时必须管理的资源层。
这也是今天重新理解 vLLM 的必要性所在。在线推理系统早已越过“要不要缓存 K/V”这一步,真正的问题变成:在变长请求、持续 decode、前缀复用、远端 KV 回填和跨实例迁移的场景下,系统如何决定哪些请求可以继续推进,哪些 block 应该被复用,哪些 block 应该被释放,以及这些逻辑如何最终落到 attention backend 的执行路径上。基于当前 vLLM v1 主线源码来看,PagedAttention 仍然重要,但它更像是这套 runtime 抽象成立的前提。
本文基于当前主线源码拆解这套 KV cache 管理机制。分析对齐的 vLLM 仓库版本是 main@48e376a007173910330a8c83f53474b21e4279c0(本地最新提交时间:2026-03-05)。核心判断很简单:vLLM 的关键创新在于把 KV cache 纳入推理 runtime 的资源管理主链路;分页访问只是这条链路成立的底层前提。
一、在线推理真正困难的是管理 K/V 的生命周期
如果从离线推理或者单请求执行的视角看,KV cache 很容易被理解成模型执行过程中的中间状态:prompt prefill 阶段算出 K/V,decode 阶段把后续 token 追加进去,注意力计算时直接读取即可。但一旦进入在线 serving,这个看起来简单的对象会立刻暴露出系统层面的复杂性。
第一个问题是请求长度不一致。不同请求的 prompt 长度不同、生成长度不同,而且到达时间也不同。如果仍然用“每个请求分配一段连续 KV 区域”的方式来处理,就会很快遇到两个矛盾:要么为了安全而做较大预留,造成显存浪费;要么频繁地扩容和整理,带来碎片化和调度复杂度。
第二个问题来自 decode 的持续增长。KV cache 很少是“先分好再使用”的静态对象,更像一组需要不断追加、检查和回收的动态资源。系统每推进一步,都要重新面对一个问题:这个请求现在还能不能继续长出新的 token?如果能,所需的 KV blocks 从哪里来?
第三个问题是前缀复用改变了 KV cache 的所有权语义。一旦系统支持 prefix caching,一段已经算好的 KV block 就可能跨 request 被复用。多个请求命中同一前缀后,会共享同一批 block。KV cache 从每个请求各自持有的一段内存,转向具备共享资源属性的运行时对象。
当前 vLLM 主线正是围绕这些问题组织起来的。scheduler 在主循环里会先查询本地 prefix cache 命中情况,再结合外部已计算 tokens(如果启用 connector/offload),最后调用 allocate_slots(...) 判断是否还能为该请求分配足够的 block。请求可调度性从一开始就包含 KV 资源可分配性。vLLM 当前主线处理的是面向在线推理的动态资源管理问题,缓存命中只是其中一个结果。
二、KVCacheManager:调度器看到的是一套资源接口
从当前主线的接口设计来看,vLLM 没有让 scheduler 直接操作底层 block 池,中间隔着一层清晰的 KVCacheManager。这层设计很关键:KV cache 在系统里已经脱离“底层内存细节”的位置,变成 scheduler 需要显式调用和理解的一组 runtime 操作。
这一点在源码中体现得很直接。KVCacheManager 文件开头定义了 KVCacheBlocks,注释里明确写到,它是 Scheduler 和 KVCacheManager 之间的接口,用来隐藏 KV manager 的内部数据结构。scheduler 不需要直接知道底层如何维护 block pool、hash 表和 ref count,它拿到的是更高层的资源视图:哪些 blocks 已经命中前缀缓存、哪些 blocks 是这次新分配的、当前有哪些公共前缀 blocks 可以暴露给后续执行路径。
KVCacheManager 对外暴露的方法本身已经接近“运行时资源管理 API”,缓存容器只是它的一部分。比如:
get_computed_blocks(request):用于查找该请求已经命中的前缀 blocks;allocate_slots(...):用于为当前 step 中的新增 tokens、外部已计算 tokens、甚至 speculative lookahead tokens 申请 slot 和 block;free(request):在请求结束时释放其持有的 blocks;get_num_common_prefix_blocks(...):统计运行中的请求之间共有多少公共前缀 blocks。
这几组接口拼在一起,scheduler 面对的是一套用于判断可执行性、申请资源、提交缓存和释放资源的 runtime service;抽象的“KV 内存”已经不足以描述这层接口。
其中最值得细读的是 allocate_slots(...)。它的注释已经非常接近一段系统设计说明:一次 slot 分配包含回收、复用和新增分配三个阶段。系统先释放已经不再参与注意力计算的 blocks,并检查当前 free blocks 是否足够;接着处理 prefix-cached tokens 和 external computed tokens,把已经算过的前缀部分接入当前 request 的 block 视图;最后再为本轮需要计算的新 tokens 和 lookahead tokens 分配新的 block slots。只有已经成为 full block、且满足可提交条件的部分,才会进入 prefix cache。
当前 vLLM 主线里的 KV slot 分配更像一套带有回收、复用、补分配和提交动作的运行时事务。它管理的对象是一组随 request 生命周期流转的 block 引用,静态扩容已经解释不了这条路径。
三、BlockPool:prefix cache、共享 block 和 free blocks 共用同一个底层资源池
如果说 KVCacheManager 是 scheduler 看到的接口层,那么 BlockPool 才是当前主线中 KV 资源真正落地的底层结构。很多人讨论 vLLM 时,会把“prefix cache”“block allocator”“eviction 逻辑”分别看成不同模块,但从源码结构看,它们实际上共享着同一套底层资源池。
BlockPool 初始化时维护了四类核心状态:
- 一组全局的
blocks; - 一个
free_block_queue,用于按可回收顺序维护空闲 blocks; - 一个
cached_block_hash_to_block哈希映射,用于 prefix caching 命中查找; - 一个特殊的
null_block,用于滑窗等场景下占位。
这里最关键的理解是:同一组 block 会在不同生命周期阶段呈现出不同视图。一个 block 最开始可能只是 free queue 里的空闲块;被分配后,它进入某个 request 的 block 列表并持有引用计数;当它被填满后,又可能获得 block hash 并进入 prefix cache 哈希索引;如果之后被其他 request 命中,这个 block 会通过 touch() 增加引用计数,成为共享 block;等所有引用都释放掉后,它又会重新回到 free queue,成为可被再次分配的资源。
get_new_blocks() 能很好体现这套机制的统一性。它从 free list 取块前,会先检查这些 block 是否仍带有缓存 hash;如果有,就执行 _maybe_evict_cached_block(),把它从 prefix cache 哈希表中移除并清理 hash 元数据,然后再把它作为“新分配 block”交给请求使用。可被复用的 cached block 和可被重新分配的 free block,共用同一个 block 池,只是处在不同状态。
另一方面,cache_full_blocks() 说明 prefix caching 的复用单位是 full block。只有当 block 被填满、且对应 hash 已经可用时,BlockPool 才会把它插入 cached_block_hash_to_block。vLLM 当前主线里的 prefix cache 语义建立在 block-size 对齐和 full-block 完整性的基础上,任意 token 粒度的自由命中不在这条路径里。get_computed_blocks() 的逻辑也明确体现了这一点:即使整个 prompt 理论上都能命中 cache,最后一个 token 仍可能需要重算以获取 logits,prefix hit 从一开始就带着工程约束。
这种共享真正成立的关键,是 block 上的 ref_cnt。当某个 prefix hit 被另一请求复用时,BlockPool 会调用 touch():如果该 block 当前处于 free queue 中,就先把它移出,再把引用计数加一;当请求结束或窗口外 block 被释放时,free_blocks() 则会减少 ref_cnt,只有 ref count 降为 0 且该对象为非 null block 时,block 才会真正重新进入 free queue。prefix reuse 的本质是共享已有 block,并把共享关系纳入统一的生命周期管理;复制 KV 反而会破坏这套设计的价值。
从这个角度看,当前主线里的 prefix cache 是 BlockPool 生命周期管理的一种状态投影。它把复用、回收和重分配统一在同一套 block 状态机里,这正是 vLLM runtime 设计最有价值的地方之一。
四、为什么还要有 coordinator 和 single-type managers:KV 管理语义会随 attention 类型变化
如果 vLLM 面对的只是单一的 full attention 模型,那么理论上一个统一的 KV manager 也许就足够了。但当前主线在 KVCacheManager 之下又引入了 KVCacheCoordinator 和一组 SingleTypeKVCacheManager,这里承认了另一个关键事实:不同 attention 语义下,KV cache 的管理方式会分化。
KVCacheCoordinator 的职责是聚合多个 KV cache group,并为每个 group 创建对应的 single-type manager。它自己持有共享的 BlockPool,但 prefix hit 的判断、skipped tokens 的处理、common prefix 的统计以及 block 释放策略,都交给各自的 single-type manager。vLLM 在这里承认了一个现实:不同 attention spec 可以共享 block 池,但不能强行套用同一套生命周期规则。
这一点在 full attention 和 sliding window 的对比中最明显。对于 full attention,前缀命中基本可以按 block 顺序前向匹配,公共前缀 blocks 也可以相对直接地通过 ref count 判断:如果某个 block 的 ref_cnt 等于当前持有已分配 KV 的 request 数量,那么它就可以被视为“公共前缀块”。但在 sliding window 场景下,逻辑会明显变化。因为窗口外的历史 token 已不再参与注意力计算,系统不能继续无条件保留所有早期 blocks。于是 remove_skipped_blocks() 会根据窗口位置主动把不再需要的 blocks 替换成 null_block,并释放真实 blocks 回到池中。
在当前主线里,KV cache 是否继续保留,既取决于请求生命周期,也取决于 attention 语义。对于 full attention,请求未结束时一般不会主动回收前缀 blocks;对于 sliding window,窗口滑出之后,历史 blocks 会被显式地标记为空位并释放。KV 管理天然是 attention-aware 的资源管理问题,很难抽成一个完全独立于 attention 的通用缓存模块。
从架构角度看,这也是 KVCacheCoordinator + SingleTypeKVCacheManager 最重要的意义:它把“统一资源池”和“差异化注意力语义”这两件事分层组织起来。统一的 block pool 提供底层资源基础,而 single-type managers 则定义不同 attention 类型下 block 生命周期的具体规则。
五、一个 request 的 KV 生命周期:连续内存让位于流动的 block 引用
理解了接口层和 block pool 之后,再回头看一个 request 的生命周期,会更容易抓住当前主线的本质。对于 vLLM 来说,请求持有的是一组会不断变化、可能共享、也可能被回收的 block 引用;从头到尾连续存在的 KV 内存不再是合适的心理模型。
一个 request 初次进入 waiting 队列时,scheduler 首先会尝试通过 get_computed_blocks() 查询它的本地 prefix hits。如果启用了 connector 或外部 KV 传输机制,还会再加上 external computed tokens。这一步得到的是当前 request 已有多少前缀可以直接复用,以及这些前缀对应哪些 blocks;最终能不能执行,还要交给后面的 slot 分配来判断。
接下来进入 allocate_slots(...)。在这一阶段,系统会先清理那些已经不再需要参与注意力的旧 blocks,比如滑窗之外的部分;然后把 prefix hit 对应的 blocks 接入 request 的 block 列表,并在必要时通过 touch() 确保这些被命中的 blocks 不会在本轮被当作 eviction candidate;如果还存在外部已计算 tokens,则还要为它们补分配相应 blocks;最后,系统才为真正要在本轮计算的新 tokens 和 speculative lookahead tokens 分配新的 block slots。
本轮执行结束后,已变成 full block 的部分才会被提交到 prefix cache。缓存提交有时机约束,request 每多一个 token 并不会立刻产生可复用缓存;prefix cache 命中时,新请求共享已有 block,并通过 ref count 纳入同一生命周期。
等到请求结束,或者在滑窗场景下部分历史 blocks 被移出窗口时,系统再通过 free() 或 remove_skipped_blocks() 释放它们。真正返回 free queue 的条件是“所有引用这个 block 的 request 都已经释放了它”。从生命周期角度看,当前主线里的 request 持有的是一组随时间流转的 block 引用关系。
这种视角很重要,因为它会直接改变我们对 KV cache 的理解方式。它更像 runtime 在每一步里不断重写的一份 block ownership graph,per-request static buffer 的直觉在这里会失效。
六、调度器为什么必须理解 KV:系统吞吐边界由 scheduler 与 KV manager 联合定义
到了这一步,scheduler 不能把 KV cache 当作透明实现细节的原因就很清楚了。对于在线推理系统来说,请求能否进入本轮执行,同时取决于 token budget、batch size、compute 预算和 KV resources。
在 schedule() 主循环里,这种耦合体现得非常直接。scheduler 会逐个检查 waiting requests,计算它们当前的本地和外部 computed tokens,再估算本轮需要新增多少 tokens,然后调用 allocate_slots(...)。如果这个调用返回 None,含义是当前资源状态下该请求本轮无法安全推进。此时 scheduler 只能选择跳过、等待、或在后续 step 再试。
scheduler 决定的不只是“谁更重要、先跑谁”,还包括“谁在当前 KV 资源状态下是可执行的”。从系统角度说,scheduler 与 KV manager 共同定义了吞吐边界:前者负责选择候选请求,后者负责判断这些候选请求在当前 block 资源和生命周期约束下能否真正进入执行。
这一层耦合还体现在 common prefix blocks 的输出上。当前主线里,scheduler 在完成一次调度后,会额外计算 running requests 之间共有多少公共前缀 blocks,并把它作为 SchedulerOutput 的一部分输出给下游。scheduler 输出里已经包含 batch 内前缀结构相关的执行信息。KV cache 从模型执行后的副产物,变成了调度器组织 batch 时必须实时感知的系统状态。
从这个角度再看 vLLM,attention 优化库这个标签已经太窄了。它更接近一个推理 runtime:scheduler、KV manager、block pool 和 worker/backend 在同一套资源抽象下协同工作,而 KV cache 正是这套协同关系的核心载体之一。
七、分页式 KV 如何真正进入执行:block table 和 slot mapping 是关键桥梁
讨论 PagedAttention 时,很多文章只停留在“KV 被拆成 blocks,逻辑连续但物理不连续”的概念层面。但在当前主线源码里,这件事真正落到执行面,依赖的是 worker 侧对 block_table 和 slot_mapping 的维护。
从 request 视角看,它持有的是一组逻辑 block ids。真正进入 GPU 执行之前,worker 会先把这些 block ids 写入 per-request 的 block table;到了 batch 组织阶段,再根据本轮 batch 的 request 映射,把对应 block tables gather 成真正的输入视图。随后,compute_slot_mappings() 根据每个 token 在逻辑序列中的 position,先算出它落在哪个 block index 上,再通过 block table 查到这个 block 的物理 block id,最后进一步计算出对应的 slot id。
这一步的意义非常大。对 attention backend 来说,请求进入执行时携带的是一份如何从 block table 中找到对应物理 KV slots 的映射说明。分页式 KV 真正成立的关键,在于 block table 和 slot mapping 把逻辑序列重新解释成可执行的物理访问规则。
当前 v1 的 CommonAttentionMetadata 也印证了这一点:backend 接收到的 batch 级元数据中,明确包含 block_table_tensor 和 slot_mapping。分页化最终会进入 attention backend 的真实执行接口。有了这层映射,vLLM 才能在不要求每条序列物理连续存储的前提下,仍然为 backend 构造出可用的访问模式。
从这一步再回看,PagedAttention 的真正意义也会更清楚:它是一种让“逻辑连续”和“物理非连续”能够同时成立的系统级接口设计,不能只被理解成一个 kernel 名词。
八、KV 存储的本体到底是什么:从物理页到请求视图的两层结构
理解 vLLM 的 KV cache,一个很容易混淆的地方是:调度层里看到的 KVCacheBlocks、KVCacheBlock,和 worker 执行时真正读写的 KV cache,处在两个层次。前者更接近运行时管理视图,后者才是真实的存储本体。如果不先把这两层区分开,后面很容易把 block 管理误解成 KV 存储本身。
从当前 vLLM v1 主线源码看,真正的 KV 存储本体是 worker 侧为 attention layer 分配的一组 GPU Tensor。在 init_kv_cache() 的路径里,系统会先按 KVCacheConfig 为每个 layer(或共享同一存储的一组 layers)分配原始字节缓冲区,再根据具体 attention backend 的 get_kv_cache_shape() 把这块连续内存重新解释成分页化的 KV cache 结构。对于常见的 FlashAttention backend,这个结构可以概括为:
[2, num_blocks, block_size, num_kv_heads, head_size]
其中第一个维度的 2 对应 K 和 V,num_blocks 表示物理页/物理块数量,block_size 表示每个 block 容纳多少 token,后两维则是 KV head 数与 head size。KV cache 的真实本体,就是按物理 block/page 切分的一块 layer 级 GPU Tensor。
和这层真实存储相对的,是 Python 层的 block 元数据对象。KVCacheBlock 本身并不保存任何 K/V 张量内容,它只维护:
block_idref_cntblock_hash- free-list 链表指针
is_null
KVCacheBlock 的角色是描述某个物理 block/page 当前的管理状态;真正的数据仍然在底层 GPU tensor 中。block_id 是二者之间最关键的关联键:一个 KVCacheBlock(block_id=i),本质上对应着底层 KV tensor 的第 i 个物理页。
基于这层物理页元数据,vLLM 再在 request 维度上维护上层视图。真正持久的 request→block 映射保存在 SingleTypeKVCacheManager.req_to_blocks 中,也就是每个 request 当前关联着一串 KVCacheBlock。随后 KVCacheCoordinator 会把不同 KV cache group 的结果聚合起来,KVCacheManager 再将其包装为 KVCacheBlocks。KVCacheBlocks 更像某个 request 当前持有哪些 block 的 grouped view,服务的是 scheduler 和 manager 之间的接口边界。
但 request 视图仍然不能直接驱动 attention backend。真正把“请求持有哪些 blocks”翻译成“模型该去哪里读写 KV”的,是 worker 侧的 block_table 和 slot_mapping。执行前,worker 会先把 request 的 block ids 写入 per-request 的 block_table;然后在 batch 组织阶段,将这些 block tables 按当前调度批次 gather 成本轮执行的视图。接下来,compute_slot_mappings() 会根据 token 在逻辑序列中的 position,先找到它所属的逻辑 block index,再通过 block_table 找到对应的 physical block id,最后计算出具体的 slot id。于是,一条完整的映射链就形成了:
request
→ 持有一串 KVCacheBlock
→ 抽象成 KVCacheBlocks 视图
→ 提取 block ids 写入 block_table
→ token position 通过 block_table 映射成 slot_mapping
→ attention backend 依据 slot_mapping 读写底层 GPU kv_cache tensor
这条链路解释了一个非常关键的事实:vLLM 的 block/page 抽象连接 request 视图与物理 KV 存储。KVCacheBlocks 让 scheduler 理解“当前请求关联了哪些 block”,block_table + slot_mapping 则进一步把这种逻辑关联落实成底层 GPU tensor 上的物理访问规则。
从这个角度看,PagedAttention 的意义也就更具体了。它要求系统同时维护两套结构:一套是面向 request 和调度器的 block 生命周期视图,另一套是面向 backend 执行的物理页访问映射。前者回答“哪些 block 归谁管理、是否可复用、何时释放”,后者回答“这一批 token 的 K/V 应该写到哪一页、读自哪一页”。真正的 KV 存储本体,始终存在于 worker 侧那块被重新解释为 page/block layout 的 GPU tensor 中。
如果把这层关系说得更压缩一点,可以概括为:
在当前 vLLM 主线中,底层本体是 layer 级分页化 GPU KV tensor;
KVCacheBlock管理物理页元数据;KVCacheBlocks提供 request 级 grouped view;block_table + slot_mapping则把这种上层视图翻译成 attention backend 可执行的物理访问。
九、从顶层管理到显存分配:KV cache 初始化、NIXL 注册与 zero-copy 边界
如果只看 torch.zeros(...) 那一行,很容易以为 vLLM 的 KV cache 初始化只是一个设备内分配动作。但把调用链往上追,会发现它实际上跨越了 Engine、Worker、Runner 和 KV connector 四层。这条链解释了两个问题:KV cache 在什么时候分配,NIXL 又在哪个时间点接入,并把这块内存变成可传输的 region。
从当前主线源码看,最上层入口在 EngineCore.__init__()。engine 启动后,会先进入 _initialize_kv_caches():读取模型的 kv_cache_specs,profiling 可用显存,生成各 worker 使用的 kv_cache_configs,再生成 scheduler 看到的 scheduler_kv_cache_config。这一步建立的是全局 KV 资源模型:系统总共允许多少 blocks、按什么 group 组织、scheduler 后续该如何理解这些资源。scheduler 必须等这一步完成后才能创建,因为它要消费的是一份已经定型的 KV 资源配置。
随后,engine 通过 executor 把 kv_cache_configs 下发给各 worker。到了 WorkerBase.initialize_from_config(),系统会按 global_rank 选出当前 worker 对应的那份配置,再进入 GPUWorker.initialize_from_config()。这一层负责完成本地执行端的准备工作。最关键的一步发生在真正初始化 KV cache 之前:ensure_kv_transfer_initialized(self.vllm_config, kv_cache_config) 会先被调用。如果当前实例启用了 KV transfer,并且底层 connector 选的是 NIXL,那么这里会通过 KVConnectorFactory.create_connector(...) 创建 worker 侧的 NIXL connector,并最终进入 NixlConnectorWorker.__init__(),在其中构造 self.nixl_wrapper = NixlWrapper(...)。NIXL agent / wrapper 的建立发生在 worker 边界,而且先于 KV tensor 分配。
真正的显存分配发生在 runner 层。GPUWorker.initialize_from_config() 接着会调用 self.model_runner.initialize_kv_cache(kv_cache_config)。在 GPUModelRunner.initialize_kv_cache() 中,runner 先构造 BlockTables,初始化 attention backend 和 metadata builder,然后进入 init_kv_cache(...)。再往下,init_kv_cache() 会调用 _allocate_kv_cache(kv_cache_config, device),而 _allocate_kv_cache() 里的 torch.zeros(kv_cache_tensor.size, dtype=torch.int8, device=device),才是原始 KV memory 的真实分配点。紧接着,_reshape_kv_cache() 又会根据各层的 KVCacheSpec 和 backend 的 get_kv_cache_shape(),把这些原始 byte buffer 重新解释成 layer 级、按 page/block 布局组织的 KV tensors。Engine 决定“怎么配”,Worker 负责“在哪个执行端准备好”,Runner 才把配置落成设备内的 KV tensor。
NIXL 对 KV cache 的“注册”则发生在这个显存分配之后。GPUModelRunner.initialize_kv_cache() 在拿到 kv_caches_dict 后,会调用 get_kv_connector(self.vllm_config, kv_caches_dict);如果当前进程已经有可用的 KV transfer group,就会构造 ActiveKVConnector,并立即执行 self.kv_connector.register_kv_caches(kv_caches_dict)。对于 NIXL,这一步会进入 NixlConnectorWorker.register_kv_caches(...):遍历每个 layer 的 cache tensor,收集 cache.data_ptr()、tensor byte size、device id 等底层信息,调用 self.nixl_wrapper.get_reg_descs(...) 生成 memory descriptors,再通过 self.nixl_wrapper.register_memory(...) 把这些真实 KV tensors 注册给 NIXL。只有在这一步之后,NIXL 才真正获得了“这些 KV cache 位于哪些 device address、每个 region 有多大、后续该如何准备 xfer descriptor”的能力。
这条链路也解释了 vLLM 在这里为什么可以做到接近 zero-copy 的传输路径。至少从当前 Python 调用链和 NIXL connector 的注册逻辑看,NIXL 直接围绕已分配好的 KV tensor 做 descriptor 注册:register_kv_caches() 里拿的是 cache.data_ptr() 和 tensor 大小,后续 register_local_xfer_handler()、add_remote_agent()、prep_xfer_dlist() 也都是围绕这些已注册内存区域组织块级传输描述。vLLM 当前 NIXL 路径的关键优势在于,它把 KV cache 作为已注册的设备内存区域暴露给传输层,后续 block 读写直接围绕这些 region 展开,绕开了额外打包成独立复制缓冲区的路径。
这里说的 zero-copy 更准确地应理解为:在 vLLM 当前 NIXL connector 设计里,KV 传输建立在已注册的原始 KV memory region 之上。是否做到硬件层面绝对零拷贝,还会受后端、host buffer、memory type、平台能力等条件影响;但从 vLLM 的 Python 代码路径看,NIXL 设计追求的是直接围绕原始 KV region 进行 descriptor 化和传输准备。
那为什么不能直接用 NCCL 做同样的事?更准确地说,在 vLLM 当前这类 KV connector 设计里,NCCL 没有被组织成“已注册任意 KV 内存区域 + 远端 agent metadata + 按 block 准备传输描述符”的抽象。NIXL connector 这条链路依赖的是:先用 register_memory() 注册本地 KV region,再通过 handshake 交换 agent metadata 和 base addresses,然后为远端 block 准备 xfer descriptors,最后按 request/block 粒度发起异步加载。NCCL 非常擅长做 rank 间 collective / point-to-point tensor 通信,但 vLLM 当前 Python 侧的 KV connector 模型围绕 memory registration、remote descriptor 和 block-level KV pull 展开,这条 zero-copy 风格的 KV transfer 路径因此建立在 NIXL 上。
如果把这整条链压缩成一句话,可以概括为:
Engine 先决定全局 KV 资源模型,Worker 先把 NIXL 这类 transfer connector 建起来,Runner 再真正分配并 reshape KV tensors,随后 connector 才把这些已分配的 KV memory region 注册出去。正是这种“先配置、再建环境、再分配 tensor、最后注册 region”的分层顺序,使 vLLM 能把 KV cache 同时纳入调度系统、显存布局和远端传输路径。
十、Prefill 与 Decode 阶段里,block_table 和 slot_mapping 分别怎么工作
把 KV 存储本体和 request 视图区分清楚之后,下一个自然问题就是:这些映射结构究竟在执行时怎么被用到?从当前主线实现看,block_table 和 slot_mapping 虽然总是成对出现,但它们在 prefill 与 decode 阶段承担的角色并不完全相同。前者更偏向“描述一个 request 目前持有哪些物理 blocks”,后者则更接近“本轮参与计算的这些 token 应该写到哪些物理位置”。
先看 prefill。对于进入 prefill 的 request,worker 会先根据当前 num_computed_tokens 和本轮 query_len 构造输入 token、position 和 seq_lens。在这个阶段,新 token 的 position 是连续增长的:如果一个 request 之前已经有若干 computed tokens,那么本轮 query token 的位置就会从 num_computed_tokens 开始顺延。随后,worker 根据这些 position、request 当前的 block ids 以及 block size,计算每个 token 应该落在哪个逻辑 block,再通过 block_table 找到对应的 physical block id,最后得到具体的 slot_mapping。这一步的结果是:虽然请求视角上只是“给这个 request 追加了一段新 token”,但执行侧已经把这段逻辑追加翻译成了“把这些 key/value 写进哪些物理 page 的哪些 slot”。
cache update 路径真正依赖的是 slot_mapping。在 FlashAttention 等 backend 中,写入 KV cache 时不会去遍历 request 的 Python block 列表,执行路径会直接拿到 kv_cache 和 slot_mapping,调用底层 reshape-and-cache 类算子,把本轮生成出的 key/value 写进对应 slot。prefill 阶段的关键动作,是边生成边按 slot mapping 直接写入分页化 KV 存储本体。
再看 decode。decode 阶段通常每个 request 每步只新增很少的 token,常见情况下甚至就是 1 个 token,但它需要读取的是“历史 KV + 当前 query”的组合。因此在 decode 中,block_table 的作用会更突出:backend 需要知道当前 request 逻辑上的整段上下文,对应到底层有哪些 physical blocks。与此同时,新增 token 仍然需要通过 slot_mapping 被写入正确位置。decode 阶段同时依赖两种映射:通过 block_table 读取已有历史页,通过 slot_mapping 把新 token 的 K/V 追加进新的物理 slot。
从 FlashAttentionMetadataBuilder.build() 的结构也能看出这一点。构建 attention metadata 时,CommonAttentionMetadata 会同时携带 block_table_tensor 和 slot_mapping,然后 backend 再据此生成具体的执行 metadata。对于普通情况,backend 直接基于 seq_lens、query_start_loc、block_table 等信息组织 attention;当存在公共前缀时,还会把 common_prefix_len、prefix_kv_lens 等信息纳入调度元数据,用于 cascade / prefix-aware 的执行路径。block_table 是 decode 阶段 attention 读取历史 KV 的关键输入,作用远超过 cache update 的辅助索引。
如果把 prefill 和 decode 的差异压缩成一句话,可以这样理解:
prefill 更强调“本轮一批新 token 如何通过 slot_mapping 写入 paged KV cache”,而 decode 更强调“如何基于 block_table 读取已有历史页,同时再用 slot_mapping 追加新 token”。
这也是 vLLM 当前分页化 KV 抽象真正成立的关键。系统让“历史 KV 存储”和“新 token 写入”都围绕同一套物理 page/block 布局组织:block_table 描述逻辑上下文到物理页的映射,slot_mapping 描述当前批次 token 到物理写入位置的映射。一个偏读路径,一个偏写路径,最终都落在同一个底层 KV tensor 上。
十一、Prefix cache 命中是如何查找的:block 级复用的工程约束
到这里,其实还剩下一个很关键的问题:当我们说一个 request “命中了 prefix cache” 时,vLLM 当前主线到底在查什么?如果把这一步想象成“拿 prompt 字符串做最长前缀匹配”,就会低估它的工程约束。实际实现里,prefix cache 查找围绕 block hash、block size 对齐以及 attention-type 特定规则展开,目标是 full-block 级可验证复用。
从 KVCacheManager.get_computed_blocks() 出发,系统会先为 request 拿到预先计算好的 block_hashes,然后把“最大可命中长度”设为 prompt_length - 1。这个 -1 是为了重新计算最后一个 token 来获得 logits,即使所有 prompt token 理论上都命中缓存。接下来,真正的查找工作会进入 KVCacheCoordinator.find_longest_cache_hit(),再由不同的 single-type manager 分别判断在各自 attention 语义下最长可接受的 cache hit 前缀。
对于 full attention,这个过程相对直接。FullAttentionManager.find_longest_cache_hit() 会沿着 block hash 链从左到右扫描:只要当前 block hash 能在 BlockPool 的 cached-block 映射中找到,对应 block 就被视为可复用;一旦某个 block hash miss,后续更长的 block 链也就不再可能命中,于是扫描停止。当前主线的 prefix cache 命中遵循的是“按 block 链前缀增长”的规则,token 粒度上的稀疏匹配不在这条路径里。
更进一步地说,命中的最小复用单位是 full block。只有 full block 才会在 cache_full_blocks() 中生成 hash 并进入 prefix cache;查找时 find_longest_cache_hit() 也只在 block hash 链上工作。当前主线里的 prefix reuse 语义天然受到 block size 约束:如果一个前缀还没有填满完整 block,它通常不会作为稳定可复用单元进入 prefix cache。对于混合 attention 组,KVCacheCoordinator 还会进一步要求 cache hit 长度满足各组 block size 的最小公倍数对齐,以确保所有组都不会出现 partial block hit。
当 attention 类型变复杂时,prefix hit 的判定也会变化。以 sliding window 为例,系统要考虑窗口内仍然有效的连续块,不能照搬 full attention 下从左到右找最长共同前缀的规则。cache hit 的查找方式受到窗口语义约束,这也是 vLLM 让不同 attention type 通过各自 manager 实现 find_longest_cache_hit() 的原因:prefix caching 跟 attention 语义绑在一起。
这一实现细节能帮读者避开一个常见误解:vLLM 的 prefix cache 面向已经稳定成 full block 的前缀页,强调可验证、可管理、可共享的复用。当前主线真正缓存的是前缀对应的完整物理页及其 hash 身份。block/page 才是 vLLM KV 管理的基本资源单位,prefix cache 命中也围绕 block 运转。
十二、Prefix caching 的真正意义:它改变了 block 的生命周期语义
在很多介绍里,prefix caching 被讲成一种“提升命中率、减少 prefill 重算”的优化功能。这种说法没有错,但放在当前主线里还不够。prefix caching 更深的一层意义,是让一部分 KV blocks 从请求私有状态变成可共享的系统资源。
首先,prefix caching 建立在 full block 命中和 block-size 对齐约束上。能否命中、命中多少、哪些部分需要重算,都受当前 block 布局和对齐语义约束。vLLM 纳入共享语义的是已经稳定成 full block 的那部分 KV,整个前缀字符串本身不会被抽象地贴上“可复用”标签。
其次,一旦命中发生,新的 request 会通过 touch() 共享现有 block。block 的生命周期因此被拉长:它可能跨多个 request 存活、被多次引用,并在某些请求结束后依旧保留。
最后,当前主线里的“公共前缀”已经进入执行路径。scheduler 会把 num_common_prefix_blocks 传给后续执行路径,而 attention backend(至少在部分 backend 中)已经开始基于 common_prefix_len 等信息组织更进一步的 batch 优化。prefix reuse 正在进入 execution-aware reuse 阶段。
当前 vLLM 主线通过 prefix caching 引入共享 block 生命周期,并开始把这层共享关系继续传导到 batch 级执行优化。沿着这个视角看,ref count、common prefix blocks、cache commit 时机等设计就不再是零散技巧,它们共同构成同一套资源语义。
十三、远端 KV 已经从接口痕迹变成跨实例缓存池
(v1.1 新增) 三月初写这篇文章时,num_external_computed_tokens、connector、remote KV、异步接收这些接口更像是 vLLM 本地 block runtime 向外延展的“痕迹”。到了 5 月,这条线已经被 vLLM、LMCache 和 Mooncake 社区一起推进成了更明确的系统形态:本地 BlockPool 仍然是单个 engine 的执行基础,但跨实例 prefix reuse 开始需要一个可查询、可传输、可隔离、可恢复的外部 KV 层。
vLLM x Mooncake Store 官方博客给出的 workload 很有代表性。Codex / SWE-bench Pro trace 一共有 610 条,median 33 turns;到第 30 轮时,上下文大约增长到 80K tokens,最长超过 180K tokens,但每轮真正新增的输入通常只有几百到几千 token,平均 input/output token ratio 约为 131:1[23]。这类 agent 任务里,单机 prefix cache 的难点在 serving 层:router 很难保证下一轮还落在同一个实例上;一旦为了负载均衡把 session 迁到另一台机器,原来的本地 KV 就变成了孤岛。
Mooncake Store 的设计正是把这个孤岛打通。vLLM 实例嵌入 Mooncake client,共享一个由 Mooncake master 管理的集群级 KV store;master 管理 KV block hash、大小、服务发现和 client 健康状态,worker 则把 GPU KV cache memory 注册成 RDMA buffer,通过 Mooncake Transfer Engine 在 GPU HBM 和分布式 DRAM / SSD pool 之间搬运 KV blocks[23][24]。
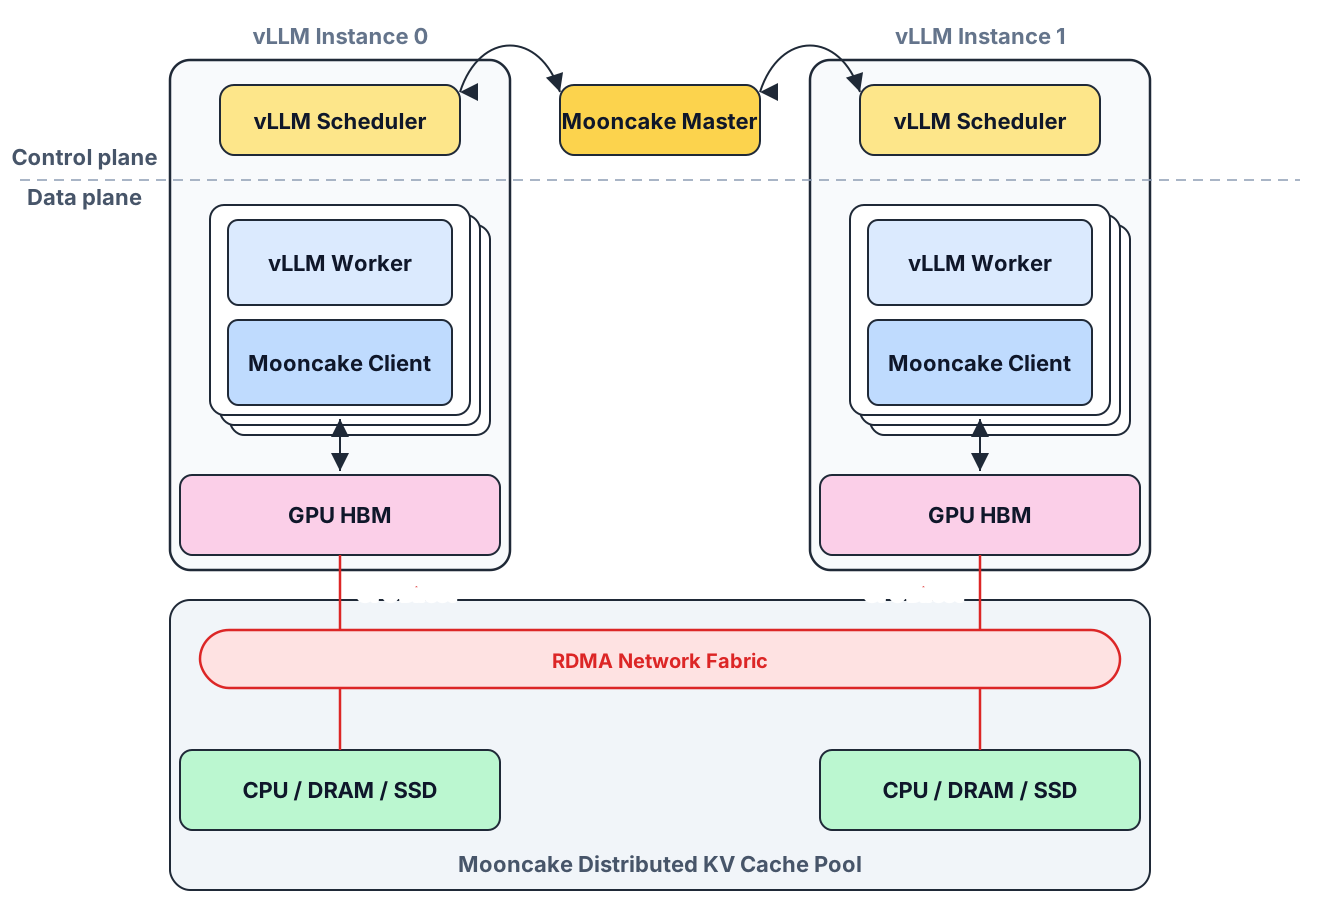
图 1:Mooncake Store 把多个 vLLM 实例接入同一个集群级 KV pool;scheduler 侧做 block-hash lookup,worker 侧通过 RDMA 在 GPU HBM 与分布式 DRAM / SSD pool 之间移动 KV blocks。来源:vLLM 官方博客。
这张图补上了原文里只讲到“connector 注册 KV memory region”的另一半:connector 的职责从 prefill 和 decode 两端之间的传输通道,扩到跨实例 cache discovery 和异步存取。PR #40900 里的 MooncakeStoreConnector 把 scheduler / worker 进一步分开:scheduler 侧通过 ZMQ IPC 查询外部 prefix cache hits,并构建本轮 load / save metadata;worker 侧注册 GPU KV buffers,启动后台 send / recv threads,支持 FlashAttention 和 FlashInfer 两类 KV cache layout 的 stride 检测[24]。这套分工延续了原文分析的 runtime 逻辑:scheduler 决定哪些外部 KV 可纳入本轮资源视图,worker 负责把这份视图落成真实数据传输。
MultiConnector 让这条路径和 P/D disaggregation 叠在一起。官方博客里的流程是:prefill instance 一边把 KV blocks 交给 PD connector,一边通过 store connector 写入分布式 KV pool;命中时,vLLM 可以从 Mooncake Store connector 恢复匹配前缀;decode 侧目前写入 pool 后会让 prefill 侧负责读取,再通过 PD connector 转发给 decode[23]。这个限制本身很有信息量:社区已经在把“多路径 KV loading”列为下一步,也就是同时从 prefill instance 和分布式 pool 拉 KV,以吃满更多网络带宽。KV runtime 的瓶颈正在从本地 page 化,转向多条数据路径之间调度同一组 block。
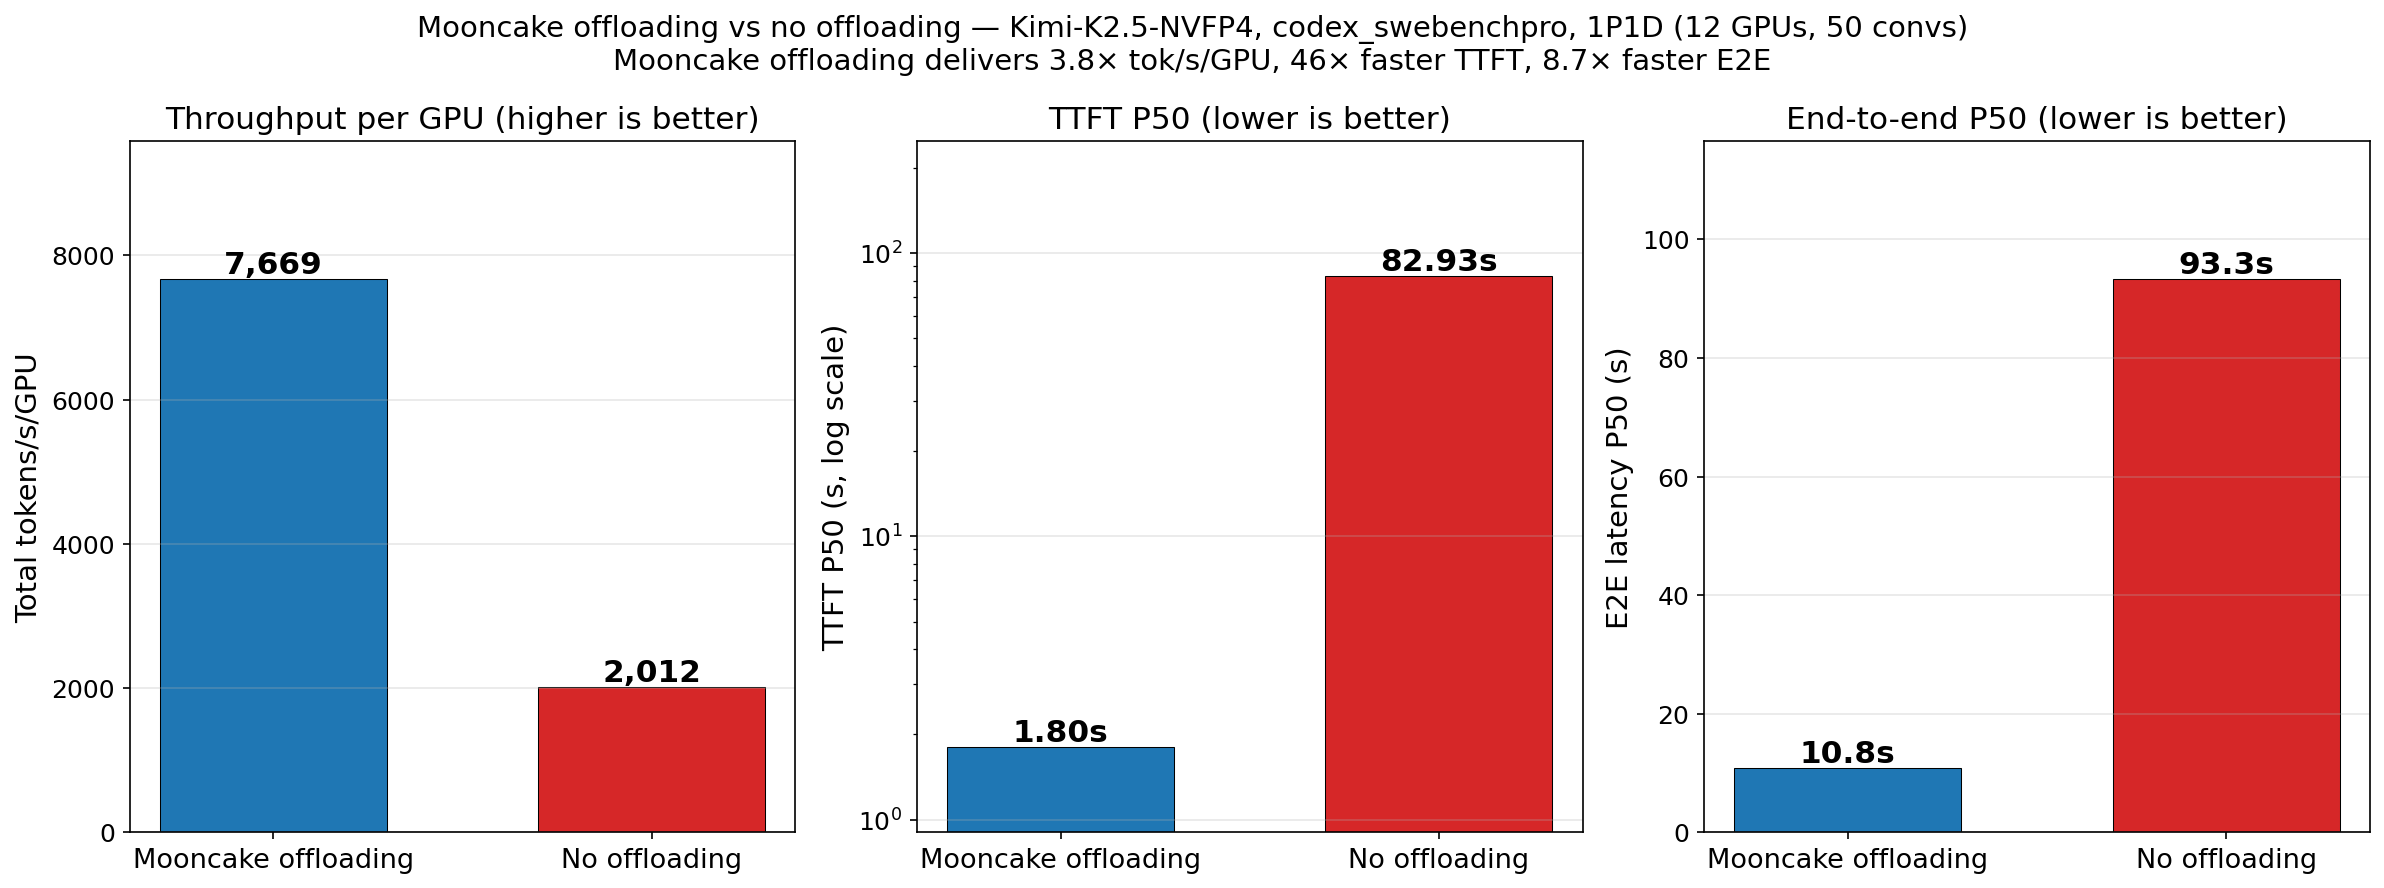
图 2:在 1P1D、12 张 GB200 的 Codex agentic trace 实验里,Mooncake Store 把 cache hit rate 从 1.7% 拉到 92.2%,对应吞吐 3.8 倍、P50 TTFT 46 倍和端到端延迟 8.6 倍改善。来源:vLLM 官方博客。
LMCache 最近的变化从另一个方向补齐了这件事:外部 KV 层一旦变成共享基础设施,就必须有租户边界和恢复语义。vLLM 先在 #39837 把 request.cache_salt 透传到 LMCache MP connector[25],LMCache 随后把 cache_salt 写入 ObjectKey 并在 #3137 引入 IsolatedLRU:每个 cache_salt 有独立 LRU list,配额通过 HTTP 动态配置,某个用户超额时只驱逐自己的 KV blocks[26][27]。本地 BlockPool 的 ref count 解决“多个 request 如何共享同一批 block”,cache_salt 进一步解决“共享基础设施里哪些 block 应该彼此隔离”。
LMCache 的 MP 路径也在变得更像一个可独立运维的服务。#3208 让 vLLM 侧 adapter 在 LMCache MP server 重启后自动重新注册 KV caches,不再要求重启 vLLM 才能恢复 STORE / RETRIEVE[28];#3172 给 Mooncake L2 adapter 加 batch operations,#3018 则提前注册 RDMA L1 memory 以服务 MooncakeStore L2 adapter[29][30]。这些改动看起来不像论文里的“大设计”,但它们决定了外部 KV 层能不能在真实服务里持续运行:重启能恢复,批量读写能摊薄开销,内存注册不再卡在请求热路径上。
Mooncake 社区最近合并的一组 PR 则说明数据面已经进入生产加固期。EFA 传输路径把 libfabric API 请求从 1.14 提到 1.18,让 p5 / p5e 这类 Nitro v4 EFA 硬件默认启用 device RDMA;PR 描述里的复现数据显示,补丁后同一 cross-node run 在不设置额外环境变量时稳定到 377.93 GB/s,和显式 FI_EFA_USE_DEVICE_RDMA=1 的 377.74 GB/s 基本一致[31]。同一窗口里,Mooncake 还修了 dmabuf 注册必须使用 allocation base address、注册前初始化 CUDA primary context、RDMA QP 并发销毁导致 ibv_post_send UAF、连接建立环形死锁等问题[32][33][34][35]。这些修复没有改变 KV cache 的抽象,却决定了“把 block 放到远端”是否能在多节点网络里稳定发生。
5 月 9 日合并的 #2004 更值得放在这篇文章里看。它修复了 Mooncake Store disk-backed replicas 读回 GPU KV cache 时全部返回 INVALID_PARAMS 的问题:LOCAL_DISK 现在可以把 on-disk blob 通过 RDMA scatter 到用户 GPU slices,DISK 则通过注册 CPU 临时 buffer staging 后再 H2D scatter;验证里 2500 个 prompts 全部完成,GPU KV cache 持续 99.8% 到 100%,external prefix cache hit rate 从 1.4% 增长到 3.1%[36]。这个数字不夸张,但它说明一个更实际的问题:分布式 KV pool 真正进入 SSD 层后,系统要同时处理容量、GPU 指针、host staging、replica 类型选择、scatter/gather 语义和错误路径。
把这三条线放回 vLLM 本地 runtime,就能看出原文分析为什么仍然成立。远端 KV 没有绕开 BlockPool、block hash、block table 和 slot mapping;它只是把这些本地抽象的生命周期拉长了。scheduler 仍然要判断本轮哪些 token 已经 computed,worker 仍然要把逻辑 block 映射到物理 KV slots,connector 只是让一部分 computed blocks 可以来自另一个实例、另一层 DRAM,甚至另一块 SSD。本地 block runtime 是跨实例 KV cache pool 的共同语言;没有这套语言,Mooncake Store 和 LMCache 都很难和 vLLM 的执行热路径对齐。
十四、当前主线的边界:本地 block runtime 已经成型,跨实例资源层正在接上来
(v1.1 更新) 当前 vLLM 主线已经把单机本地的 KV cache 管理做成了一套系统级 runtime;2026 年 5 月的社区进展则说明,下一层工作正在把这套 runtime 接到跨实例、跨介质的资源层上。更准确的说法是:vLLM 已经把“本地显存中的 block 级 KV 管理”系统化了,Mooncake Store 和 LMCache 正在把这些 block 的生命周期扩展到集群级共享空间。
这套设计本身带来了额外复杂度。系统需要维护 block hash、free queue、引用计数、公共前缀统计,还要让 backend 理解 block table 和 slot mapping。这些复杂度换来的是动态请求下更好的复用与调度能力,contiguous KV buffer 的简单模型已经不够用。
另一方面,当前主线已经显式吸纳更复杂 KV 体系。allocate_slots(...) 里存在 num_external_computed_tokens、delay_cache_blocks 等参数;scheduler 中也存在 connector、remote KV、异步接收完成后再更新 request 状态的逻辑。Mooncake Store、LMCache MP 和 Mooncake disk replica 修复把这些接口从“预留能力”推向真实部署路径:远端已计算 KV、异步传输、offload、重启恢复和租户隔离都开始进入同一条资源链路。
边界也很清楚。MooncakeStoreConnector 在 2026-05-09 仍是开放 PR,官方博客公布的是当前实现和实验结果,距离完全稳定的 release API 还有一段路[24]。此外,decode 侧目前还没有直接从分布式 pool 读取所有命中 KV,多路径加载、cache-aware routing、hybrid model offloading 和分布式 disk offloading 都还在后续计划里[23]。因此,这篇文章的主线仍然应该从本地 block/page runtime 读起;跨实例 KV pool 是它的延展形态。
十五、结语:vLLM 的重要性,在于它把 KV cache 推进到了 runtime 中枢
如果只把 vLLM 看成一种 PagedAttention 实现,它的意义会被压缩到 attention 访存和显存利用率层面。但从当前主线源码来看,这个理解已经过于狭窄。vLLM 真正更有代表性的地方在于,它把 KV cache 从模型执行中的中间状态,推进成推理 runtime 的中枢资源之一。
在这套系统里,scheduler 要理解哪些请求在当前 KV 资源约束下可执行;KVCacheManager 是调度器的资源接口;BlockPool 统一维护 block 的缓存、共享和回收生命周期;worker 则通过 block table 和 slot mapping,把分页式资源抽象落到 attention backend 的执行面上。
(v1.1 更新) 5 月这批进展让这个结论更向前走了一步。当前 vLLM 主线给出的最重要答案已经扩展为:如何把 KV cache 纳入一个面向动态请求、前缀复用、调度约束和跨实例共享的运行时系统。如果说早期人们把 KV cache 看成 Transformer 推理中的必要副产物,那么 vLLM、LMCache 和 Mooncake 社区正在把它推进成推理系统设计必须正面处理的核心对象:它有本地生命周期,也有远端所有权;有性能路径,也有租户边界;有显存布局,也有网络和存储数据面。
参考资料
版本对齐信息
v1.0 源码分析对齐
| 项目 | 范围 | 对齐版本 |
|---|---|---|
vllm-project/vllm |
main 分支源码路径 |
commit 48e376a |
v1.1 社区进展对齐(2026-05-09 刷新)
| 项目 | 本文引用的更新材料 | 对齐版本 |
|---|---|---|
vllm-project/vllm |
PR #40900、#39837 | #40900 为 open PR head 68a1718d,查询于 2026-05-09,未视为稳定 release API;#39837 merge commit ed333105 |
LMCache/LMCache |
PR #3042、#3137、#3208、#3172、#3018 | merge commit 前缀:408d6df5、87829d20、730e8f99、7657836e、19acf22c |
kvcache-ai/Mooncake |
PR #2041、#2035、#2034、#1903、#1959、#2004 | merge commit 前缀:44cde29c、658297c4、d2dcd8b4、ea8fa5da、2a5a94a0、98333ad4 |
源码文件
[1] scheduler.py 展示 vLLM 将 KV 管理放入调度热路径:相对路径 vllm/v1/core/sched/scheduler.py
GitHub:scheduler.py
重点关注 Scheduler.__init__ 与 schedule(),其中 waiting request 在进入 running 前会先查询 computed blocks,并调用 allocate_slots(...) 判断当前步是否可调度。
[2] kv_cache_manager.py 定义调度器视角的 KV 资源接口:相对路径 vllm/v1/core/kv_cache_manager.py
GitHub:kv_cache_manager.py
重点关注 KVCacheBlocks、get_computed_blocks()、allocate_slots()、free() 与 get_num_common_prefix_blocks()。其中 allocate_slots() 的注释已明确给出 prefix tokens / new tokens / lookahead / external computed tokens 的处理布局。
[3] block_pool.py 统一管理 free blocks、cached blocks 与共享 block 生命周期:相对路径 vllm/v1/core/block_pool.py
GitHub:block_pool.py
重点关注 get_new_blocks()、cache_full_blocks()、touch()、free_blocks() 与 reset_prefix_cache()。该文件是理解 prefix cache 与 block 生命周期统一管理的关键。
[4] kv_cache_coordinator.py 展示多 KV cache group 的统一协调层:相对路径 vllm/v1/core/kv_cache_coordinator.py
GitHub:kv_cache_coordinator.py
重点关注 KVCacheCoordinator 的初始化和聚合接口,包括 get_num_blocks_to_allocate()、allocate_new_blocks()、cache_blocks()、free() 等。
[5] single_type_kv_cache_manager.py 展示不同 attention spec 下的差异化 KV 管理:相对路径 vllm/v1/core/single_type_kv_cache_manager.py
GitHub:single_type_kv_cache_manager.py
重点关注 SingleTypeKVCacheManager 抽象基类,以及 FullAttentionManager、SlidingWindowManager 对 find_longest_cache_hit()、get_num_common_prefix_blocks()、remove_skipped_blocks() 的不同实现。
[6] block_table.py 展示 worker 如何将 request blocks 转换为执行 metadata:相对路径 vllm/v1/worker/gpu/block_table.py
GitHub:block_table.py
重点关注 append_block_ids()、gather_block_tables() 与 compute_slot_mappings()。这是理解逻辑 block 到物理 slot 映射的关键。
[7] attention/backend.py 定义 attention backend 消费的 batch 级公共 metadata:相对路径 vllm/v1/attention/backend.py
GitHub:attention/backend.py
重点关注 CommonAttentionMetadata,其中显式包含 block_table_tensor 与 slot_mapping。
[8] flash_attn.py 展示公共前缀信息已进入部分 backend 优化路径:相对路径 vllm/v1/attention/backends/flash_attn.py
GitHub:flash_attn.py
重点关注 common_prefix_len、prefix_kv_lens、prefix_scheduler_metadata 和 use_cascade = common_prefix_len > 0 等逻辑。
[9] engine/core.py 展示 KV cache 初始化发生在 engine 启动阶段、scheduler 创建之前:相对路径 vllm/v1/engine/core.py
GitHub:engine/core.py
重点关注 EngineCore.__init__() 与 _initialize_kv_caches(),其中 engine 会先生成 kv_cache_configs,再调用 model_executor.initialize_from_config(...) 初始化各 worker 的 KV cache。
[10] gpu_worker.py 展示 worker 侧先初始化 KV transfer,再初始化 KV cache:相对路径 vllm/v1/worker/gpu_worker.py
GitHub:gpu_worker.py
重点关注 initialize_from_config(),其中先调用 ensure_kv_transfer_initialized(...),再进入 model_runner.initialize_kv_cache(...)。
[11] model_runner.py 展示 runner 侧如何把配置落成 BlockTables、attention backend 和 KV tensors:相对路径 vllm/v1/worker/gpu/model_runner.py
GitHub:model_runner.py
重点关注 initialize_kv_cache(),其中依次创建 BlockTables、初始化 attention backend、调用 init_kv_cache(...),最后通过 get_kv_connector(...) 把已分配好的 KV tensors 暴露给 connector。
[12] attn_utils.py 展示原始 KV memory 的真实分配与 reshape:相对路径 vllm/v1/worker/gpu/attn_utils.py
GitHub:attn_utils.py
重点关注 _allocate_kv_cache()、_reshape_kv_cache() 和 init_kv_cache();其中 _allocate_kv_cache() 里的 torch.zeros(...) 是原始 KV tensor 的真实分配点。
[13] kv_transfer_state.py 展示 KV transfer connector 的初始化入口:相对路径 vllm/distributed/kv_transfer/kv_transfer_state.py
GitHub:kv_transfer_state.py
重点关注 ensure_kv_transfer_initialized(),它通过 KVConnectorFactory.create_connector(...) 创建 worker 侧的 transfer connector。
[14] gpu/kv_connector.py 展示已分配 KV tensors 如何被注册给 connector:相对路径 vllm/v1/worker/gpu/kv_connector.py
GitHub:gpu/kv_connector.py
重点关注 ActiveKVConnector.__init__(),其中直接调用 self.kv_connector.register_kv_caches(kv_caches_dict)。
[15] nixl_connector.py 展示 NIXL worker 初始化与 memory registration:相对路径 vllm/distributed/kv_transfer/kv_connector/v1/nixl_connector.py
GitHub:nixl_connector.py
重点关注 NixlConnectorWorker.__init__()、register_kv_caches()、register_local_xfer_handler() 和 add_remote_agent();其中 register_kv_caches() 通过 cache.data_ptr()、get_reg_descs() 与 register_memory() 把真实 KV memory region 注册给 NIXL。
相关 PR
[16] Use block table apis for capture inputs:PR #35671
链接:PR #35671
说明 block table API 仍是当前执行主链的一部分,并在演进中。
[17] Avoid prefix cache hit in the same schedule step for mamba layers:PR #29387
链接:PR #29387
说明 prefix caching 与 schedule step 的交互语义并非静态设计点,仍在持续修正。
[18] Fix CPU memory leak from Request reference cycle in prefix caching:PR #34183
链接:PR #34183
说明 prefix caching 不只是性能特性,也涉及 request 生命周期与引用管理复杂度。
[19] Support multiple KV cache groups in Hybrid KV Coordinator:PR #31707
链接:PR #31707
可用来支撑“当前主线已是多组 KV 协调架构”的判断。
官方博客 / 原文延伸阅读
[20] Inside vLLM: Anatomy of a High-Throughput LLM Inference System:vLLM 官方架构总览文
链接:Anatomy of vLLM
这篇文章从整体系统角度覆盖 Engine、Scheduler、Prefix Caching、Disaggregated P/D 等主题,适合作为理解 vLLM 全局结构的官方背景材料;KV cache 内部运行时与显存布局的源码级细节,需要结合本文这样的拆解来读。
[21] vLLM Router: A High-Performance and Prefill/Decode Aware Load Balancer for Large-scale Serving:vLLM 官方对状态感知路由与 P/D 解耦的说明
链接:vLLM Router
文中明确指出大规模 serving 需要感知 KV cache 这一状态,并提到 router 支持 NIXL 与 NCCL-based (with ZMQ discovery) 的 disaggregation backends。本文对 NIXL / NCCL 的讨论更聚焦于 当前 vLLM Python connector 路径中 memory registration 与 block-level KV transfer 的语义差异,与 router 文中的部署层描述并不冲突。
[22] Inside vLLM’s New KV Offloading Connector: Smarter Memory Transfer for Maximizing Inference Throughput:vLLM 官方对 KV offloading connector 的原文说明
链接:KV Offloading Connector
这篇官方博客重点讨论 CPU KV offloading、异步 connector API、cudaMemcpyAsync / DMA 路径与吞吐优化,是理解“KV data 如何通过 connector API 在不同介质间搬运”的第一手材料。本文对 NIXL register / zero-copy 的讨论则进一步补充了另一条以已注册 device memory region 为中心的 KV transfer 路径。
2026-05 v1.1 更新材料
[23] Serving Agentic Workloads at Scale with vLLM x Mooncake
[24] vLLM PR #40900: Add MooncakeStoreConnector for KV cache offloading via Mooncake distributed store
[25] vLLM PR #39837: Propagate cache_salt through LMCache MP connector for per-user cache isolation
[26] LMCache PR #3042: Add cache_salt to ObjectKey for cache isolation
[27] LMCache PR #3137: Add IsolatedLRU eviction policy and per-cache_salt quotas
[28] LMCache PR #3208: Make vLLM reconnect after LMCache restarts
[29] LMCache PR #3172: Add batch operations to Mooncake L2 adapter
[30] LMCache PR #3018: Add RDMA L1 memory preregistration support for MooncakeStore L2 adapter
[31] Mooncake PR #2041: Request libfabric API 1.18 so device RDMA is the default on all EFA generations
[32] Mooncake PR #2035: Use allocation base addr for dmabuf-based mem registration
[33] Mooncake PR #2034: Init CUDA primary context before dmabuf-based mem registration
[34] Mooncake PR #1903: Fix RDMA use-after-free crash in ibv_post_send
[35] Mooncake PR #1959: Fix possible deadlock in RDMA transport connection setup
[36] Mooncake PR #2004: Fix disk replica read paths for GPU KV cache
Discussion
留言
评论由 GitHub Discussions 承载,需要 GitHub 账号登录后发布。
滚动到这里时加载评论。